ARTICLE · 1188854
Hindsight:给 AI 助手加长期记忆的开源系统,为什么会记错“谁说的”?
设想一次客服对话:客户说“我上周升了套餐”,一个能调用工具办事的 AI 助手,也就是 Agent(智能体),回复“我今天帮你改账单”。如果这段对话被压成一段没有说话人标记的摘要,长期记忆就可能把客户做过的事和智能体答应做的事混在一起。过一段时间再问“智能体处理过什么”,它甚至可能把客户的经历说成自己的。
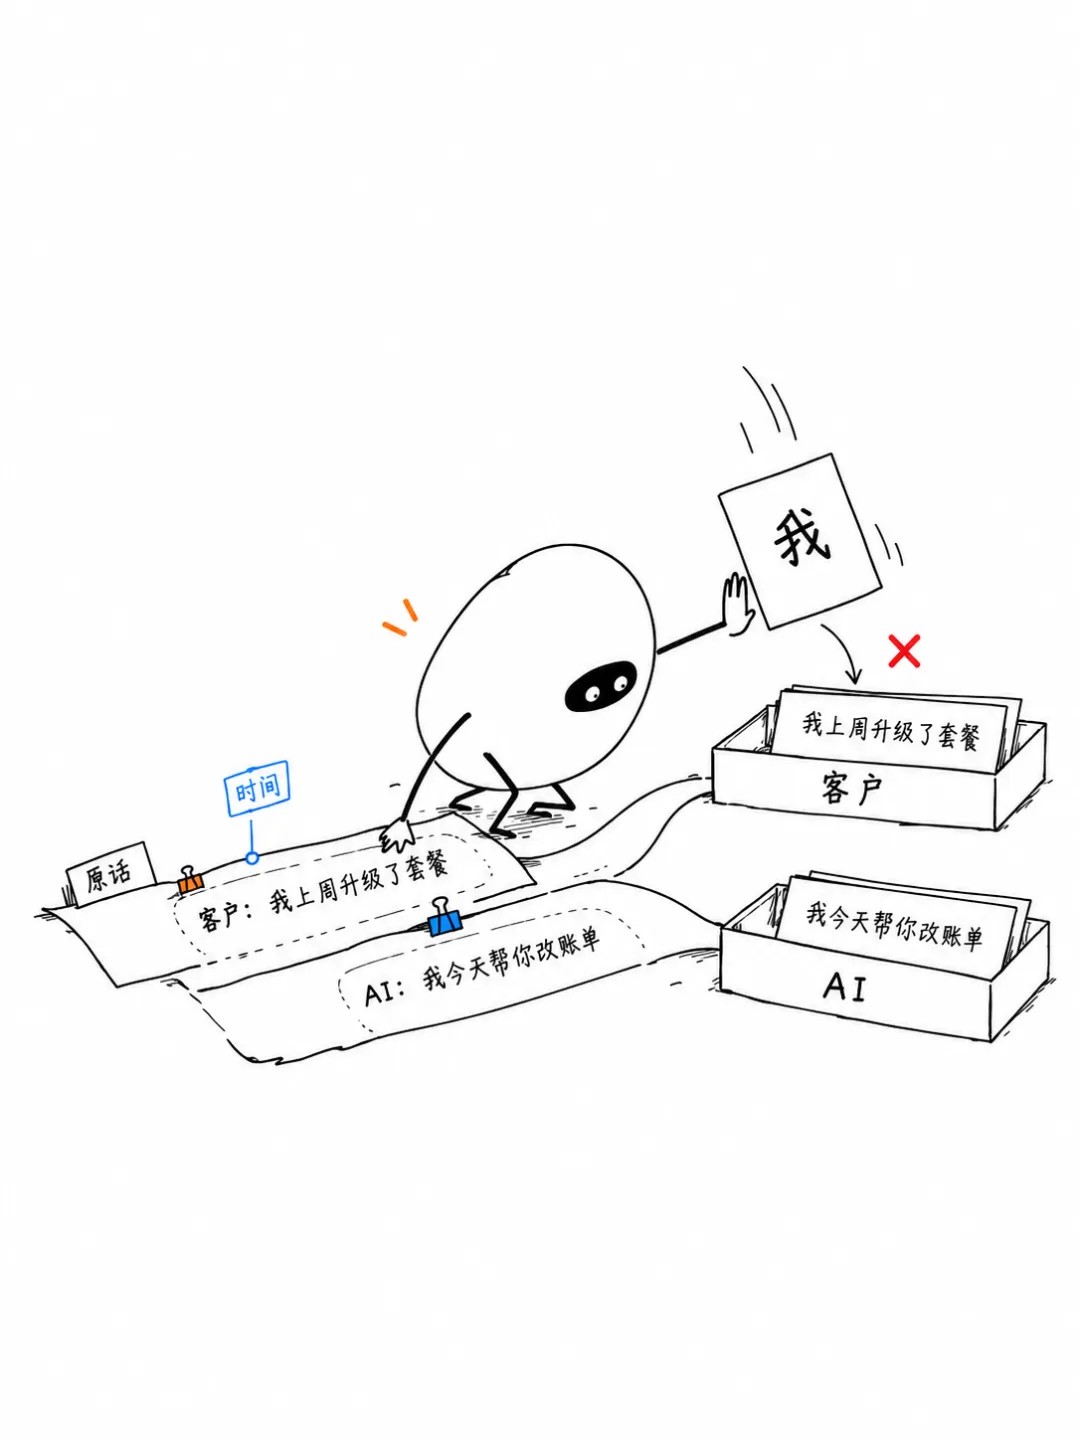
这类错误也可能出现在记忆写入时。系统还得判断哪些内容该留下、以后怎样找到它们,以及找回来后能不能说明“谁说的、什么时候说的、依据是什么”。
长期记忆要把说话人、来源和时间记清楚;只存得多还不够。
由 Vectorize 团队维护的开源项目 Hindsight,就是一种给智能体使用的长期记忆系统。它把记忆拆成三件事:写入、召回、综合回答。
为什么光靠一份记忆文档不够
对话中的上下文,可以理解成模型这次工作时摊开的桌面。桌面上有什么,模型当下就能参考什么;换一个新会话,旧桌面上的内容不会自动跟过来。记忆文档的作用,是从过去挑一些信息,带进新的会话。
以 NousResearch 开发的 Hermes Agent 为例,官方文档列出的默认配置是:MEMORY.md 最多 2,200 个字符,另有一份记录用户偏好的 USER.md,最多 1,375 个字符。这些上限可以调整;文件会在每个新会话开始时载入。这样做很直接,不用先搜索记忆,但装进去的内容每次都会占用模型能读取的信息空间。
如果把文档越写越长,每个新会话都会带上许多当前任务用不到的内容;如果为了省空间反复删改,又可能只留下结论,删掉时间、过程和说话人。记忆文件短了,不代表记得更清楚。
Hermes 还有两种不同用途的能力。Skill(技能)保存的是“某类任务怎么做”的操作说明,不等于某次对话中谁做过什么;会话搜索可以回到过去的聊天里找原文,但积累的会话多了,搜索和整理仍然要花时间。一份短记忆、任务说明和完整聊天记录,各自解决不同问题;长期记忆要补的是跨会话找回事实及其关系。
记忆文档负责随新会话带入少量信息;会话搜索负责翻旧记录;长期记忆试图按问题找回相关事实和关系。
Hindsight 如何把对话变成可找回的记忆
Hindsight 把主要流程分成 retain(写入)、recall(召回)和 reflect(综合回答)。它们分别回答三个问题:存什么、找什么、怎样根据找回来的内容作答。
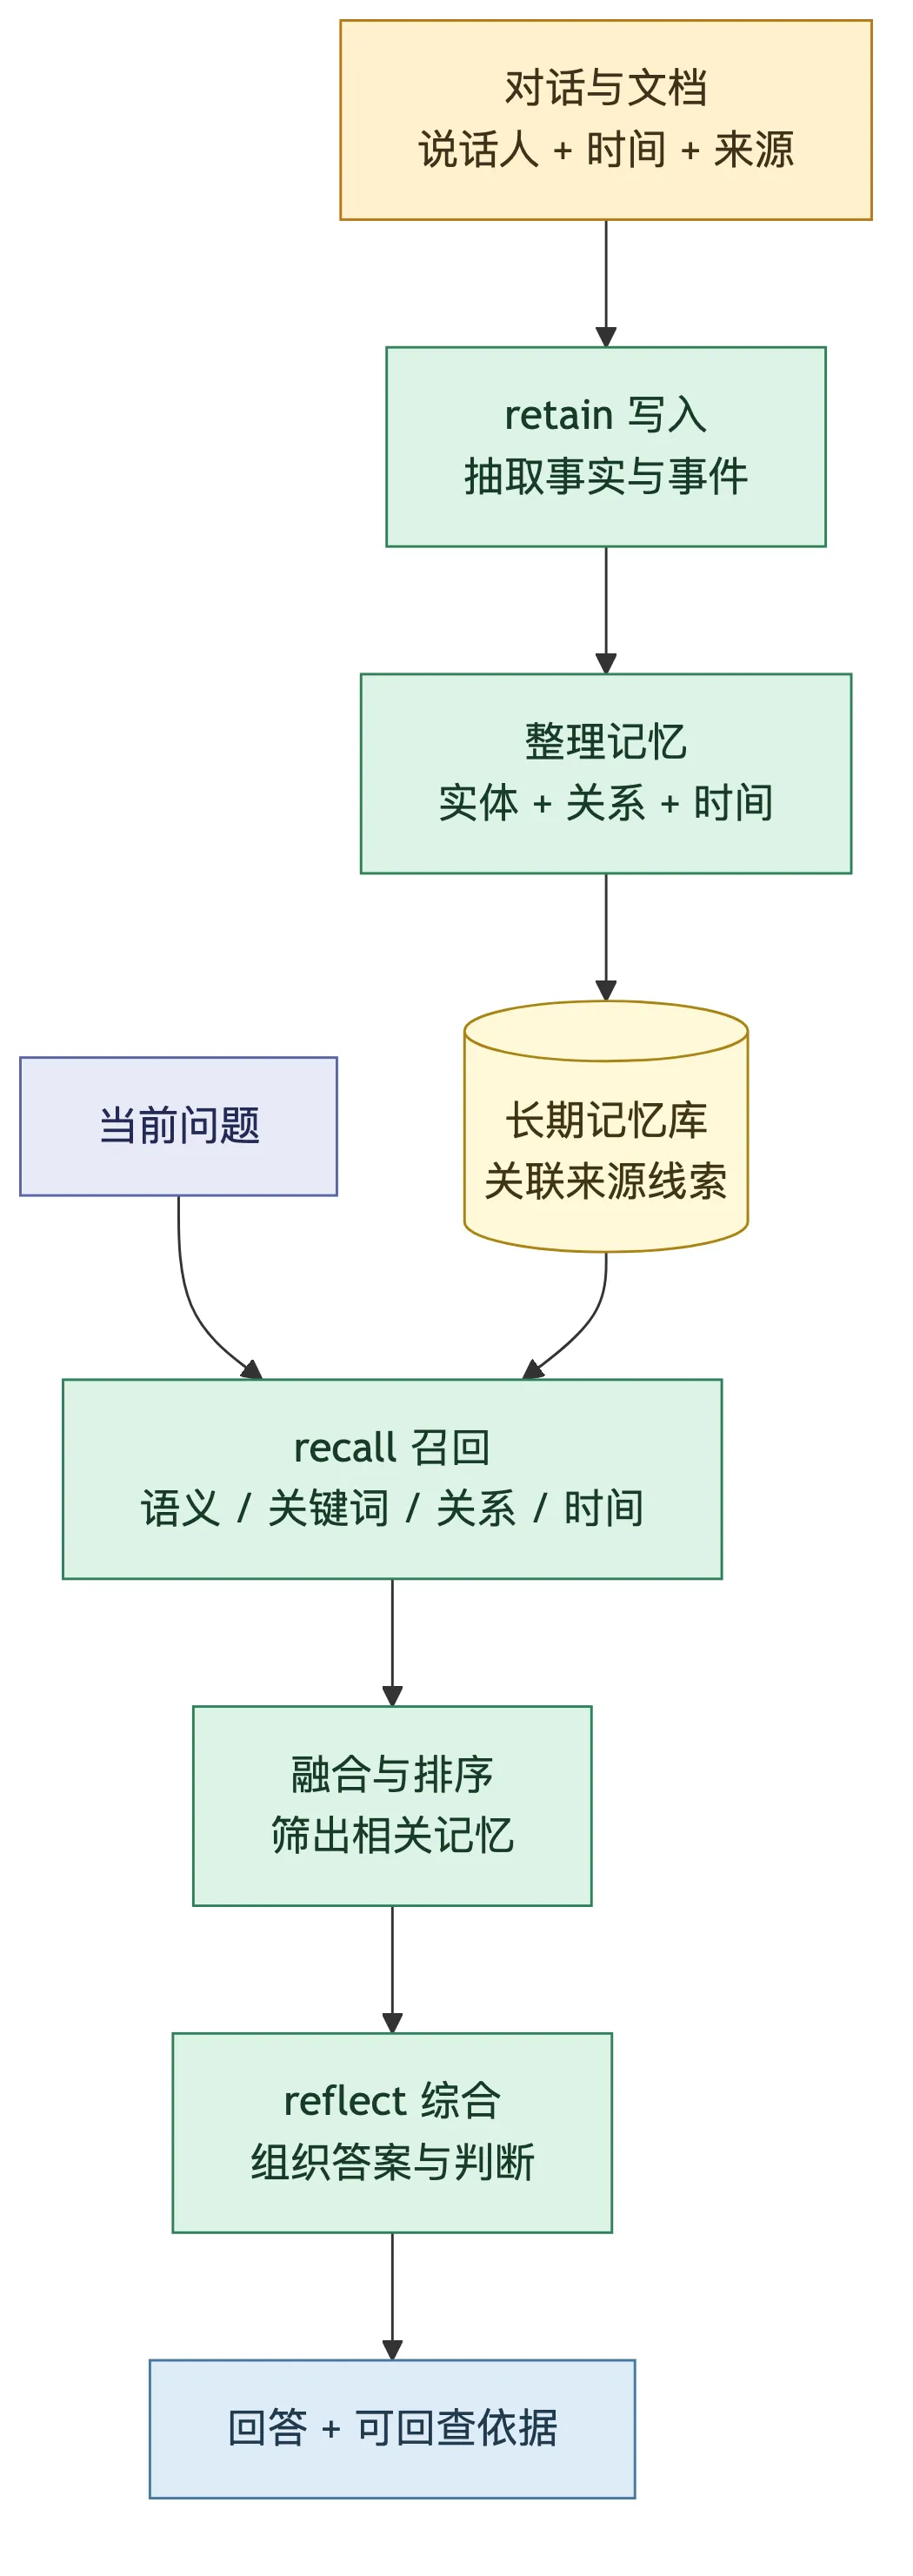
第一步是 retain。系统收到对话后,会用模型提取其中的事实和事件,识别人物、项目等对象,把相关内容连起来,并记录时间信息。比如“我们先试了方案 A,后来因为维护成本高,改用方案 B”,系统应记录 A、B 名称、参与人、先后顺序和改动原因。
系统还会把文字转成 embedding(嵌入向量)。可以把它理解成一组用于比较文本意思的数字:以后有人用不同说法提问,系统仍能找到含义相近的内容。人物、项目、时间和事件之间也会建立关系,帮助查询时把相关记录串起来。Hindsight 也支持关联源文档或原文片段,便于回头核对;能回查什么,取决于写入了哪些内容和查询时用了什么选项。
写入时,模型会先判断对话里发生了什么,并把内容归到相应人物或事件。如果原文没说明说话人,模型就可能把内容归错人;后续搜索即使找得很准,也只是找准了那条错误记忆。
retain把聊天整理成带人物、时间、事件和来源线索的记忆;整理错了,错误也会一起留下。
它怎样从记忆库里找对内容
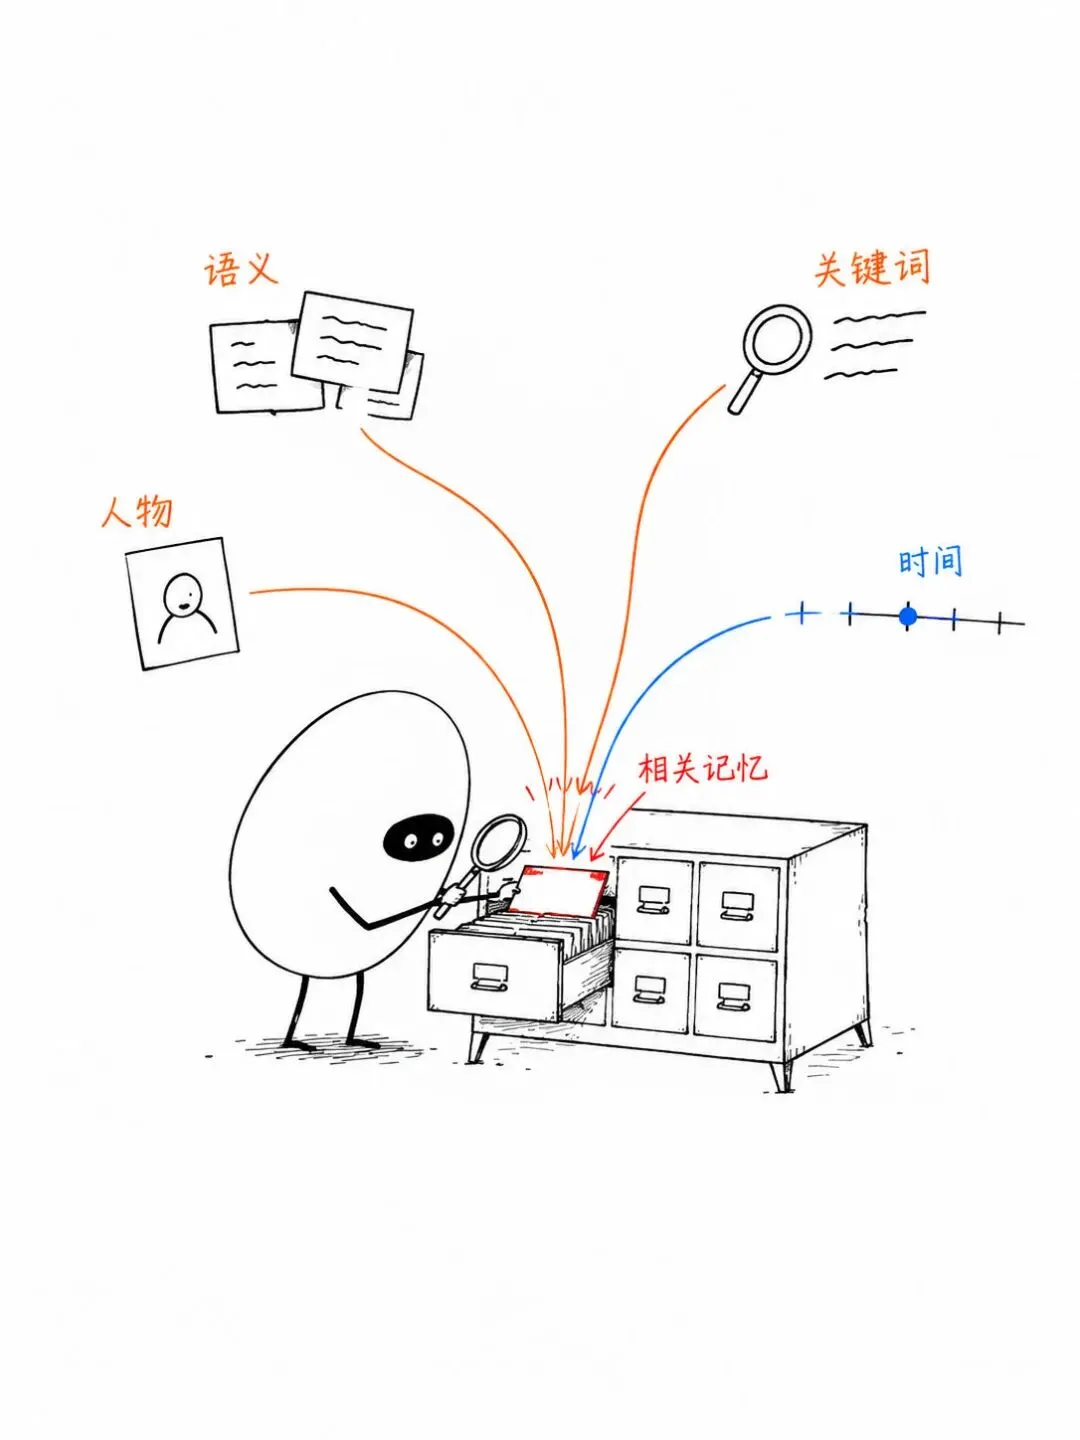
第二步 recall 根据新问题找相关记忆。Hindsight 会并行利用几类搜索线索:
• 语义搜索:寻找意思相近的句子。问“为什么改主意”,不需要原话里恰好出现“改主意”; • 关键词搜索:根据人名、项目代号或产品名等明确字词查找; • 关系搜索:沿着同一个人、项目或事件,找相互关联的记录; • 时间搜索:处理“上次”“去年”“上线前”等时间范围。
每种搜索会先找到一批候选内容。系统再把结果合并和重排(ranking),尽量把与问题最相关的记忆放前面。比如问“为什么推迟上线”,理想的结果不只包含延期记录,还会带上当时的成本评估、相关负责人和前后两次决策。
搜聊天日志时,通常先找到含有相似词句的文件,再让模型阅读并整理;长期记忆会按问题检索已整理过的事实和关系。它仍可能漏掉信息或排错顺序,不能因为结果排在前面,就当作已核实的结论。
recall用语义、关键词、关系和时间几条线索找候选,再排序;排序靠前不等于事实已核实。
找回记忆后,模型还要组织答案
第三步 reflect 会让模型基于找回的记忆,组织成回答或判断。recall 更像把可能相关的记录交出来,reflect 才负责把几条记录连起来解释。
比如过去几次讨论都记录了对某个模型的评价、测试结果和改变主意的原因,后来问“为什么当时放弃了它”,系统就可以先召回相关记录,再由模型组织出一段解释。这样不必每次从几十份旧文件开始翻。
但 reflect 只根据召回的内容组织回答,并不核验其中的事实。如果找回来的内容把“客户做过的事”错归给了智能体,模型可能把这条错误记忆组织成一段完整、听起来可信的回答。记忆让答案更连贯,不会自动让答案更真实。
recall找记录,reflect把记录组织成回答;如果记录来源错了,回答也可能错得更完整。
最该防的错误,是把“谁说的”弄混
一次对话里可能同时有用户自己的经历、智能体的推断、智能体从外部资料查来的事实,以及客户或其他人的原话。如果整理时把这些话混成一段,像“我上周升级了套餐”这样的第一人称句子,就可能被归到错误的说话人名下。
客服场景中的错误链可能是这样的:
1. 客户说自己升级了套餐,智能体说会帮忙改账单; 2. 对话交给记忆系统整理时,双方的话没有明确区分; 3. 系统把“我升级了套餐”记成智能体的经历; 4. 之后有人问智能体做过什么,系统找回这条记录,模型再把它讲成智能体执行过的动作。
Hindsight 的官方资料会区分关于外部世界的事实、智能体自身的经历,以及从多条记忆归纳出的观察;同时建议写入时提供说话人、上下文和时间。这能帮助系统正确归类,但不能验证现实中的事情是否真的发生过。给输入贴上“事实”标签,也不能证明它是真的。
因此,企业里的记忆要能回答四个问题:谁说的?什么时候说的?来自哪次对话或哪份文件?这是原始事实,还是模型整理出的判断? 面向客户、员工或业务决策的答案,还应当能回到原文核对。
记忆系统必须保留说话人、时间和出处;否则,错记之后还可能被当作组织事实继续使用。
长期记忆需要维护,也会产生持续成本
要让一段新对话变成以后能用的记忆,系统需要提取、归因、向量化、建立索引并写入;查询时还要搜索、合并、重排,最后再组织回答。中间任何一步没成功,都可能出现“没有写进去”或“写进去了却找不到”。如果处理在后台异步完成,刚说过的内容也可能要等一会儿才能查到。
实际投入通常有几类:
1. 记忆提取:如果设置为自动整理,需要模型判断哪些内容值得保存;每轮处理还是分批处理,会改变调用频率; 2. 向量化:把文字转成嵌入向量,需要本地算力或云端服务; 3. 检索和重排:要花计算时间;如果重排使用云端模型,也会产生 API(软件接口)调用费用; 4. 运行资源:数据库、磁盘、备份、监控,以及连接 Agent 的插件都要有人维护。
具体成本取决于数据量、模型、写入频率和部署方式,单个用户的服务器配置或日费用不能直接当成普遍标准。评估时要把整条流程的费用、延迟和故障监控都算进去,不能只看数据库价格。
外置记忆增加了一条需要运维的数据流程,成本要连同模型调用、响应延迟和故障排查一起看。
什么时候值得试
如果只是偶尔做彼此无关的任务,保存少量偏好、加载任务说明、需要时搜索旧会话,可能已经够用。只有当同一个智能体需要持续跟进某个人或项目、旧记录越来越难找时,外置长期记忆带来的收益才可能超过部署和维护成本。
做小范围试点时,可以先检查四件事:
1. 来源是否清楚:每条记忆能否看到说话人、时间和来源? 2. 写入是否可靠:有没有写入成功、索引完成和失败告警记录? 3. 答案能否回查:涉及客户、员工或决策时,能不能找到原始依据? 4. 记错能否修正:错误内容能不能更改或删除,冲突记录会不会被悄悄覆盖?
不要只检查“它答得像不像懂我”。还要测试它有没有分清谁做过什么、结论来自哪里,出了错能不能找到是写入、搜索还是回答环节的问题。
试点先验来源、写入、证据和纠错,再比较最终回答质量。
长期记忆的作用,是让智能体积累过去的对话和经验,在新任务中找回相关部分;它不会凭空让模型变聪明,也不保证每条记忆都正确。先让记忆能追溯、能纠错,再让智能体记得更多。
只有当任务需要跨会话积累,且答案可追溯、错误可修正时,长期记忆才值得承担额外成本。