ARTICLE · 1195391
一个开源插件,把AI编程成本砍掉98%
墨知 · AI神器精选 · 实战拆解 · 只发能照做的
实战拆解: 用 AI 写代码最贵的不是模型,是它一直在读没用的东西。一个开源 MCP 插件把上下文占用降了 98%,把连续干活时间从 30 分钟拉到 3 小时,微软、谷歌、Meta、字节的团队都在用。
我是墨知。写这个号,是因为我自己也被这些坑绊过,能抄的我尽量给你摆明白。
用 AI 写代码最贵的不是模型贵,是它一直在读没用的东西。
有个开源插件把这件事解决了,数字很夸张:上下文占用降 98%,连续干活时间从 30 分钟拉到 3 小时。
它叫 context-mode,GitHub 1.5 万 Star,微软、谷歌、Meta、字节、Cursor 的团队都在用。
01|先说清痛点:AI 编程贵在哪
两个坑,用过的人都懂:
坑一:Token 全是浪费的。
一个 Playwright 快照 56 KB,二十条 GitHub issue 59 KB,一份访问日志 45 KB——每一次工具调用,都把这些原始数据直接倒进上下文。跑半小时,40% 的上下文没了。
坑二:模型会失忆。
上下文塞满后,系统开始压缩历史。前一秒还在流畅写代码的 AI,下一秒就忘了刚才定的架构和约束条件。
有个真实案例:一位开发者把 300 组数据的训练任务交给 Claude。为了盯进度,Claude 没有写脚本,而是每 5 秒对整个项目做一次全局检索——半小时烧掉高配会员 90% 的额度。
这不是模型笨,是没人教它怎么干活。
02|它干了什么:三个机制
① 虚拟沙盒:不让模型直接看原始数据。
所有文件和运行记录先存本地,模型需要什么,再按需检索。官方比喻很准——把跑马拉松的过程扔进屏蔽舱,模型只看最终排名,而不是盯着每个选手的每一步。
② 存档点:治失忆。
实时监控每一次文件编辑,对话太长时自动注入一个小于 2 KB 的快照,告诉模型「你刚才在干嘛、改到哪了」。相当于给单机游戏存档。
③ Think in Code:让模型写脚本,而不是读文件。
要统计 50 个文件里的函数数量?不要让模型逐个读(700 KB),而是让它写一段脚本在本地算完,只把结果返回(3.6 KB)。一个脚本替代十几次昂贵调用,省百倍上下文。
03|三个能记住的数字
· 场景:效果
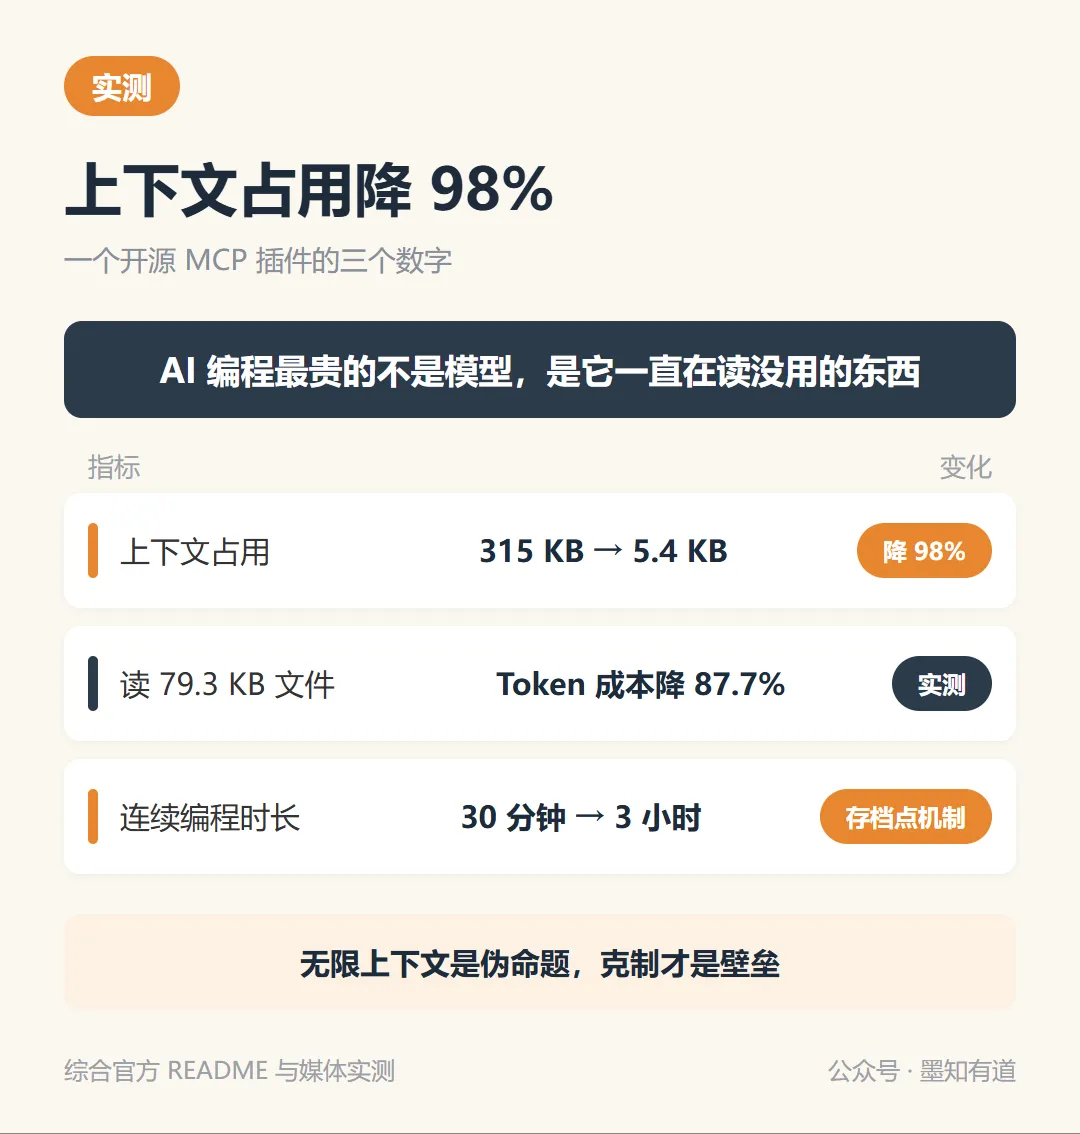
· 上下文占用:315 KB → 5.4 KB,**降 98%**
· 读一份 79.3 KB 文件:Token 成本**降 87.7%**(《智能涌现》实测)
· 连续编程有效时间:30 分钟 → **3 小时**
04|普通人怎么用
它是 MCP 插件,不用换 IDE、不用改工作流。
- 装:作为中间件接入你现有的 AI 编程环境(官方支持 15 个平台)
- 用:正常写代码,它在后台拦掉无效的数据读取
- 看:输入快捷指令,浏览器弹出本地统计面板,能看到这周省了多少 Token
门槛比换一套 IDE 低得多——这是它能在两周内火起来的原因。
05|它给的三个启发(比工具本身值钱)
① 无限上下文是伪命题。
行业都在卷 100K、1M 上下文,但这可能是个陷阱。把几十 KB 报错日志一股脑倒给 AI,只会加速它失忆和幻觉。真正的解法不是扩容,是克制。
② 别把大模型当数据处理器,当代码生成器。
很多人的习惯是把 50 个文件读进上下文让模型「数一数」。更好的做法是让模型写个脚本去数。思路一换,成本差百倍。
③ 瓶颈不在模型聪不聪明,在上下文管理。
大家抱怨 AI 老在同一个 Bug 上反复跌倒——不是模型变笨,是它在冗长对话里迷失了。
📌 今晚就做(5分钟)
回想一下你用 AI 干活的习惯,问自己一句:
我刚才是不是把一大堆原始数据直接贴给它了?
如果是,试试换个方式:让它写一段脚本、或者只贴关键结论。这一个习惯的改变,能省掉你大部分 Token 账单。
最后一句
大家都在等更强的模型,但真正的差距,常常在于谁更会管住喂给 AI 的东西。
克制,才是这个时代最稀缺的能力。
◆ ◆ ◆
🔧 关注「墨知」,每天一个能直接抄的 AI 神器实战。
📦 回复「工具包」领《AI 工具实战清单》|每晚 20:30 更新
延伸阅读
👋 你用 AI 干活时,有没有发现自己一直在「喂没用的东西」?留言聊聊。 这里是「墨知」,只写 AI 工具怎么真正用起来。 关注后回复「工具包」,领《AI 提示词实战手册》:五要素骨架 + 6 个高手模式 + 20 个可直接抄的模板。