ARTICLE · 1207840
RAG效果不好,可能从文档切片就错了
RAG 是 Agent 的重要组成部分,关键且基础。但是我们很容易有个经验:RAG在文档量很少的时候,效果不错,文档数量一旦多起来,就会出现检索不准的问题。很多人就会得出RAG不过如此,或者RAG已然过时的结论。其实经过学习我了解到:RAG结果不准,要先检查切片的思路——有时候,我们入库切的那一刀,已经决定了检索质量的上限。
1. 上周最小 RAG 遗留的问题
上周的最小 RAG 能跑、能引用、能拒答,但留了一个尾巴,有四个关键任务没有完成:
切片只有一个按标题切片的策略,且 max_chars=480是拍脑袋定的,检索效果看运气。只支持 Markdown 文档,PDF 和网页解析等其他文件格式没有涉及。 增量更新停在文档级,每改一个字,整库的块全部重新嵌入,成本高。 引用只在"块"粒度,答案和引用的对应关系没有程序化校验。
这次我们重点来先看切片策略,即"块切多大、在哪里下刀"。PDF 解析和增量更新我们留在下一篇详细讨论,程序化校验我们放在专门的 RAG 测评专题里后面讨论。
2. 解决问题要弄懂的几个关键概念,以及我个人的理解
(这部分来自我第 9 周的学习笔记)
在哪下刀:四种切片策略
重点说一下递归切片。它是非常主流的默认切片方式,能兼顾切片效果和切片成本,著名的框架LangChain使用的就是它。它的机制其实是分隔符优先级逐级降级:先按空行切段落,某段还超长才降级按换行切,再不行按句子切,实在超长才按字符硬切。
按标题切是上周和本周的实际主要用法,值得多说两句。它是顺标题层级把文档切成节,一节一块,标题路径随手记下,引用溯源零成本。它的短板是长短不均:有的小节三千字,远超块上限;有的就两行,单拎出来没法用。工程上的补救是叠着用:先按标题切节,节内超长就按段落打包成多块(上周的 chunker 就是这个写法),实在超长的段落内部再套递归,碎块并进相邻块。
四种切片方法怎么选?我们一般从文档类型和预算强度两方面考虑。
文档自带语义边界(标题、章节)就顺边界切,语义完整性高,成本低,我们对 Markdown 语料选按标题切就是这样考虑的。反过来,如会议记录等没有任何结构标记的文档,按标题切直接失效。这种场景我们预算足够就按语义切(因为人说话有话题流转,正好检测转换点),预算紧张就用递归来兜底;
固定长度一般只当对照组或最后的兜底手段,不作首选。
切多大:太大太小都会翻车
块切太小会导致单个块语义残缺,检索命中了也只是拿到一部分信息,模型拿到半句话照样答不对;另外,检索阶段的 Top-K 本来就是稀缺资源,切太细会导致一个完整答案被拆成 N 块,Top-K 的名额很快就被一个答案吃光了,宝贵的召回位被低效占用。
块切太大,向量被多个话题平均,导致与具体问题的相似度不够尖锐,同时单个证据还会占用数百个 Token 的上下文预算,挤占其他召回片段的可用空间。
Overlap(相邻块的重叠)防的是关键句正好被切在边界上。一般设置为块大小的 10%~20%,如块大小 500~1000 字、重叠 50~100 字。不能用固定值,如"固定 50 字",2000 字的块配 50 字重叠形同虚设。当然,按标题或语义切分时边界落在自然断点上,重叠可以很小甚至为 0。
那块大小到底设多大?
网上流传"大家都设 512"。512 指块的上限取 512 个 token(中文约 500 字),这个数有历史根源:BERT 时代的嵌入模型位置编码上限就是 512(模型一次能读的最大 token 数),块切得再长,超出的部分也进不了向量,512 于是成了事实标准,又被教程和示例代码一路抄到今天。
现在这个前提变了:bge-m3 的窗口是 8192,块大小的瓶颈不在模型窗口,在切片语义和上下文预算(就是前面说的两头翻车)。不拿自己的语料验证,就想当然的教条式抄512不可取——要拿自己的文档的评测集通过实验来确定,方法跟第 8 周扫拒答阈值完全同构:把扫描对象从阈值换成切片参数,对每组参数跑评测集比 Recall@K。本周的对照实验就是这么设计的。
3. 概念在代码里的实现
核心思路:切片策略做成可切换的插槽,块大小交给评测集裁决。
上周的 Chunk、content_hash、make_embedder 工厂全部沿用,切片部分这周动了两处:按标题切分器升级,递归切分器新写。
① 按标题切:围栏代码块与标题路径栈
上周的按标题切分器这周升级:多了一个围栏代码块的状态位,标题路径栈照旧。
HEADING_RE = re.compile(r"^(#{1,6})\s+(.+?)\s*$")defsplit_sections(md: str) -> list[Section]:"""按标题切节:代码块里的 # 不算标题,表格整表跟当前节走。""" sections, stack, in_fence = [Section("(开头)")], [], Falsefor line in md.splitlines():if line.lstrip().startswith("```"): in_fence = not in_fence # 围栏代码块开/关 m = HEADING_RE.match(line)if m andnot in_fence: # 块外的 # 才是标题 level, title = len(m.group(1)), m.group(2) stack = stack[:level - 1] + [title] # 标题路径栈:父 > 子 sections.append(Section(" > ".join(stack)))else: sections[-1].add(line) # 正文行(含表格行)归当前节return sections关键设计:一个布尔值挡掉代码块里的 #,表格行跟着当前节不跨块。切出来的节天然带"第3章 > 3.2 向量检索"这样的路径,溯源零成本。节内段落打包沿用第 8 周的写法:超过 max_chars 开新块、相邻块带 overlap 段落,超长小节内部再套 ② 的递归。
② 递归切片:分隔符逐级降级
SEPS = ["\n\n", "\n", "。", "!", "?"] # 优先级:段落 > 换行 > 句子def_leaves(text: str, seps, max_chars: int) -> list[str]:if len(text) <= max_chars:return [text]ifnot seps: # 兜底:字符硬切return [text[i:i + max_chars] for i in range(0, len(text), max_chars)] sep, rest = seps[0], seps[1:] parts = text.split(sep)if len(parts) == 1:return _leaves(text, rest, max_chars) # 切不动 → 降下一级 out = []for p in parts: out.extend(_leaves(p, rest, max_chars)) # 超长片段各自继续降级return outdefrecursive_split(text, max_chars, overlap_ratio=0.15):return _pack(_leaves(text, SEPS, max_chars), max_chars, overlap_ratio)关键设计:降级的意思是能不硬切就不硬切,段落装得下就不拆句。overlap 按 max_chars 的 15% 取,按比例、不按固定字数。
跑起来:不同切片的检索效果对比
本周还有一段核心代码是做切片策略效果对比。
我们期望文档出现在 Top-K 证据里算命中,只测检索、不看回答文本,也不经过拒答阈值。向量用本地 bge-m3,检索取 Top-5,统计四个指标:Recall@3(期望文档进没进前 3 名,进了就算命中)、Recall@5(同一条门槛放宽到前 5 名)、Top-1(期望文档是不是第 1 名)、MRR(每题按期望文档的首命中名次取倒数再平均:第 1 名记 1 分,第 3 名记 0.33 分)。Recall 管"找到没有",Top-1 管"是不是第一",MRR 管"平均排多前"。
判分核心就五行(完整评测脚本在 week9_rag.py 的 compare 命令里):
top_docs = [s.chunk.doc for s in pipe.retrieve(case["q"])] # 前 5 名的文档名hit3 += case["expect_doc"] in top_docs[:3] # Recall@3:进前 3 算命中hit5 += case["expect_doc"] in top_docs[:5] # Recall@5:门槛放宽到前 5top1 += top_docs[0] == case["expect_doc"] # Top-1:第 1 名就是它rr_sum += 1.0 / (top_docs.index(case["expect_doc"]) + 1) # MRR:名次取倒数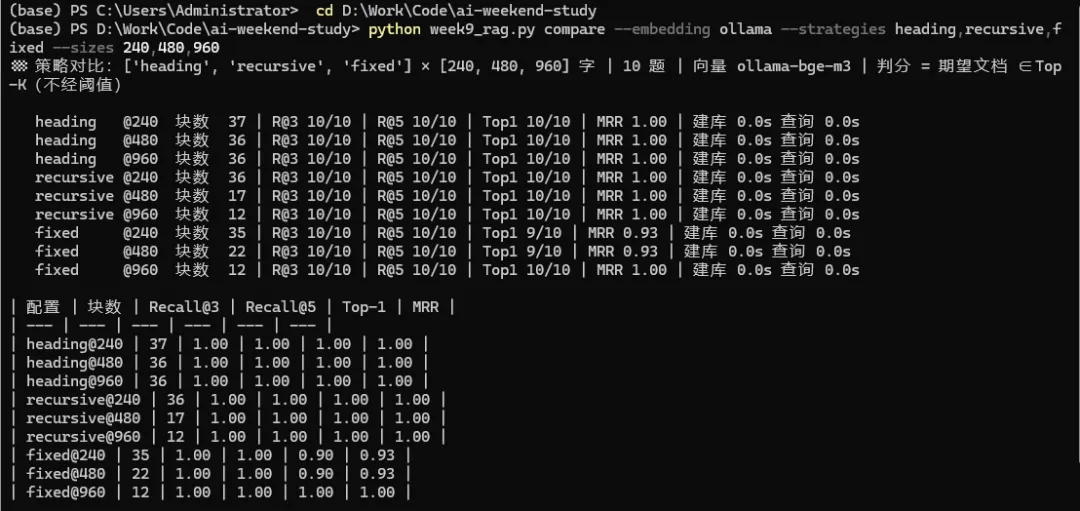
几个位置反常识需要重点解释:
九组配置的 Recall@3 / Recall@5 全部打满。这不是不同的切片效果一样,而是这道评测的判分粒度太粗:只要期望文档挤进 Top-5 就算命中,12 篇文档的小库里这个门槛很容易过(这也是很多知识库少量文档感觉很准,文档一多效果就变差的原因)。真正分出高下的是排序指标:固定长度切在 240 和 480 两档 Top-1 掉到 0.90、MRR 0.93,其余七组全满。 固定长度切@960 满分,理论上不应该,实际因为12 块基本一篇一块。"太大平均化"伤的是多主题长文,这批文档单篇单主题,整篇一块反而语义完整;它的代价在上下文预算,不在排序。
固定长度切掉分的是同一道题:"两份知识文档说法冲突时按什么规则裁决?"答案在 07 号文档的冲突裁决一节。固定长度切@480 把这一节和相邻内容混在一块,关键句被摊薄,第 1 名变成了 12 号学习路线图--它只是在概述里提到过这个话题。按标题切下这一节完整成块,稳居第 1。这就是块边界落在语义边界上的排序收益。
本次模型和关键配置:
向量 Ollama bge-m3(本地,零 API 费用); 切片三种策略(按标题切 / 递归切 / 固定长度切)× 块上限 240/480/960 共九组; 检索 Top-5; 块长度分布检查过,36 块集中在 76~291 字、单峰无双尾(直方图在仓库 logs/)。 生成模型本周不出场,切片实验只测检索。
样本局限:评测题沿用上周那 10 道文档内问题,自出自评;判分是文档级的——期望文档进 Top-K 就算命中,同一篇文档内部切得好不好区分不出来,这也是九组 Recall 饱和的主要原因;10 题里 1 题的差距说明不了什么,差异小于 2 题的对比一律视为持平;语料 12 篇、几十个块,对大库不保证成立。
4. 我踩过的坑
Markdown 格式文档按标题切说起来简单,真升级切分器时 Markdown 给了我三个下马威:# 只是注释,却被当成标题,凭空切出好几个不存在的节 | ||
5. 当前代码存在的问题与适用范围
已知问题清单:
适用范围:
语料自带结构(Markdown 标题、书籍章节):顺边界切,语义完整性白拿,这是最便宜的优化 "对照组 + Recall@K"这套选参数的方法本身:换任何文档集都适用
会翻车的情况:
无结构纯文本(会议记录、聊天导出):按标题切失效;预算够上语义切,预算紧用递归兜底 抄默认参数:换文档集,就重跑一遍评测
6. 给读者的提问
给大家留四道我学习时答错或卡壳的原题,答案都在正文里:
递归切片到底怎么"递归"?如果一段话按空行和句子都切不开,接下来会发生什么? "大家都设 512"为什么不可信?换一批文档、换一个向量模型,这个参数要怎么办?(提示:想想上周的拒答阈值是怎么定出来的) 会议记录没有任何结构标记,按标题切直接失效。预算紧的情况下选哪种切片策略,判断依据是什么?(提示:跟句子长短没关系) 你手头的知识库是什么格式,Markdown、Word、PDF 还是网页?如果只能选一种切片策略,你选哪个,依据是什么?评论区聊聊。
7. 结尾
切片的债还上了:策略有了对照组,参数有了实验数据。但欠条上还压着两件事:其他格式的文件切片还没进过库,文档改一个字还是要重嵌整库。这些如何处理?下一篇《改一个文件,为什么要重嵌整个知识库?》我们继续说。
如果你也想跟着跑一遍,请关注我并私信我,我会把我的代码共享给你