ARTICLE · 1211272
AI芯片的下一场竞争,为什么发生在软件层?
过去两年,AI芯片行业一直在探索一个问题:如何让大模型走出数据中心,进入个人电脑、机器人等更多终端设备?
随着模型压缩、量化和推理优化技术不断进步,大模型逐渐具备在功耗受限的设备上运行的条件。与此同时,越来越多芯片厂商推出面向端侧推理的产品。
终端市场也在释放新的需求。研究机构Gartner在2025年8月曾预测,2026年全球AI PC出货量有望达到1.43亿台,占整体PC市场的55%。尽管这仍属于预测,但AI计算的确正在成为个人终端的重要发展方向。
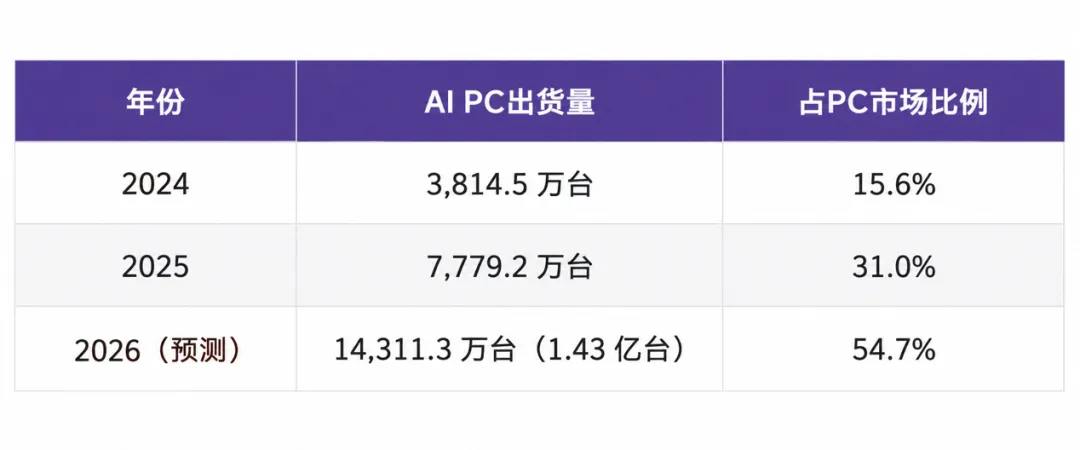
(来源:Gartner)
不过,让模型在设备上运行,与做出一款成熟的AI产品之间,仍有不小的距离。
一颗芯片即使拥有出色的算力和能效,装进笔记本电脑后,仍需要解决电源管理和系统调度问题;一套模型即使在测试环境中运行稳定,进入实际产品后,也要应对长时间推理、多任务并发和软件兼容等挑战。
对于终端厂商来说,选择芯片时需要考虑的,除了硬件性能,还有开发工具是否成熟、能否及时支持新模型,以及后续产品开发和升级需要投入多少资源。这意味着,端侧AI芯片的竞争需要向硬件之外延伸。而从英特尔、高通到英伟达,多家芯片厂商已经围绕模型部署、开发工具和系统软件进行了长期布局。
当大模型开始进入更多终端设备,软件能力为何变得越来越重要?这一问题也可以从近期国内芯片企业的产品实践中找到答案。

端侧AI
开始进入产品交付阶段

早期的端侧AI应用相对简单。手机通过本地模型完成语音识别、拍照优化,电脑运行一些辅助功能。这些任务边界明确,计算需求也相对固定。
Agent(智能体)的兴起改变了这种情况。一个持续工作的Agent,需要理解用户意图、调用工具、检索文件,并根据执行结果反复推理,还可能同时处理语音、视觉等信息。
模型变得更精简,为本地部署创造了条件;Agent执行更复杂的任务,又带来了持续推理和多任务处理的需求。端侧芯片由此需要兼顾更多指标:除了TOPS(每秒万亿次运算),内存容量、存储带宽、功耗、散热和系统调度,都会影响实际表现。
更复杂的问题来自终端之间的差异。AI PC关注算力、功耗与续航,家庭设备重视长期运行和噪声控制,机器人对响应延迟更加敏感,边缘服务器则需要考虑计算密度与部署成本。即使采用同一颗芯片,不同设备仍可能需要大量独立的系统开发。
长城N90 Pro笔记本电脑提供了一个具体案例。围绕搭载的后摩智能M50芯片,长城、后摩智能与麒麟软件进行了联合开发,其中一项重要工作是电源管理。
与服务器不同,笔记本需要频繁在运行、空闲和睡眠状态之间切换,AI模块必须与操作系统的电源策略配合,避免不必要的电量消耗。经过联合调试,该产品的AI模块空闲功耗降至约0.35W。
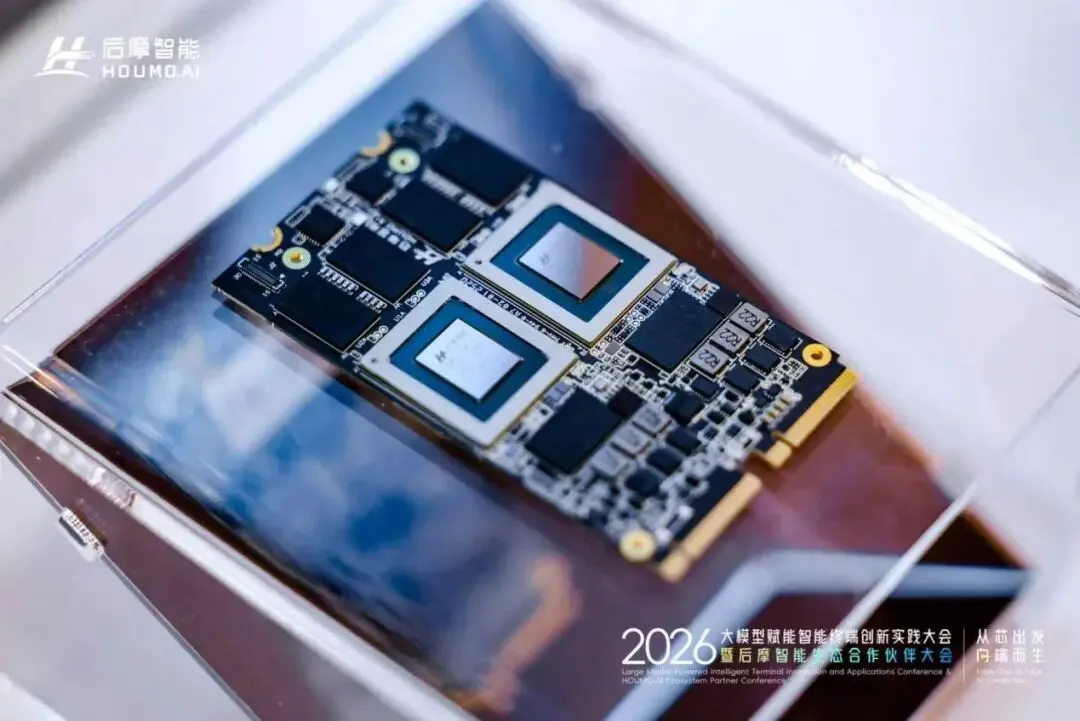
图|搭载后摩智能M50芯片的AI加速卡(来源:后摩智能)
这说明,硬件性能需要经过系统级优化,才能转化为实际的产品体验。对芯片厂商而言,交付芯片之后,还需要参与解决整机开发中的具体问题。
类似的工作也不会随着产品上市而结束。新的模型和推理方法不断出现,芯片厂商需要持续更新编译器、算子与推理框架,才能让已有设备获得新的AI能力。

从硬件创新,到软件易用性

在整机的电源管理、系统调度之外,开发者还面临另一个问题:如何让不同框架开发的AI模型,更方便地运行在不同芯片上?
目前,主流大模型通常基于PyTorch等深度学习框架开发。部署到终端设备时,还需要借助推理框架和编译工具链,将模型中的计算操作转换为芯片能够执行的指令。
这一过程涉及算子适配、模型转换、量化精度和计算调度等多个环节。不同芯片采用的计算架构、数据格式和指令体系存在差异,开发者可能需要针对具体硬件进行额外优化。对于采用新架构的AI芯片,软件适配的重要性更加凸显。
如果每更换一款芯片,都需要投入大量软件开发资源,即使硬件具备性能和能效优势,也可能因为适配成本过高而难以推广。因此,降低模型部署门槛,已经成为芯片厂商完善软件生态的重要方向。
英特尔推出的OpenVINO,是一套面向AI推理的开源工具,支持将PyTorch、TensorFlow等框架开发的模型转换和优化,并部署在英特尔CPU、GPU和NPU等不同计算单元上。高通的AI Hub则提供经过硬件优化的模型、设备测试工具和应用样例,帮助开发者完成模型转换、性能分析和终端部署。
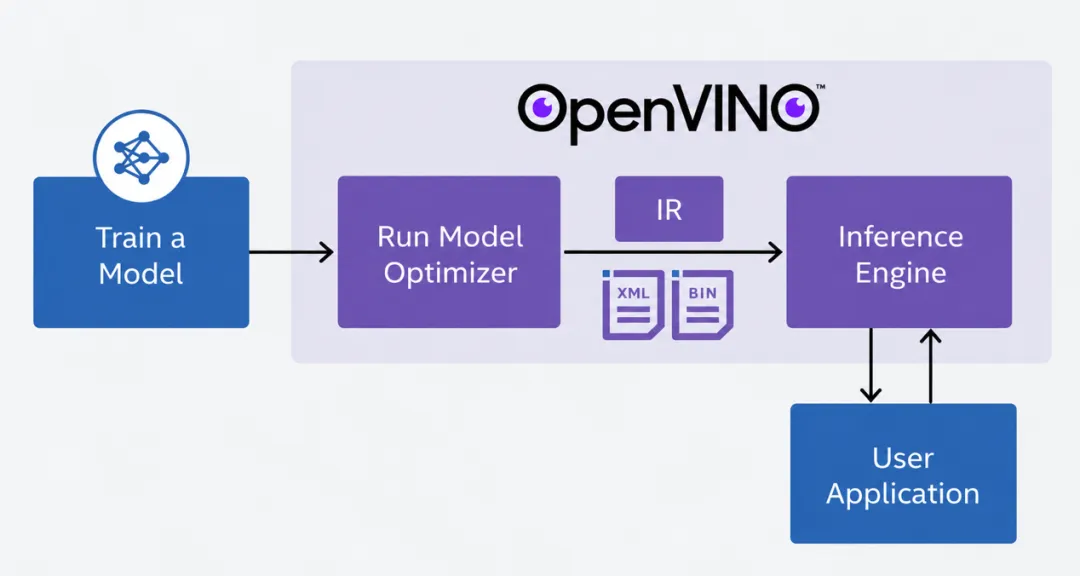
图|OpenVINO模型优化与推理部署流程示意,展示模型从转换、编译到执行推理的主要环节(来源:英特尔)
两家厂商的产品定位有所不同,但都在尝试减少模型从开发环境进入真实设备所需的适配工作。这也是芯片企业从提供硬件,走向提供完整开发平台的重要一步。
10月14日,后摩智能宣布开源面向上层应用的AI生态软件,涵盖推理框架、模型资源库、领域开发套件和应用样例等。其背后的问题具有行业共性:如果每个终端项目都需要重新完成模型部署与软件适配,芯片厂商和客户的工程投入都会随之增加。将已有经验沉淀为可复用的工具,是降低开发成本的一种方式。目前,后摩生态软件已与vLLM、llama.cpp、SGLang等主流推理框架完成适配,超过95%的客户基于其ModelZoo进行产品开发。
这里存在一个值得关注的关系。芯片厂商需要通过差异化的硬件架构建立竞争优势,但对开发者来说,成熟、统一的软件接口更有利于快速完成产品开发。硬件可以采用不同技术路线,开发者却希望尽可能沿用熟悉的工具。
不过,支持模型运行,只是软件能力的一部分。文档是否完整、接口是否稳定、新模型能否及时得到支持,都会影响客户的实际研发投入。即使两个平台都宣称支持同一款模型,部署难度和运行效率也可能存在差异。

端侧AI的下一道壁垒,是生态

当软件工具逐步成熟,芯片厂商还需要面对一个更长期的问题:如何让开发者愿意持续使用自己的计算平台?
英伟达CUDA提供了一个成熟的参照。长期积累的计算库、开发工具和开发者资源,使AI开发者在选择GPU时,除了考虑硬件性能,还会考虑代码能否复用、工具是否成熟,以及能否获得持续的软件支持。后来者即使推出性能出色的硬件,也很难在短时间内建立同等规模的软件支持体系。
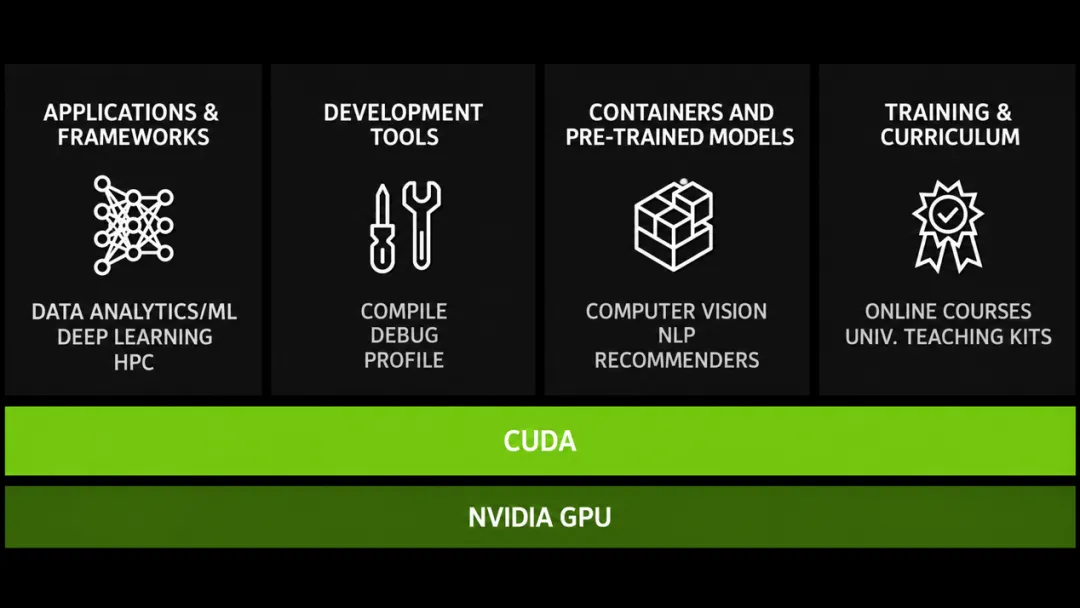
图|英伟达CUDA软件生态示意图,涵盖编程语言、计算库、开发工具等多个组成部分(来源:英伟达)
不过,端侧AI市场存在更多差异。AI PC、家庭智能设备、机器人和边缘服务器采用的CPU、操作系统和模型框架各不相同,主流产品形态也仍在变化。
芯片厂商很难提前判断哪些终端会形成稳定需求。如果围绕某一种设备建立高度专用的软件体系,一旦市场变化,原有的开发投入就可能难以复用。在底层保留硬件架构和编译优化能力,同时开放上层开发工具,与模型、操作系统和终端厂商共同完成产品适配,是一种可行的选择。
但开源并不意味着生态能够自然形成。开发者是否愿意参与,还取决于工具能否持续维护、问题能否及时解决,以及开发成果能否在不同设备之间复用。
(来源:后摩智能)
软件生态也可能反过来影响芯片设计。过去,芯片厂商通常先确定硬件架构,再由软件团队围绕既定硬件开展优化。随着端侧应用快速变化,终端厂商反馈的内存占用、推理延迟和多任务并发等问题,也可以为下一代芯片的架构设计提供依据。
当同一套软件平台连接起更多终端,芯片厂商就有机会发现不同应用中的共性需求,并将这些经验用于后续研发。软件生态的价值,由此延伸到了硬件迭代本身。
当然,端侧AI仍处于市场探索阶段。哪些设备能够形成稳定需求,本地计算相较云端究竟能节省多少成本,都需要通过实际应用验证。软件工具可以降低开发门槛,却无法替代真实的产品需求。
下一阶段,衡量端侧AI芯片竞争力的标准,除了算力和能效,还将包括开发者能否以合理成本完成部署,以及产品能否获得持续的软件支持。从一颗芯片到一套可持续复用的计算平台,端侧AI的竞争正在向更深层次展开。
整理 | 信睿科技评论

thethinker@citicpub.com