ARTICLE · 1218941
UM表不是Excel:厂务需求数据的正确打开方式
做厂务设计的工程师,大概都经历过这样的早晨:
打开邮箱,收到客户发来的UM表——文件名是"工艺设备需求表-FINAL-v8-真的最终版.xlsx"。点开一看,心里咯噔一下:和上一家客户的格式,又不一样。
设备代号这栏,有的写"ETCH",有的写"刻蚀",有的写"E-01";系统需求散在三个sheet里,有的还是合并单元格;Pumpingline的连接关系,有的画在CAD里,有的写在备注栏,有的……没有。
你深吸一口气,开始复制、粘贴、拆分、改名、核对。半天过去了,图纸还没画一张,Excel先改了三百行。
UM表是什么?它是整个厂务设计的"总开关"
UM表(Utility Matrix,厂务需求矩阵)是工艺设备对厂务系统的全部需求的清单:这台机台要不要冷却水、真空、压缩空气、特气、排风,各要多少量、什么参数、从哪个接口接——全在这张表里。
机台动辄几百上千台,每台十几个系统接口,上万条数据。厂务设计的每一个数字,源头都在UM表里。
这一点常被低估:UM表不只是二次配的源头,更是主系统设计的核心数据来源——纯水站配多大、CDA装机容量、真空系统分几个区、排风量怎么平衡,本质都是把UM表几万条需求按系统汇总、加预留、做计算。主系统容量的对错,直接决定造价和运行能耗,而这些计算的输入,和二次配P&ID是同一张表。
换句话说,UM表是整个厂务设计的"总开关"。开关拧歪了,主系统容量错,二次配图纸错,后面全错。
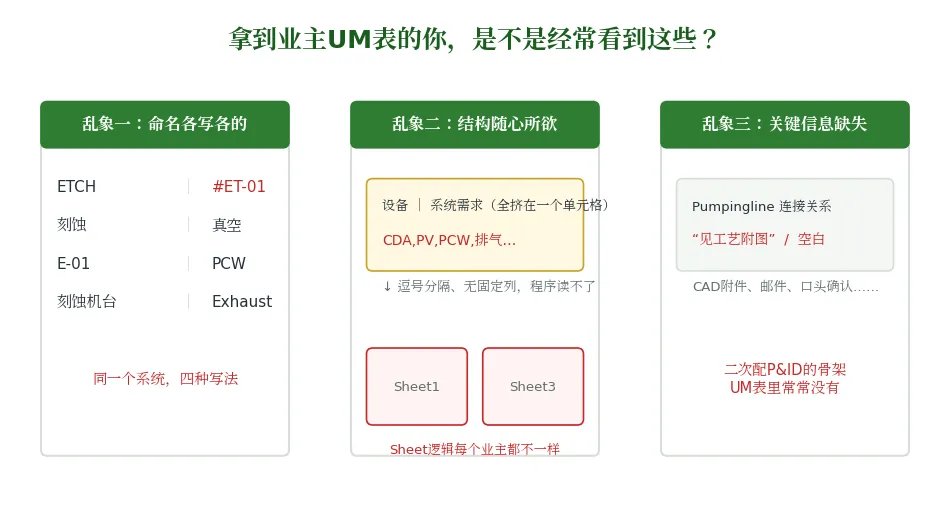
▲ 业主UM表的三大典型乱象
现实是:拿到UM之后,大家都选择了"直接干活"
十几年来我们接触过的设计院和工程公司,拿到业主UM表之后的操作惊人地一致:不做整理统一,直接干活。
原因很朴素——整理的工作量太大了。几百上千台设备、上万条数据,逐条核对、统一命名、补齐缺漏,一个熟练工程师要干一到两周。而项目工期从收到UM那天就开始倒计时,没有人愿意为"整理数据"这种不产生图纸的工作买单。
于是每个项目都是:拿到什么格式就用什么格式,画完图、交完工,UM表随手一存,项目结束。
然后呢?没有然后了。
下一个项目,新的一家业主,又发来一个新的"最终版",Excel大战重新打一遍。上一个项目踩过的坑、校对过的数据、摸清的机台规律,随着项目解散,烟消云散。
这才是最大的浪费:干了十年,企业什么都没留下
站在企业角度算一笔账:一个设计院十年做了五百个电子工业项目,手里应该有五百套UM数据。如果这些数据是统一格式的,意味着什么?
意味着新项目投标阶段,就能快速检索"同类厂同类机台的真空需求分布",报价更准;意味着主系统容量计算有历史数据对标,"同时使用系数取多少"不再靠拍脑袋;意味着工艺设备清单一拿到,半天就能出全套需求汇总,把竞争对手还在整理Excel的时间,用来打磨方案。
但现实是,五百套UM以五百种格式躺在五百个文件夹里,无法检索、无法汇总、无法复用。
企业真正值钱的资产不是图——图是死的;是数据。而数据资产化的第一步,就是UM表的标准化。可惜这一步,因为"工作量太大",被整个行业集体跳过了十年。
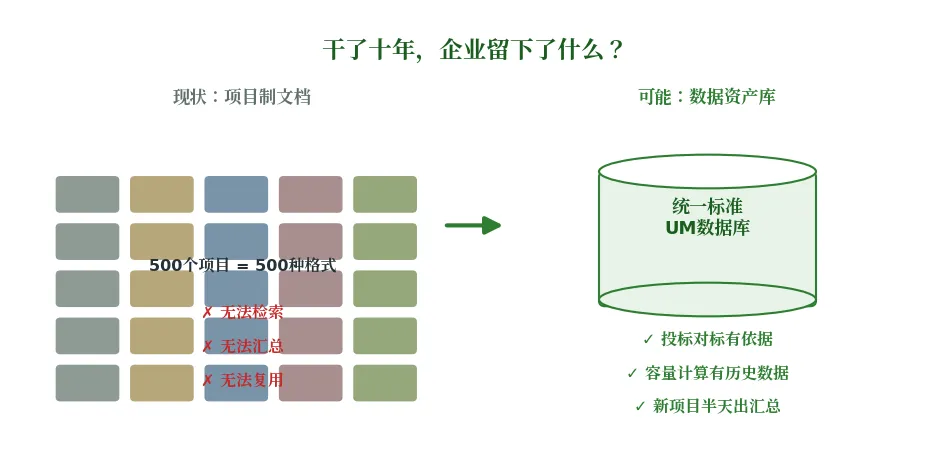
▲ 项目文档 vs 数据资产:差距从UM表标准化开始
正确打开方式:UM表应该是一张"结构化数据表"
那标准的UM表长什么样?抓住五个要素:
1. 设备标识唯一:设备位号、设备代号统一编码,一台机台一行基准数据;
2. 系统名称规范:按行业标准统一系统代号,全项目一套语言(SJ/T 11927—2024对电子工业厂务系统代号有明确规定);
3. 需求参数完整:每个系统的需求值、单位,列结构固定——注意,单台设备按厂商额定值忠实记录,不在UM表内乘系数;
4. 连接关系显式表达:Pumpingline等设备间连接关系,用结构化字段表达(如排风组编号+组内序号),不写小作文;
5. 结构统一、可机读:不使用合并单元格、表头唯一——让程序能直接读。行粒度两种形式均可:单机台UM表一行一个系统,多台设备汇总的UM表一行一台设备,只要同一项目内结构统一就行。
关于系数,再多说一句:同时使用系数是系统层面的事——把各机台需求按系统汇总后,再按业主设计标准乘上系数(一般是小于1的折减系数),得出系统设计量,作为管径和设备选型的依据。UM表的责任是忠实记录单台额定需求,系数取值和汇总计算留给主系统设计环节,各管一段,数据才不会乱。 另外,UM表的行粒度没有唯一标准:单机台需求表一行一个系统,便于逐系统提资;多台设备的汇总表一行一台设备、系统分列,便于项目级统计——两种都是标准做法,关键是同一个项目、同一个企业内保持结构统一。
做到这五条,这张表就不再是"给人看的Excel",而是一条从主系统容量计算到二次配P&ID、再到物料清单的数据流水线的源头。更值钱的是——它格式统一,可以入库,十年五百个项目的数据能摞在一起用。
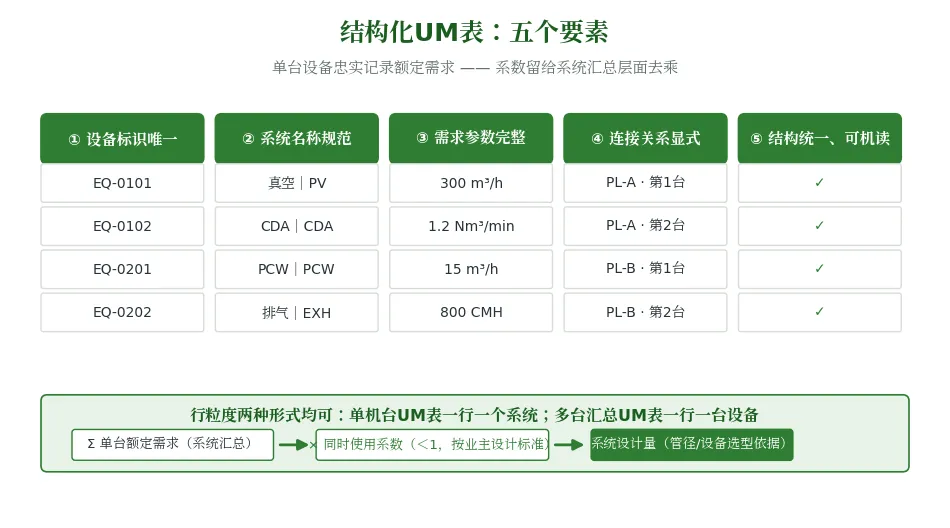
▲ 结构化UM表的五个要素(示例数据为示意,系数在系统汇总层面乘)
AI时代的新变量:数据成了训练智能体的"燃料"
这两年所有人都在谈AI。但真正做过落地的人都明白一个道理:AI的上限不是模型决定的,是数据决定的。
同样一个设计智能体,喂给它五百套格式杂乱的UM,它学到的是噪音;喂给它五百套标准化、高质量的UM,它学到的是规律——哪类机台的真空需求服从什么分布,同时使用系数跟什么参数走,不同工艺路线的用气特征是什么。前者让AI变笨,后者让AI长成一个"老司机"。
这件事对设计院和工程公司意味着一个残酷的排序:行业里的AI竞争,拼的不是谁先用上AI,而是谁手里有能喂AI的数据。竞争对手的标准化UM库先建成,他们的智能体就先学会、先上岗、先把设计成本打下来——而你那五百种格式的Excel,连被AI读取的资格都没有。
所以UM表标准化不只是资产沉淀,它是AI时代的入场券,是企业能不能快速完成数字化转型的分水岭。
过去我们说"数据是资产",多少还有点抽象;今天有了AI,这句话变得无比具体:高质量数据 = 会干活的智能体 = 实实在在的人均产能。
那……整理成本谁出?
这是关键问题,也是过去十年没人做这一步的真正原因。
我们的答案是:不该让工程师手动整理,该让软件去适应。
我们做设计软件的团队,这几年一边被各种"自由格式"的UM表折磨,一边在训练设计智能体——两头的工作让我们对"数据质量决定AI上限"有了切肤之痛。所以我们干脆写了个智能体:把业主发来的UM表丢进去——sheet结构不同没关系、命名不规范没关系、中英文混写没关系——它自动识别、清洗、映射成标准结构,输出一张可以直接进设计流程、将来也能喂给AI的规范化UM表。
整理成本从"一到两周"压缩到"一杯咖啡的时间",这件事才终于有可能发生。而一次整理、终生受益:这张标准表进库,既是企业数据资产的又一块砖,也是未来智能体的口粮。
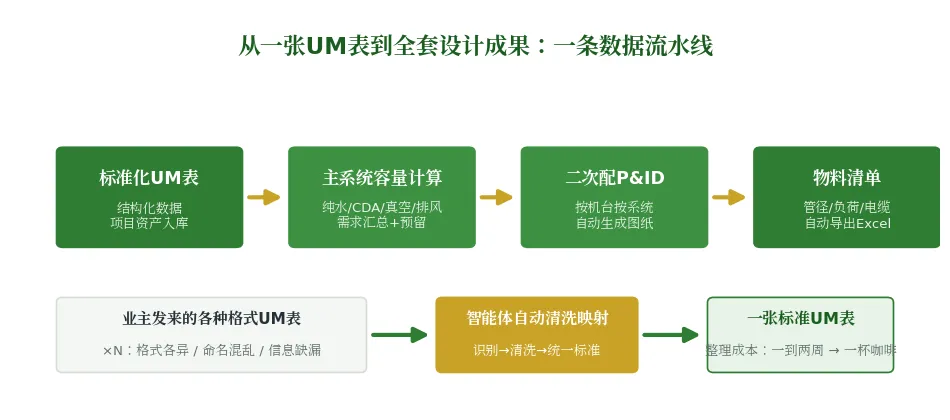
▲ 从UM表到全套设计成果:智能体 + 数据流水线
写在最后
半导体扩产的窗口就这么几年,但比赶工期更重要的,是趁项目多的时候把数据资产攒下来。潮水退去的时候,手里有数据的企业和只有文件夹的企业,报价的底气是不一样的。
AI的浪潮不等人。企业数字化转型的快慢,差距不在买不买得起AI,而在有没有高质量的数据——而这条路,第一步就是UM表的标准化。
下次我们聊聊:拿到规范的UM表之后,从主系统容量计算到二次配P&ID,是怎么一条流水线"长"出来的。