ARTICLE · 1219185
一次 AI 流式对话请求的一生(下):回答如何实时流回 Vue
发布时间:2026-10-21 00:05:53 最近访问:2026-10-21 00:05:56
一次 AI 流式对话请求的一生(下):回答如何实时流回 Vue
在上篇中,请求经过 Vue、Spring Boot 网关和内部 HMAC 认证,请求终于获得了进入 FastAPI 的资格。这一篇从 FastAPI 收到请求开始,讲清楚回答是如何逐段生成,又怎样经过 Spring Boot 最终回到浏览器。一、FastAPI 如何把回答变成 SSE 事件
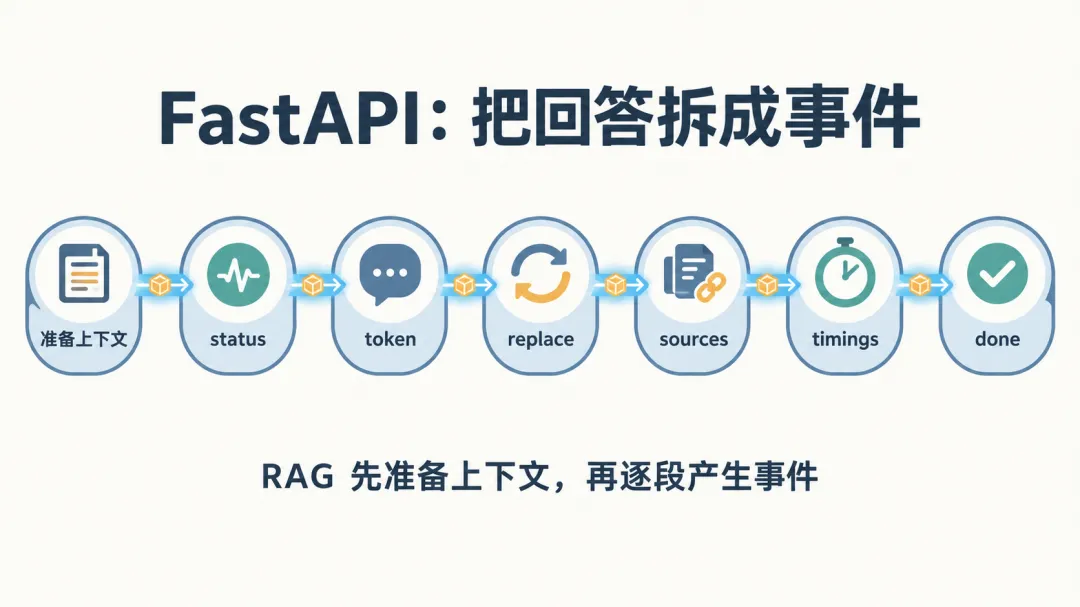
当请求进入 FastAPI 后,会调用 /api /chat /stream 接口,最终进入 RAG 的流式问答流程。RAG 并不会等整段回答生成完才返回。它会先完成查询改写、召回、重排和上下文准备,然后进入模型生成阶段。模型每产出一段内容,FastAPI 就会把这段内容包装成一个事件,然后通过 SSE 推送给 Spring Boot。在这里我们可以把这些事件理解为不同阶段的状态标签。token:一段新增的文本内容
error:生成过程中出现失败
sources:回答结束后对应的引用来源
timings:首 Token 时间、生成耗时和总耗时等性能数据
实际代码中还有 status、replace、confidence 和 done 等事件,分别表示当前状态、整体替换、置信度和流结束。如果等模型生成完整回答再返回,用户可能盯着空白页面十几秒,误以为是页面卡顿或者系统故障。而流式输出可以让内容生成一点,就显示一点。yield f"data: {json.dumps(event, ensure_ascii=False)}\n\n"
yield:每执行一次,生成器产出一个事件
data::告诉 SSE 客户端,这一行是数据
{json}:本次事件真正携带的 JSON 内容
\n\n:表示一个 SSE 事件结束
yield
→ 仓库准备好一件包裹,交给传送带
data:
→ 包裹上的运单字段,告诉接收方“下面是数据”
{json}
→ 包裹里的物品,也就是本次事件的内容
\n\n
→ 包裹之间的分隔符,表示当前事件到此结束
Python 生成器 yield 一个事件
→ FastAPI StreamingResponse 写入响应流
→ Spring Boot 读取并转发
→ Vue 解析事件并更新页面
Python 负责产生事件,Spring Boot 负责持续搬运,Vue 负责解析和展示。二、Spring Boot 如何把事件实时转给 Vue
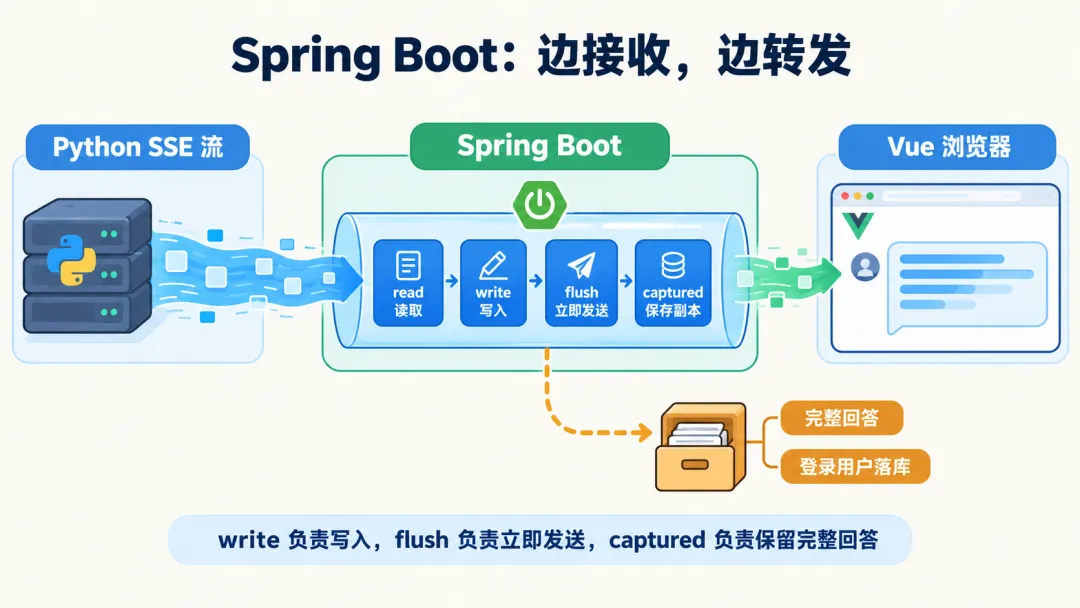
这个项目有意不让浏览器直接连接 FastAPI,而是让所有请求先经过 Spring Boot。因为这样做可以统一处理用户身份、游客 Cookie、会话保存和内部认证。FastAPI 返回的是一段持续到达的 SSE 流。Spring Boot 并不会等所有内容到齐后再统一发送,而是每读到一段,就立刻往浏览器写一段。读取一块
→ 写入浏览器
→ 立刻刷新
→ 另外保存一份
write:把刚收到的内容写入浏览器输出流
flush:推动这段内容立刻发送出去
captured:在服务端额外保存一份,用于最后拼出完整回答
因为数据写进输出流,不代表浏览器马上就能收到。Tomcat 或中间代理可能先把多段内容攒在缓冲区里,等攒够一批再发送。如果没有及时刷新,用户可能看不到“逐字生成”,而是过一会儿突然出现一大段,甚至等回答结束后才一次性显示。write
→ 把包裹放上传送带
flush
→ 按下“现在就发走”的按钮
captured
→ 同时给仓库留一份复印件
不过,flush 也不是万能的。如果前面还有 Nginx 之类的代理,它可能继续缓冲数据。因此,后端还需要关闭缓存和代理缓冲,让数据直接转发。当 Python 的流正常结束后,Spring Boot 会从 captured 中解析出完整回答。对于登录用户,这一轮问题和回答就会保存到数据库。游客的短期上下文则由 Python 和签名 Cookie 维持。Python 负责产生事件,Spring Boot 负责实时搬运,Vue 负责解析和展示。
三、流式请求失败时,会发生什么
但真实使用中,用户可能中途停止,网络可能超时,模型也可能生成失败。不是所有失败,都应该用同一种方式处理。
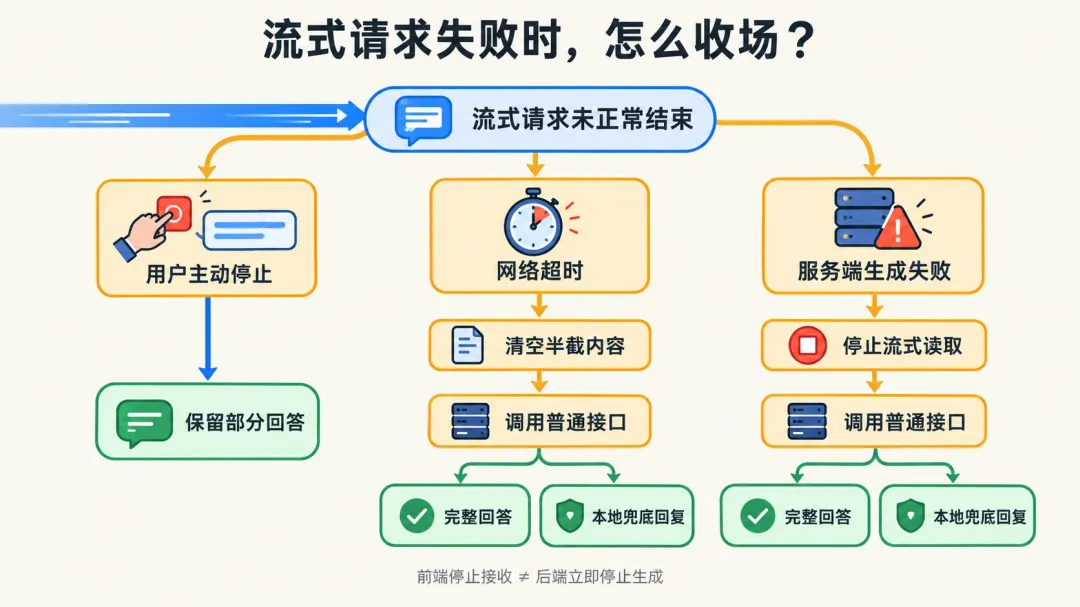
但这并不是系统故障,而是用户主动做出的选择。因此,前端不会重新请求完整回答,而是保留已经生成的内容。如果用户刚发送就停止,此时一个字都没有生成,前端便会删除空的 AI 消息气泡。如果请求长时间没有正常结束,前端会主动中断这次流式请求。用户停止:主动取消,保留已有内容
网络超时:请求失败,清空半截内容,尝试重新获取回答
普通接口不会逐段返回,而是等完整回答生成后一次性返回。如果这次请求成功,用户仍然能看到完整答案。如果普通接口也失败,前端会显示本地兜底回复,并提示后端暂时不可用。如果模型或 RAG 在生成过程中出错,Python 会发送一个错误事件。前端收到后,会停止读取当前流,并进入和网络超时类似的兜底流程:清空半截回答
→ 调用普通接口
→ 成功则显示完整回答
→ 失败则显示本地兜底回复
如果身份认证或内部服务认证失败,请求通常会在进入生成阶段前被拒绝。如果错误发生在流开始之后,前端更可能遇到连接中断,而不一定拿到标准错误信息。前端停止接收,不代表模型一定立刻停止生成。
用户点击停止后,浏览器会取消当前请求。但 Spring Boot 是否停止读取、FastAPI 是否停止生成、模型调用是否被取消,还取决于服务端如何处理断开的连接。因此,前端看起来已经停止,不一定代表后端资源已经完全释放。这一点需要通过日志和断连实验确认。如果流在中途断开,完整回答并不存在,这轮问答通常不会落库。四、AI 项目背后,仍然是软件工程
从表面看,这是一个 AI 项目:有聊天界面、有 RAG、有模型生成,也有流式回答。但把整条链路拆开后,我发现真正让它运行起来的,仍然是熟悉的后端基础。以前我会觉得,AI 对话的核心是去“调用模型”来回答问题。请求由谁发出?
身份由谁确认?
历史消息是否可信?
服务之间如何认证?
回答如何逐段返回?
失败以后怎么处理?
这些问题和模型本身关系不大,却决定了一个 AI 应用能否真正投入使用。一个请求进入 Controller、调用 Service、再返回结果,这看起来像一次普通的函数调用。但在真实系统中,它可能还要经过拦截器、网关、内部服务、数据库和第三方接口。流式输出不是后端返回一个“流”就自动完成了。它依赖整条链路:FastAPI 产生事件
→ Spring Boot 持续读取
→ 输出流及时刷新
→ Vue 解析事件
→ 页面更新内容
其中任何一层发生缓冲,用户都可能从“逐字生成”变成“等半天后突然出现一大段”。第三个变化,是我重新认识了“认证”和“失败处理”。认证并不只是用户登录,还包括服务之间的身份确认。失败也不只有一种结果,用户停止、网络超时和服务端异常,需要不同的处理方式。回头看,这些内容分别对应着 Java 后端的基础能力:拦截器和 Controller:请求进入业务前的边界
异步响应和输出流:线程、缓冲与流式传输
HTTP 客户端:服务之间的调用
Token、Cookie 和 HMAC:不同层次的信任边界
事务与保存时机:数据什么时候才算完整
所以这篇文章真正想说的,不是“我用 AI 做了一个项目”。AI 可以帮我写出能运行的代码,但只有把链路真正走一遍,我才能知道自己理解了哪些东西。
用户点击“停止生成”之后,后端真的停止生成回答了吗?