ARTICLE · 1219194
FDE与企业家必看:AI开发加速数倍之后,会带来什么新的问题?
「AI 只是让代码写得更快」
代码快了5 到 10 倍
值班呼叫器也响了 10 倍
可靠性悖论 · 构建更便宜 · 运行更昂贵
贝恩· 软件工程中的 AI
本文为贝恩咨询公司撰写的《软件工程中的 AI:可靠性悖论》。以下是原文译文,请品鉴。
PART 01
被遗忘的另一半
AIOps 与上下文
PART 02
给 CIO
运维组织是新的前沿
PART 03
给 CTO
SRE 的旧前提消失
PART 04
四条原则
领跑者与浅尝者
PART ///
写在最后
重新设计即战略
如果 AI 能让工程师编写代码的速度提高 5 到 10 倍,那么当代码正式发布后,所有依赖该代码运行的系统又会面临怎样的情况呢?
全文从这个问题展开
代码交付之后的所有工作,会发生什么变化?
内容概览
贝恩咨询公司(Bain)的一项调查发现,约半数企业预计,在未来一至两年内,许多软件工程任务将由 AI 主导。
AI 主导的开发正在缩短软件构建周期、降低构建成本,但软件运行成本却在悄然上升。
在我们的调查中,运维韧性的预期提升幅度落后于其他所有指标。
领先企业不只是应用 AIOps 工具,还在重新设计工作流、团队和绩效衡量方式。
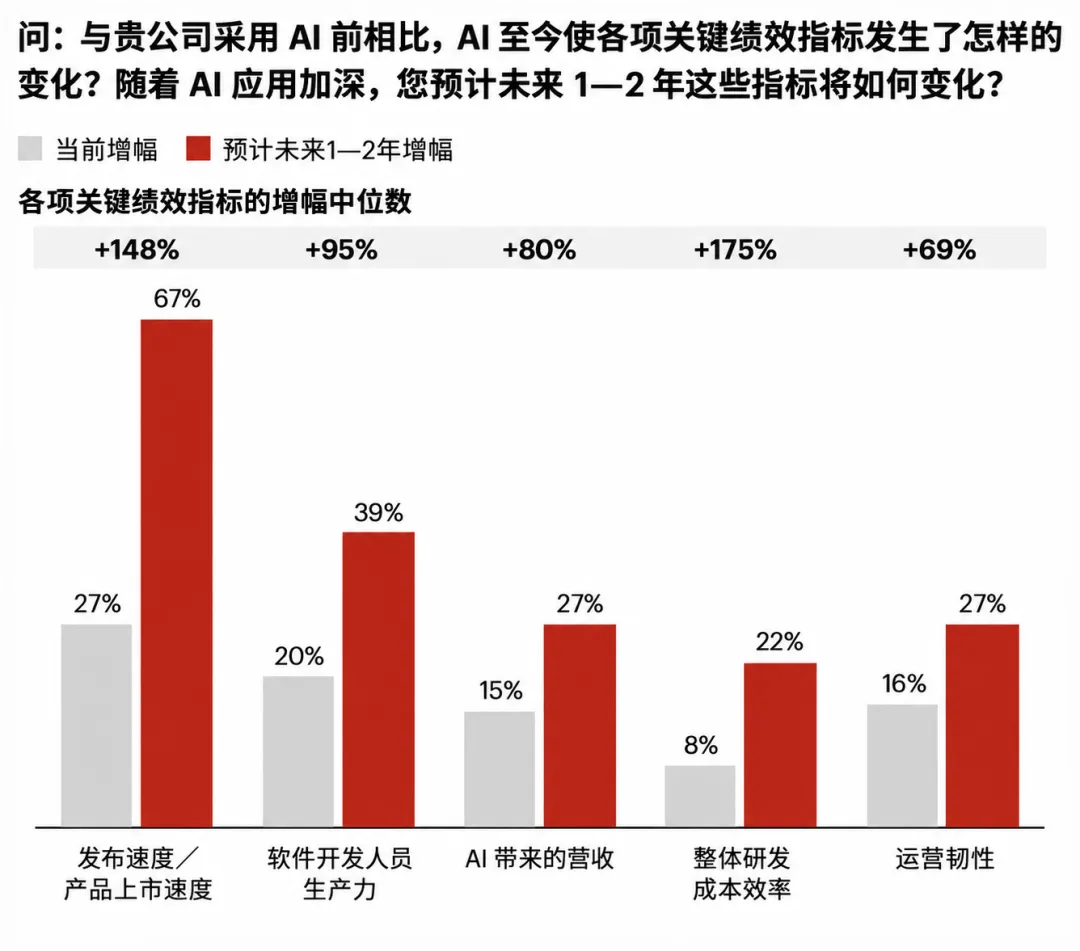
大多数企业对工程领域的 AI 提出了错误的问题:“我们能以多快的速度编写、测试和合并代码?”这种思路已经带来了令人瞩目的结果。在贝恩最近针对近 300 位技术与工程领导者开展的调查中,迄今 AI 带来的最大可衡量收益体现在速度和吞吐量上;高管们预计,未来一至两年内,提升幅度将接近 150%。
然而,更快发布的软件,仍然需要部署、监控、诊断和修复。而组织中负责运维的另一半——CIO 的运维团队,以及 CTO 的站点可靠性工程(SRE)和平台团队——则是为一个由人类按人类速度编写代码的世界而建立的。
调查揭示了这一缺口。高管们预计,AI 将在发布速度和工程成本效率上带来最显著的改善;而运维韧性的预期提升,在我们衡量的所有指标中最低(见图 1)。
图1:AI 带来的运维韧性改善,落后于其他所有受测软件工程指标
注:数值经四舍五入处理。|来源:Bain Tech and Engineering Survey,2026 年 4 月(n=293)
我们将其称为
“可靠性悖论”:构建更便宜,运行却更贵
我们将其称为“可靠性悖论”:AI 压低了构建软件的成本,却可能抬高运行软件的成本,除非运维也同步进行重新设计。当十倍的变更涌向一套为人工响应而设计的运行模式时,你得到的是一家速度更快、却更容易跌跟头的企业。如果只追求速度,就只是把组织的瓶颈从工程师的键盘转移到了值班呼叫器。
不过,正在脱颖而出的领先企业发现,速度与韧性并不矛盾;它们是同一套经过重新设计的系统所产生的两项成果。
01
PART
运维:AI 开发生命周期中被遗忘的另一半
AIOPS · THE FORGOTTEN HALF
产品与软件开发之间的传统界限正在消失。AI 让团队能够在同一个流程中完成定义、构建、测试和改进,而不再依靠依次交接。(参见贝恩简报“The Rise of the AI Development Life Cycle”:
https://www.bain.com/insights/the-rise-of-the-ai-development-life-cycle/。)
这一逻辑不会在部署环节止步。运行时的表现——哪里发生故障、哪里性能下降、用户经历了什么——是软件质量最清晰的信号。过去,这一信号的传递很慢:一份 PDF 复盘报告、一张工单、三个迭代周期后才补上的改造。现在,它必须跟产生这些信号的代码一样快地流动。
因此,AI 运维,也就是 AIOps——将 AI 应用于实时遥测数据,以检测、诊断和解决软件故障——并不是交给另一个团队、另拨一笔预算的独立项目。我们在开发中所说的“闭环”,放到运维中,就是能否从每次故障中学习,而不是为同一个问题救两次火。
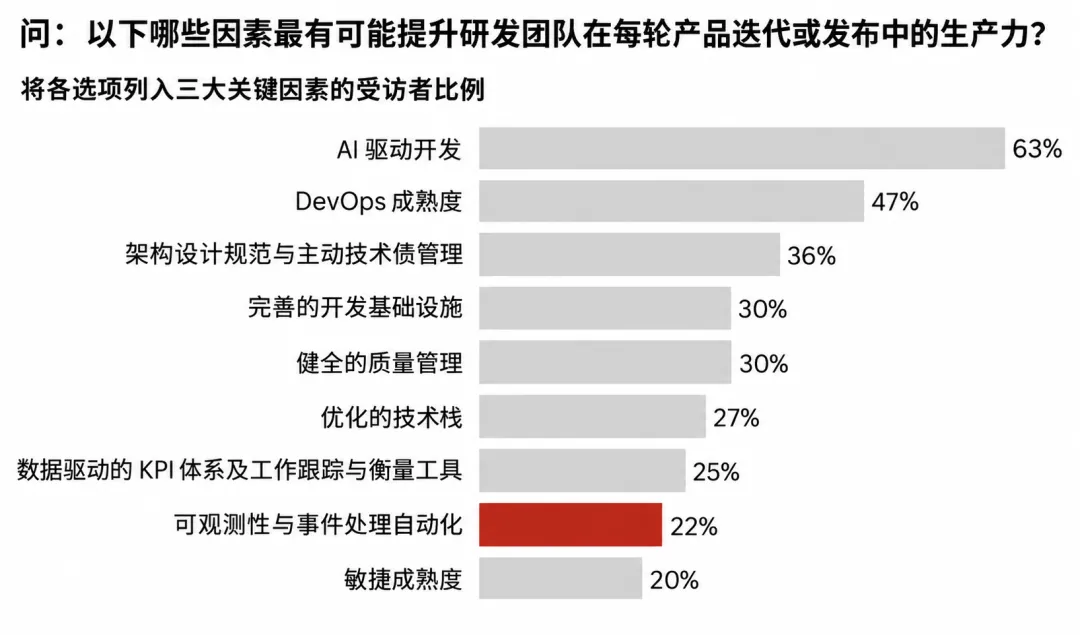
企业把注意力放在哪里,已经让这一悖论显现出来。在被要求对最有可能提升工程生产率的举措排序时,领导者将可观测性和故障处理自动化——也就是 AIOps——排在了接近末尾的位置,只有约五分之一的人提及它(见图 2)。将 AI 应用于开发,即编程、测试和评审,则被近三分之二的高管列为最重要的举措。
图2:高管将 AI 运维列为对工程团队生产率贡献最小的因素之一
来源:Bain Tech and Engineering Survey,2026 年 4 月(n=293)
AIOps 应该从哪里起步?自主执行依赖上下文,而大多数企业还没有把这些上下文建立起来。智能体只能依据自己看得见的信息行动,因此有四件事必须先做好:
建立统一的可观测性体系,覆盖指标、日志和追踪。
建立覆盖拓扑、归属、依赖关系、变更历史、安全态势和历史故障的服务知识图谱。
建立机器可读的故障分类体系和运维手册。
让环境达到足够的标准化程度,确保对一个系统的修复在其他系统中也能保持安全。
Netflix 提供了一个范例。该公司采用了新的故障管理平台,工程师将团队、服务、业务领域,甚至硬件设备直接接入平台,让报警自动分派给合适的响应人员,并根据遥测数据预先填好故障字段。统一的表述和标准化元数据让这种自动化成为可能;没有它们,智能体就没有可靠的行动依据。
02
PART
给 CIO:运维组织是新前沿
FOR THE CIOS · OPS IS THE NEW FRONTIER
在典型的 IT 投资组合中,运维组织用于维持日常运转的基础设施、服务台、故障管理和安全运维支出,远高于新开发工作的预算。也正因为这些工作不够光鲜,运维组织至今也是受 AI 冲击最小的领域之一。这种情况即将改变。
解决更快
平均故障解决时间缩短
出事更少
更早发现问题,重大故障减少
花钱更省
自动调整资源规模、整合工具
采用 AIOps 的组织已经报告的三类收益
采用 AIOps 的组织报告称,平均故障解决时间缩短了;通过更早发现问题和更好地分析告警趋势,重大故障减少了;通过自动调整资源配置规模和整合工具,基础设施成本也降低了。同样的能力还可以延伸到安全运维、成本优化、合规自动化和基础设施生命周期管理,每一项都对应运维预算中的一笔支出。不过,这些早期收益还不足以体现真正的价值:一个不再随着复杂度增加而同步扩张的运维组织。过去,系统更多、告警更多,就得有更多人来分诊;未来,系统将越来越多地自行诊断和自我修复。
Netflix 数据平台团队:无需人工介入在线解决的内存配置错误,相关成本
约 56% | 降低约 50%
Netflix 的数据平台团队将基于规则的错误分类器与机器学习相结合,预测失败的大数据作业在重试后能否成功,找出应采用的正确配置,并自动修复问题。Netflix 报告称,新系统无需人工介入,就能在线解决约 56% 的内存配置错误,同时将相关成本降低约 50%。这说明,运维组织可以不呼叫工程师,就自行消化掉一整类常见故障。
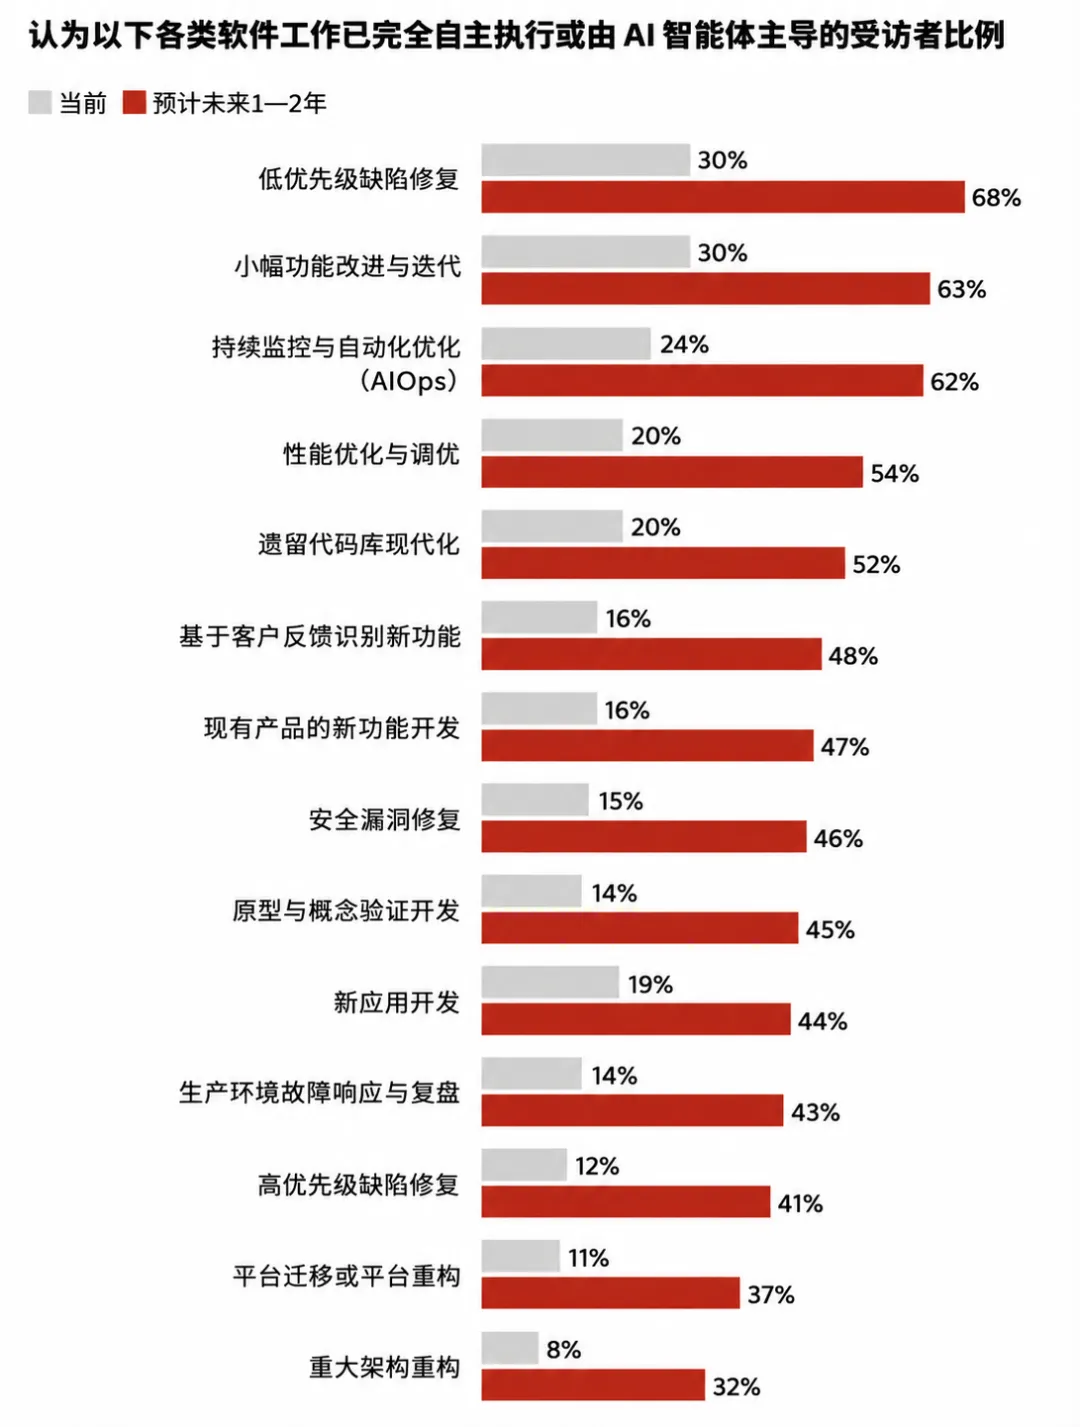
最终目标是零接触运维:在呼叫人工之前,智能体先在整个故障生命周期中完成观察、决策、行动和学习。我们调查中约半数组织预计,两年内,许多关键工程任务将由 AI 主导(见图 3)。
图3:约半数软件工程组织预计,未来一至两年内,大多数任务将由 AI 主导
来源:Bain Tech and Engineering Survey,2026 年 4 月(n=293)
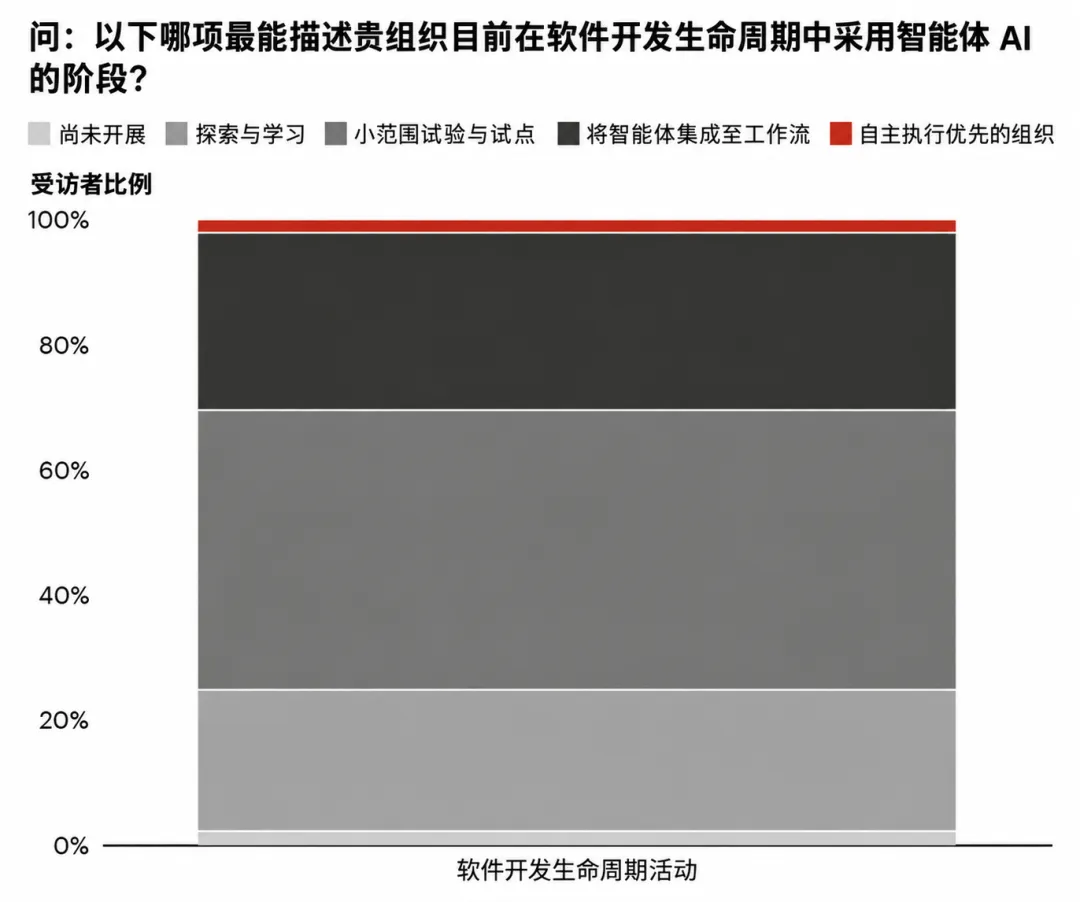
如今,很少有企业接近这一状态。只有约 2% 将自己的工程组织称为“自主化优先”;大多数仍在试点或整合早期工作流(见图 4)。CIO 的职责,不是购买一个承诺能让企业登上曲线顶端的平台,而是建立能够逐步攀升的组织能力。
图4:如今,很少有组织的软件工程职能实现了完全自主运行
来源:Bain Tech and Engineering Survey,2026 年 4 月(n=293)
这意味着,运行模式本身已经过时。把 AIOps 工具叠加到按人工分诊层级组织的团队上——从 L1 升级到 L2,再到 L3——只会得到一个运转得更快、却仍然错误的流程。要获得真正的价值,需要重新设计工作,而不只是加快它。
03
PART
给 CTO:SRE 的旧前提已消失
FOR THE CTOS · SRE AFTER AGENTIC AI
SRE 是过去二十年间运行模式最重要的创新之一。它将软件工程的规范方法引入可靠性管理:错误预算、服务级别目标,以及将严谨的工程方法应用于系统可用性。然而,智能体式 AI 改变了 SRE 的核心前提:具备专业技能的人类注意力是稀缺资源,需要尽可能高效地分配到不断扩张的系统中。当智能体能够摄取各个层面的遥测数据,根据依赖关系图推断根本原因,并且比人类值班人员更快、更一致地执行修复手册时,稀缺资源就变成了可信赖的自主执行能力。
这让工程师可以将精力从人工故障分诊,转向能够创造更大价值的工作。我们的调查显示,工程管理者已经将这一变化纳入考量。过去,可靠性工程师整夜在六种监控工具之间关联分析告警,这从来不是他们最有价值的工作。与开发端一样,他们现在正从操作执行者转向自主运维的架构师。他们的职责是:
定义什么才算“健康”。
将智能体何时可以自主行动、何时必须升级处理的规则编码化。
构建评估框架,确保自主修复造成的危害不会超过它所避免的危害。
围绕价值重新调整的,不只是 SRE。最成功的企业将采取从零开始的思路:如果今晚没有任何人值班,会有什么出问题?又在哪些地方,人类判断不可替代?这个问题会揭示出多数组织目前尚未配备的岗位:
智能体编排工程师
监督修复智能体群。
可靠性产品经理
负责界定并管理可靠性边界。
AIOps 数据工程师
维护遥测数据与知识图谱层。
智能体可观测性负责人
监控智能体本身。
自然语言界面让非专业人员也能排查系统,从而让规模更小的资深团队腾出精力,专注于治理和架构。
能够做好这些工作的 CTO,衡量 SRE 职能的标准,将不再是故障解决得有多快,而是能把需要人工介入的故障数量降到多低。
04
PART
区分领跑者与浅尝者的原则
4 PRINCIPLES · LEADERS VS. DABBLERS
AI 主导开发的原则同样适用于 AI 主导运维,只是在运维中,要求更为严苛。
上下文为王
AIOps 智能体的能力,取决于它能够获取的上下文。没有统一的遥测数据层,没有反映系统实际关联方式的知识图谱,智能体就只能汇总告警,无法自主开展运维。
将风险作为首要设计约束
允许智能体在生产环境中重启服务、回滚发布或调整基础设施规模,其风险远高于让它编写由人类审核的代码。我们的调查中,安全、风险与治理护栏,被列为扩大智能体式 AI 应用规模的首要支撑因素;治理和遗留系统的限制,则是主要障碍之一。自主修复需要一个运行时治理层:以置信度阈值决定是否允许行动,以策略即代码设置护栏,确保所有行为均可审计,为高风险变更设置明确的人工检查节点,并密切跟踪智能体的决策、工具调用和成本。例如,Google 将这些自主行动边界内置于 SRE 工具中。智能体通过函数调用(fetch_playbook)获取经过批准的运维手册,而不是使用自由形式的命令。
衡量结果,而非产出
传统指标,即便是定义了 DevOps 时代的 DORA 指标,也是为所有工作都由人类完成的世界设计的。如今,单看平均故障解决时间可能产生误导:系统可以在更快解决故障的同时,悄然积累脆弱性。衡量方式必须区分人类与智能体的行动,将人类加 AI 的混合团队视作一个整体,并将可靠性、控制和信任与速度并列,列为核心考核维度。最成功的企业还会跟踪自主解决率、成本和业务结果,而不是假定采用技术就能带来成效。调查中的核心矛盾——对软件工程速度提升的预期高于对韧性提升的预期——正是组织衡量容易看见的东西,却忽视难以信任的东西所带来的结果。
为复利积累而设计
长期来看,最大的机会在于优势的复利积累:智能体每解决并记录一次故障,就会增加一份上下文,加快下一次修复,让系统运行得越久,表现就越好。人工分诊团队做不到这一点;其知识会随人员流失而流失,也会在两次故障之间逐渐淡化。闭环让运维成为一种越用越强的能力,而不再是一项随业务量增长而上升的成本。
///
LAST
重新设计本身就是战略
REDESIGN IS THE STRATEGY
CIO 和 CTO 很容易将 AIOps 视为一项采购工作:选择平台,按现有运行模式部署,再将效率收益计入成果。这条路能带来大多数企业目前看到的渐进式改进,却无法化解这一悖论:开发的加速幅度,依然超过运维所能承受的范围。
将组织现有的 AI 工具串联起来,并不能解决问题;但解决问题也不需要彻底颠覆组织,或投入巨额预算。真正需要的是构建一套相互衔接的新流程与新能力:
重新设计工作流
让运行时反馈以机器的速度回到规划环节。
重组团队
围绕智能体编排,而非人工分诊。
重建衡量体系
让信任与控制和速度一样清晰可见。
一旦建成,这些能力就会成为自主工作的控制平面,应用范围远不止工程领域。
只追求速度,只是把瓶颈从键盘挪到了值班呼叫器
原文参考:
中文内容由智变光年团队编译,如需转载请联系我们。
智变观察
我们是智变光年,观察智能变迁,研究AI产业与商业,发现中美AI机会,连接AI行业资源。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING