ARTICLE · 1220553
为什么导入知识库的Excel是废数据?Excel放进知识库就废了?扒一扒检索效率低的底层真相!
我是老九,一个一直在一线折腾技术和AI的人。AI难的不是跑通Demo,而是上线以后。记录一个个真实小问题:出现了什么、怎么排查、原因在哪、怎么解决。欢迎关注我!
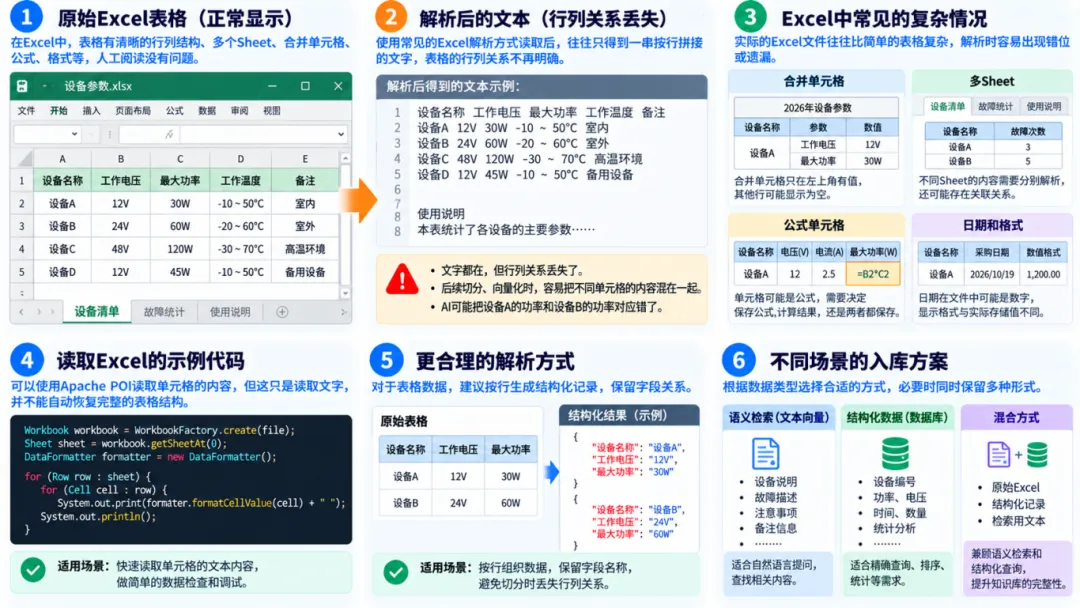
不要错过文章最后的总结图呦!
当前章节:第五章|知识库文件进去以后
当前小节:第一节|文档解析
本篇问题:Excel解析
做知识库,PDF、Word能上传,Excel也想支持。文件上传没问题,Apache POI正常读取单元格,检索环节容易出现奇怪的问题。
用户问:“设备A的最大功率是多少?”
Excel里30W,AI找不到,或把设备B的60W回答出来,看看Exce被解析成了什么。
还是那张表:
假设输出:
设备名称 工作电压 最大功率 设备A 12V 30W 设备B 24V 60W把文字拼成一段,再按500个字符切Chunk。一份Excel可能几千行,切分位置刚好在设备A和30W之间,或把表头留在前一个Chunk,后个Chunk剩一堆数字。数据读出来了,不代表字段之间的关系保住了。
真正麻烦的文件有十几个Sheet,有些表头占三行,还有合并单元格。
Excel里看起来一个“设备A”覆盖了下面五行,实际上通常只有合并区域左上角的单元格保存了值。
如果直接逐行读取,后面几行的设备名称可能是空的。不能把所有空单元格填成上一行的内容。必须先判断合并区域,确认这些行是不是属于同一台设备。
还有公式。Apache POI读取公式单元格时,取得公式表达式,不会因为调用普通的格式化方法,就必然得到最新的计算结果。
如果需要计算值,要结合FormulaEvaluator处理;如果依赖文件中的缓存结果,也要考虑缓存可能已经过期。
公式可能引用其他Sheet,甚至外部工作簿。入库前明确:保存的是公式、计算结果,还是两者都保存。
日期踩坑。Excel内部可能把日期保存为数,只读取底层数字,知识库可能收到的是序列值,而不是用户看到的日期。
这类问题先给Excel解析结果增加几项检查:
file: device_list.xlsx
sheet_count: 3
sheet: 设备清单
row_count: 1250
merged_regions: 8
formula_cells: 36
parsed_records: 1248
记录数少于行数不一定错误,可能存在表头、空行和说明行。如果差距异常,需要检查哪些行被跳过了。
Excel真的适合全部转成向量吗?举例子说吧!
如果用户问“设备A的最大功率”,可以把每条记录成文本,再通过向量检索查找。
如果用户问:“所有设备的平均功率是多少?”
或者:“找出故障次数最多的十台设备。”
这不是简单的语义检索,向量数据库擅长查找语义相关内容,不能保证完整扫描所有记录并准确完成统计。
这种结构化查询适合把Excel数据导入关系型数据库,使用SQL筛选、排序和聚合。大模型负责理解用户问题,具体计算交给数据库执行。
也就是说同一份Excel未必只有一种入库方式。设备说明备注、故障描述,可以考虑转成文本做语义检索。设备编号、功率、时间、数量等字段,则更适合保留结构化数据。
如两种都有,同时保存原始Excel、结构化记录和用于检索的文本。
总结下,Excel不是一篇按顺序阅读的文章,而是一份带着行列、公式和业务关系的数据。
如果解析时只把它变成一大段文字,文件虽然进了知识库,很多真正有用的信息却可能已经丢了。
如果你读着还行,欢迎点赞收藏关注;如果有不同的观点,也欢迎大家留言讨论。