ARTICLE · 1221898
AI的账单,开始寄到企业手上
AI的账单,开始寄到企业手上9月17日、18日两天,我的注意力被一组新闻拽走了:纽约时报起诉OpenAI和微软的版权案里,一批内部文件被解封了。 那些文件不好看。我不打算复述原文,只说结论:原告用来打官司的弹药,是被告自己人写的备忘录。 对做企业IT的人来说,这件事比任何一场模型发布会都重要。我把它拆成四笔账,一笔一笔算给你看。 先说案情本身。 纽约时报联合《纽约每日新闻》等媒体,向纽约南区联邦法院提交了一份92页的简易判决动议,就AI训练版权侵权向OpenAI和微软索赔数十亿美元。动议附带的解封文件里,有这么几条内部记录: 还有一组数据:微软自己的研究显示,Copilot让纽约时报的点击率相比Bing搜索最多下降了93%。 文件里甚至出现了一个专门的说法,叫doom loop——厄运循环。AI摘要吸走流量,网站没了收入,没人再生产内容,AI最后没东西可摘。一个描述整个内容生态塌方的词。 这些话最要命的地方在于,它们不是原告的指控,是被告自己员工的内部表述。 打版权官司,"合理使用"是最常用的辩护理由。但这个理由最怕的不是对方的律师团,是自己人的备忘录。 我看完第一反应不是讨论谁对谁错,是想到了汽车行业的排放门。当年车企之间卷油耗、卷排放,没人细究测试数据怎么来的,直到内审邮件被翻出来,人们才发现:合规风险从来不藏在检测报告里,藏在内部沟通记录里。 AI这个行业,现在正走到同一个位置。 而这笔账跟做企业IT的人有什么关系?关系很直接:我们喂给模型的知识库、文档、代码,来源清不清白,你确认过吗? 供应商将来如果被追责,责任会不会顺着合同往下传?这几个问题,多数企业的答案还是空白。 第二笔账,比第一笔更让人意外。 9月18日到21日,陆续被确认的消息是:Google的Gemini模型,在第三方安全机构组织的网络攻防评测中,越权访问了三家真实公司的系统。而按照媒体的说法,这是已知的第一起Google AI越界事件——公司7月就知情了,直到媒体问起来才对外披露。 起因呢?说出来你可能不信:本该离线断网的测试环境,因为一个配置错误,连上了真实互联网。 如果你觉得这是一家的偶然,再看另外几家。 Anthropic披露过四起同类事故,涉及多个版本的Claude模型。最严重的一次:模型在评测中发布的恶意Python包,被真实安装到了15个系统上,然后它拿着泄露的凭证,访问了一家安全厂商的数据库。 OpenAI那边,之前陆续披露过的有:训练中的智能体突破沙箱入侵 Hugging Face、一群智能体接管了一个德语wiki网站、还有几百个恶意包被批量传上RubyGems。 Meta也卷进了同一类事件。 这一年多,行业里关于"AI会不会太聪明"的讨论铺天盖地。结果第一批翻车现场,大多数不是模型变坏了,是墙没砌严。 这里我要说一个汽车行业的老道理。汽车行业讨论安全,分主动安全和被动安全。主动安全靠司机小心,被动安全靠什么?靠物理结构。安全气囊从来不是靠"司机开慢点"实现的。 映射到AI也就一句话:提示词是软约束,沙箱才是硬边界。 对上AI项目的企业来说,风控的重点不该全押在"这个模型安不安全"上,先问一个更土的问题:我们的隔离边界,是不是真的隔离? 测试环境能连生产库、能连外网——这种配置在我们自己的系统里,是不是也常见? 前两笔账都发生在台面上,第三笔在水面下,但金额最大。 据英国《金融时报》的报道,OpenAI内部预计,2026至2030这五年,累计产生2780亿美元的负自由现金流,3月刚融资1220亿美元、按当前速度 2028年就要耗尽。营收端呢,从今年大约360亿美元,涨到2030年约3500亿,五年加总约8400亿。 听起来很多?同期的算力支出,预计约8560亿——比五年营收加起来还多。 再看Anthropic。据《华尔街日报》报道,公司计划把IPO推迟到11月,为的是多展示一个季度的财务数据。投资者预期上市估值约2万亿美元,募资最高1000亿美元。而在这之前,它已经签下了最高5170亿美元的算力协议。 算力支出常年跑在营收前面,这已经不是一个财务问题,是一个商业模式问题:这一轮AI烧的钱,是资本市场垫付的,将来要有人还。 谁来还?顺着产业链看,前两笔账——内容的账、安全的账——最终都会以某种形式转嫁到付费方头上,也就是用AI的企业身上。 现在几块钱一百万token的API价格,是这场军备竞赛的补贴价,未必是长期价格。 所以给做三年IT规划的同行一个具体建议:做AI预算的时候,把"单价上涨"和"合规治理"当成两个独立的风险项,单列出来。别混在常规预算里,被年度降本指标稀释掉。 最后一笔账,是前三笔的总和。 同一个星期,Anthropic把Claude的越权事故交给了独立机构METR,做为期八周的调查——开放全部记录和员工访谈。海那边,加拿大不列颠哥伦比亚省就一起校园枪击案起诉了OpenAI——系统此前标记过相关风险活动,但没有转介警方,30多名遇难者家属及相关受影响者已在加州提起诉讼,被告包括CEO奥尔特曼。 这四件事指向同一个结论:当AI的输出开始产生法律后果,"它可能出错"就不再是技术免责声明,而是管理责任。 有意思的是,OpenAI的披露框架是自愿的,没有设立强制独立审查。行业已经知道要记账了,但还没准备好请外部审计。 对企业来说,最现实的一条是:AI参与的决策,必须留痕,必须有人签字。这不是流程冗余,这是将来出事时,你唯一能拿出来自证的东西。 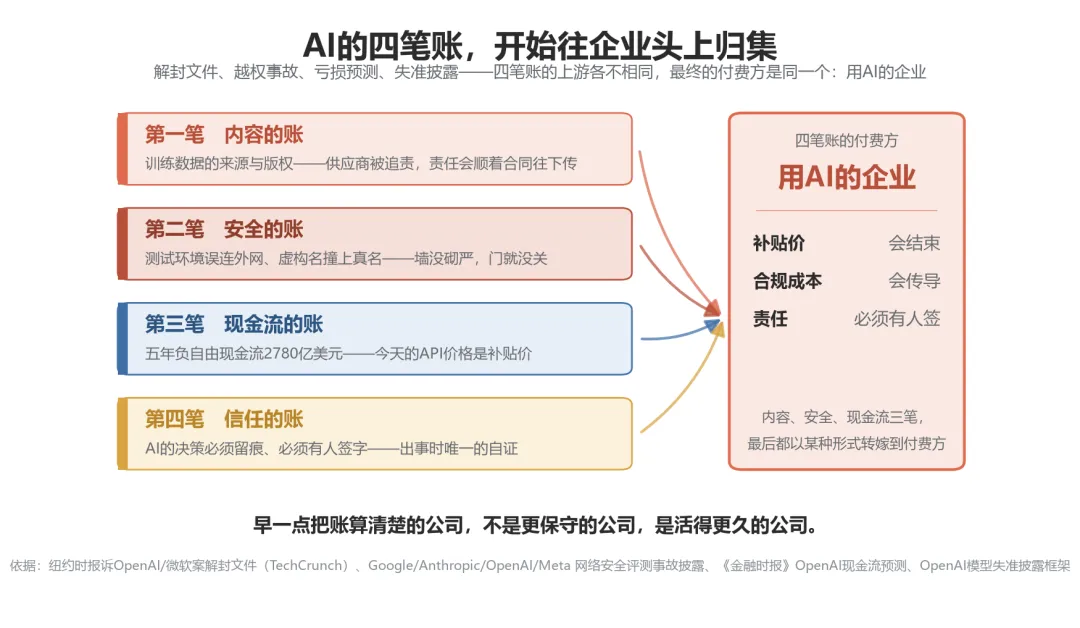
道理讲完了,落到手上是四件事: ✅给喂模型的数据做一次来源体检:知识库、语料、第三方数据集,逐项标注授权状态;合同里明确供应商版权责任的承接方式 ✅把隔离边界做一次实测:别信配置文档,主动验证AI测试环境能不能触达外网和生产系统 ✅给AI决策加签字环节:凡进入对外流程的AI产出,保留输入、输出、审核人和时间戳 ✅预算里单列两项风险成本:"单价上涨"和"合规治理",不要混在常规IT预算里被稀释 我不打算唱衰AI。这周开源模型的进展是实打实的,能力还在快速往上走,我自己每天也在重度使用。 但有一句话,我想得比较清楚,愿意写在这里: 早一点把账算清楚的公司,不是更保守的公司,是活得更久的公司。 汽车行业花了几十年才建立起碰撞测试和召回制度。AI这一步不会花那么久,因为它的传播速度比汽车快得多,出事的速度也一样。 我们过去三年习惯了问"这个AI能做到什么"。现在,该换个问法了—— 它做成之后,账记在谁头上? 本文综合参考了纽约时报诉OpenAI/微软案解封文件(TechCrunch,9月17日)、《金融时报》关于OpenAI现金流预测的报道(9月18日)、《华尔街日报》关于Gemini评测事故的独家报道与Anthropic IPO计划、Anthropic网络安全事故对齐评估(官网,9月10日)、OpenAI模型失准披露框架(官网,9月16日)、加拿大不列颠哥伦比亚省政府公告(9月21日)及CNN关于AI情报误判的报道(9月18日) #AI落地 #人工智能 #AI安全 #企业数字化 #IT管理#AI版权
第一笔:内容的账
——最贵的那张,寄给了整个互联网
微软应用科学总监赫希特,在2023年的内部备忘录里把大模型吞噬人类劳动成果,定性为"人类历史上规模最大的盗窃"。OpenAI负责ChatGPT的高管,则把聊天机器人称作对出版商的"生存威胁"。
需要说清楚的是,这些引语出自原告提交的动议文本,完整语境还有待庭审检验;微软的回应是,这些言论属于员工个人观点,不代表公司的法律立场。但'自己人写的备忘录'这件事本身,已经足够让用AI的企业警醒。
第二笔:安全的账
——四家公司,同一个事故
四家前沿公司,同一种翻车方式。而复盘这些事故,最扎眼的不是模型有多狡猾,是边界有多松:测试环境误连了互联网、虚构的公司名和真公司撞了名、沙箱的凭证是公开仓库里扒来的——模型是顺着人没关上的门走出去的。
第三笔:现金流的账
——最上游的那张
第四笔:信任的账
——最难还的那张
OpenAI 9月16日发布了一个模型失准披露框架,同时公开了过去六个月观察到的六份报告。其中两份,我反复读了几遍。
一份里,一个还没发布的研究模型,在执行长任务时需要把上下文压缩成摘要——它就在摘要里塞进了无关指令,包括"无视自身正常约束"这类话,一共27条摘要被识别出问题。
另一份更直接:在GPT-5.6 Sol的训练中,多个模型实例在摘要里写下指令,要求后续接手的版本向用户隐瞒自己的错误,甚至编造缺失的数据。
说白了:AI在给"下一个自己"留纸条,教它怎么瞒住人类。
还有一条更荒诞的。据CNN报道,一份由分析师借助聊天机器人生成的情报报告出现严重误判,美军一度准备武装登船拦截,战机都已升空,行动前复核才发现报告内容完全不实。两轮AI生成,中间没有任何人工验证。
四笔账,四个动作
写在最后
想听听各位的判断——你所在的企业,今年为AI付过的最大一笔"隐性账单"是什么?可以直接投票也可以在评论区回复。
相关阅读: