ARTICLE · 1223488
35 万 Star 的 REA,杀不死闭源软件
35 万 Star 的 REA,杀不死闭源软件

GitHub 上有个叫 ReverseEngineeringAssistant(简称 REA)的项目,最近火得一塌糊涂。短短几天,Star 数从 1 万飙到 35 万,成了 AI 圈子里最热的开源项目之一。 热闹归热闹,但关于它到底意味着什么,争论也异常激烈。有人说这是「闭源已死」的号角,有人说这是「盗版」的帮凶。 所以,REA 到底是什么?它真的会让闭源软件「死掉」吗?还是说这只是一个被过度解读的工具? PART 01 
逆向工程的本质是「理解意图」 
要理解 REA 到底改变了什么,得先理解逆向工程的本质。 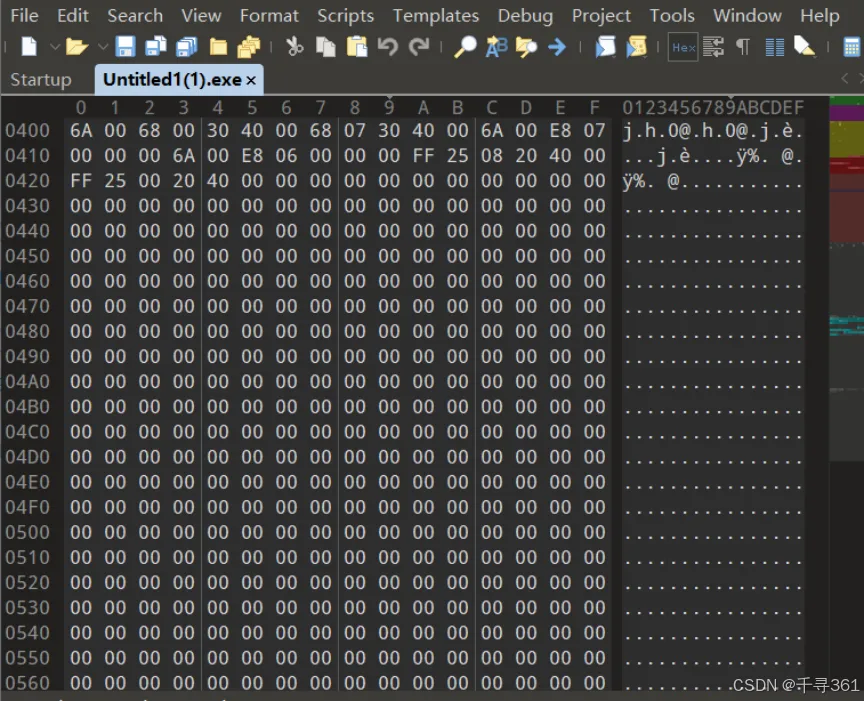
过去,它是一门手艺,而且是一门昂贵的、小众的手艺。 你得会用 Ghidra、Hopper、IDA 这些反编译器,得懂汇编、懂内存布局、懂调用约定,还得有耐心在一堆没有变量名、没有注释的伪代码里,一点点还原出「这行代码到底想干什么」。 一个中等复杂度的二进制文件,资深工程师可能要花几天甚至几周才能摸清楚核心逻辑。而且这个过程极度依赖个人经验——同样的代码,老手能一眼看出门道,新手可能完全无感。 更重要的是,逆向出来的结果往往是不完整的。 反编译器给你的是这样的东西: 结构是恢复了。可 FUN00401230 这个名字、param1、param_2 这些参数,没告诉你在业务上这是什么。它可能是个通用除法,也可能是某个计费模块里的比例换算,还可能是一段登录里的风控逻辑。只看这几行伪代码,你什么都确定不了。 要确定,你得继续往上游追:谁调用了它,参数从哪来,返回值去了哪,旁边有没有相关的字符串。每一步都需要人的判断,每一步都在烧时间。 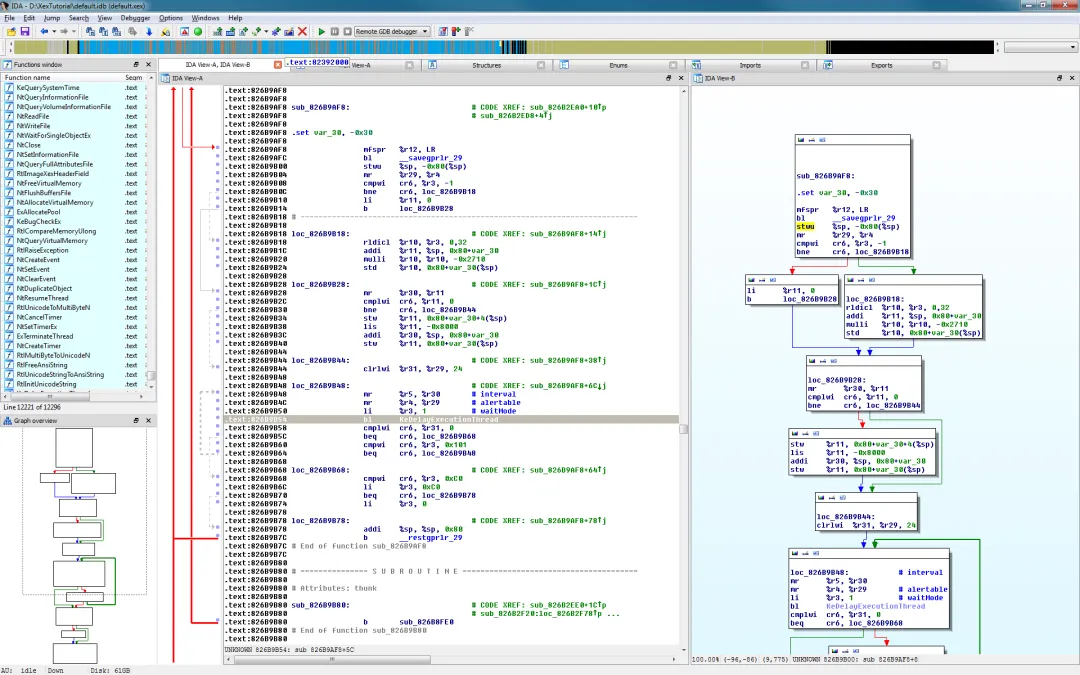
这就是 REA 出现的那个位置。它把逆向里最贵的那部分——那份需要资深工程师日复一日打磨的判断力——用 AI Agent 接了过去。 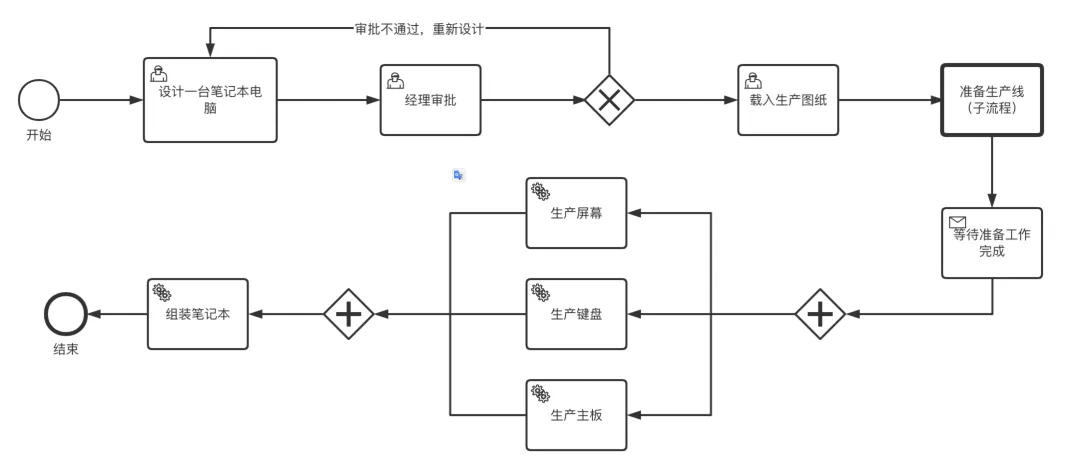
PART 02 
REA 到底做了什么? 
简单说,它是一个「AI 驱动的逆向工程流水线」。 它的核心架构可以拆成三层: 第一层,MCP 协调层 REA 不是单打独斗。它通过 MCP(Model Context Protocol)协议,把一系列专业工具串在一起:反编译器、调试器、十六进制编辑器、符号执行引擎,等等。这些工具各自负责自己最擅长的部分,REA 负责协调它们什么时候该用什么、按什么顺序用。 第二层,Agent 推理层 这是 REA 的灵魂。它内置了一个基于 LLM 的 Agent,能理解「逆向工程」这个任务本身。你扔给它一个二进制文件,它会自己规划:先反编译看看整体结构,然后找入口点,再追踪关键函数,最后生成一份带证据链的分析报告。 这个「带证据链」很关键。REA 的每一步结论,都会附带它用了什么工具、看了哪段代码、得出了什么判断。你可以复查,可以质疑,可以修正。 第三层,REA 专用层 这是它区别于通用 AI 的地方。REA 内置了大量逆向工程领域的专业知识:常见的编译器优化模式、标准库函数的识别、各种架构的调用约定、已知漏洞的检测规则,等等。这些知识让它的判断比普通 AI 更准、更专业。 PART 03 
四个案例,看懂 REA 的能力边界 
说架构太抽象,直接看案例。 案例一:DX-Ball,63 字节逐字节一致 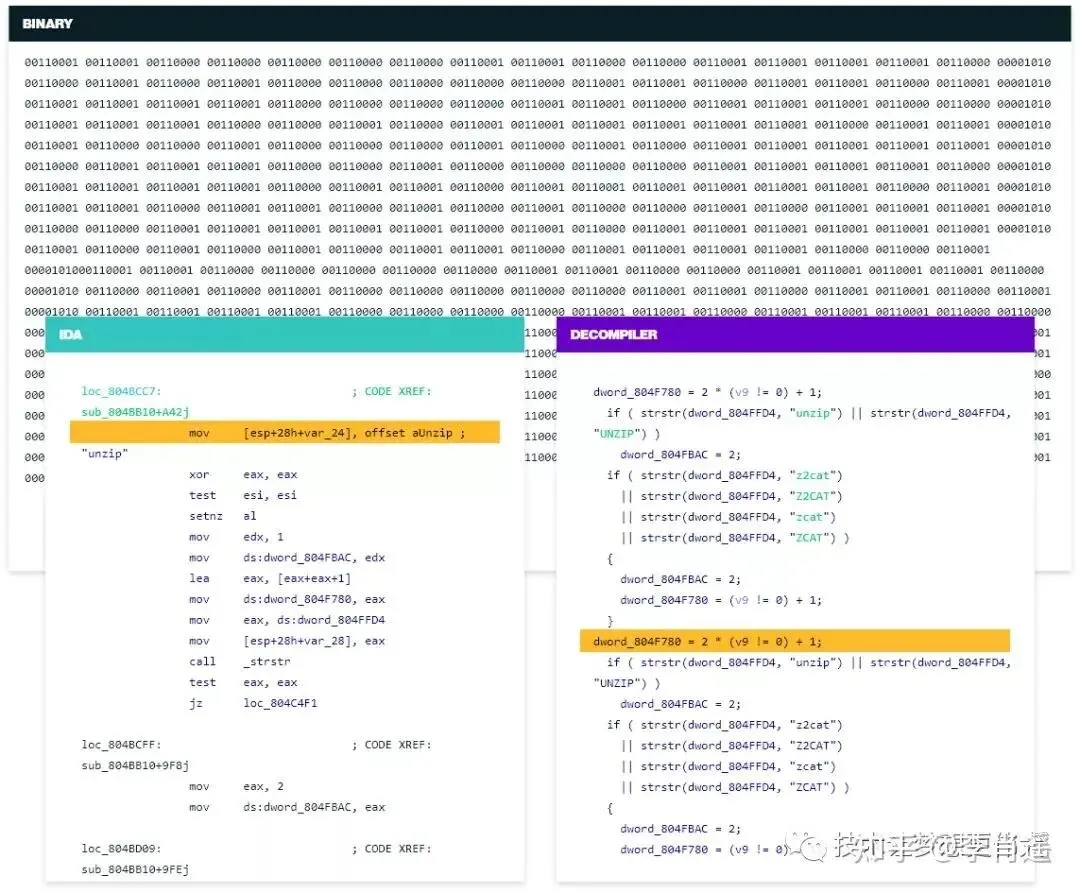
这是一个经典弹球游戏,原版是 90 年代的 Windows 小游戏。有人用 REA 对它做了完整逆向,最后生成的代码和原版对比,63 个字节逐字节一致。 这个数字很夸张。它说明 REA 不仅还原了逻辑,还还原了编译器优化后的具体指令选择。这不是「大概看懂」,这是「精确复刻」。 案例二:Notion 剪贴板,跨进程追踪 Electron 应用里,剪贴板数据要从渲染进程一路穿过 preload、IPC,最后到主进程。 REA 的厉害之处在于,它能自动识别出「剪贴板」这个业务概念,然后追踪完整的调用链:从用户按下 Ctrl+C,到数据最终进入系统剪贴板,中间经过了哪些函数、哪些 IPC 消息、哪些数据转换,全部可视化。 这背后是它内置的「Electron 应用模式识别」能力在起作用。 案例三:TH04 东方 Project,20 年前的游戏 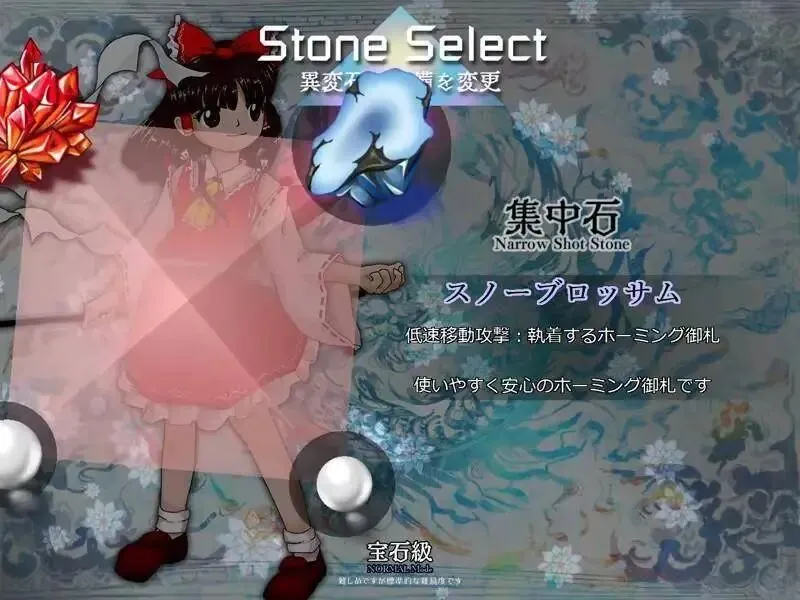
这是一个 1998 年的弹幕游戏。REA 对它的逆向,不仅还原了游戏逻辑,还找出了当年程序员埋的彩蛋和未使用的代码。 这个案例说明,REA 对老旧代码、非标准编译的产物,也有不错的适应能力。 案例四:智能马桶,半小时出遥控方案 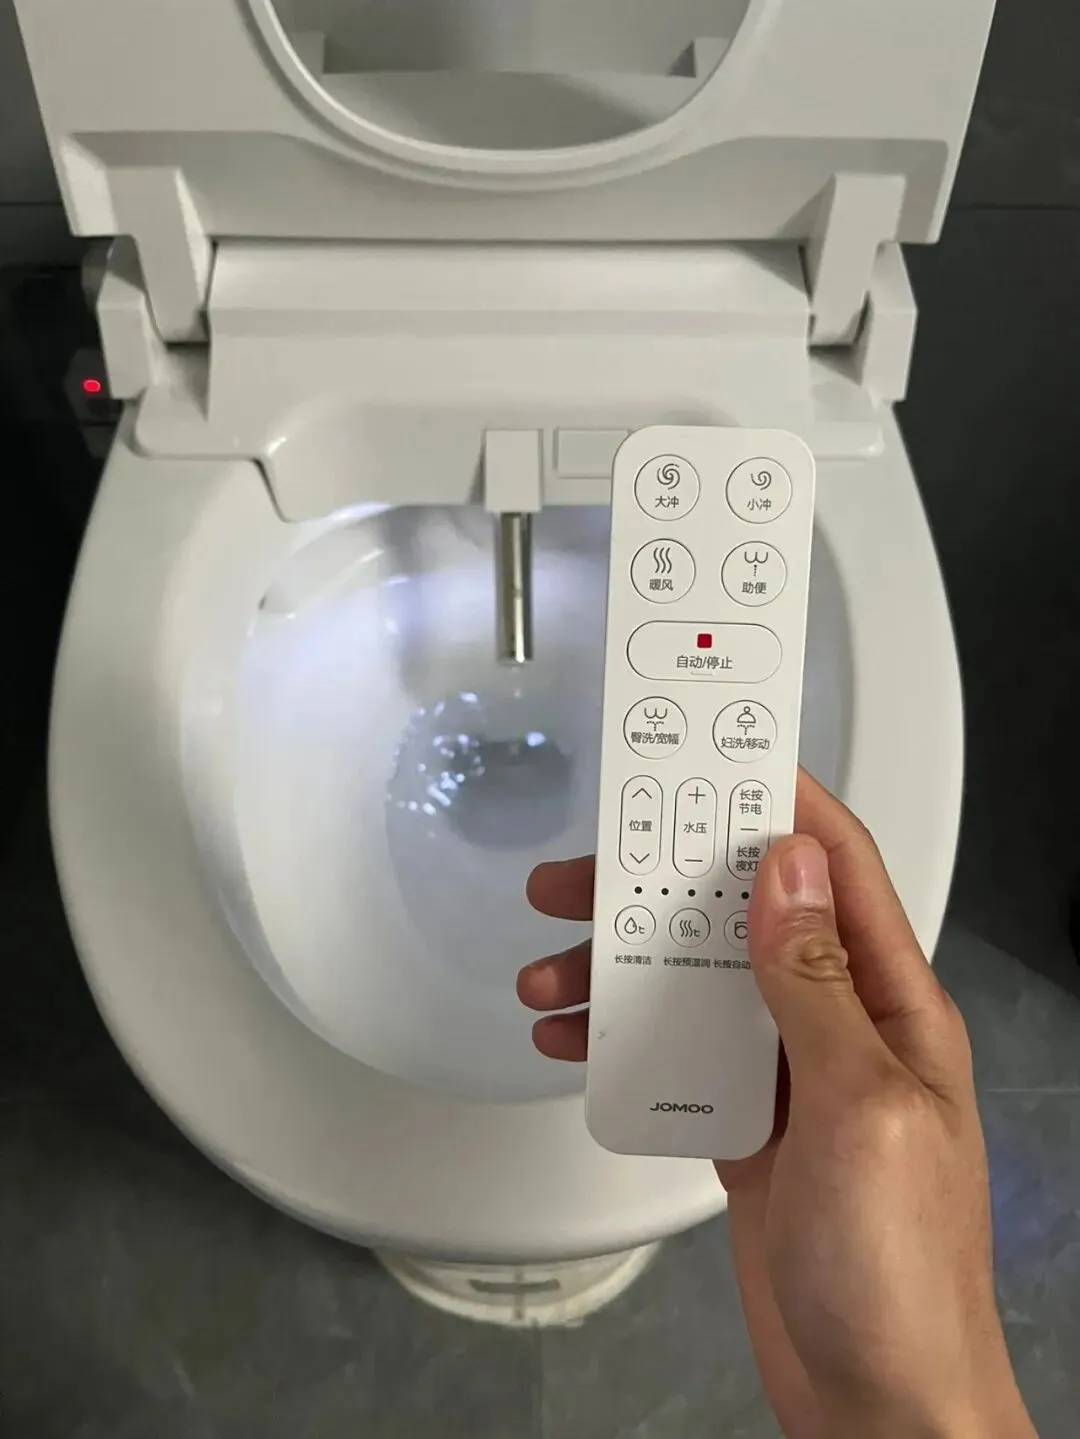
这是个有点意外的案例。有人用 REA 逆向了一个智能马桶的蓝牙协议,半小时就搞清楚了怎么用手机控制冲水、加热、夜灯等功能。 IoT 设备的固件逆向,传统上是个麻烦事。REA 把这个门槛大大降低了。 PART 04 
房间里的大象:这到底是不是偷? 
热闹到这一步,必须来面对那个绕不开的问题。它几乎是 REA 爆火的同一时刻,就被人抬上桌面的: 这不就是偷吗? X 上一半人喊「盗版」,一半人喊「软件已死」。Chamath 在播客里放话说知识产权「实质上变得一文不值」。但有意思的是,他这段话很快被人加了一条 Community Note,澄清说:那些替代 Adobe 的项目,并不是反编译产物,开发者自己宣称那是「净室重新实现」。 净室,这个词是关键。 它是一个四十年前的老把戏。玩法是这样的:一个团队去研究原版产品,但他们只记录「它做了什么」——是行为描述,不是代码;然后另一个团队,只根据这份行为描述,从零写一个新产品。写代码的人,从头到尾没见过一行原始代码。结果就是,做出来的东西功能一样,却不包含原版的任何一行代码。 PC 行业,其实就是这么来的。80 年代初,Compaq 用净室的方式重建了 IBM 的 BIOS,花了一百万美元左右。这就是为什么后来会有那么多「IBM 兼容机」——它们没有抄 IBM 的代码,却能和 IBM 的软件跑在一起。 而法院,也一直是站在逆向这一边的,至少在合理的边界内。 1992 年,Sega 诉 Accolade 案。Accolade 拆解了 Sega 的主机游戏,为了做出兼容的游戏。法院裁定:当拆解代码是理解工作原理的唯一途径时,它可以构成合理使用。 2000 年,Sony 诉 Connectix 案,Sony 三局全输。最终那个模拟器里,根本不包含 Sony 的任何代码。 当然,硬币还有另一面。2010 到 2011 年,黑客破解了 PS3 的安全机制,公布了根密钥,Sony 起诉了那个叫 geohot 的家伙,最后双方在 2011 年 4 月达成和解,约定不再破解 Sony 产品。 把这条线画清楚,其实不难: PART 05 
松动的从来不是「代码护城河」 
最近我还反复想一个问题:REA 到底松动了什么? 我的结论是——它没有松动「闭源」这件事,它松动的是「黑盒」这件事,而且是「体验层的黑盒」。 那些真正值钱的软件,它们的护城河,几乎从来都不在代码本身。 微信的护城河是什么?是十几亿人的社交关系,是熟人网络带来的迁移成本。你把微信的代码一行不差地反编译出来,再原样开源一份,也没人会用你那份——因为用户不在代码里,用户在网络里。 支付宝的护城河是什么?是金融牌照、是商户网络、是监管准入。这些东西,反编译给不了你。 抖音的护城河是什么?是内容生态、是推荐算法背后那个持续运转的数据飞轮。算法的一部分逻辑也许能被逆向,但喂养它的那几亿用户的实时行为数据,你复制不来。 这些,才是现代软件公司真正的、深层次的壁垒。它们叫「网络效应」「监管壁垒」「数据飞轮」,唯独不叫「代码保密」。 
所以当我看到「闭源已死」这四个字时,我的第一反应不是兴奋,而是警惕。这是一个把「手段」误当成「目的」的典型误读——闭源从来不是目的,闭源只是保护护城河的一种手段,而且是一种正在贬值的手段。 那什么是「体验层的黑盒」? 
是某个交互细节为什么这么设计,是某个本地缓存策略为什么这么写,是某个小程序的加载机制到底怎么运作。这些东西,过去被编译成二进制之后,就成了一道「你懒得去看、也看不太懂」的黑幕。而现在,REA 让这道黑幕变得透明。 这变化大吗?也大,也不大。 说它大,是因为它改变的是「学习成本和模仿成本」。过去你想拆解一个交互细节是怎么实现的,门槛高到大多数人根本不会去尝试。现在你问一句话就能拿到一条带证据的链路。这对那些靠「巧妙体验」吃饭、却没有网络效应和数据壁垒的小团队,是实实在在的威胁。 说它不大,是因为它没有触及软件行业真正值钱的那一层。那些真正的巨头,不会因为自己的构造函数被看懂一点点就死掉。他们死不掉的原因,和代码一点关系都没有。 PART 06 
三个真正值得关注的变量 
说三个我觉得真正值得关注的变量。 第一,安全 REA 让「找漏洞」的成本也降低了。过去需要专业安全研究员花几周才能找到的漏洞,现在可能几小时就能定位。这对软件安全行业是个双刃剑:好人用它能更快修漏洞,坏人用它能更快找漏洞。 而且,REA 目前对复杂混淆、虚拟机保护、代码加壳的处理能力还有限。但随着模型能力进化,这个「有限」的边界会不断外推。 第二,定价 软件的价值,正在被重新定价。过去,代码的「不可见性」本身就有价值——你看不懂,所以你只能买。现在,「不可见性」在贬值,软件公司必须找到新的价值锚点。 这个锚点可能是服务,可能是数据,可能是持续迭代的生态,唯独不能是「我写了代码但你不许看」。 第三,法律与伦理 技术的进化速度,远远快过法律的反应速度。REA 这类工具的出现,会倒逼法律界重新思考:什么是「合理使用」的边界?什么是「净室」的标准?当 AI 可以自动完成过去需要人工完成的「理解」过程,法律该如何界定「理解」和「复制」的区别? 这些问题,没有现成答案。但它们会在未来几年里,成为软件行业真正的风暴眼。 PART 07 
最后 
REA 不是一个终点,它是一个起点。 它标志着 AI 开始真正进入「理解复杂系统」的深水区。不是简单的文本生成,不是图像识别,而是对软件——这个人类创造的最复杂的人工制品——进行结构化的、可验证的理解。 
它告诉我们:AI 真正能撬动一个行业的时候,往往不是它喊出最大口号的时候,而是它把一件过去很贵、很玄、很靠个人手艺的事,变成一件可以验证、可以复现、可以交给下一个人接着干的事的时候。 软件会不会因此「死掉」?大概率不会。 但它会进化。它会从「靠代码保密吃饭」进化到「靠生态和服务吃饭」。它会从「黑盒护城河」进化到「透明护城河」。它会从「你不能学我」进化到「你学了也没用」。 这才是 REA 真正的意义。
intFUN_00401230(int param_1, int param_2){if (param_2 == 0) { return -1; }return param_1 / param_2;}
工具无罪:逆向工程本身是一种被法律认可的技术手段,关键看你怎么用。 行为有罪:用逆向出来的东西去侵犯版权、破坏安全机制、商业竞争,那是另一回事。 边界模糊:REA 让「获得技术理解」的成本趋近于零,这让「学」和「偷」之间的那条线,变得前所未有的模糊。