ARTICLE · 1225105
垂直AI应用+数据要素,项目制软件的双重叙事催化
A股软件股大部分是项目制,美国大多是saas,2026年1月软件股,其实2025年三美股软件已经开始跌了,代表性的是IGV,扩展科技软件行业ETF,然后对应的是SOXX半导体ETF,有几个代表性的软件龙头比如汤森路透,财捷,思爱普,奥多比,埃森哲
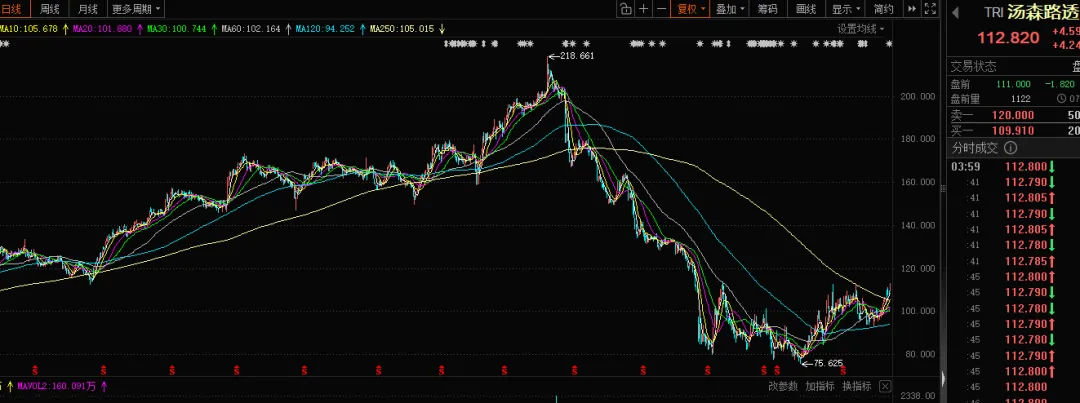
他们的股价基本是这样的,催化剂就是AI颠覆软件叙事,尤其是anthropic一次次的发布金融,法律等行业插件。
然后再6月底,随着AI基建叙事本身的弱化,硬件见顶的时候软件见底了。
但是A股的软件依然低迷,这是因为相比于美股的资金,A股的资金看即时催化剂多过长期逻辑,做短多于做长,跌下来没有催化就不可能涨,因为没人愿意买。
其实AI颠覆软件的叙事在美股行得通,但是在A股基本行不通,因为美股多是saas,SaaS卖的是标准化的"功能",功能可以被更聪明的通用模型替代,但是A股软件多数脱胎与政府和央国企的长期服务。软件功能不等于软件公司,专业数据生成+业务流程嵌入+合规资质+长期运维信任和责任承担,这些都是通用大模型既攻不破也不愿意去干的累活苦活。A股软件下跌从更深层逻辑上说,是我们框架中的付费者的能力和意愿出了问题——地方政府钱太紧张了,只能把信息化建设的资金后移。
AI颠覆软件叙事逐步远去,至少在A股逐步远期,新的正面叙事建立,资金才有可能挖掘,这个新叙事就是垂直AI应用+数据要素了。
国家数据局之后,国家数据集团成立,集团成立旨在推进数据资源开发利用、释放数据要素价值、服务人工智能发展、繁荣数据产业生态。
这里面就把数据要素和AI结合起来了。
数据被确立为继土地、劳动力、资本、技术之后的第五大生产要素,当土地财政这个老生产要素日渐乏力、地方化债压力高悬时,必须挖出新的要素来变现,在变现前,还有确权,定价,流通一系列环节需要打通。
在我们的框架中的付费者的能力和意愿中,意愿可以给到极强,意愿由紧迫性推动,而土地财政衰竭叠加化债压力要求地方必须寻找新的要素性财源,同时“人工智能+”也会给出很多带有截止时间点的政策要求。
中国政府手里的数据,是整个社会里体量很大、质量最高、也最“值钱”的那部分,这是我们产业框架里“需求强度”高分的基础,提供了充足的想象力空间。政务数据产生于法定履职,权威性、连续性、覆盖广度、公共采信度都是企业数据难以复制的。这些政务数据是发展数据要素和高质量AI燃料的基础。在我们的产业框架里,
而政府手里的数据,最方便用来当成高质量AI燃料的和数据要素的是结构化数据,比如财税。
而项目制软件公司长时间给政府做建设和运维,结构化高的数据都是在他们的系统上被生产,归集和保管的,只是这是软件交付的副产品没有被单独定价。
数据要素与 AI 底层技术,本来就是“相通”的,而且是1+1大于2的。AI 是引擎,数据是燃料;没有燃料,引擎在真实政务场景里就是一堆空转的参数。软件公司相对于拥有数据所有权的政府和拥有强大引擎的通用AI,卡位稀缺,有自研的垂直大模型和近水楼台先得月的数据,是AI 能力 × 专属结构化数据 × 政府信任的交集。
在我们的产业框架里,这个是有效供给垄断度高。原先某一块业务的建设和运维商,天然就能成为这块业务产生的数据的数据要素运营商,最终形成一批一批的区域特许经营,一个个的“自留地”。这在我们的产业趋势框架里是“有效供给垄断度高”。
AI漫剧之所以是不能投资的生意,因为有效供给垄断度极低,创作门槛极低,大部分利润因为投流归于平台方以及算力商。
按照我们的产业框架,最大的短板是供应链传导顺畅度与配套成熟度(决定业绩能否规模化兑现),确权,定价,流通,结算这些规则,都需要去捋顺,所以国家数据集团这个催化剂很重要,就是冲着捋顺去的。
最后,商业模式上,软件公司凭借稀缺卡位,赚服务费,运营费,比如数据资产化与入表服务,对于长期运维的软件商来说是“帮客户把数据变成表内资产”的自然增值服务;因为是数据的长期可信运维方处理方,可以扮演授权运营与加工中介的角色,最后,如果谁的垂直AI能力更强大,可以有数据增值运营服务,比如帮助政府来风险预警,合规审查等,相当于AI应用一定要走通“按效果付费”。
数据要素+垂直AI应用还处在很早期阶段,正在从0-1跨越到1到10,和硬件相比,还提供不了业绩可见性。但是数据要素已经是一个更连续的制度安排,所以催化剂不会断档,软件板块的股价表现也会比以前更活跃。