ARTICLE · 1232979
OpenClaw系列06-记忆系统(下):接入TencentDB Agent Memory(TDAI) 四层记忆
本地文件记忆撑到 9 月暴露短板后,我接入了 TDAI 四层长期记忆。本篇讲接入的关键认知(memory-proxy 伪装成 OpenAI 兼容 provider、静态 header 四元组做隔离),以及一次"静默停写 40 小时、零报错"的故障排查方法论。
上篇(05)讲本地文件三层记忆,并留了一个天花板:跨会话做事实级检索时,靠 grep 翻文件不可行。 本篇讲两个事:一是怎么接入外部分层长期记忆(TDAI 四层),二是接入之后必须掌握的一课——记忆链路"静默失效"的排查方法。我这套链路发生过的最痛故障,就是 6 个 Agent 的记忆静默停写 40 小时、表面完全正常、零报错。
先说结论:
接入外部记忆的关键认知不在"接入"本身,而在"隔离怎么做"——不靠会话机制,靠每个 Agent 一个专属 provider + 静态 header 四元组。 最危险的不是"报错",而是"静默失效"——记忆链路上任何一环的隐性配置缺失,可以让全部 Agent 的记忆停写几十小时,而对话表面完全正常、零报错。这类故障必须靠可观测探针兜底,靠"更小心"防不住。
一、为什么本地文件不够了
05 篇结尾留的那个问题,跑几个月之后变成了具体痛点:
我想问"3 个月前那个故障到底怎么修的",本地 MEMORY.md里其实有这条,但它被埋在几百行的经验教训区里,得靠"想起来去哪个 agent 的哪个分区找"。更根本的是:本地文件是"Agent 自己会读写的",不是"能被结构化检索的"。Agent 每次启动注入的是全文,不是按需召回。记忆量一大,注入负担陡增,且"3 个月前那条"这种精确检索没有工具可查。
需要一个真正的分层长期记忆库,支持"按需召回",而不是"全量注入"。 这就是 TDAI。
二、TDAI 四层金字塔
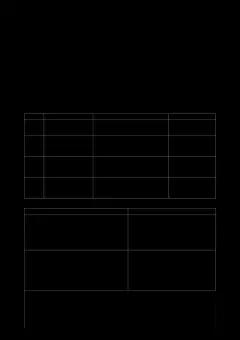
我接的记忆系统叫 TDAI(基于腾讯云数据库的记忆组件,部署在我 NAS 上跑容器)。它把记忆分成四层:
| L0 | |||
| L1 | |||
| L2 | |||
| L3 |
关键:L0 是"全量流水",L1-L3 是"提炼后的可检索层"。 本地文件只能做到 L0(而且做不到跨会话检索),TDAI 的价值在 L1-L3——把散落的对话提炼成"能被按需召回"的原子记忆。
三、接入方式:一个关键认知 + 四个 header
3.1 关键认知:memory-proxy 伪装成 OpenAI 兼容 provider
TDAI 的接入不是"在 Agent 里加一个记忆工具调用",而是:
在 OpenClaw 侧配一个 memory-proxy provider,它伪装成一个 OpenAI 兼容的模型端点。 Agent 以为自己在调 LLM,实际请求被 proxy 拦下,既转发给真正的上游 LLM,又顺手把这一轮对话写进 TDAI 的 L0,并把已提炼的记忆注入回上下文。
也就是说,记忆写入是寄生在 LLM 调用链路上的,不是独立的一步。这个认知直接决定了后面"静默失效"的形态——链路寄生 = 链路坏了你未必立刻发现(下详)。
3.2 隔离靠静态 header 四元组,不靠会话机制
多个 Agent 共享一个 proxy,怎么保证 A Agent 的记忆不串到 B Agent?
一个反直觉的事实(我实际验证过):OpenClaw 实际发给 proxy 的 custom header 里,根本没有会话级标识。 所有 Agent 的会话标识完全相同、无区分度。按"会话"隔离在这条链路上做不了。
结论:隔离不靠会话机制,靠静态 header 四元组:
x-team-id | ||
x-agent-id | Agent 级(隔离主键) | |
x-task-id | ||
x-conversation-id |
每个 Agent 配一个专属 provider(memory-proxy、memory-proxy-invest、memory-proxy-life…),各自带一组静态 x-team-id/x-agent-id/x-task-id。x-agent-id 是隔离主键。
而 x-conversation-id 这里埋了全篇最深的雷——它"看起来该有,实际 OpenClaw 不会自动发",必须每个 provider 手动填固定值。这就是下面 40 小时静默停写的根子。
四、静默停写 40 小时:故障形态与排查方法论
这是本篇主线。故障全貌先给结论,再给排查方法。
4.1 故障形态:为什么它会"静默"
某次清理 provider 配置时,x-conversation-id 被误删。后果:
proxy 判定该链路"无会话身份",跳过全部 L0 写入与记忆注入 全部 6 个 Agent 的 L0 集体静默停止写入,持续约 40 小时 期间对话一切正常、零报错、模型照常回复
最要命的点:这 40 小时里没有任何一个报错。 因为 memory-proxy 是"寄生"在 LLM 调用链上的——链路本身(转发给上游 LLM)没坏,坏的只是"顺手写记忆"那一支。模型照常回答问题,你的对话体验完全正常,没人会去怀疑"记忆没在写"。
这就是"静默失效"的完整定义:功能降级了,但所有你可见的信号都正常。 报错至少能定位;静默失效会让你几十小时都没意识到记忆在漏。
4.2 定位手段:备份对比 + 三条探针
能定位到根因,靠两条平时就有的纪律:
① 配置备份对比(*.bak-* 备份链,08 篇细讲)
清理动作前后的两份备份一 diff:前一份里 provider 还有 x-conversation-id,后一份起全缺失。时间点对上了——根因就是这次清理误删了该 header。没有备份链,"改了什么配置"根本无从查起。
② 三条探针按顺序用(已固化进我的排查手册 SOP):
1) 看 proxy 的判定结果(关键字段 injectedSkipped) 期望:conversationId=conv-... injectedSkipped=false 异常:conversationId=null injectedSkipped=true ← 静默失效的指纹2) 发一个手动带上 conv header 的受控探针,确认写入链本身没坏3) 直接查 L0 落库目录:日期文件是否还在增长三条探针回答三个不同问题:1 回答"判定逻辑现在怎么看",2 回答"写入链本身还能不能写",3 回答"停了多久"。三个答案拼起来,根因、时间窗、影响面一次全拿到。
4.3 修复与补录
修复:给每个 provider 补回按 Agent 固定的 x-conversation-id,然后重启网关。
补录(停掉的窗口里的对话要补回 L0):
按各 Agent 实际缺口区间补,不全量重导——只取"该 Agent 的 L0 确实是零写入"的时间窗,天然无重复。全量重导必产生重复记录。 单条消息有长度上限(≤8192 字符),超限直接 HTTP 400——合并工具调用结果时最容易超,必须分段。 用会话级断点续跑:每完成一个会话落一个断点,失败可安全重跑。
4.4 防复发:把"静默失效"变成"可观测"
修好之后加了一道 cron 巡检(07 篇的微澜):每小时自动跑一次"探针 + 落库增长检查",异常时走自动修复链(重放 patch → 清洗存量 → 再验证)。
主动式巡检把"下次再静默停 40 小时没人发现"的风险,压到"最迟 1 小时被发现并自愈"。 防静默失效的唯一手段是可观测性,不是"下次小心点"。
五、最终结论与教训
关键链路上必须留可观测探针。记忆写入寄生在 LLM 调用上,天然不会主动报错。要在链路里埋一个能回答"现在到底有没有在写"的探针(日志关键字段 + 落库文件增长),否则静默失效只能靠撞大运发现。 静默失效比报错更可怕。报错能定位;静默失效(表面正常、零报错)让你毫无感知。识别指纹(如 injectedSkipped=true)、固化三条探针 SOP,是把"不可观测"变成"可观测"的具体做法。可逆性纪律是排障的地基。这次 40 小时能定位到根因,全靠"删前必备份"留下的 *.bak-*链(08 篇)。没有备份链,这次故障大概率变成"发现时已污染 40 小时、且说不清改了什么"。补录要按缺口补,不能全量重导。全量重导必产生重复;按"该 Agent 实际零写入窗口"补,天然无重复。配套两条硬约束:单条消息长度上限要分段处理;会话级断点支持失败续跑。 防复发靠巡检,不靠自觉。把"探针 + 落库检查"交给每小时 cron 巡检,异常自动走修复链——"最迟 1 小时发现"替代"40 小时靠运气发现"。
文件即状态(05 篇)在外部记忆上同样成立:L0 落库也是文件(conversations/<日期>.jsonl),能直接 ls/cat 验证"在不在涨"。 外部记忆系统再黑盒,也要保证至少 L0 这层是"可被人直接看的文件",可观测性才有抓手。
下一篇预告:《07|定时任务体系:让 Agent 体系"活起来"的 cron 实践》——怎么把"人查 Agent"变成"Agent 主动找人",四类 cron 任务的实测配置,以及 cron 失败三板斧。
互动:你的 Agent 记忆系统有没有"静默失效"过?你靠什么手段发现它的?评论区聊聊。