ARTICLE · 1233226
发给AI的PDF,涂黑就算脱敏吗
把合同、简历或项目说明交给AI前,你可能会把姓名、客户编号涂黑,再上传PDF。我在本机做了一个小实验:黑框已经挡住页面上的编号,重新提取文字时,编号仍然完整出现。对有文字提取能力的工具来说,眼前那块黑色未必代表资料已经删掉。
这次没有拿真实客户文件冒险。我新建了一页PDF作为构造示例,放入一段交付说明,以及一个虚构客户标记:CLIENT-DEMO-7319。文件的作者属性也填了虚构值。整个实验没有把文件上传到聊天产品,没有测试哪个模型更会“识破打码”。
我想弄清的只有一件事:在本地看起来遮住了,交出去的文件里还剩什么?
原文件另存成两份。一份用不透明黑色矩形盖住客户标记;另一份使用PDF的删改功能,标记区域后真正应用删除,再另存。两份都重新打开,既看渲染出来的页面,也读取其中的文字。
覆盖版提取出的这一行,仍是:
Client: CLIENT-DEMO-7319
应用删改的版本,则只剩:
Client:
同页的交付描述还在。这个差异来自文件处理方式,和提示词写得客气还是严厉没有关系。
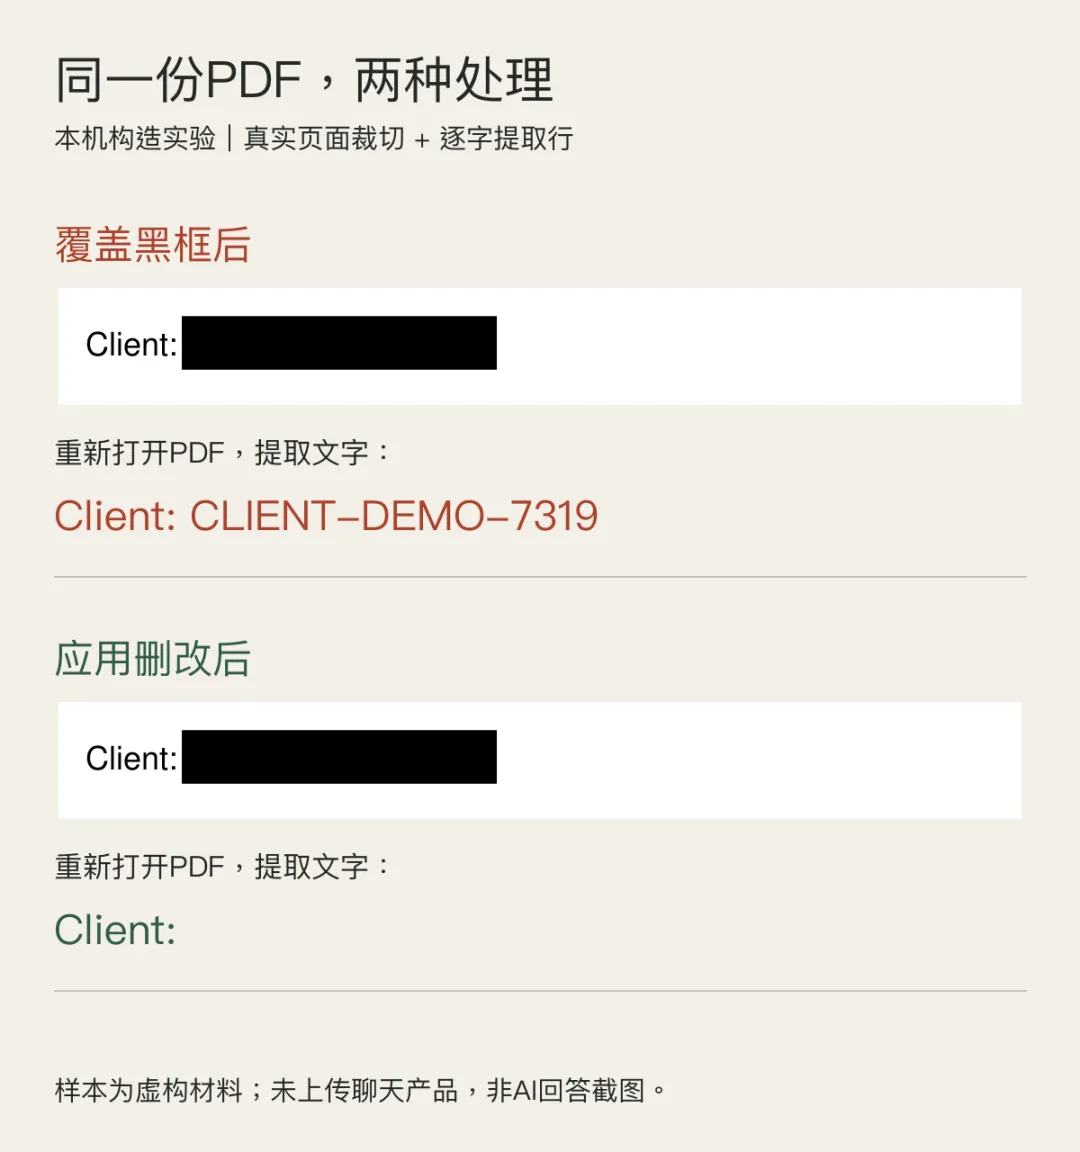
PDF可以同时保存文字、图形和其他对象。盖上一块黑色图形,只是让它后画出来,遮住前面的字;底下的文字未必跟着消失。我的覆盖版就是这样生成的。读取文件内容的程序,不必像人一样只盯着最终那张页面。
这也解释了为什么把文件交给AI,不能仅凭屏幕观感判断输入范围。OpenAI现行文件上传帮助页区分了PDF视觉检索与文本检索,并明确提到提取文件中的数字文本。这里的“数字文本”指文件保存的可读取文字,不限于数字。
它足以提醒我们:文件处理可以走文字通道,未必只是“看一张页面图片”。但本文没有登录测试ChatGPT,更没有依据这次本机结果宣称所有AI产品都会读取黑框下面的字。不同产品、套餐和文件处理路径,需要分别确认。
反过来,也不能把这件事讲成“AI能还原一切打码”。本次原字本来就留在PDF里,普通程序已经能读到,不需要猜测。只有像素的图片被彻底覆盖,是另一个问题;我没有测试模糊、马赛克、扫描件或截图的恢复能力。
字删掉了,文件还没检查完
第二份PDF通过了目标文字检查:重新提取,已经没有那个客户标记。但我又读了一次文件属性,作者栏仍然是预先填入的 AUTHOR-DEMO-8426。
这不表示删改失败。它完成了指定页面区域的处理,没有被要求顺手清空整份文件的其他信息。页面上的客户编号和文档属性里的作者,本来就在不同位置。
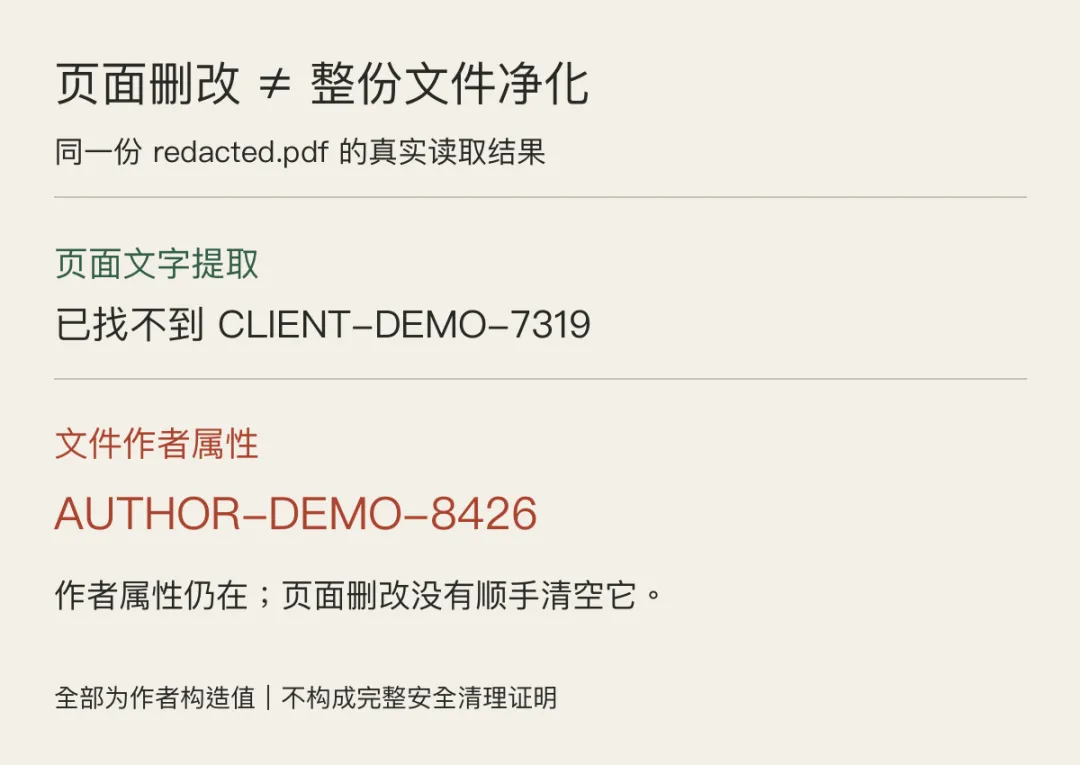
Adobe的官方说明也把可处理的信息分开列出:除了可见文字、图片,还有作者等元数据、附件、批注、隐藏文字和图层。只在页面上找名字,会漏掉这些地方。
如果你用Acrobat Pro,现行官方操作路径是“所有工具”里的PDF删改工具,选中文字和图片后点击“应用”;随后还能选择净化并移除隐藏信息,再保存文件。中文界面名称可能随版本不同,英文文档对应的是 Redact a PDF、Apply 和 sanitize。这里介绍的是Pro的官方功能说明,我没有亲手运行Acrobat,也不把它说成免费Reader自带的操作。
我这次实际使用的是本机PDF处理库PyMuPDF:先标记删改区域,再应用删改,另存时清理不再使用的对象。这只是一个可复现的机制实验,不建议普通用户为了处理一页简历先学一套代码。更实用的判断是,你所用的软件执行的是“画一个黑框”,还是“应用删改并保存”。
保存之后,要重新打开准备上传的那份副本。试着搜索被处理的标记,把相关区域复制到本地纯文本编辑器里,再检查文件属性、批注和附件。只要原文还能被读出,这份文件就还没达到你想要的处理结果。搜索不到则只说明这条检查没找到,不能据此颁发“绝对安全”证明。
还有一个更省事的选择:如果只想请AI改写交付说明,就新建一份工作副本,只放交付说明和完成任务所需的条件。客户姓名、联系人、内部报价,原本就不必一起交出去。保留“五个工作日内交初稿”这类有用约束,删掉无关身份信息,往往比对着整份文件逐块遮盖更容易检查。
若确实需要同一客户在多处对应,可以在本地用“客户甲”替换,并把对应关系留在本地;但项目名称、独特经历等仍可能让人识别身份,换个名字不等于完成匿名化。涉及保密义务或组织禁止外传的材料,也不会因为你处理过几个字段就自动获得上传许可。
我的判断是,上传前值得花时间检查的是那份实际文件:该删的内容是否还在,任务需要的条件是否保留,额外信息是否有必要交出去。页面上的黑框,只能回答“我现在看不看得见”,回答不了这些问题。