ARTICLE · 1233333
换个AI就得从头交代?20多个编码工具共用一本可手写的记忆册
[AI · Agent · 长期记忆 · 开源工具 · ai-memory · 每日AI速递]
ai-memory把Agent长期记忆写成git里的markdown wiki,交接不靠你手动说
昨晚关掉Claude Code去睡觉,今天上午打开Codex接着写,第一句话还是得从"我们上次做到哪了"讲起。
进度写到哪个文件、为什么改这个接口、昨天卡在哪个报错、哪条路走过别走了。这些东西昨晚那个窗口里都有,今天这个窗口里全是空的。
你得重新交代一遍,AI也得重新理解一遍。时间花在复述上,没花在往前赶。
这种"换个对话就失忆"的状况,最近一年被讨论得很多。解决方向分成好几派,今天这条速递的主角,选了一条很朴素的路:把记忆写成你能直接打开、直接手写、直接用git管理的markdown册子。它叫「ai-memory」。
01 · 你是不是也这样:换个窗口,AI就把前面的事忘了
先把这个日常场景说透。
一个项目你可能同时开好几个工具。Claude Code写主线,Codex跑重构,Cursor改界面,Gemini CLI查资料。每个窗口都很聪明,但每个窗口都只记得自己这一段。
早上在A工具里定的方案,下午切到B工具,B工具一无所知。你只能把A里的结论复制粘贴过去,或者重新口述一遍。
更麻烦的是断档。晚上关掉,第二天再开,上下文窗口早就被新对话挤掉了。昨天查到的约束、昨天推翻的方案、昨天顺手记下的注意事项,全部要靠人脑补。
就算不换工具,同一个长任务也会被压缩打断。上下文塞不下时,早期内容被摘要替换,细节糊成一团,AI开始重复已经否决过的方案,你得在旁边不停纠正。
团队里也一样。同事在他的Agent里摸清了一个坑,你这边的Agent并不知道,又踩一遍。新人接手项目,没有一份"这个项目为什么这么设计"的书面交代,只能靠老人口述。
问题的根子在于:现在大多数AI的记忆是「会话内的短期记忆」,对话一关,记忆就断了。项目真正需要的是「跨会话、跨工具、跨时间的长期记忆」。
短期记忆像工作台面上摊开的纸,用完就收;长期记忆像档案柜,按项目归档,下次开工直接调出来。ai-memory要做的就是给Agent配这个档案柜。
02 · ai-memory装了什么:一本git里的markdown记忆册
ai-memory是一个Rust写的单二进制程序,MIT开源,自己部署自己管。它给编码Agent配了一台记忆服务器,把每次会话沉淀成一个git仓库里的markdown wiki。
这里先交代几个容易混淆的组成部分,看这张表就够了。
有一个设计选择值得单独说:它把「真相」放在markdown文件里,数据库只是个可重建的索引。
这和很多记忆方案相反。常见做法是把记忆塞进封闭的向量库或二进制块,你想看一眼都得借它的工具。ai-memory反过来,页面就是纯文本,grep能搜,git能提交,Obsidian能开,打包能交给别人。
2.0版本开始,它采用了Google在2026年发布的OKF(Open Knowledge Format)开放格式。wiki文件本身就是合法的OKF文件,不需要额外导出一个分叉副本。记忆不被这个项目本身锁死。
页面之间还带类型化链接,causes表示因果、fixes表示修复、contradicts表示矛盾。这些链接本身就能做矛盾检查,不需要额外调用模型。查询支持as_of,你可以问"在某个日期之前,我们对这件事的认知是什么",实现按时间回溯。
本地嵌入模型默认开启后,检索从纯关键词全文升级成语义匹配。你换个说法描述需求,也能翻到当时记下的相关页,不必逐字命中关键词。模型文件约87MB,带固定校验和,第一次运行在后台下载,之后全程在本机跑。
03 · 它怎么让下一个AI接着干
机制分三步,顺着一次会话走一遍就清楚了。
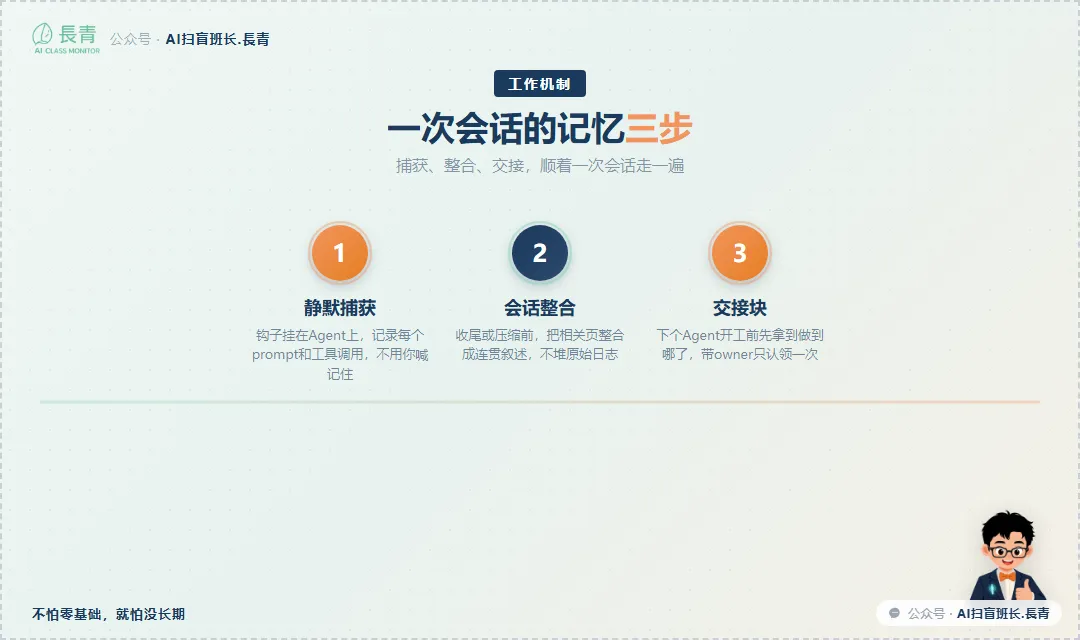
第一步是静默捕获。钩子挂在Agent运行时上,每个prompt、每次工具调用、每个会话边界都被记录下来,全程不需要你喊一句"记住这个"。
第二步是会话结束时整合。对话收尾,或者上下文要被压缩(PreCompact)之前,相关的页面被整合成一段连贯叙述,而不是堆原始日志。
第三步是交接。同一个目录下,下一个Agent启动,在它收到第一条任务之前,先拿到一个带类型的"where you left off"交接块,知道前面做到哪、为什么停、下一步该接什么。
交接这块它做了一个防重复设计,叫claim-once。交接棒有唯一owner,被一个会话认领之后就失效,第二个会话不会把同一根棒抢走。你留给同事的待交接内容,不会被他的Agent误吞。
个人和团队也分开。每个人"我正在做什么"的槽位按人隔离,你的私人上下文不会漏进团队的公共简报。
并发写入靠单写者队列加背压。两个窗口同时写同一页,第二个不会覆盖第一个,而是生成新版本进版本链,旧版本还能回溯。这一点直接关系到它为什么没像某些竞品那样在并发写时损坏数据。
04 · 和别的记忆方案比,差异在哪
给Agent做长期记忆,市面上已经有好几条路线,各有取舍。
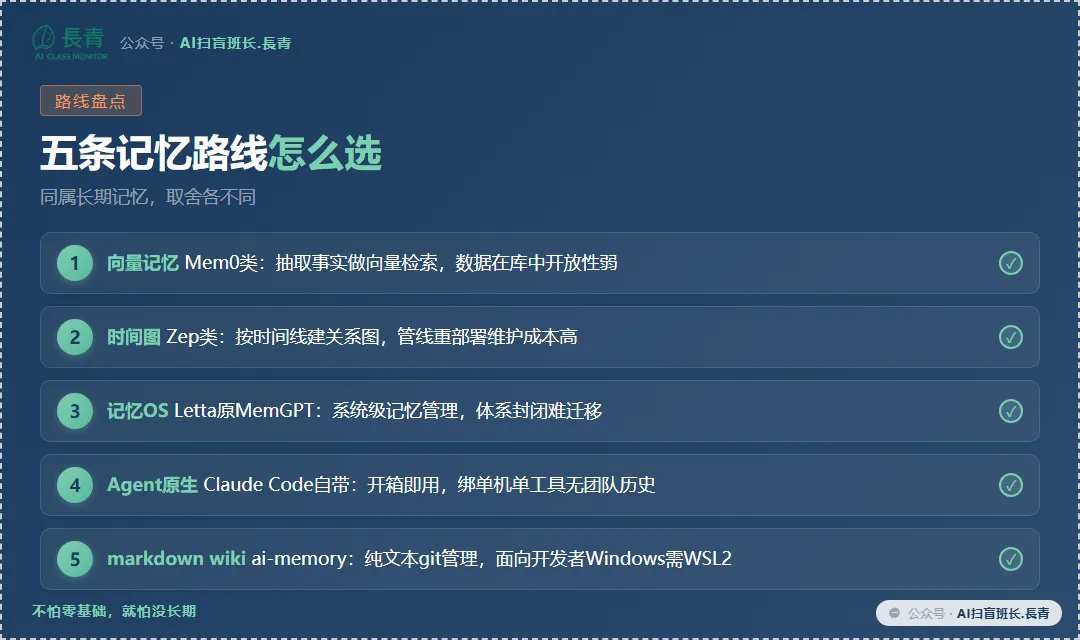
作者在2.0前做过一轮2026年市场调研,文档留在仓库里。这里面有个值得记下的教训:MemPalace两周内冲到近5万星,吸引了大量关注,但审计后发现基准数字注水,而且两个写操作同时发生时会损坏数据。热度高不等于稳,记忆这种要长期留底的东西,并发一致性比星数重要。
ai-memory把几个点凑在了一起,这是它和单个竞品拉开距离的地方。
跨Agent。二十多个运行时喂进同一本记忆,Claude Code、Codex、Cursor、OpenCode、Gemini CLI等都在支持列表里,交接是一套有类型、带owner、只认领一次的协议。
跨机器。记忆放在你自己的服务器上,台式机做到一半,笔记本接着拿,项目落在同一个位置,不跟着某台电脑走。
给团队用。多人指向同一台服务器,写入带署名,自带审计日志,谁改过哪页都查得到。
默认不花模型钱。零LLM路径下,捕获、检索、注入、交接都不需要API key。本地嵌入模型默认开启,纯Rust跑all-MiniLM-L6-v2,约87MB,不需要GPU,数据不出本机。作者自评在LongMemEval-S上,命中率hit@5从纯全文的0.617升到0.779,这个数字是作者自己测的,缺独立第三方复测,先记着参考。
05 · 上手门槛与真实局限,先讲清楚
它面向开发者,门槛要如实说,别吹成人人能装。
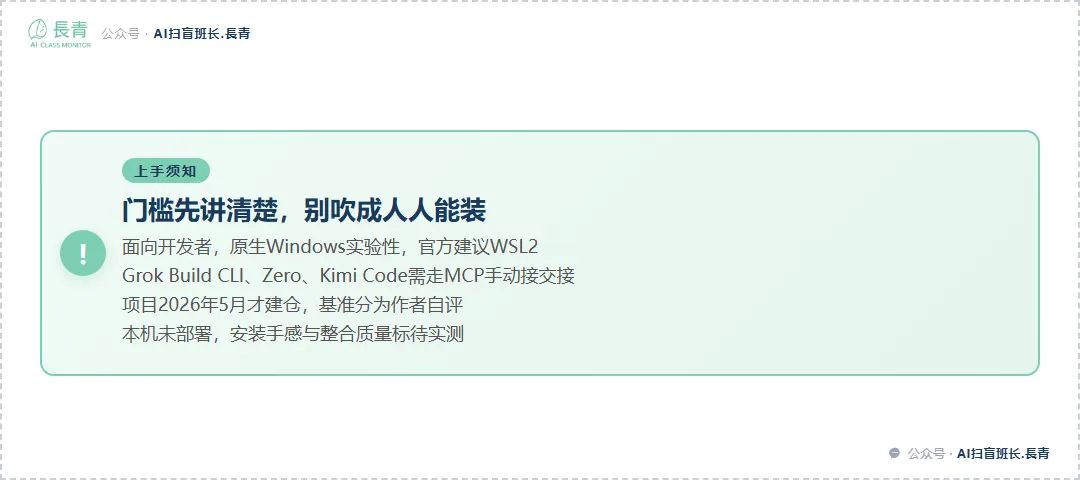
主目标是Linux和macOS,原生Windows还是实验性,官方建议用WSL2。普通办公读者暂时用不上安装流程,看懂趋势就够。
不是所有客户端都能自动交接。Grok Build CLI、Zero、Kimi Code这几个会丢弃SessionStart钩子的输出,自动交接注入不生效,得改走MCP的memory_handoff_accept工具手动接。
项目2026年5月才建仓,迭代快,版本号涨得猛,长期维护性还需要继续观察。基准分为作者自评,没有独立端到端对比。本机这一轮没有实际部署,真实安装手感、响应速度、整合质量都标「待实测」。
安装渠道含release二进制、Homebrew、AUR和Docker,单二进制起步,团队模式则在一台homelab或内网机器上起服务器,前面加HTTPS反代,每人把自己的Agent指向同一URL,后端仍是单SQLite,不堆多套数据库。
团队模式下,公共页面所有人可读可写,靠审计日志记录归属,故意不做逐页权限隔离;交接棒和"正在做"槽位才是私有边界。这是一种取舍:把信任放在记录和历史里,而不是给每页上锁。
零LLM模式能跑,是指检索和交接不花钱。如果你要让它自动把几轮会话整合成更聪明的页面、做矛盾lint、给自动改进建议,那才需要选配一个LLM provider,这部分是可选的。
06 · 今日速递:另外几条值得扫一眼
除了主选题,过去24小时还有几条动态,快速过一遍。
GPT-6 Astra Pro多智能体并行。OpenAI在10月16日升级,Pro档可以让多个智能体分头处理同一任务,主对话跟踪各支线进度,点开能查每支成果。并行只对没有依赖的部分有效,前后有依赖的步骤仍要按序。Plus档位用不了Chat内的GPT-6 Pro,200美元档和100美元档分周限额。OpenAI近30天我们已经写过,这条只作快讯。
可灵Kling 4.0全量上线。快手10月15日晚推出,10-bit HDR,支持4K、1080p和21:9超宽,单次原生最长30秒一镜到底,可续拍延展到约2分钟,单次最多输入10张图、5段视频、7个主体,并接入MCP和CLI,企业与开发者API近期开放。
FLUX 3 Image Klein开源。Black Forest Labs 10月15日发布,5.6B开放权重,INT8量化后8GB显存可跑,支持到4K,API按张计价,年收入低于500万美元可用Kommunity License免费商用。它要配合prompt upsampler使用,短直出效果会明显变弱,图中文字可能变形,目前没有独立榜单排名。
LongHorizon-Harness长任务循环。它包在编码Agent外面,把任务切成有界步,独立Auditor核验真实产物,只把通过的记为进度,失败回到检查点。作者报告通过率从51.8提到80.7,属于自述,待实测;8月后基本没有新提交。
ai-job-search求职技能库。GitHub上5万余星,12个slash命令加6个招聘门户skill,起草agent和fresh context审稿agent分开,职位帖当不可信输入处理。它面向丹麦市场,需要付费Claude Code订阅和LaTeX工具链,本地化要自己改。
Product Hunt 10月18日榜。第二位mylens,做AI规模化一对一live presentation;第三位shim-cli,查看并脱敏coding agent外发的内容,记录每次调用,本地运行。
AI财务方向,过去24小时没有拿到真正的重大新发布,按不凑数原则这一条今天不收。
07 · 收尾
回到开头那个场景。你关掉一个AI,打开另一个,不想再从头讲一遍,是因为项目是你的,记忆也该是你的。
模型和订阅这个月选哪家,下个月可能换一家。项目沉淀下来的决策、踩过的坑、走到一半的进度,应该留在自己手里,纯文本、可手写、能进git,这是ai-memory给出的答案。至于装不装、值不值得为你的项目配一台记忆服务器,等你真的被"又要重讲一遍"磨到,再回来对照第05节的门槛判断。
觉得有用就关注我吧
后续还有更多AI工具实战拆解持续更新
把工具用明白,把方法讲清楚
欢迎点赞·关注公众号
你好,我是長青,你的AI工具实战向导。