ARTICLE · 1240134
【开源】DeepSeek 把整页文档压缩成 1120 个视觉 token:OCR 的竞争重点,正在从“识字”转向“阅读”
【开源】DeepSeek 把整页文档压缩成 1120 个视觉 token:OCR 的竞争重点,正在从“识字”转向“阅读”当 OCR 能“看懂”阅读顺序,文档数字化才算真正进入 AI 时代 传统 OCR 的主要工作,是把页面中的字符框出来。 但现实中的文档并不是一串从左上角开始、严格按像素排列的文字。论文有双栏,报表有合并单元格,教材混排公式和图注,报纸则同时包含正文、标题、图片和广告。即使每个字都被正确识别,只要阅读顺序错误,最终输出仍然是不可读的。 DeepSeek 于2025 年 10 月 20 日开源初代DeepSeek-OCR,随后在2026 年 1 月 27 日开源DeepSeek-OCR 2。 两代模型解决的是两个不同问题: 因此,DeepSeek-OCR 2 不只是一个更准的 OCR 模型,它更像是一次文档理解范式的调整:
初代 DeepSeek-OCR 由 Haoran Wei、Yaofeng Sun 和 Yukun Li 完成。相关论文于 2025 年 10 月 20 日随代码与权重公开,并于次日提交至 arXiv,论文题目为: 它的研究对象不是简单的照片文字识别,而是文档图像中的光学二维映射压缩。 其原始思路是:与其把一页文档展开为大量文本 token,不如先将其渲染为图像,再由视觉编码器压缩为少量视觉 token,最后由解码器还原成 Markdown、HTML、表格或公式。 论文中的关键表述是: 这说明初代 DeepSeek-OCR 的价值,不能只用 OCR 准确率衡量。它还试图回答一个更长远的问题: 公开实验显示,当文本 token 数量不超过视觉 token 的 10 倍,即压缩率低于 10 倍时,OCR 精度约为97%。 可以把它理解为: 但压缩率继续提高后,曲线明显下滑。在 20 倍压缩时,OCR 准确率仍约为60%。 这意味着“视觉压缩”并非无损容器: 因此,它更适合作为工作记忆、摘要索引和草稿层,不能直接替代对真实性要求极高的档案级复制。
初代 DeepSeek-OCR 由两部分组成: 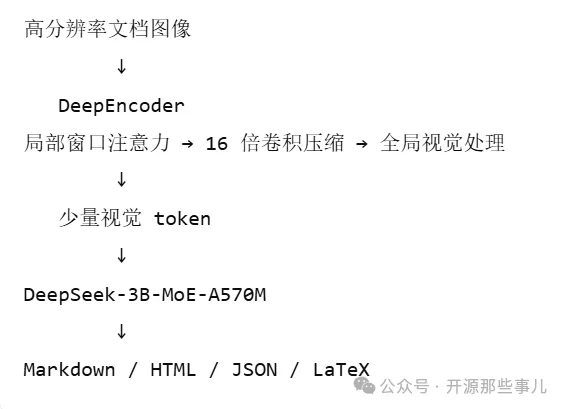
DeepEncoder 的参数规模约3.8 亿,由约 80M 的 SAM-base 和约 300M 的 CLIP-large 串联组成。 它的任务不是传统意义上的“图像增强”,而是: 其主要路径可以概括为: 这相当于先把整页文档“扫一遍”,再“捏成”少量信息,最后交给语言模型阅读。 模型总参数约为30 亿,但每个 token 实际激活约5.7 亿参数。 MoE 架构的优势是:不必让所有参数都参与每一次推理。因而它有机会在总容量、推理成本和任务表达之间取得平衡。 初代模型支持多种推理模式,可以处理: 官方称其训练数据覆盖约 100 种语言,并支持 Transformers、vLLM 和 SGLang 等推理后端。模型权重采用MIT 许可证,代码与 BF16 权重已在 GitHub 和 Hugging Face 开放。
如果初代模型回答的是“如何压缩文档”,那么 DeepSeek-OCR 2 回答的是: 传统视觉语言模型通常按照固定栅格顺序处理图像: 这种处理方式和人类阅读并不一致。看到一份复杂页面时,人通常不会机械地扫描每个像素,而是先判断整体结构,再决定先看标题、表格、图注还是正文。 DeepSeek-OCR 2 将这种差异称为传统 VLM 中的不合理归纳偏差,并提出“视觉因果流”机制。 DeepEncoder V2 最重要的变化,是用 Qwen2-0.5B 这样的轻量语言模型结构,替换前代基于 CLIP 的视觉知识压缩模块。 视觉编码器不再只是“识别图像特征”,而是开始承担一定语言和结构推理能力。 整体结构如下: 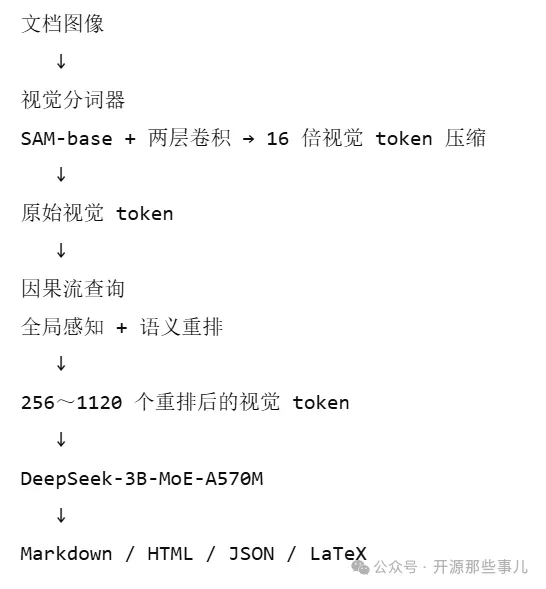
DeepEncoder V2 的关键不是简单加入一组查询 token,而是使用定制化注意力掩码,同时处理两种任务。
这个过程不是让模型随机跳跃,而是形成一个有先后依赖的“阅读计划”: DeepSeek-OCR 2 的整体推理可分为两级: 判断版面中哪些内容具有逻辑先后关系,并对视觉信息进行重排。 根据已经重排的视觉 token,生成 Markdown、HTML、表格或公式。 因此,它试图解决的核心问题是:
为了处理不同分辨率的页面,DeepSeek-OCR 2 使用多裁剪策略: 一个 1024×1024 的全局视图,产生约256 个 token; 一个 768×768 的局部视图,产生约144 个 token; 组合 0~6 个局部视图; 最终送入语言模型的视觉 token 控制在256~1120。 这里的 256~1120,不是模型能够识别的文字数量,而是每页用于表达视觉信息的 token 预算。 这种动态裁剪比“每页固定切成大量块”更经济:
DeepSeek-OCR 2 在 OmniDocBench v1.5 上的综合得分为91.09%,前代为87.36%,提升3.73 个百分点。 该基准覆盖杂志、论文、报告等九类、共1355 页中英文文档。 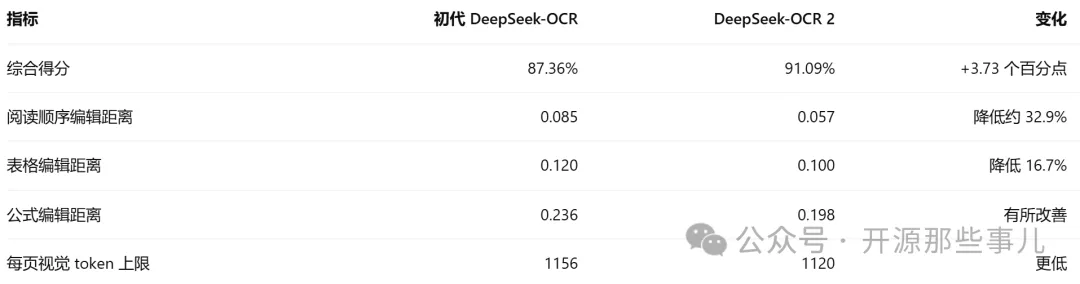
其中,“阅读顺序编辑距离”尤其值得关注。该指标越低,代表模型输出顺序越接近标准阅读顺序。 复杂文档的主要痛点通常并不是单个字无法识别,而是: 阅读顺序错误率下降,意味着模型可能更接近“理解版面”,而不只是“识别字符”。 在相同的1120 个视觉 token预算下:
文档解析编辑距离越低越好。因此,在这一设定下,DeepSeek-OCR 2 的表现优于对比模型。 同时,前代 DeepSeek-OCR 使用约100 个视觉 token时,已经能够超过 GOT-OCR2.0 在 256 个视觉 token 下的结果;其使用不到800 个视觉 token时,也优于某些每页使用 6000 个以上视觉 token 的模型。 但这并不能直接推导出“所有文档一定识别得更好”。OmniDocBench 是公开基准,其分布不能完整代表报纸、工程图纸、古籍、手写票据或企业内部模板。
传统方法处理整页文档时,经常需要大量视觉 token。视觉 token 越多,后续语言模型需要处理的信息越长,显存和延迟压力也越大。 DeepSeek-OCR 的路线是: 它并不保证“压得越少越好”,但为长文档处理提供了一条明确的优化路径:
固定栅格扫描假设版面天然具有从左到右、从上到下的语义顺序,但现实文档并非如此。 DeepSeek-OCR 2 的因果流查询允许模型: 这让 OCR 从字符识别工具更接近文档理解模型。
如果视觉模态能够用少量 token 保存较完整的页面信息,那么它就可能承担: 初代论文也讨论了利用该管线批量生成训练数据:在单张 A100 上,每天可以生成超过 20 万页用于训练大语言模型和视觉语言模型的语料。 但必须谨慎理解这一能力:
DeepSeek-OCR 与 DeepSeek-OCR 2 的代码、权重和论文均已公开,并支持自托管。 其主要价值是: 不过,“开源”仍有使用边界。不同仓库、权重和组件的许可证可能不同,商业部署前应逐项检查许可证、模型卡和专利声明,不能直接把“权重开放”等同于“所有用途均无限制”。
DeepSeek-OCR 2 并非所有文档场景的最佳答案。 文本密度极高的报纸、旧印刷材料和拥挤版面,识别效果相对较弱。原因在于: 复杂表格中的跨页单元格、多层表头、旋转表格、无边框表格和错位合并单元格,仍可能产生结构错误。 输出看起来像 Markdown 表格,并不等于: 10 倍压缩时的 97%,是特定实验条件下的指标,不是所有文件都能达到的统一精度。 当压缩率接近 20 倍时,60%左右的准确率意味着模型已经进入“能恢复部分信息,但不能承担精确复制”的区间。 虽然每次激活参数约为 5.7 亿,但模型总参数量达到 3B,且需要加载编码器、解码器和视觉分词组件。实际部署仍可能依赖: 因此,它并不是“一台普通电脑即可低成本无限运行”的轻量 OCR。
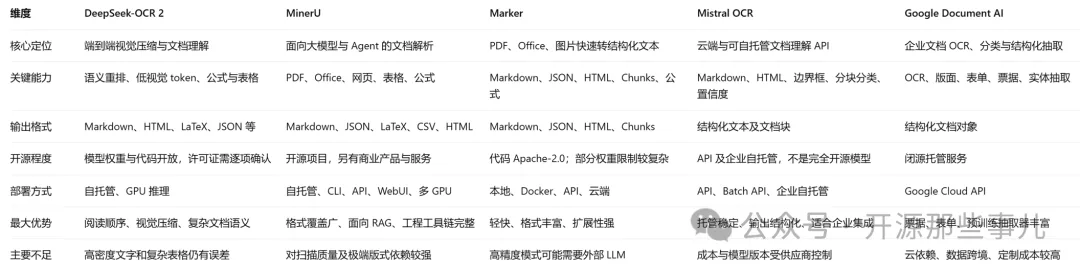
MinerU 更像面向知识库和大模型应用的文档解析引擎,支持 PDF、Word、PPT、Excel、图片和网页,并能够输出 Markdown、JSON、LaTeX 和 CSV。 它还提供: MinerU 的优势是工程集成和格式覆盖;DeepSeek-OCR 2 的优势则是基础视觉编码和阅读顺序。 两者不一定互斥。更现实的架构是: 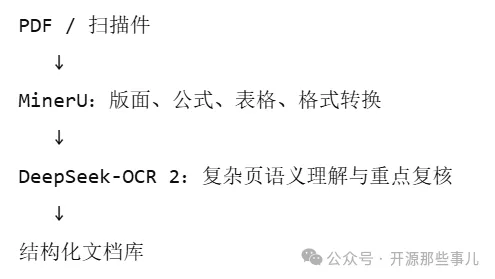
Marker 的特点是部署门槛相对灵活,支持 GPU、CPU 和 Apple 芯片,可以输出 Markdown、JSON、HTML 和 Chunks。 它还提供: Marker 的优势是“快”和“方便”,适合: 普通 PDF; 内容发布; 知识库转换; 表格、公式和参考文献提取; 对响应速度要求较高的流程。 DeepSeek-OCR 2 更适合文字密集、语义结构复杂、阅读顺序容易错乱的页面。 需要注意,Marker 的代码采用 Apache-2.0,但其模型权重许可证并非简单等同;商业使用前仍要查看具体版本和许可证。
Mistral OCR 的优势在于: 在 Mistral 公布的官方价格中,OCR 4 标准 API 为每1000 页 4 美元,Batch API 为每1000 页 2 美元;Document AI 为每1000 页 5 美元。 它更适合希望直接调用托管服务,并需要边界框、置信度和结构化分块的企业。 DeepSeek-OCR 2 的差异化优势则是: 如果团队最重视“供应商可控、模型可定制”,优先评估 DeepSeek-OCR 2;如果最重视“快速上线、边界框和置信度”,Mistral OCR 更适合。
Google Document AI 的优势是成熟的云端产品体系,包括: 但它是闭源托管服务,通常存在云绑定、数据跨境、版本管理和定制费用等问题。 两者适合解决的问题不同:
推荐采用“传统 OCR 保字符、视觉模型保语义、规则保字段、人工保责任”的四层结构。 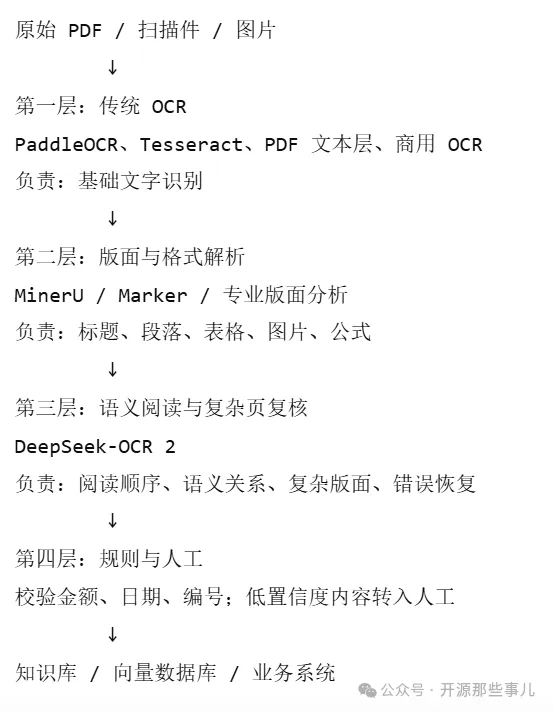
重点检查: 重点检查: 重点检查: 即使是 DeepSeek-OCR 2,也不能成为法律、财务等高风险字段的唯一数据源。
不要只依赖公开榜单。至少覆盖: 只统计字符准确率是远远不够的,应分别统计: 对于金额、证件号、合同责任、医学指标等高风险字段,应设置: 不同页面不宜使用完全固定的预算: 97% 是特定实验条件下的指标,不能直接换算为“每页只错 3%”。 真实文档的误差可能是: 这些错误对叙事文本可能可以接受,对金融、法律和科研数据却可能造成严重后果。
DeepSeek-OCR 2 最重要的价值,不只是提高了 OCR 准确率,而是重新定义了文档模型应该优化的对象: 初代 DeepSeek-OCR 证明了“少量视觉 token 也能恢复大量文档信息”;DeepSeek-OCR 2 则进一步证明,视觉信息的处理顺序本身,就是文档理解的一部分。 它的优势可以概括为: 它的边界同样明确: 因此,DeepSeek-OCR 2 适合作为复杂文档的语义理解层,而不是所有文档场景的单一答案。对于 RAG、知识库、档案数字化和版面复杂的文档,它值得实测;对于身份证、合同金额、财务报表等关键数据,仍应保留传统 OCR、规则校验和人工复核。 真正成熟的文档智能化,不是“交给一个大模型”,而是: 项目地址: Gitee/GitHub: 8元解锁820+优质项目!别再瞎找资料了!AI140+、低代码140+、数字人30+,AI数据治理 Agent实战教程一网打尽,永久更新!
初代解决“长文档如何用极少视觉 token 表达”; 二代解决“视觉 token 应该按照什么语义顺序被理解”。
从固定扫描版面,转向按语义和逻辑关系阅读文档。
DeepSeek-OCR 从何而来:一次关于“视觉压缩长上下文”的公开实验
《DeepSeek-OCR: Contexts Optical Compression》
本项目是对“通过光学二维映射压缩长上下文”可行性的初步探索。
视觉模态能否成为一种高密度、可重建的上下文压缩介质?
从 10 倍“找回”到 20 倍“勉强理解”
600~700 个文本 token,被压缩到 64 个视觉 token; 模型仍能恢复 96.5% 的原文; 100 个视觉 token 时,恢复率达到 98.5%。
10 倍以内更接近“可恢复表达”; 20 倍时开始丢失信息; 极限压缩下,模型可能依靠语言先验补全内容,而不只是读取视觉证据。
初代核心原理:DeepEncoder 压缩,MoE 解码器重建
1. DeepEncoder:不只做 OCR 前处理
处理高分辨率输入; 保留局部文字细节; 压缩视觉序列长度; 生成后续模型能够使用的视觉 token; 在高分辨率输入下尽量控制计算量。
局部窗口注意力; 16 倍卷积下采样; 全局视觉处理。
2. DeepSeek-3B-MoE-A570M:参数总量大,激活参数并不大
OCR; 版面分析; 图表与表格提取; 公式识别; 化学结构; 图像描述; 视觉定位; 多语言文字识别。
DeepSeek-OCR 2:真正的变化不是参数增加,而是“怎么读”
视觉信息应该按照什么顺序进入语言模型?
从上到下; 从左到右; 按照图像块的位置依次展开。
DeepEncoder V2:用轻量语言模型充当视觉编码器
双轨注意力:既要“看到全局”,也要“确定顺序”
信息类型 | 注意力方式 | 主要职责 |
|---|---|---|
原始视觉 token | 双向注意力 | 保留版面、位置与全局信息 |
因果流查询 token | 因果注意力 | 按先后顺序决定“下一步关注什么” |
视觉 token | 可相互关注 | 建立整页全局感知 |
因果查询 token | 只能关注前面的查询及全部视觉 token | 逐步组织新的阅读序列 |
最终送入解码器 | 因果流查询的输出特征 | 以语义逻辑而非像素顺序驱动输出 |
先感知整页; 再识别标题、正文、表格、图注和公式; 根据语义关系确定理解顺序; 最后由语言解码器按序列生成结果。
两阶段因果推理
编码器:阅读逻辑推理
解码器:视觉任务推理
二维版面不能直接平铺为一维序列,但语言模型又需要一维因果顺序。与其强行指定像素顺序,不如让编码器先学习语义顺序。
多裁剪策略:模型不再“一页一视”
简单页面使用较少 token; 复杂页面增加局部视图; 高分辨率细节按需补充; 总预算有上限; 下游模型不需要处理无限增长的视觉序列。
性能表现:它强在“阅读顺序”,不只强在字符识别
OmniDocBench v1.5
双栏正文串行; 表头与表格错位; 公式与正文混淆; 图注和图片分离; 跨页表格关系断裂。
与 Gemini-3 Pro 的同等预算对比
模型 | 每页视觉 token | 文档解析编辑距离 |
|---|---|---|
Gemini-3 Pro | 约 1120 | 0.115 |
DeepSeek-OCR 2 | 1120 | 0.100 |
它的优势:不只是识别字符,而是压缩理解成本
1. 用视觉 token 控制长文档成本
高分辨率输入; 局部与全局信息结合; 视觉特征深度压缩; 少量视觉 token 进入语言解码器。
把昂贵的语言上下文预算,尽量留给真正需要理解和生成的部分。
2. 从“识字”升级到“阅读”
先看标题,再看正文; 先识别表格结构,再填充单元格; 先判断图注,再联系图像; 对复杂版面动态选择阅读路径。
3. 视觉压缩可能成为大模型记忆层
历史对话压缩; Agent 工作记忆; 长文档摘要; 页面级检索; 训练数据合成。
高压缩不等于无损记忆,视觉重建也不等于逐字精确存储。
4. 模型、代码和论文同步开放
数据和文档可以不离开本地环境; 可以针对中文、专业术语和内部模板微调; 可以接入企业 RAG、知识库和审核流程; 可以替换底层推理后端; 不会完全受单一闭源 API 路线约束。
局限:它更适合复杂文档理解,不能无条件取代传统 OCR
1. 高密度文字仍有明显挑战
视觉压缩会丢失细粒度信息; 字体小、字符密集时更容易发生误读; 极限压缩可能使模型依靠上下文猜词; 高密度页面的重排难度也更高。
2. 表格结构不能保证完全还原
表头正确; 单元格对应正确; 汇总行没有错位; 跨页关系已经恢复。
3. 高压缩不等于无损
4. 运行门槛不可忽视
GPU 显存; 推理框架; 合适的模型后端; PDF 预处理; 图像分辨率控制; 批量并发管理。
与其他文档识别平台的对比
1. 与 MinerU:一个研究模型,一个工程型文档流水线
命令行工具; 本地 API; WebUI; 多 GPU 路由; 文档库与检索; Agent 和 MCP 支持。
2. 与 Marker:一个偏重模型推理,一个偏重快速转换
快速模式; 混合模式; LLM 增强模式; Docker 部署; Streamlit 界面; JSON Schema 结构化抽取。
3. 与 Mistral OCR:一个偏模型研究,一个偏企业服务
API 和 Batch API; 单容器企业自托管; 边界框; 分块类型; 页级和词级置信度; 文档对象化输出。
模型与权重开放; 可本地运行; 支持更深度的定制; 阅读顺序研究路线清晰; 视觉 token 预算较低。
4. 与 Google Document AI:一个偏文档理解,一个偏企业文档业务
OCR; 版面分析; 表单理解; 发票识别; 银行单据; 身份凭证; 自定义抽取器; 工作流和人工复核。
场景 | 更适合的工具 |
|---|---|
高精度抽取发票、表单、ID | Google Document AI |
本地部署、模型微调 | DeepSeek-OCR 2 |
中文复杂版面与公式 | DeepSeek-OCR 2 |
快速接入 GCP 工作流 | Google Document AI |
数据不得离开本地 | DeepSeek-OCR 2、MinerU、Marker |
需要词级置信度路由人工复核 | Mistral OCR |
企业落地:应该把它放在哪一层?
最值得优先处理的三类文档
1. 学术论文和教材
双栏阅读顺序; 公式与正文对应; 图表引用; 参考文献; 跨页内容。
2. 财务报表和研究报告
表格表头; 汇总行; 指标单位; 页码和脚注; 图表与说明对应关系。
3. 合同、法规和制度文件
条款编号; 引用关系; 表格与正文; 日期、金额和责任主体; 跨页条款。
上线前必须检查的五件事
1. 建立自己的文档测试集
中文与英文; 单栏与双栏; 数字表格; 合并单元格; 公式; 扫描件; 拍照倾斜; 模糊和阴影; 低质量 PDF。
2. 分别评测字符层、结构层和语义层
字符准确率; 字段准确率; 阅读顺序准确率; 表格结构准确率; 公式准确率; 金额、日期等关键字段准确率。
3. 设置置信度与人工复核
置信度阈值; 多人复核; 规则校验; 来源页定位; 人工审批节点。
4. 显式管理视觉 token 预算
简单页面使用较低预算; 复杂页面增加局部视图; 极密集页面使用更高分辨率; 对低置信度页面重新处理; 记录每页的 token 数、耗时与成本。
5. 不要把 97% 理解为“整份文档无损”
一个数字识别错误; 两行内容串行; 表格整体错位; 一个表头关联错误; 公式结构变化。
结论
不是简单增加视觉 token,而是让模型先学会如何阅读。
视觉 token 预算较低; 复杂版面阅读顺序改善; 表格和公式理解增强; 模型与代码可以本地部署; 支持 Markdown、HTML、LaTeX 和 JSON 输出; 为长上下文压缩和多模态记忆提供了研究路线。
高密度文本仍有误识别; 复杂表格结构仍会出错; 高压缩不保证无损; 商业使用需要确认许可证; 自托管仍有显存、吞吐和运维成本。
字符识别交给确定性工具,语义理解交给视觉模型,关键决策留给规则与人工。
https://github.com/deepseek-ai/DeepSeek-OCR