ARTICLE · 1245676
Taskonomy 源码精读:训完约 3000 个迁移网络算出任务关系图,CVPR 2018 最佳论文怎么省下三分之二标注
Taskonomy 源码精读:训完约 3000 个迁移网络算出任务关系图,CVPR 2018 最佳论文怎么省下三分之二标注2018 年 6 月盐湖城的 CVPR 颁奖台上,斯坦福和伯克利的一篇论文拿走当年唯一一个最佳论文奖:Taskonomy。它的问题一句话能问清楚——视觉任务之间到底是什么关系?表面法线能不能帮你算深度?它的答案也很硬:不猜,训网络量出来。二十六个任务两两之间训了约三千个迁移函数,再解一个整数规划,把「谁该当谁的老师」变成一张可查的图。 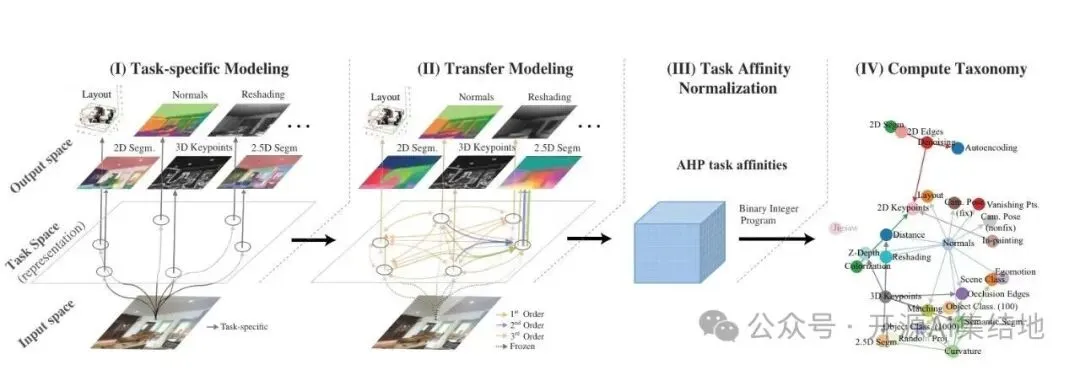
Taskonomy 解决的是迁移学习里最古老的一个盲选问题:手里有个新任务、标注只有几千张,想找个源任务先学再迁过来——选谁?2018 年之前的惯用答案是 ImageNet 特征,万金油,但万金油的意思是处处平庸。这篇论文给出一套全计算流程:先为二十六个任务各训一个任务网络,再在任务两两之间训低容量迁移函数,用层次分析法把不同量纲的损失归一成亲和度,最后解一个带监督预算约束的二元整数规划,输出一株迁移结构图。 改了什么:它把「任务关系」从研究领域的手感问题,变成一个可复算、可求解的优化问题,并且顺手造了一个四百万张图、每张图带全套任务标注的室内场景数据集。 拿到什么:按论文摘要的账,解十个任务的监督数据总量能比各训各的省下约三分之二,性能几乎不掉。 停在什么条件:官方代码是 TensorFlow 0.12 的存档版,仓库 README 自己写着「供存档参考、不再维护」;解图用的 BIP 求解器代码没有随库发布,交互式求解器在项目网站上在线用。 只看一处的话,看 code/assets/transfers/config_prototype.py——迁移函数怎么定义、源编码器怎么冻结、读出网络多小,一份配置全说清。 把场景放具体。你想训一个表面法线估计,标注图只有八千张,直接训出来是糊的。直觉说:法线和深度、和曲率应该沾亲带故,先训个深度再迁过来呗。但「应该」不是答案——深度的表示里到底装没装法线要的信息?装了的话一个小读出网络能不能取出来?换成先训语义分割呢? 这件事在 2018 年之前没人量过,原因有两个。第一是量不起:二十六个任务,一阶两两组合就是五百多个迁移函数,加上高阶组合是个组合爆炸,每一格都是一次真金白银的训练。第二是没法比:深度的均方误差和场景分类的交叉熵、相机位姿的姿态误差,根本不在一个量纲里,把损失值摆进一张矩阵直接比大小是错的;连每行各自线性归一到 0 到 1 都不行,因为损失和质量之间的换算曲线是未知的,单调性是唯一敢假设的东西。 于是大家的实践退而求其次:要么用 ImageNet 特征当万能源任务,要么一年换一个自监督 pretext task,全凭信仰。Taskonomy 的判断是,卡点不在选任务,在于「任务亲和度」这个量本身不存在——那就先把它造出来。 主线一句话:把任务间关系做成一张带权有向超图,图的边权是「从源任务迁到目标任务能有多好」,图由四步流水线算出来。 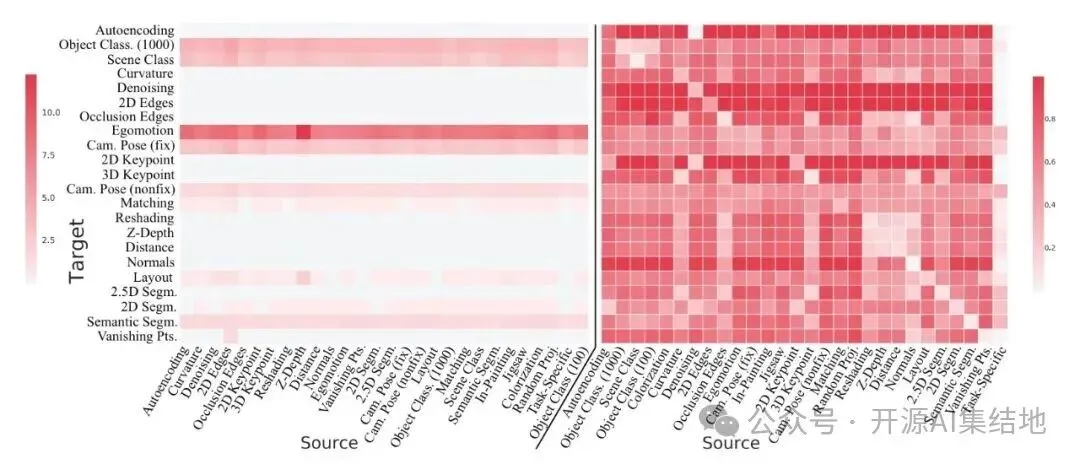
第一步给二十六个任务各训一个任务网络,架构全任务同构:编码器统一用不带池化的全卷积 ResNet-50,超参数全任务统一,像素类任务的解码器是十五层全卷积,低维任务两三层全连接。同构是刻意的——架构差异会污染亲和度。 第二步训迁移函数。源任务的编码器冻结,表示预先抽好存成文件,只在它上面训一个小读出网络。小是刻意的:读出网络容量大了,什么信息都能硬挖出来,亲和度就失去区分度;用比任务网络少 8 到 120 倍的数据训也是刻意的,迁移要在「便宜」的前提下成立才有意义。高阶迁移允许多个源任务联合迁一个目标,用束搜索压组合数。 两个设计里第一个说完了,第二个是归一化。式 (2) 的锦标赛比率:w'_ij = P(s_i 迁移到 t 更好) / P(s_j 迁移到 t 更好)。三个量:在保留测试集上 s_i 的预测赢过 s_j 的图像比例当分子,反过来 s_j 赢的比例当分母,胜负计数先剪裁到 [0.001, 0.999] 做 Laplace 平滑防止除零。这样每个目标任务得到一张两两比较的正互反矩阵,取它的主特征向量当各源的亲和度——特征向量中心性,本质是无穷随机游走落在各源上的时间占比。各目标的主特征向量摞起来就是亲和度矩阵 P,只假设了单调性,绕开了量纲。 第四步解图:监督预算 γ 限死能从头训几个源任务,每个目标是选一个迁移还是自己全训,在预算内最大化总亲和度。这是一个二元整数规划,论文引用的求解器口径是「几分之一秒解完」。解出来的最优子图就是 taxonomy,预算一变图就跟着变。 调用链从 code/tools/transfer.py 起跑:读迁移配置、装载数据管线、建 TransferNet、训完把损失和检查点落盘。配置由 tools/script/generate_transfer_configs.py 批量生成,模板就是 config_prototype.py。 第一处对读:论文 3.2 节式 (1) 和图 4——迁移函数 D_s→t = argmin E[L_t(D_θ(E_s(I)), f_t(I))],源编码器冻结、读出网络小、数据少。代码在 config_prototype.py 里: cfg['train_representations_file'] = '.../{task}_val_representations.pkl' cfg['representation_dim'] = 1024 cfg['model_type'] = architectures.TransferNet cfg['encoder'] = encoder_multilayers_fc_bn_res_no_dropout cfg['encoder_kwargs'] = { ..., 'layer_num': 3 } cfg['num_epochs'] = 4 源任务的表示是预先抽好的 pkl 文件——源编码器连显存都不进,冻结彻底到「不在场」;读出网络是三层带 BatchNorm 的全连接,训练只跑 4 个 epoch,学习率在第 2500 步砍成十分之一。对应关系逐条对上:式 (1) 的 E_s(I) 是那份 pkl,D_θ 是这个三层读出,L_t 从目标任务的配置里继承。 第二处对读:论文第 4 节「全任务同构」——编码器全任务统一为全卷积 ResNet-50 无池化、hidden 1024,像素任务解码器十五层全卷积。任务网络怎么长出来,看 encoder_decoder.py 的 StandardED,它按配置把 encoder 函数和 decoder 函数组装起来;具体一例是 taskbank 里法线任务 rgb2sfnorm 的配置: cfg['model_type'] = architectures.EncoderDecoderWithCGAN cfg['encoder'] = resnet_encoder_fully_convolutional_16x16x8 cfg['hidden_size'] = 1024 cfg['decoder'] = decoder_fc_15_layer_256_resolution_fully_convolutional_16x16x4 cfg['num_epochs'] = 30 编码器函数名里的 fully_convolutional 对应论文「无池化」,hidden_size 1024 对应表示维度,decoder 名字里的 15_layer 对应论文「十五层全卷积解码器」。任务损失在 code/lib/losses/all.py 里按任务换件:带掩码的 L1、L2、余弦距离、稀疏 softmax,掩码权重那一套正是深度和雾深这类有天空遮挡的任务要的。 区分一下默认行为与实验选择:TransferNet 的 docstring 写明「the decoder is frozen」——默认把目标任务自己的解码器从检查点恢复进来当只读件,损失经它回传,只更新 transfer 域的权重;要解锁得显式开 finetune_decoder。这是个实验开关,不是默认路径。 数据:四百万张室内图,来自约六百栋建筑的三维扫描,图像与网格对齐后程序化生成大多数任务的真值,场景类别这类需要语义标签的用知识蒸馏生成,论文附录给了人工核验,蒸馏错误率低于 7%。主文实验用稳定后的子集:训练 120k、验证 16k、测试 17k,按建筑不相交切分。 迁移函数在验证集的 1k 到 16k 子集上训练,主文口径是 16k;测试集只做评估。高阶迁移用束搜索采样:阶数不超过 5 时,每个目标取一阶表现最好的 5 个源的所有 k 阶组合;阶数超过 5 束宽收到 1。传递性迁移做过专门实验,结论是 s→t1→t2 与直接 s→t2 几乎打平,搜索深度不必超过一层——这条省掉了图搜索的一大块。 规模账:二十六个任务网络,一阶迁移 22×25 个,各阶合计约三千个迁移函数,总训练开销 47,886 GPU 时。框架是 TensorFlow 0.12。最影响可比性的三个条件:全任务同构的超参、按建筑切分的数据划分、16k 迁移监督口径——三者共同保证亲和度差异来自任务本身。 数字全部出自论文表格和图,我没有跑。 任务网络的健全性(表 1,对随机高斯网络表示读出与统计基线的胜率):自编码 100,法线 99.4,2D 特征点 99.8,深度 92.3,均值 92.4——网络没训坏,这是后面一切的地基。深度任务对照已发布模型的专项对比里胜率 88%,损失 0.35 对 0.47。 迁移结构的收益(图 9、图 10):对十个榜外新任务做「全员迁一个」的实验,taxonomy 推荐的迁移策略对自监督方法、ImageNet FC7 特征和从头训练全面占优——深度胜率 88,法线 97,语义分割 78;对全监督金标准多数任务落到四成上下的胜率段,接近但没追平。ImageNet 特征被针对性策略明显超过,是论文里最硬的一条结论。 结构的显著性(图 11):同样的预算下,taxonomy 连接方式对大量随机可行连接的胜率差拉得很开——不是「随便迁点什么都行」。 跨数据集(图 12):把迁移排行搬到 MIT Places 和 ImageNet 上微调验证,Spearman 相关系数分别 0.857 和 0.823,结构跟着数据集走时不散架。稳定性实验把任务网络和迁移网络的架构、数据量各放大四倍到十六倍,输出结构几乎不动。 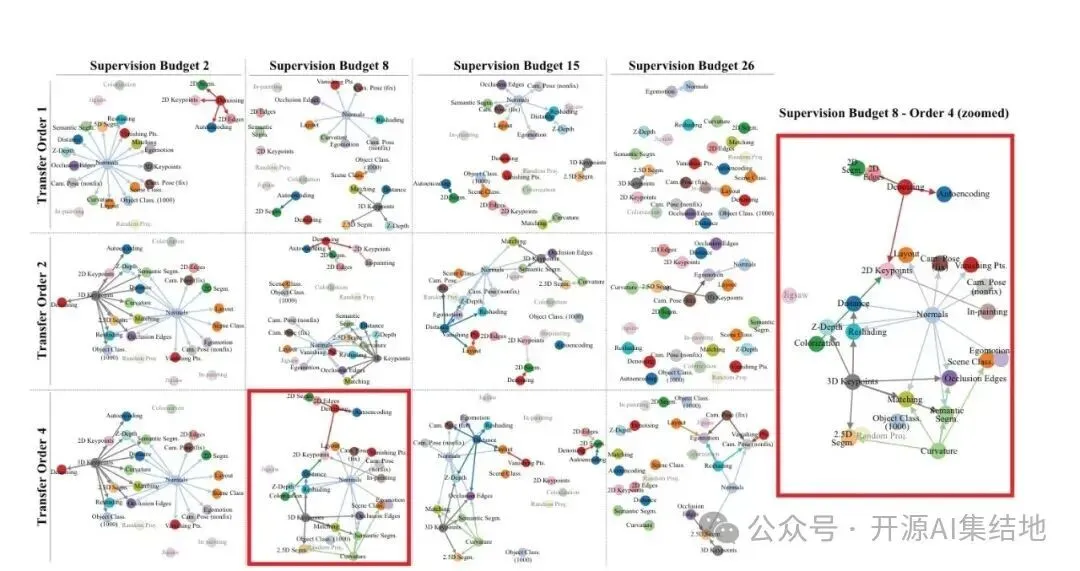
摘要里「省三分之二标注」的账要按它的口径念:这是按 taxonomy 的迁移策略解十个任务、对照各任务独立全监督的总标注需求,性能保持几乎同水平。它不是任何单一任务的提升幅度,别拆开引用。 对得上的:迁移函数的冻结与小容量、任务网络的同构架构、损失库的按任务换件,前两节已经逐条对读。 有一处口径差别值得写明。论文图 4 把迁移函数画成「表示直接读出到目标标签」;代码里 TransferNet 的实现是读出网络先把源表示映到目标任务的表示空间,再过目标任务那个从检查点恢复来的冻结解码器算损失——docstring 的原话是损失经目标解码器回传、只改 transfer 侧权重。两者数学上可以视为同一件事的两种参数化(解码器定义了损失),但严格复现时要按代码口径来,别按图 4 想当然。 属于发布口径的:taskbank 下的 final 配置 README 自述比论文版本略有改进,比如法线任务加了 GAN 项;code/README 提到 notebooks/analysis 目录里有 BIP 求解器的早期实现,但 notebooks 没有随库发布,results/ 目录里放的是各口径的亲和度和胜率 pkl 数据,在线交互求解器得去项目网站用。这些是档案化发布的选择,不是缺陷。 想看模型出图,用 taskbank:仓库根目录 README 给了预训练模型(PyTorch 版)的下载脚本,二十六个任务的检查点都能拿到,对室内照片各跑一个任务出预测图就是成功标志。 想复现训练要认清现实:代码是 TensorFlow 0.12 的 2017 年栈,README 明说不再维护,现代环境原样装起来的成本很高。现实路线是拿配置和论文附录当规格书,在现代框架里重写任务网络和迁移函数——数据集有公开下载渠道,规格是全的。 一个容易看错的地方在 config_prototype.py 中段:有一段注释直接写着 kludge,把 train_filenames 换成 val_filenames、val 换成 test。这不是 bug——迁移函数本来就是在 16k 验证子上训练、测试子上评估,跟惯性里「训练集训练」的划分是反的。第一次读很容易以为仓库改错了。 有证据的价值有三条。任务关系从手感问题变成可复算的量,后面这一支研究——同一批人做的 omnidata 数据集、后续各种任务转移工作——都以它为起点;AHP 锦标赛归一化给了跨量纲比较一个只依赖单调性的干净解法;带预算约束的整数规划把「标注怎么花」变成了一个能查表的决策问题。 限制论文自己认领了大半:结果是模型类和数据相关的,只对二十六任务的采样字典成立,室内场景意味着结构未必外推到室外和机器人视角,二十六个任务是对稠密任务空间的采样而非全集。再加一条我的观察:三千个迁移函数、近五万 GPU 时的成本,决定了这套方法更多是个「做一次、大家用」的基础设施——项目网站至今挂着交互式求解器,就是让后来的人不必重跑图。 放回 2018 年看,它回答的其实是每个做视觉的人都要面对的问题:标注预算有限时先标什么、先学什么。这个问题今天换成了「预训练模型怎么选、微调数据怎么配」,问题的形状没变过,这大概是它至今仍被引用的原因。
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看