ARTICLE · 1249156
问 AI 同一个问题两遍,它给了两个答案.
一篇文章,三百二十四个字。
里面有二十个「之」。
没有两个,写得一样。
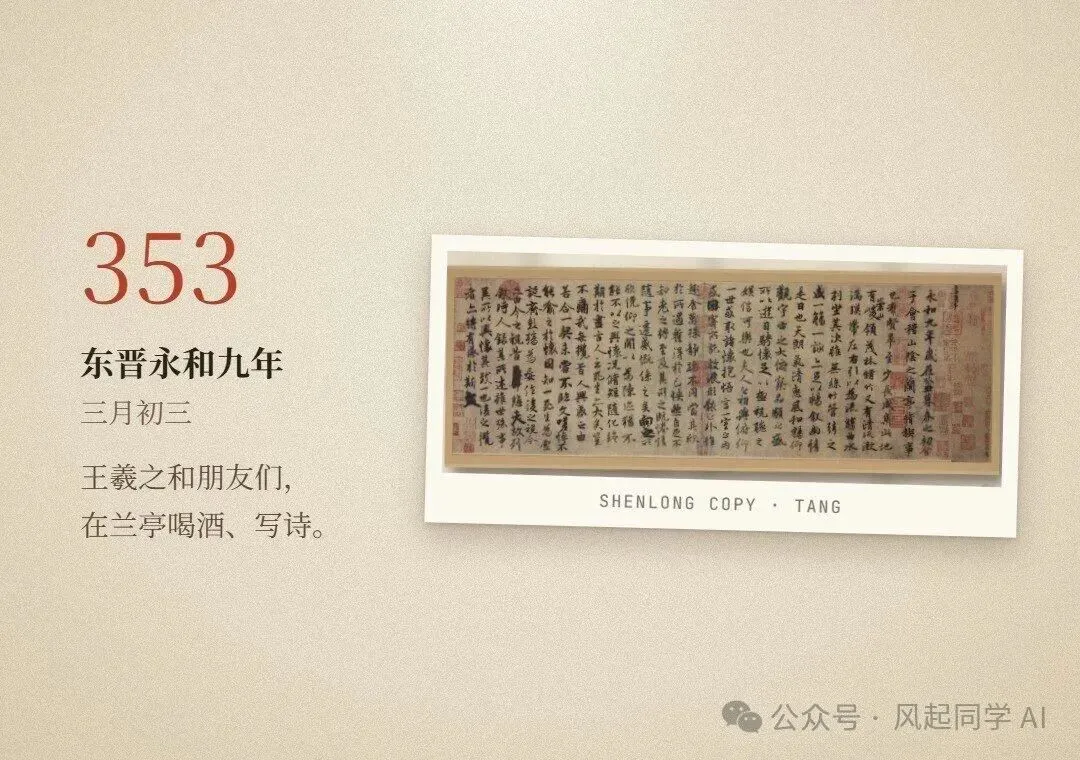
《兰亭序》神龙本,唐人摹本。
写它的人是王羲之。写它的那天,他喝了酒。
01
兰亭那天:同一个字,写了二十遍
东晋永和九年,公元 353 年,三月初三。
三月三是上巳节。古人这天要到水边洗一洗,叫「修禊」,冲走一年的晦气。王羲之约了一帮朋友,谢安、孙绰都在,四十来人聚到会稽山阴的兰亭。
他们玩的是曲水流觞。酒杯放进弯弯曲曲的小溪,顺水往下漂,停在谁面前,谁就喝酒、作诗。那天二十六个人写了三十七首诗,后来编成《兰亭诗》。
诗集要一篇序。王羲之趁着酒兴,提笔写了。
这就是后来被叫作「天下第一行书」的《兰亭序》。二十八行,三百二十四个字,「之」字出现了二十次。
唐朝的何延之写过一篇《兰亭记》,专门讲这卷字的来历。说到那天,他用了八个字:
揮毫製序,興樂而書。
挥笔写序,乐在兴头上。他连纸笔都记下了:蚕茧纸,鼠须笔。又说,序里凡是重复的字,都换了写法:
字有重者,皆搆別體。
是有意换着写,还是酒意里手自己在走,他没说。
重复最多的就是「之」,他数的是「二十许个」。说到这些「之」,他写:
變轉悉異,遂無同者。
变来变去,全不一样,到头来没有一个相同的。
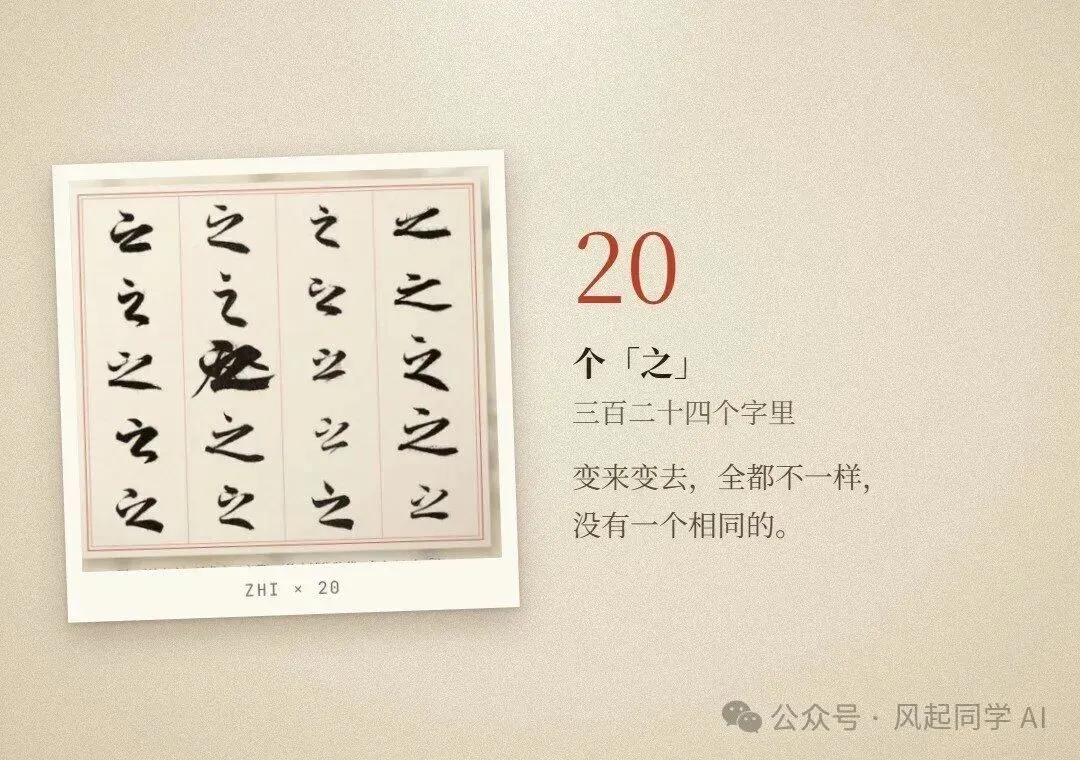
二十个「之」,二十个样子。
练过字的人都知道这有多难。同一个字连写二十遍,正常人会越写越像。手有惯性,脑子也会偷懒:刚才那样挺好,照着来。
可兰亭那天的「之」,有的收,有的放,有的轻轻一点,有的拖出长长一笔。像是每一次落笔,都是临时起意。
为什么一个都不重样?何延之给过一个说法,我们后面讲。眼下只知道,那天他喝了酒;何延之后面还提了一句「醒后」,说明写的时候,酒还没醒。
那天,他的手比脑子快。
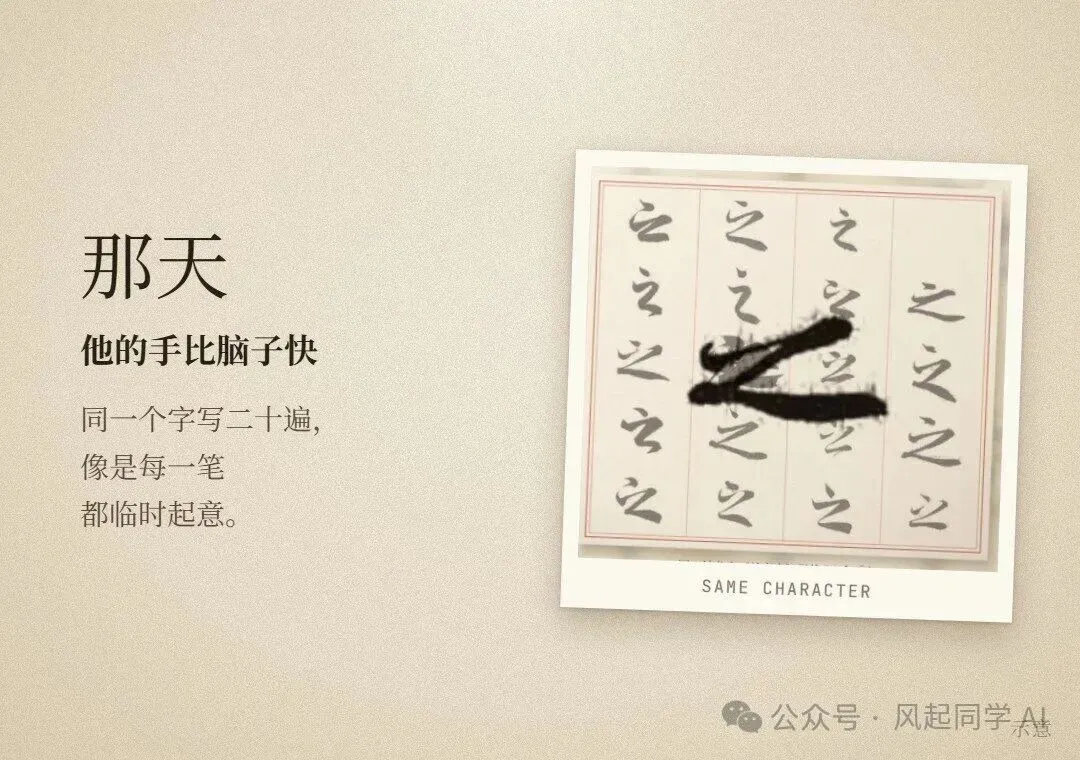
同一个字,写二十遍(示意)。
02
同一个问题问两遍:它坏了吗?
一千六百多年后,换一个人,换一件事。
你打开 AI 聊天助手,问它:周末去哪儿玩?
它说:去爬山吧。
你随手点了「重新生成」。同一个问题,一字没改,它这回说:去看海吧。
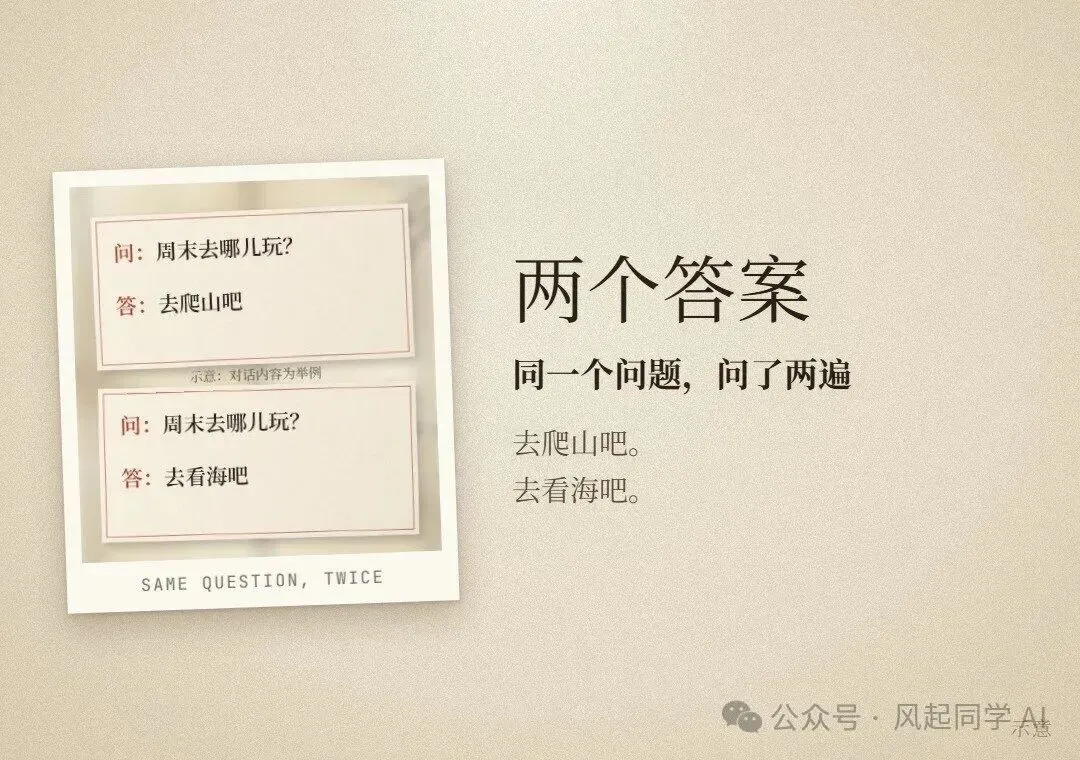
同一个问题,问了两遍。
不少人第一次碰到,心里会犯嘀咕:机器不就该一个输入、一个输出吗?计算器算一加一,算一万次都是二。它怎么问两遍,给两样?
它坏了吗?
没坏。它只是,也喝了一点。
这份「醉意」是做 AI 的人故意留进去的,不是故障。而且它有多醉,有个旋钮能调。要讲清这个旋钮,得先看 AI 是怎么一个词一个词往下写的。
03
碗里的纸团:每个词都是抓出来的
不管是哪家的聊天 AI,写回答的办法都差不多:一个词一个词往下接。前面写了什么,决定了它下一个最可能接什么。
关键在「最可能」三个字。它每接一个词,心里都不只一个答案,而是一张比重表。
比如写到「周末我们去」,下一个词接什么?假设它心里的比重是这样(数字是为讲清楚编的):
把这张表换成一只碗,就好懂了:碗里放十个纸团,五个写着最稳妥的「爬山」,三个写「吃饭」,两个写冷门的「看海」。
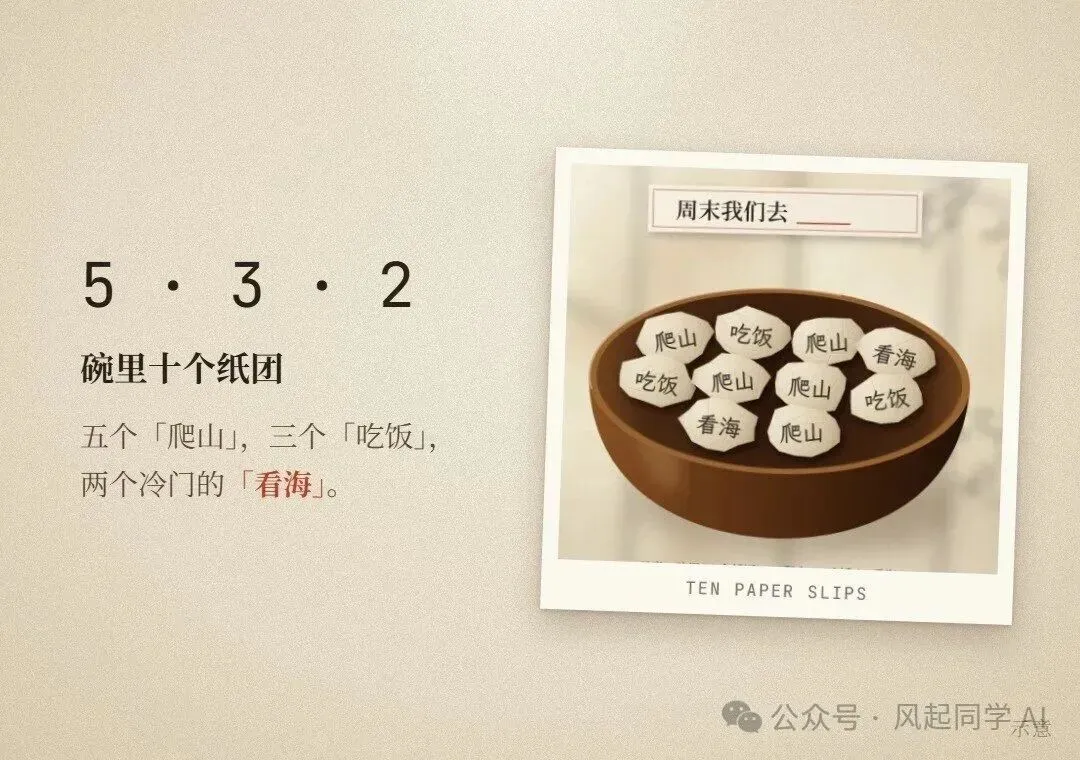
碗里十个纸团:五个「爬山」,三个「吃饭」,两个「看海」(示意)。
然后,AI 闭着眼,抓一个。
抓到哪个,就写哪个。写完,再看下一张比重表,再摆一碗纸团,再抓。你看到的一整段回答,就是这样一个纸团一个纸团抓出来的。
有一点要说准:比重是一步步算出来的,丝毫不差;只是到了「选哪个」那一下,它不总挑最大的,而是按比重抓阄。
比重是算出来的,选哪个,是抓出来的。
开头那件事也就不奇怪了。你再问一遍,就是让它再抓一遍。五成机会抓到「爬山」,也有两成机会抓到「看海」。两次不一样,再正常不过。
04
第一个纸团:整句话就拐了弯
抓阄还有一个后果,比「换了个词」大得多。
它每写一个词,都要把前面写下的所有词,当成接下来的条件。第一次抓到「爬山」,它就顺着写:「周末我们去爬山,早点出发吧」。第二次抓到「看海」,后面每一张比重表都跟着换了:它已经站在海边这条路上,接下来更可能写「听说那边的日落很好看」。
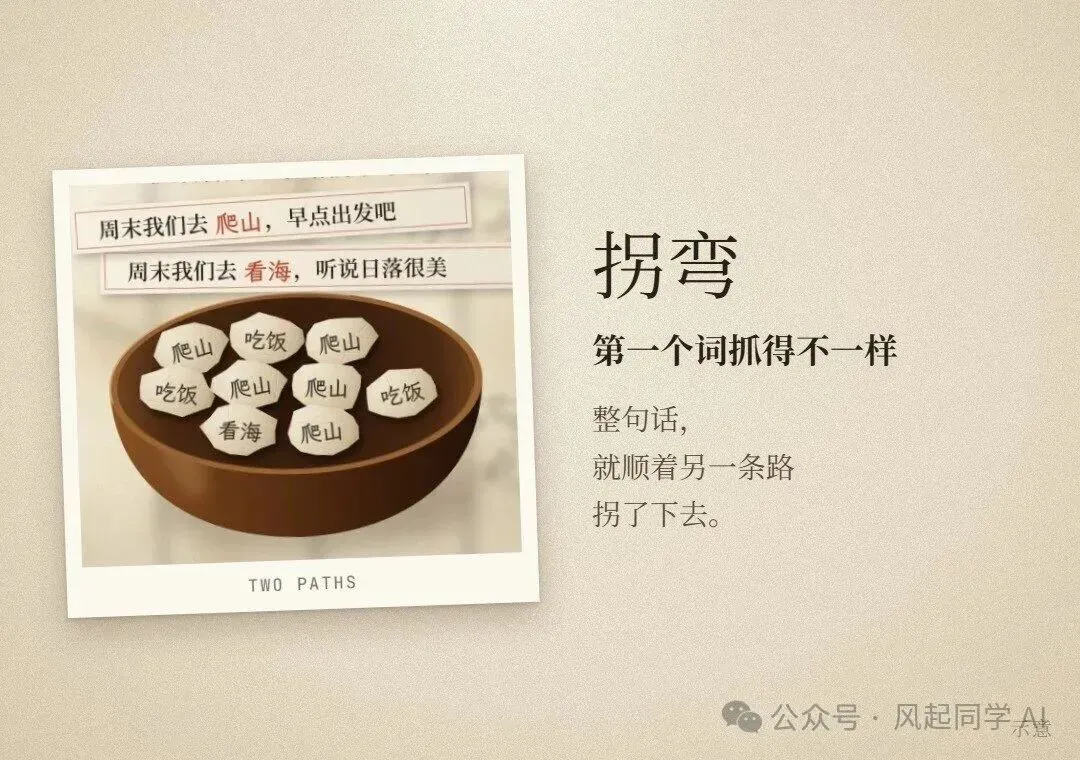
第一个词抓得不一样,整句话就顺着另一条路拐了下去。
第一个岔路口走了不同方向,越往后,两条路离得越远。所以你看到的两个回答,常常不是换了几个字,而是思路、顺序,甚至结论都不一样。
「重新生成」一次,有时好很多,有时差很多,道理也在这儿。它并没有突然变聪明,只是在前几个岔路口,走了另一条路。
你看到的那个回答,只是很多可能的回答里,抓出来的一个。
05
温度:给醉意装一个旋钮
这几分醉意,不是固定的。做 AI 的人给它装了一个旋钮,叫「温度」。
温度做的事,是在抓阄前,先把碗里的纸团重新摆一遍:
- 调低:热门的更热门,冷门的更冷门,它越来越爱抓最稳妥的那个。
- 调到零:碗里只剩最稳妥的「爬山」,每一步都挑比重最大的词。
- 调高:纸团摆得更平,冷门的相对多了,它就敢去摸那个「看海」。
拿前面那只碗,按温度的算法实打实算一遍:
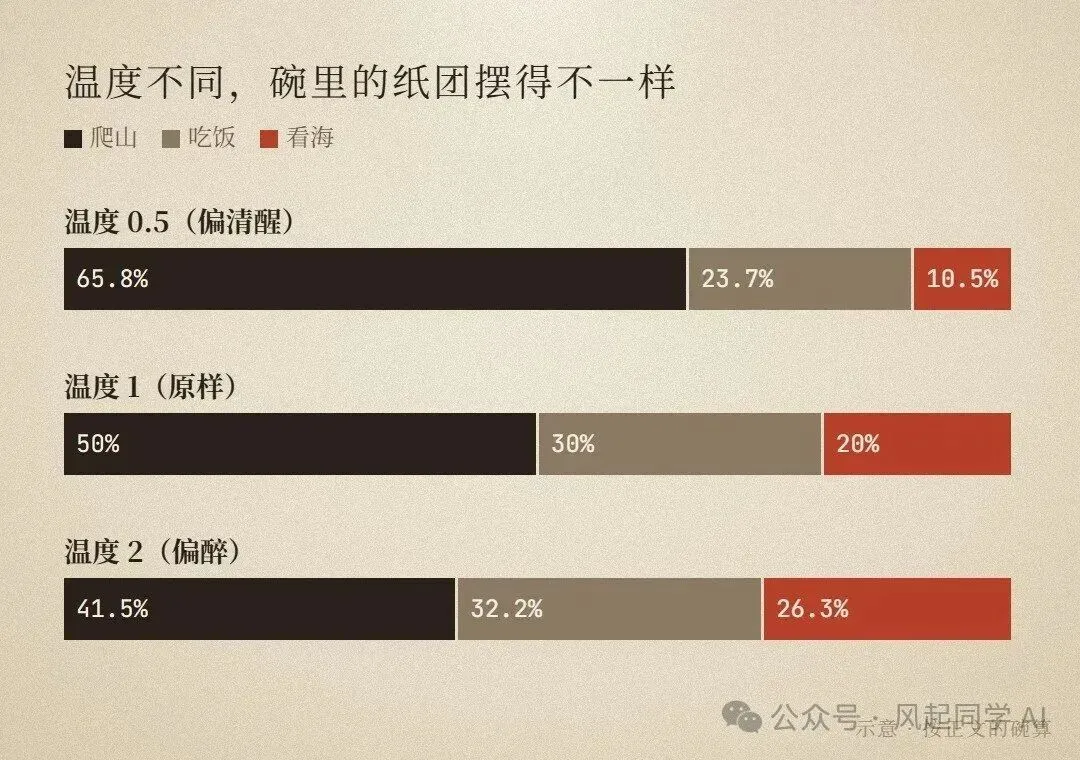
同一碗纸团,温度不同,三个词被抓到的机会(示意)。
温度从 1 降到 0.5,「看海」从两成掉到一成;从 1 升到 2,涨到两成六。温度越高,三个词越接近「各占三分之一」。
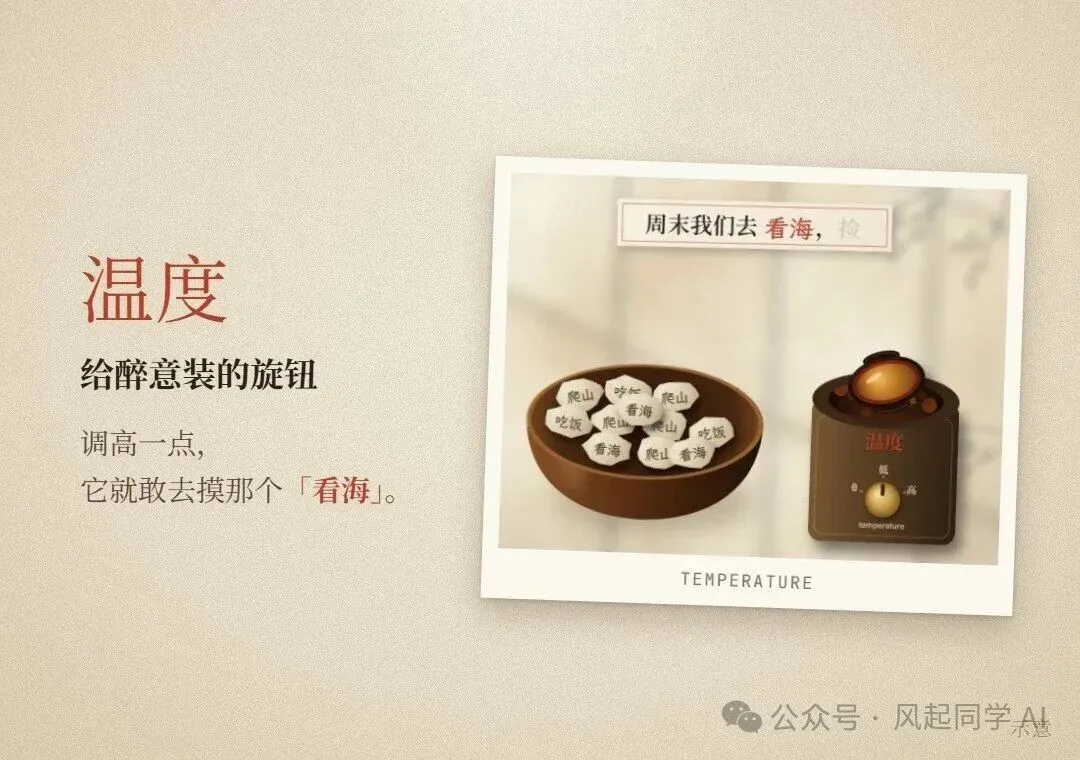
温度调高一点,它就敢去摸那个「看海」。
这就是微醺的好处:冷不丁,冒出几句新鲜的说法。
可三个纸团,怎么抓也乱不到哪儿去。为什么说温度调太高,写出来的话就像喝大了?
问题出在碗太小。
06
喝大了:一千个冷门纸团
王羲之那天是在兴头上,不是烂醉。AI 也一样,醉过了头,就不是神来之笔了。
真实的 AI,碗里不是三个纸团。它认得的词有好几万个,每写一步,这几万个词全在碗里。放在「周末我们去」后面,绝大多数都是胡话:「螺丝」「昨天」「的」「月亮」。每一个的机会都小得可以不计,可架不住多。
把碗换得真一点(数字依然是编的):三个正经词占九成,爬山 45%、吃饭 27%、看海 18%;另外放一千个乱词,每个占万分之一,合起来占一成。再拧一遍温度(温度 0.5 时乱词几乎抓不着,三个正经词的比例和前面一样):
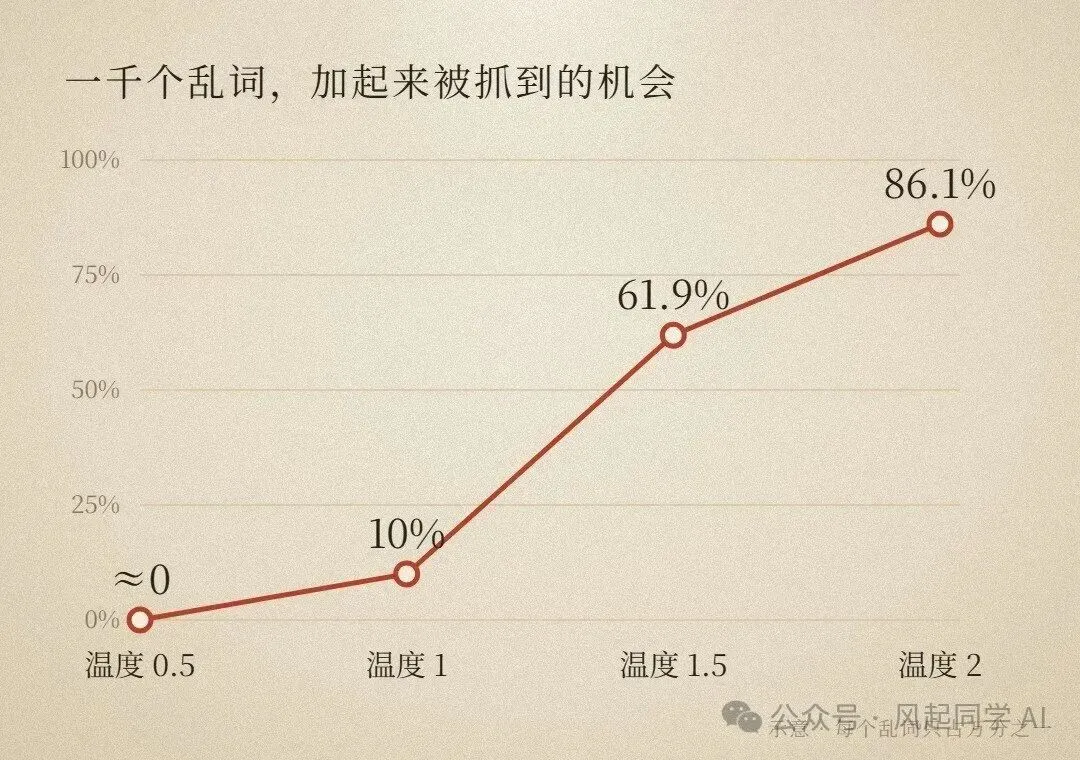
温度越高,一千个乱词加起来被抓到的机会越大(示意)。
温度到 1.5,乱词合起来已经过半;到 2,超过八成。每个乱词单看还是冷门,一千个凑一起,就把正经词挤到了角落。
而且这是每一步都要抓的。一句话二十个词,每步都大概率抓到乱词,再加上「一个词拐弯,整句跟着拐」,写出来就是这样:
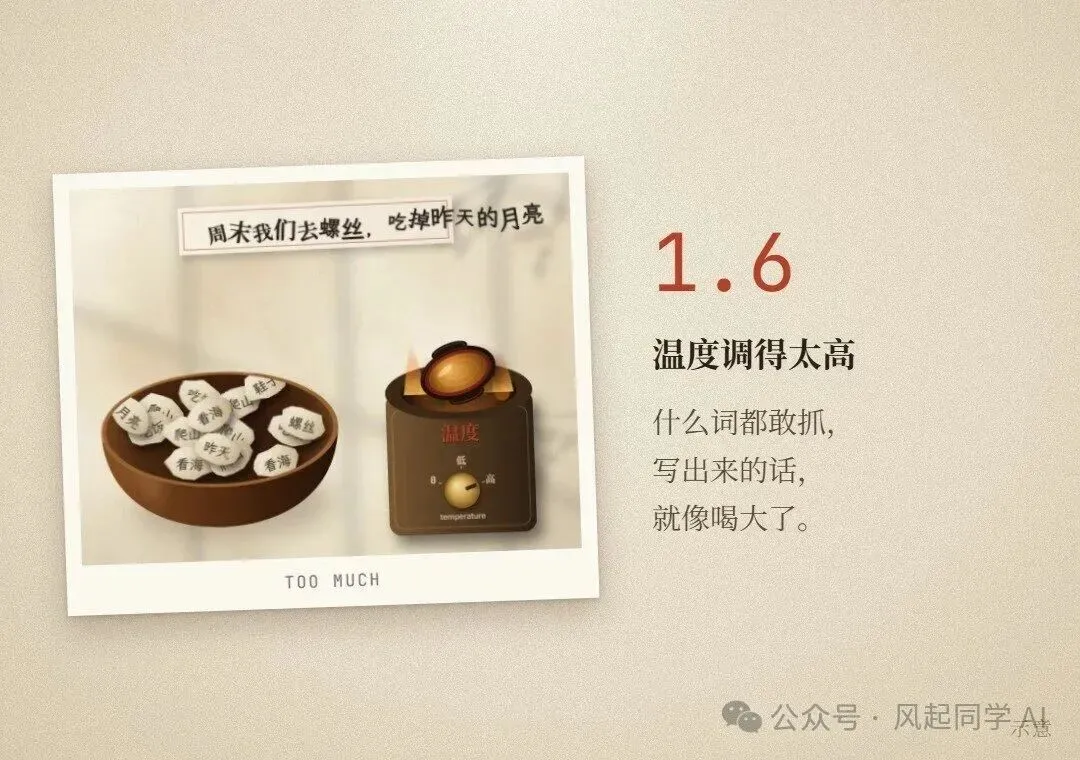
什么词都敢抓,写出来的话就像喝大了。
这不是某一个词错了,是整段话前言不搭后语。2019 年,华盛顿大学的霍尔茨曼等人专门发论文讲过这事:直接按原本的比重去抓,写出来的东西跟上文几乎不沾边。他们管碗底那一长串叫「不可靠的长尾」:几万个不起眼的词,加在一起,分量就大了。
2024 年另一项研究,把温度从 0 往上调,看 AI 做题的表现。过了 1,答对率很快往下掉;调到 1.6,已经语无伦次,答对率几乎为零。
所以很多 AI 产品会多加一道筛子:抓之前,先把碗底那一长串冷门纸团倒掉,只在排前面的那一小撮里抓。乱词进不了碗,也就抓不着。
07
彻底清醒:平,而且也不是每次都一样
既然醉了会乱,那把温度拧到零,彻底清醒,是不是最好?
也不是。毛病刚好反过来。
每一步都挑最稳妥的词,写出来的就是最稳妥的句子:不出错,也没惊喜。还是霍尔茨曼那篇论文,他们发现一直挑最可能的词,写出来的东西:
bland and strangely repetitive.
平淡,而且重复得奇怪。
他们还拿人写的文字比了比。同样的上文,人接下去的词,平均比重比 AI 只挑最大时选的词低不少。人说话,很少一直待在最稳妥的地方,总会拐进比重没那么高、却更有意思的词。每步都挑最大的,反而不像人话。
还有一件更意外的事:温度调到零,也不等于每次都一模一样。
照理说,每步都挑最大的,结果应该是定死的。可真用起来,常常还会变。2023 年一项研究让 ChatGPT 做了 829 道编程题,每题问 5 遍,看 5 份程序跑出来的结果对不对得上。默认设置下,三个题库里,5 份结果全对不上的题分别占了 76%、51%、48%。把温度调到零,降到了 44%、27%、18%。少了很多,可还是有。
为什么?去年 9 月,一家叫 Thinking Machines 的 AI 公司专门研究过。他们把温度设成零,用同一句「讲讲理查德·费曼」,问了一个大模型 1000 遍。
结果,1000 个回答里,有 80 种不一样的。从头到尾一字不差、最常见的那一段,也只出现了 78 次。
更有意思的是第一次分岔的地方。开头一大段,一千个回答一模一样;写到费曼出生在哪儿,992 次写「纽约皇后区」,8 次写「纽约市」。后面分出来的岔就更多了。两个说法的比重本来就挨得很近,一丁点扰动,就够让「最大的那个」换人。换了一个词,后面就整段跟着拐。
那一丁点扰动,不是谁故意加的随机,而是服务器在「拼车」。为了快,服务器会把很多人的提问拼成一车算。车里人数时时在变,底层的加法顺序就跟着变;而电脑算小数加法,顺序一换,末尾几位就可能不同。他们后来改了底层算法,让结果不跟着人数变,1000 遍就一字不差了。代价是算得慢了一些。
所以,彻底清醒的 AI,也只能说「几乎」每次都一样。
08
酒醒以后:几十遍,没有一遍赢过那天
说到清醒,王羲之也有酒醒的时候。
何延之在《兰亭记》里,还写了后来的事:
及醒後,他日更書數十百本,無如祓禊所書之者。
酒醒后,王羲之又写了几十上百遍,没有一本比得上修禊那天。有的书里引这段,写的是「数百千本」。我们取少的那个说法:几十遍。
还得加个「据说」。何延之是唐朝人,离兰亭那天已隔了三百多年,这些细节,只能当唐人的讲法来听。
据说,王羲之酒醒以后,把《兰亭序》重写了几十遍。
开头留下的那个问题,何延之自己给了个解释,四个字:其时乃有神助。那天是有神帮了忙。
醒着为什么写不出来,何延之没说,我们也不替古人编理由。只看结果:
一遍,都没赢过那天的自己。
还有一件事,很多人不知道:今天你在字帖上、博物馆里看到的《兰亭序》,都不是王羲之亲手写的那一卷。
据说唐太宗爱极了这卷字,打听到它在辩才和尚手里,三次召他进宫,辩才都说早丢了。太宗就派萧翼去。萧翼扮成过路书生,跟辩才下棋、弹琴、喝酒,混熟了,辩才才从房梁上取下《兰亭》给他看。萧翼故意说字是假的,辩才便不再藏回梁上。一天辩才出门,萧翼谎称有东西落在房里,哄小和尚开门,拿上《兰亭》就走了。
太宗让人照着临摹了好几本,分给大臣。临死前,他又跟儿子要了这一样东西,把真迹带进了陵墓。今天最有名的「神龙本」,是唐人照着真迹双钩填墨摹出来的,藏在北京故宫博物院。
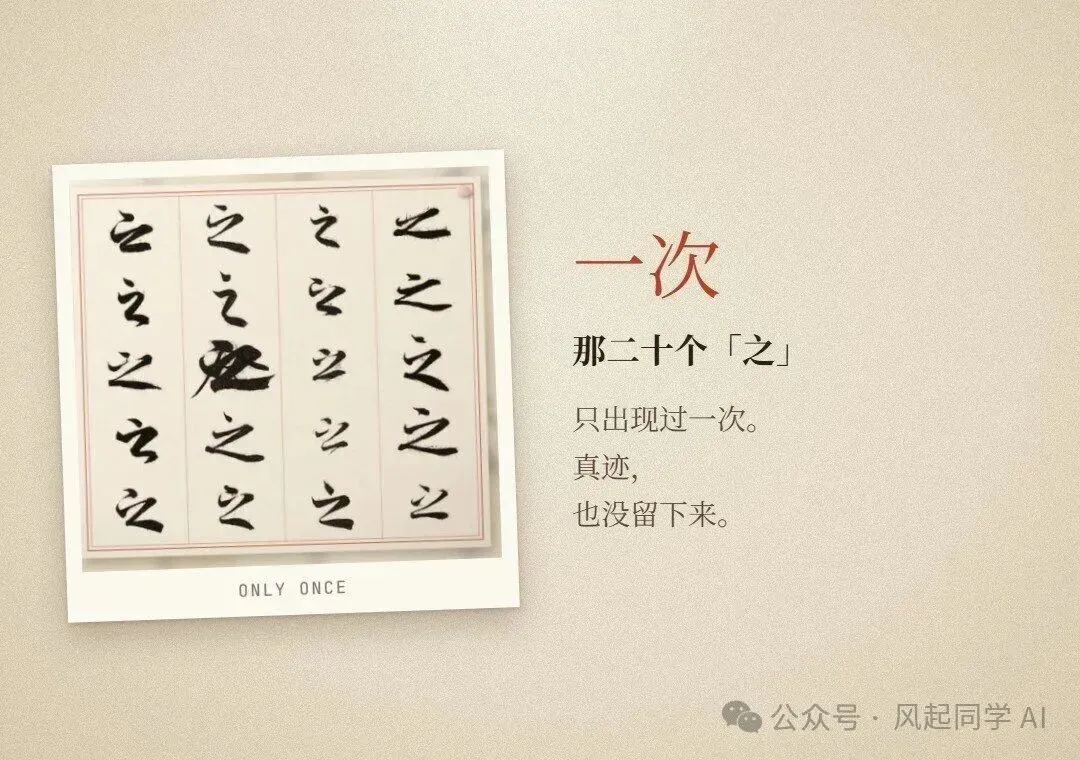
那二十个「之」,只出现过一次。
所以严格说,那二十个「之」,我们见到的也只是影子。真正写下它们的那一次,连原件都没留下。
09
稳和新:同一个旋钮的两头
那一回写成的样子,后来再没有第二回。放到 AI 身上,稳和新,是同一个旋钮的两头。
你要它稳,比如写代码、算账、从文件里抄数字,就希望它别乱抓,每次都差不多。
你要它新,比如起名字、想标题、写故事、出点子,就得让它偶尔摸到冷门的纸团。那些让人眼前一亮的句子,常常就是在比重不高的地方抓出来的。
有意思的是,温度对「做对题」的影响,可能比你想的小。前面那项 2024 年的研究,让 9 个常见大模型做选择题,温度从 0 调到 1.6。过了 1 会乱,可在 0 到 1 之间怎么变,答对率没有明显差别。也就是说,对有标准答案的题,一点醉意不会让它变笨;温度真正改变的,是说法有多少花样。
合在一起,大致可以这样用(经验值,各家模型手感不一样):
好东西,往往藏在一点点不确定的意外里。
10
知道它在抓阄之后,怎么用它
落到每天用 AI 这件事上,有四条:
1. 第一个回答,别急着收。
它只是很多可能的回答里,抓出来的一个,不代表它的最好水平。
2. 太平,就让它重来一遍。
大多数聊天软件不让你直接调温度,可「重新生成」按钮,就是让它再抓一次阄。起标题、想点子这类事,多点几次,挑最好的那个。
3. 抓出了神来之笔,先存下来。
再抓一次,未必还有。这一点,王羲之已经替你试过了。
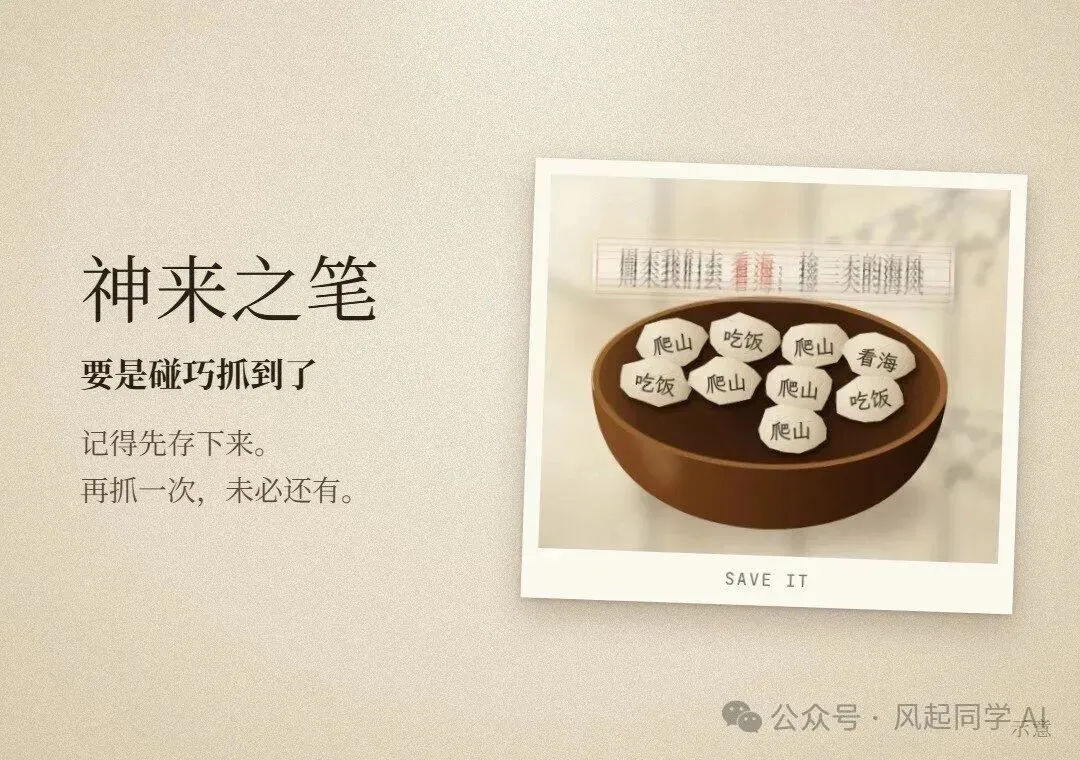
要是碰巧抓出了神来之笔,记得先存下来。
4. 要紧的事,多问几遍对照。
几次回答结论一样,心里可以踏实一点;每次说得都不一样,就要留个心眼,自己去查一查。
这个办法有研究撑着。2022 年,谷歌的研究者让大模型做小学数学应用题,同一道题多想几遍,取出现最多的答案,答对率比只想一遍高了 17.9 个百分点。
一千六百多年前那天,要是有人在旁边劝王羲之:先醒醒酒,想清楚了再写。
还好,那天没人劝他。
那二十个「之」,只出现过一次;
AI 给你的那一句,也是。
这张卡片上写的,是一句假话。
下期预告
AI 说得最有把握的时候,也可能是在一本正经地瞎编。