ARTICLE · 1257797
HBM6:重构AI算力底座的下一代超级内存
在人工智能算力竞赛进入白热化的今天,制约大模型训练与推理效率的不再只是GPU算力,而是长期被忽视的“存储墙”瓶颈。传统内存带宽不足、延迟偏高、吞吐量有限的问题,让顶级GPU时常陷入“等数据计算”的困境。作为高带宽内存(HBM)技术的第六代迭代产品,HBM6瞄准生成式AI大规模推理、超算集群、实时智能渲染等高端场景,以架构革新、带宽跃升、能效优化为核心,成为2032年前后AI基础设施的核心支撑,彻底改写高性能存储的技术格局。
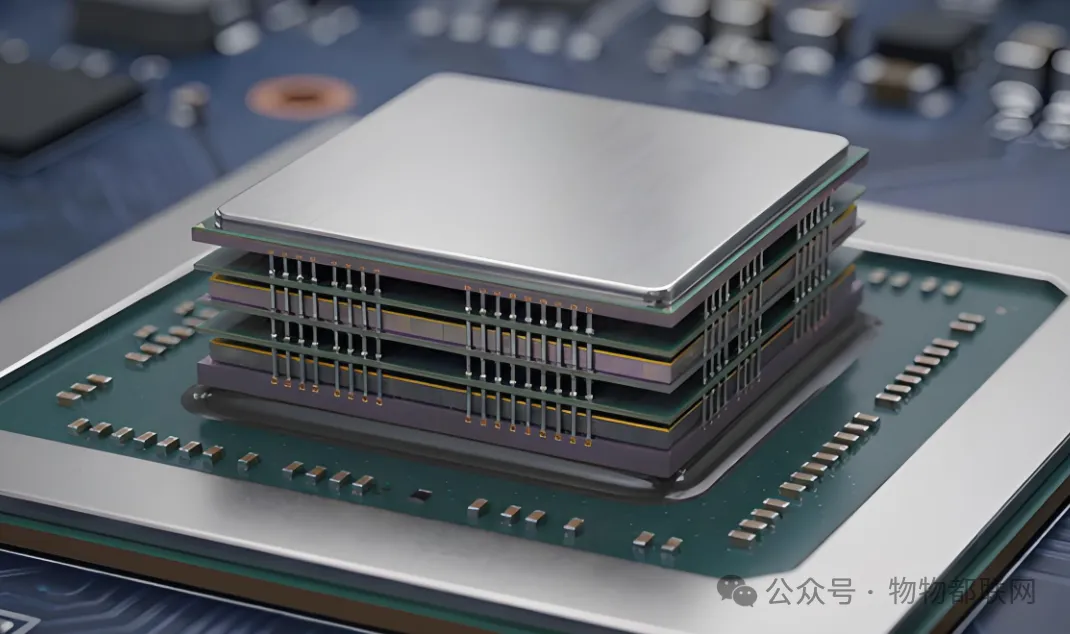
HBM是专为高性能计算、人工智能场景打造的3D堆叠DRAM技术,通过垂直堆叠芯片与硅通孔(TSV)互连技术,摆脱了传统DDR内存的平面传输局限。历经HBM3E、HBM4、HBM5的迭代,HBM6不再是单纯的参数升级,而是从单塔堆叠向多塔异构架构的跨越式变革,是适配通用人工智能(AGI)落地的关键存储技术。
一、核心参数全面跃升,突破性能天花板
依托韩国KAIST TERALAB发布的权威HBM技术路线图,HBM6的核心硬件参数实现代际翻倍升级,各项指标精准适配超大模型算力需求,相较于前代产品形成全方位碾压优势:
在传输速率上,HBM6单通道数据速率达到16Gbps,较HBM5实现翻倍提升,相当于为数据传输的“单车道”全面提速;峰值带宽突破8TB/s,是HBM5的2倍,每秒可传输海量高清影像数据,足以支撑万亿参数大模型的瞬时数据读写需求。
容量与功耗层面,HBM6单模块存储容量提升至96-120GB,堆叠工艺进一步精进,在大幅扩容的同时严控体积,延续了HBM小型化、高密度的优势。模块额定功耗为120W,配合全新散热与架构优化,实现了“高性能不高耗”的平衡,适配大规模数据中心集群的部署需求。
接口能力上,HBM6延续并升级了高密I/O设计,搭载2048条高速中介层通道,保障多通道并行传输的稳定性,彻底解决海量数据并发传输的拥堵问题。
二、颠覆性架构革新,解锁全新存储能力
HBM6最大的技术突破,在于摒弃了传统单堆叠架构,首创Quad-Tower四塔异构架构,实现了内存结构的革命性升级。该架构在单个基础芯片(Base Die)上集成两组独立的DRAM堆叠核心,形成两座并行运行的“数据算力塔”,每座塔均配备独立的I/O传输通道,可独立处理数据读写任务。
这种并行架构带来的最直观提升是推理吞吐量的跨越式增长。实测数据显示,搭载HBM6运行LLaMA3-70B大模型推理任务时,系统吞吐量较HBM5提升126%,单秒处理用户请求数量近乎翻倍,同时数据传输延迟降低28%,完美适配AI客服、实时翻译、智能交互等高并发、低延迟场景。
在封装工艺上,HBM6创新性采用硅-玻璃混合中介层技术,攻克了传统纯硅中介层的面积受限、成本高昂难题。其中玻璃材质负责拓展封装面积,可支持最多8个HBM模块同步集成,大幅提升服务器算力密度;硅材质负责精密布线,保障高速数据传输的稳定性。该技术不仅让封装集成度大幅提升,还将整体制造成本降低20%,为规模化商用奠定基础。
针对大模型推理的核心痛点,HBM6专属集成L3高速缓存(L3E-HBM6),专门用于存储大模型运行所需的KV缓存(对话上下文、推理中间数据)。这一设计大幅减少了核心存储芯片的高频访问次数,降幅达73%,既有效降低数据读写延迟(延迟降低40%),又减少芯片损耗、延长设备使用寿命,精准适配生成式AI的持续运行需求。
三、专属散热方案,保障高负载稳定运行
随着性能大幅升级,HBM6的热密度同步提升,传统顶部散热方案已无法满足高负载运行需求。为此,HBM6搭载了全新的热通孔(Thermal TSV)浸没式散热系统。不同于传输数据的硅通孔,热通孔专为导热设计,可快速将堆叠芯片内部的集中热量传导至外部冷却液中。
配合全域浸没式冷却工艺,HBM6实现±3℃的高精度温度控制,彻底解决了高带宽、高并发场景下的芯片过热降频问题,保障AI数据中心、超算集群7×24小时不间断稳定运行,大幅提升高端算力设备的可靠性与续航能力。
四、核心应用场景,精准匹配未来算力需求
HBM6的技术定位精准锚定2030年后的AI产业发展趋势,核心服务于高并发推理、超大规模算力集群、实时沉浸式渲染三大高端场景:
一是生成式AI大规模推理集群。
随着AI应用普及,AI客服、智能文案生成、实时AI绘画、跨国语音翻译等场景迎来海量并发请求,HBM6的超高吞吐量与低延迟特性,可支撑十万级并发用户的实时交互需求,解决传统算力集群“排队卡顿、响应滞后”的痛点。
二是超级计算与科学算力场景。
在气象模拟、生物医药研发、量子计算辅助运算等高精度超算领域,HBM6的超大带宽与高密度存储能力,可快速支撑海量科研数据的迭代运算,大幅缩短科研计算周期。
三是元宇宙与实时沉浸式渲染。
元宇宙场景需要实时处理三维场景建模、高清画面渲染、动态交互数据,对内存带宽与实时性要求极高,HBM6可实现海量图形数据的瞬时传输与调用,保障沉浸式场景的流畅运行。
同时,随着边缘高端智能设备迭代,HBM6的轻量化、高性能特性,未来也有望落地高端AI PC、智能车载算力平台等设备,打通云端、边缘端的高性能存储壁垒。
五、产业价值与行业展望
当前全球HBM市场已进入高速增长期,预计2030年市场规模将突破980亿美元,占据全球DRAM市场半壁江山。HBM6作为面向2032年的下一代核心技术,不仅是简单的产品迭代,更是从“存储辅助算力”到“存储定义算力”的产业变革。
相较于前代产品,HBM6通过多塔异构架构、混合封装、缓存集成的三重创新,彻底破解了AI发展的“存储墙”瓶颈,为万亿参数通用大模型、大规模AI集群、沉浸式数字经济的落地提供了核心底座。在全球算力竞赛中,HBM6将成为高端AI服务器、超算设备的标配核心组件,重塑全球存储与算力产业的竞争格局。
从技术演进脉络来看,HBM6承接了HBM4、HBM5的3D堆叠与近内存计算优势,进一步完善了存算融合的技术体系,为后续HBM7、HBM8的全集成式算力存储技术奠定基础。未来,随着封装工艺持续优化、成本不断下探,HBM6将推动高性能AI基础设施从“高端定制”走向“规模化普及”,成为驱动人工智能产业持续进化的核心隐形基石。