ARTICLE · 1261996
1.3B打穿三榜:Agent的PDF噩梦,被「OXR」终结了?
你让Agent敲命令、改代码、跑测试,它干得挺利索。可你随手丢给它一份30页PDF,它立马露怯:表格糊成一团,公式变乱码,双栏论文左右串读,化学结构式被当成乱线条扔掉。你把这种结果喂进RAG,下游怎么调都救不回来。
Agent的工具箱越来越全,唯独“眼睛”这件事,一直在将就。
10月5日,SoMark团队开源了OXR(Optical Everything Recognition) 。
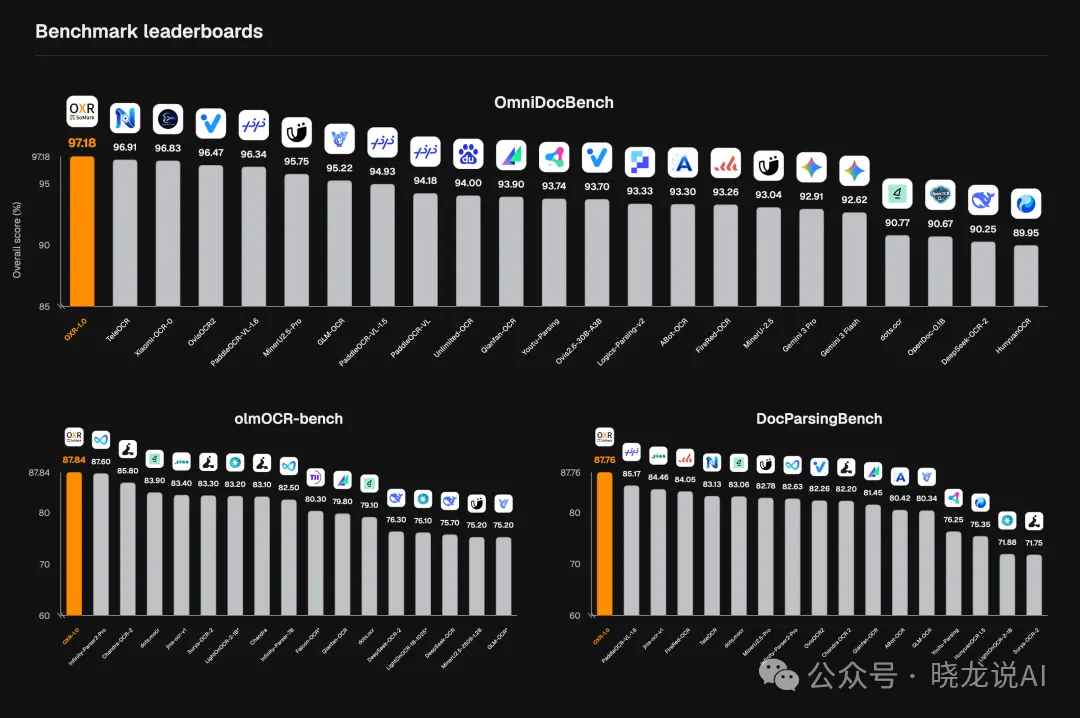
主模型仅1.3B参数,在OmniDocBench(97.18)、olmOCR-Bench(87.84)、DocParsingBench(87.76) 三项文档解析基准上全部第一;单张RTX PRO 6000上,100页文档端到端解析101.0秒;代码、权重、评测复现流程全量开源。
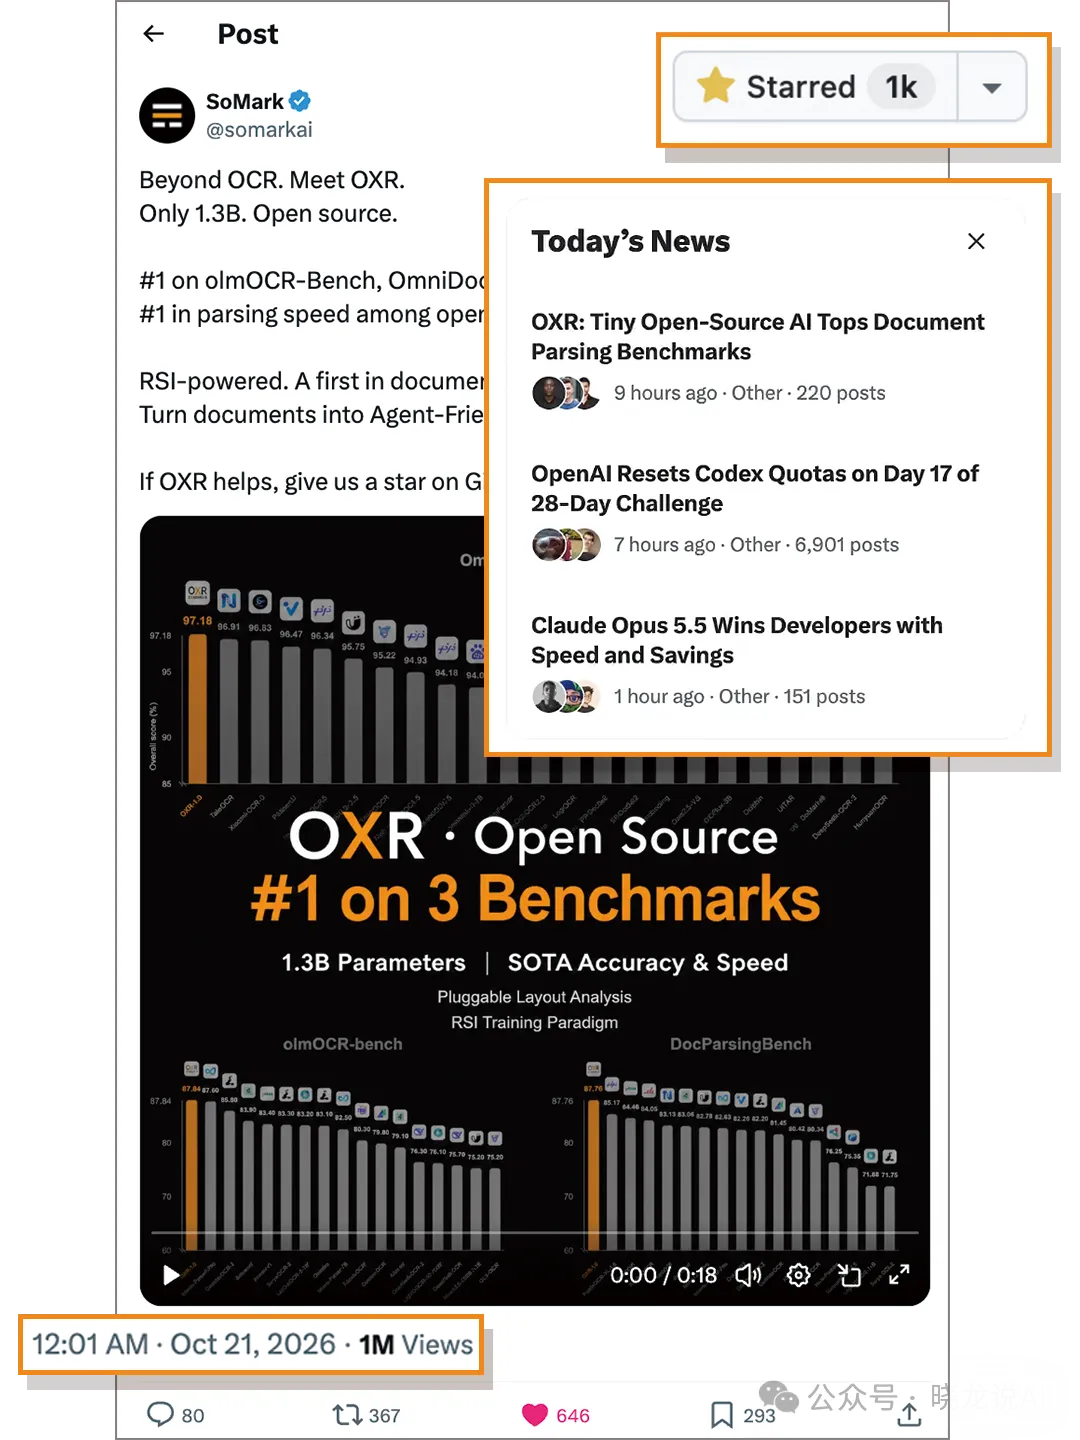
它要解决的问题只有一个:把PDF拆成Agent能直接吃的带坐标的Markdown/JSON,让“眼睛”不再是将就的那个零件。
1. Agent的最后一公里,卡在PDF上
“文档解析一直是个听着没技术含量、实际至今没被完全攻克的活。”
传统OCR面对真实文档基本是灾难现场:双栏论文阅读顺序串行,跨页大表格行列关系错位,手写公式识别成乱码,化学结构式在很多工具里直接被当作“非文本噪声”丢弃。
这些问题不是“识别率差几个点”,而是结构层面的信息在抽取阶段就丢失了。一份表格如果行列关系错位,数字就会对应到错误的项目;一篇论文如果左右栏串读,原文的论证关系在进入RAG之前就已经被破坏。
多模态大模型逐页“看”是一条出路,但价格和速度劝退。一页一页送进百亿参数模型,效果有了,成本也上去了。更关键的是,即使模型“看懂了”,它吐出的往往仍是自由文本,下游Agent拿不到内容在哪一页、哪个位置这种结构信号——想做问答引用、标原文出处、按版面切知识库,数据是不完整的。
劣质提取丢进RAG,模型再聪明,下游Tool Call也得全部歇菜。
2. 1.3B凭什么打过同量级竞品——答案是RSI
OXR的主模型只有1.3B参数。在它面前,PaddleOCR-VL-1.6约0.9B,MinerU2.5-Pro约1.2B——它不是靠“小”去越级打百亿通用模型,而是在专用文档解析这个有标准答案的任务上,用后训练把1.3B的潜力榨到了三榜第一。
核心手段是RSI(递归自我改进)后训练。官方称这是文档解析领域第一次用RSI做后训练。逻辑并不玄妙:文档解析有标准答案——文字对不对、表格跨行跨列有没有错、公式符号漏没漏,都能被精确测量。既然能测量,错误本身就可以变成训练信号。
三步循环:预测与分类 → 归因与训练规划 → 数据生成。
模型先对自己的输出打标:Correct、Wrong、Uncertain。
保留Uncertain是一个反直觉但关键的设计——它承认“不确定”不是噪声,而是一类需要被单独诊断的失败模式。
然后系统归因错误原因,聚类成“原因簇”,再针对每个原因簇生成新的训练数据,真实样本提供排版锚点。
整个过程不需要人工标注新数据,迭代速度比传统标注驱动的后训练快得多。
1.3B的精度,是这样一轮一轮“自己给自己出题”磨出来的。
3. 13类元素,每个都带坐标——这才是Agent要的“眼睛”
OXR的输出不是散字。它识别13类文档元素:表格、公式、代码块、图片、化学方程式、化学结构、脚注、页眉、页脚、印章等,每一类都带bounding box坐标,输出为结构化的Markdown或JSON。
格式是“下游可用”的关键:公式转LaTeX,表格转HTML,化学方程式用mhchem,化学结构用SMILES,代码块、图注、脚注、印章各归各位。
在DEV Community的实测示例中,JSON输出的每个block都携带bbox字段,例如"bbox": [75, 753, 606, 908],下游拿到的不只是“一段文字”,而是“这段文字在哪一页的哪个矩形区域里”。
这件事比看着炫有用得多。问答引用可以直接指向原文坐标;知识库切分可以按版面结构而非固定长度切;Agent做证据溯源时,不需要再靠“语义相似度”去猜来源。
带坐标的结构化输出,是把PDF从“只能读的文档”变成“可以操作的版面数据”。
4. 版面分析被拆成积木——最常被换的零件,做成标准接口
OXR的架构分两个模型:一个管版面分析(LA) ,一个管内容识别,并且把阅读顺序并进了识别模型——一个模型管两件事。
版面分析被做成独立、可插拔的模块。内置模型可以单独跑一个服务,也可以换成用户自己训练的版面模型,OXR接着负责内容识别和阅读顺序。官方称这是首创。
理由很实在:版面这层的差异比其他任何环节都大。同一份文件,不同业务对元素类型、区域边界、分组规则的要求可以完全不同(比如:一个文本框是“标题+正文”还是“一个表格”,一组图片是一个区域还是每个图片一个区域,没有通用答案。)
版面分析一直是文档解析服务里被要求定制最多的部分。把它拆出来做成标准接口,等于把“最常被换的零件”从黑盒里拿出来,让业务侧自己决定版面规则,OXR守住识别和阅读顺序的通用能力。
阅读顺序并入识别模型,还带来一个额外收益:阅读顺序的判断可以结合内容语义,而不只是纯视觉的框排序。从全页图像和每个区域的ID、类型、边界一起预测顺序,双栏、标题、图注和正文的关系可以在识别阶段一并被利用。
5. 数据有多硬,边界就有多清楚
三榜第一的具体分数:OmniDocBench 97.18、olmOCR-Bench 87.84、DocParsingBench 87.76,三项均排名第一,表格解析的领先幅度尤其明显。
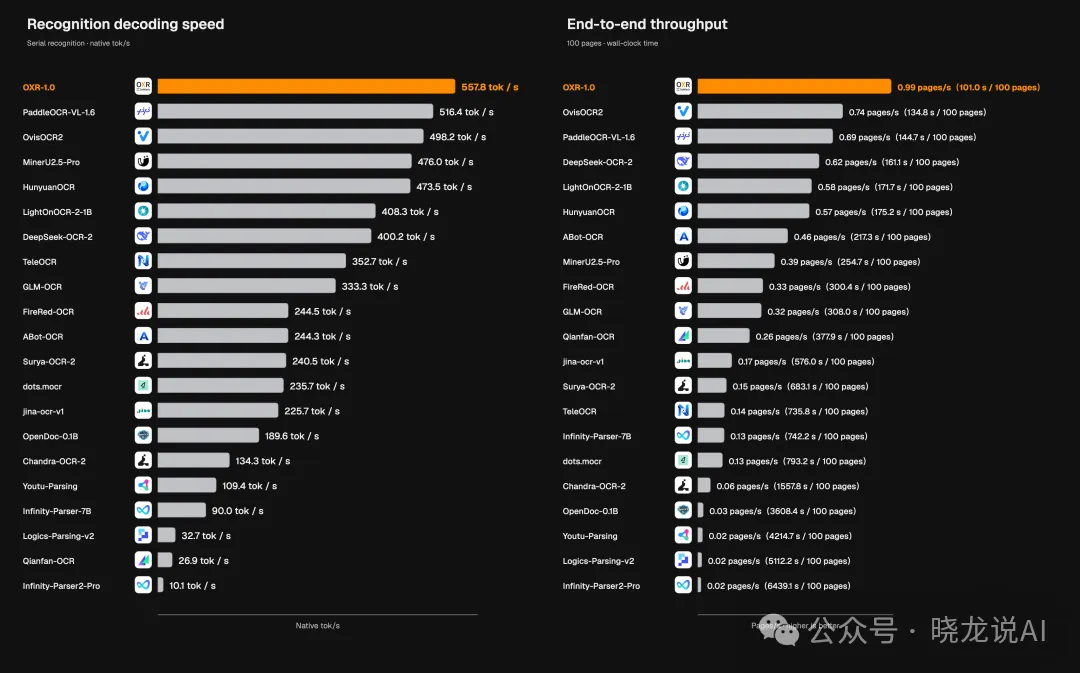
速度上,同场参测、同一张RTX PRO 6000 Blackwell上,解析从OmniDocBench随机抽取的100页文档,OXR平均约101秒,PaddleOCR-VL-1.6约145秒,MinerU2.5-Pro约255秒。
开源范围是代码、权重、评测复现流程全量开源,GitHub上线三周超1000 star,X上超100万 views。但开源协议需要单独核实:许可证并非标准Apache 2.0,而是在Apache 2.0基础上附加条款的OXR Open Source License,商用前必须以官方LICENSE为准。
免费API(free-oxr.somark.ai / free-oxr.somark.cn镜像)无需注册,但官方自己明确提醒:排队处理、不保证稳定性,不建议用于生产。想正式用,自托管部署单卡24GB显存起步。
另外,“文档解析领域第一次用RSI”是官方表述,不是第三方独立认证的“全球首次”。arXiv技术报告尚未发布,RSI循环的完整细节目前以README和官方说明为准。
因此,OXR不是文档解析的终局。它没有“统治”这个行业,但它做了一件足够具体的事:把Agent“眼睛”的标准,从“勉强能用”抬到了“可以不用将就”。
Agent的最后一公里,不该卡在PDF上。更不该卡在“反正OCR都差不多”的将就里。
资料参考:
https://heatdrop.ai/repo/SoMarkAI/OXR
https://www.kun.net/models/oxr-1-0/
https://dev.to/luming/the-long-overlooked-performance-cost-in-document-parsing-reading-order-504c#comments#1
https://dev.to/luming/how-to-use-oxr-from-the-free-api-to-self-hosting-1kb#comments#1
https://www.qbitai.com/2026/10/505635.html