ARTICLE · 1268676
AI 工具越换越多,我的资料却还是一团乱
AI 工具越换越多,我的资料却还是一团乱
简介
Skill 解决的是“让 AI 按规则做事”,但规则之外,还有一个更现实的问题:资料到底放在哪里?用哪个版本?哪些内容可以直接引用?当我的报价 Skill 开始依赖越来越多的产品资料、价格表和历史案例时,我发现,工具换得再勤快,资料也不会自动变得清楚。知识库不是把文件丢进去就结束了,它决定了 AI 能不能找到正确的资料,也决定了我们以后能不能把经验真正留下来。
Skill 能做事以后,我又遇到了新的问题
前面几篇文章里,我一直在解决一个问题:怎么让 AI 按照我的方法做事。
先是学会给它上下文,再是比较不同模型,后来又制作了自己的 Skill。Skill 能把一部分固定流程保存下来,让 WorkBuddy 不用每次都从头理解“报价应该怎么做、资料应该怎么查、结果应该怎么输出”。
但 Skill 用得越多,我越发现它还有一个前提:它得知道去哪里找资料。
报价模板放在哪里?
最新的设备成本价是哪一份?
去年那个项目的特殊处理方式还能不能参考?
如果这些资料只是散落在电脑文件夹、微信聊天记录和几个临时文档里,Skill 写得再清楚,也只能让 AI 更快地找不到东西。
这时候我才真正意识到:
Skill 解决的是“怎么做”,知识库解决的是“依据什么做”。
我为什么没有继续往 Skill 里塞规则
我最初的想法很直接:既然 AI 找不到资料,那我就把资料位置、使用方式和注意事项全部写进 Skill.md。
后来我发现,这条路很快就会走不通。
资料会更新,文件会增加,项目会留下新的案例。今天我把一个价格表的位置写进规则里,过一段时间价格表换了版本,原来的说明就可能过期。今天我把一个项目的处理方式写进去,换一个项目后又未必适用。
如果所有内容都写在 Skill 里,Skill 最后就会变成一个越来越长的说明书。规则、资料、历史案例、例外情况全部混在一起,AI 既要判断“应该怎么做”,又要判断“应该用哪份资料”,出错的概率反而更高。
所以我开始考虑把两件事拆开:
拆开以后,规则不用一直膨胀,资料也不用反复复制到每一个 Skill 里面。
我没有一开始就陷入“到底选哪个工具”
刚接触知识库时,我也差点走进一个很常见的坑:先打开搜索框,开始比较哪个工具更强、哪个工具更先进、哪个工具更适合做第二大脑。
但我很快停了下来。
因为工具还没有选,问题本身都没有想清楚。我要做的不是参加一场知识库软件评选,而是解决我自己的工作问题。
我先把手头的资料摊开来看:报价模板、产品参数、成本资料、历史项目、客户需求,还有那些我平时临时记在聊天窗口里的判断。
我真正想解决的,其实是下面几件事:
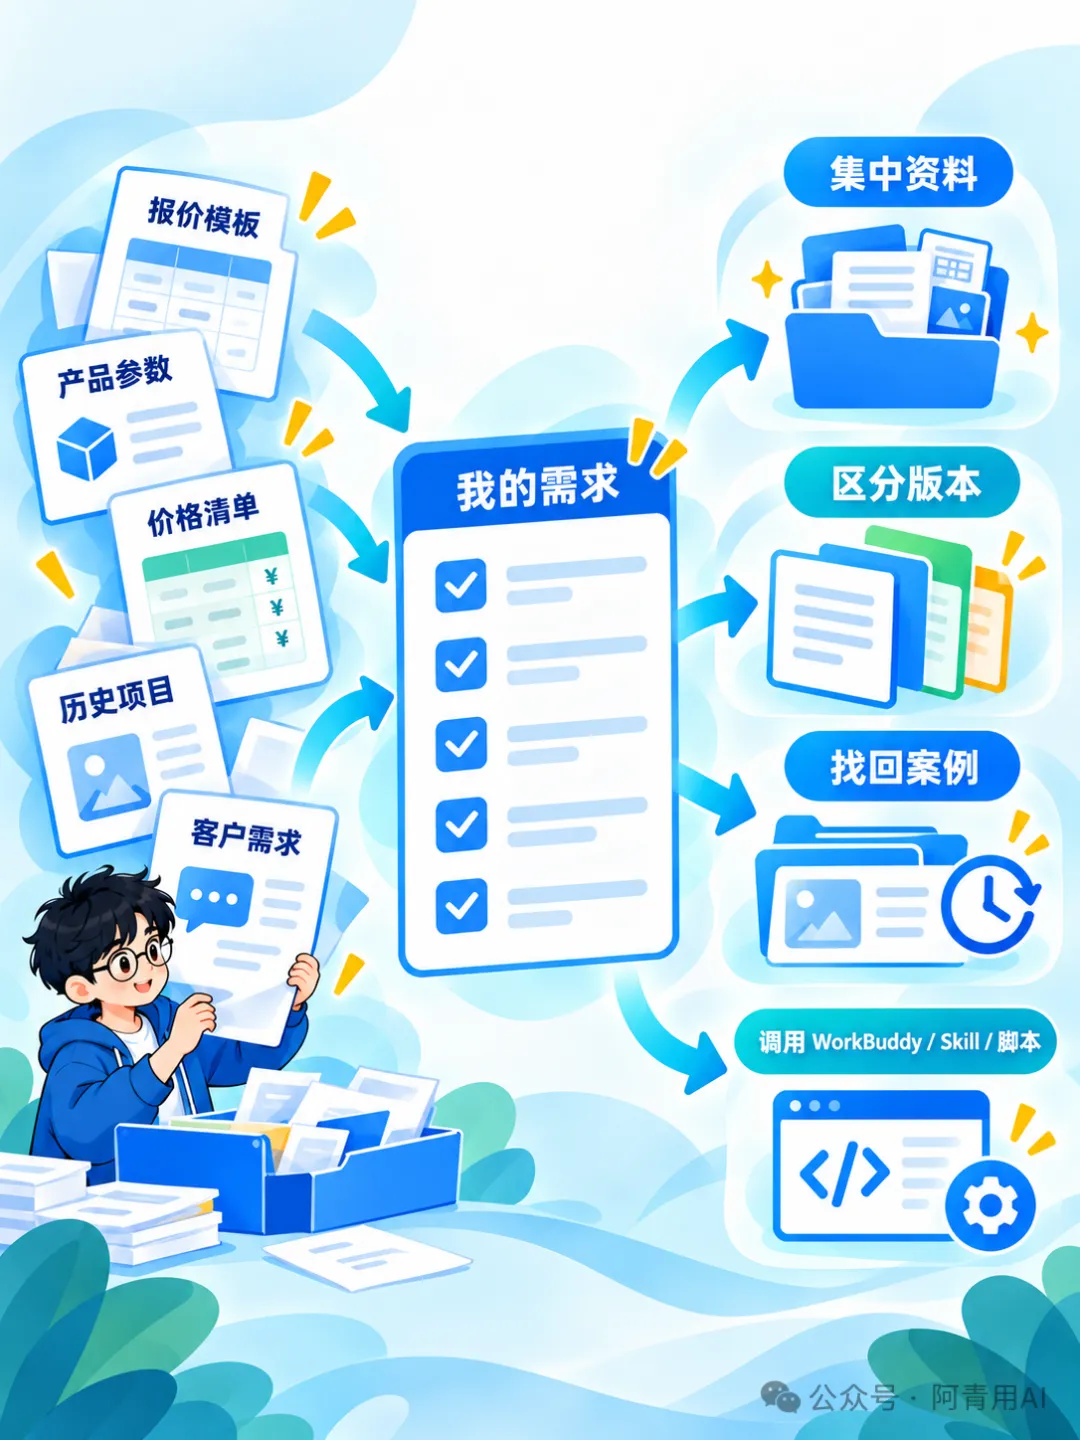
知识库要解决的不是“软件哪个好”,而是资料、版本和后续调用怎么接起来。
需求一列出来,选择就没有那么玄学了。
如果我只是想把一批资料快速读懂,IMA 会更顺手;如果我要建立一个能够长期保存、持续整理,还要和后面的工作流连接起来的资料底座,Obsidian 就更符合我的目标。
所以我才把这两个工具拿出来认真比较。
先把自己的工作问题列出来,工具选择就不会变成盲目比较。
IMA 更像一个可以直接提问的资料助手
IMA 的使用方式比较直观:把文件、网页、图片或其他资料放进知识库,然后围绕这些资料提问、总结和整理。
对不想先研究复杂结构的人来说,这个过程比较顺。
你不用一开始就设计复杂的文件夹和链接规则,也不用先决定每条信息应该放在哪个页面。先把资料收进去,再围绕资料提问,比较适合刚开始接触知识库的人。
比如,我可以把一批报价模板、产品资料和历史项目文件放进去,然后直接问:
“这几份资料里,哪些内容和室内项目报价有关?”
“这两份价格表有什么不同?”
“按照现有资料,完成一次报价还缺哪些信息?”
这类用法里,IMA 的优势很明显:上手快,反馈快,资料一放进去就能开始问。它适合临时接手一批文件、快速提炼重点、比较几份材料,或者还没有形成稳定整理习惯的人。
它也不只是“上传文件后聊天”。在实际使用中,我会把它当成一个资料入口:网页先收进去,会议记录先收进去,图片和 PDF 先收进去,之后再通过提问把有用的内容整理出来。
腾讯目前把 IMA 定位为以知识库为基础的 AI 知识管家,官方介绍中也提到它支持文件、网页、图片、音频等内容的导入和解读。具体功能会随版本更新,实际使用时还要以当前版本为准。
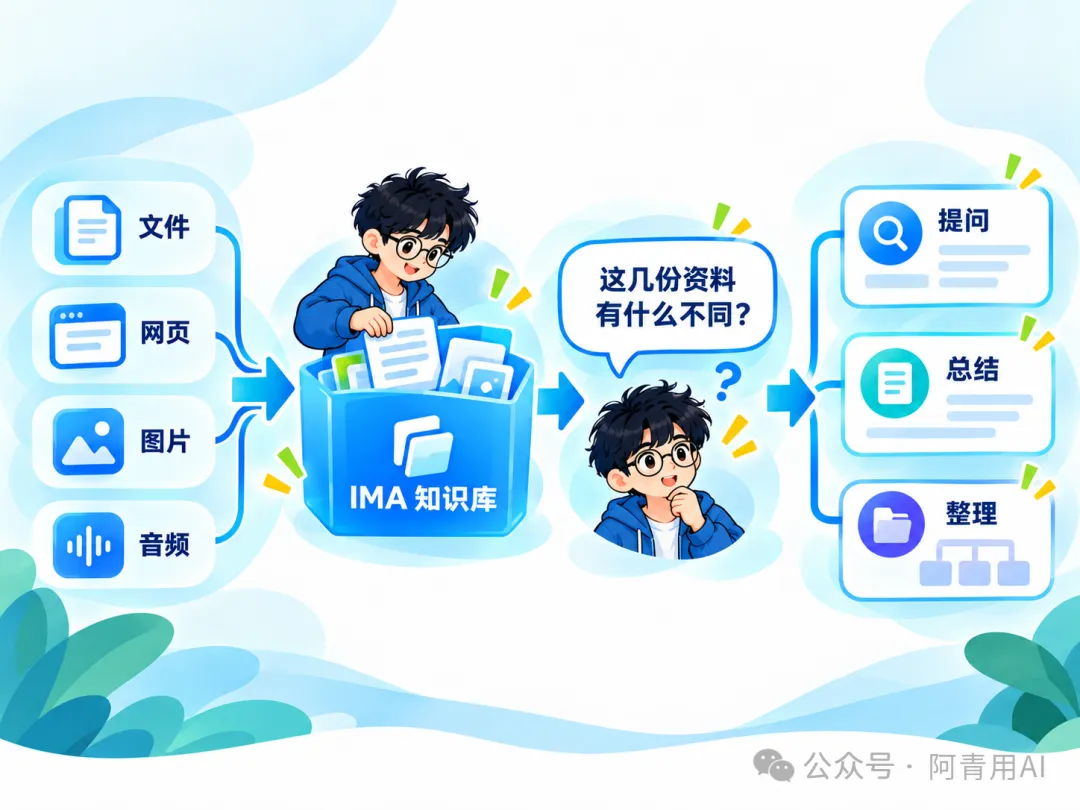
IMA 的优势,是资料进入知识库后,可以马上围绕资料提问和整理。
Obsidian 更像一个自己搭建的资料仓库
Obsidian 给我的感觉不一样。
它不是先把“马上回答问题”放在最前面,而是先把资料以 Markdown 文件的形式保存在本地,再通过文件夹、标签、双向链接和其他插件,慢慢建立自己的知识结构。
这意味着它需要你多做一点整理,也需要你对资料之间的关系有自己的判断。
它最大的特点,是资料不只是存在软件里,而是以本地文件的形式存在。笔记可以打开、备份、复制和迁移,也可以被其他程序读取。Obsidian 官方文档显示,它支持 Markdown、图片、音频、视频、PDF 等文件,也支持 Canvas 这类可视化整理方式。
对我来说,这一点很重要。因为报价资料不是看完就算了,它还要继续被 WorkBuddy 找到,被 Skill 调用,被脚本检查。文件在本地、格式比较开放,后面做这些连接时,心里会更踏实。
但它的门槛也更高。
如果你只是把文件全部拖进去,却没有命名规则、目录结构和整理习惯,最后得到的可能不是知识库,而是一个更漂亮的文件堆。
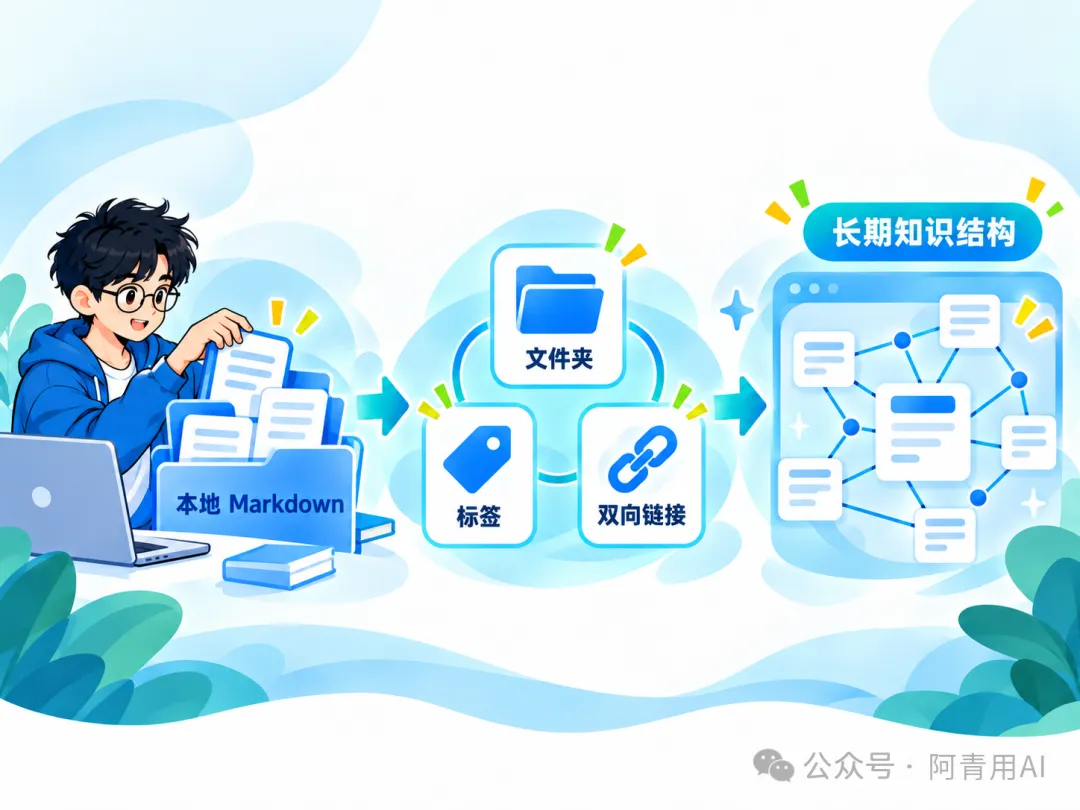
Obsidian 的价值不只是保存文件,而是让文件之间慢慢形成自己的结构。
这两个工具的优势,刚好在两个方向上
IMA 的优势,是帮我尽快把资料用起来。
我不需要先学习一套知识管理方法,也不用先把每篇资料拆成标准笔记。资料放进去以后,先问起来、先整理起来,适合解决眼前的问题。
Obsidian 的优势,是让我把资料真正留下来。
文件放在哪里、叫什么名字、属于哪个项目、关联哪些案例,都可以由我自己决定。以后哪怕更换 AI 工具,资料还在本地,原来的结构也不会全部消失。
一个偏“马上使用”,一个偏“长期积累”。这也是我为什么只比较它们,而不是把所有知识库工具都列一遍。
这两个工具到底怎么选
我后来没有把它们理解成互相替代的两个工具,而是先把自己的需求放到同一张表里看。
这不是说 IMA 不能长期使用,也不是说 Obsidian 不能接 AI。
真正的区别在于:IMA 更强调“资料进来以后马上用”,Obsidian 更强调“资料留下来以后怎么组织”。
这张表只能帮我缩小选择范围,不能直接替我做决定。真正决定我最后选谁的,还是前面那几个问题:资料是否掌握在自己手里,版本能不能分清,未来能不能被 WorkBuddy、Skill 和脚本继续调用。
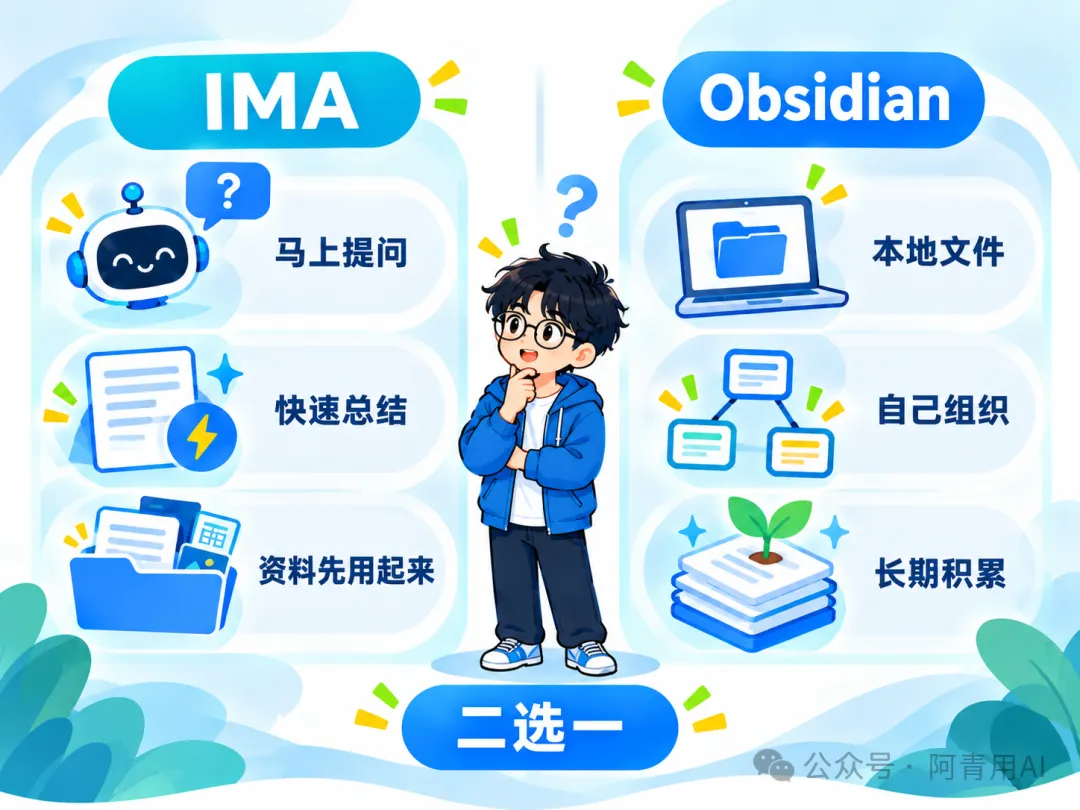
IMA 偏向马上使用,Obsidian 偏向长期积累。
我为什么没有把 IMA 定为最终选择
如果我的目标只是快速处理一批资料,IMA 完全够用。
比如临时拿到几份 PDF,想知道它们分别讲了什么;或者手里有一堆网页、截图、会议记录,想先找出重点。这个时候,IMA 比较省事:不用先设计目录,资料收进去就能开始问。
但我的需求不止是“现在问一个答案”。
报价资料会不断更新,产品资料会有不同版本,历史项目还要在以后被重新查到。我还希望 WorkBuddy、报价 Skill 和脚本能围绕同一批资料工作。
这就要求我不仅能问到答案,还要知道答案来自哪份文件、哪个版本,以及这份文件能不能被其他工具继续读取。
IMA 更适合把资料交给 AI 快速使用,而我现在要做的是先把资料整理成自己的长期资产。它适合当资料助手,但不完全符合我想搭的工作底座。
我为什么把 Obsidian 留到最后
Obsidian 的第一步确实麻烦一点。
我得自己想清楚:报价模板放在哪个目录,价格表怎么命名,历史案例怎么和产品资料关联,旧版本要不要保留,哪些内容需要单独写成经验笔记。
但这些麻烦,正好也是我需要建立的工作规则。
Obsidian 的笔记是本地 Markdown 文件,可以备份、复制、迁移,也可以被其他程序读取。以后即使我换了 AI 工具,资料本身还在;如果要让 WorkBuddy 检索,或者用脚本扫描文件,也有比较清楚的落点。
更重要的是,我可以把“我为什么这样报价”“这个项目当时遇到了什么问题”“下次遇到类似需求要检查什么”这些经验留下来。它们不再只是某一次聊天里的答案,而是可以继续修改、关联和复用的资料。
所以 Obsidian 的优势不是第一次使用时更轻松,而是时间越长,越能看出它的价值。
这次不是两个都用,而是明确二选一
如果只是体验工具,IMA 和 Obsidian 都可以试。
但如果是要为后面的工作流建立一个长期底座,我不准备两个一起维护。两个工具同时使用,最容易出现的问题就是:资料放一份在 IMA,另一份在 Obsidian;过一段时间以后,自己也不知道哪边才是最新版。
知识库最怕的不是工具少,而是资料没有唯一来源。
所以我给自己的选择标准只有一句话:
以后报价 Skill、WorkBuddy 和脚本,都应该能够围绕这套资料继续工作。
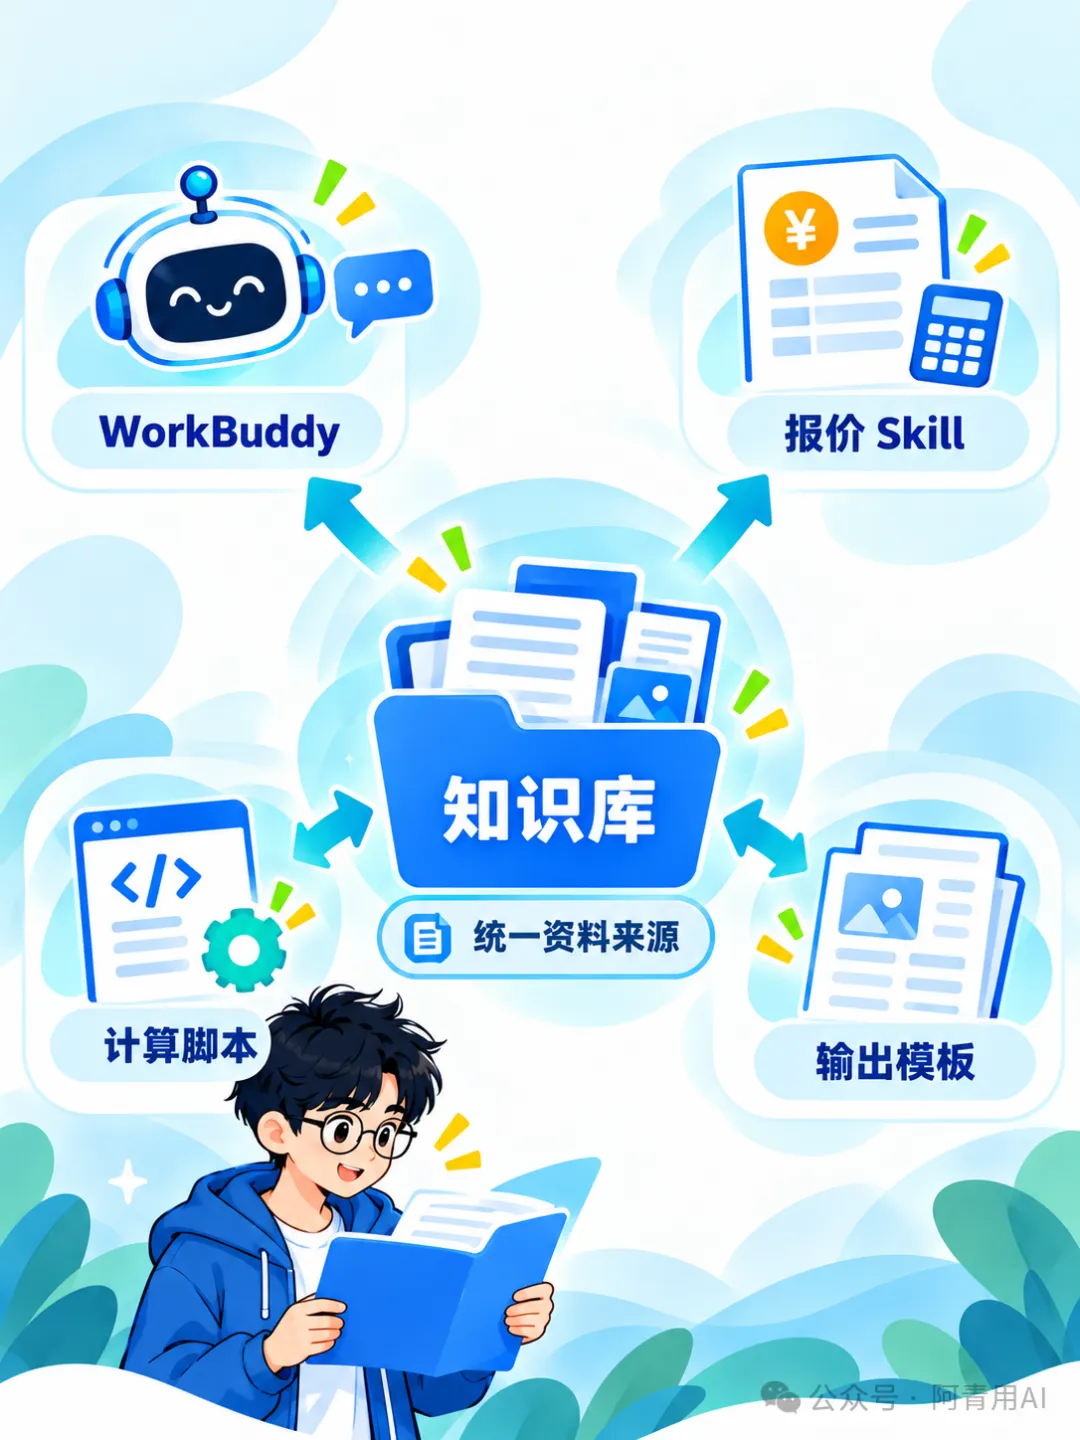
知识库要成为多个工具共同使用的资料来源,而不是又一个孤立的文件夹。
按照这个标准,我最后选择 Obsidian。
不是因为 IMA 不好,而是因为 IMA 更适合“把资料交给 AI 使用”,而我现在要做的是“先把资料和经验掌握在自己手里,再让 AI 来使用”。
IMA 的优势是快,Obsidian 的优势是稳;IMA 更像一个随时可以提问的资料助手,Obsidian 更像一个可以持续建设的本地资料底座。
对我现在的工作来说,后者更重要。
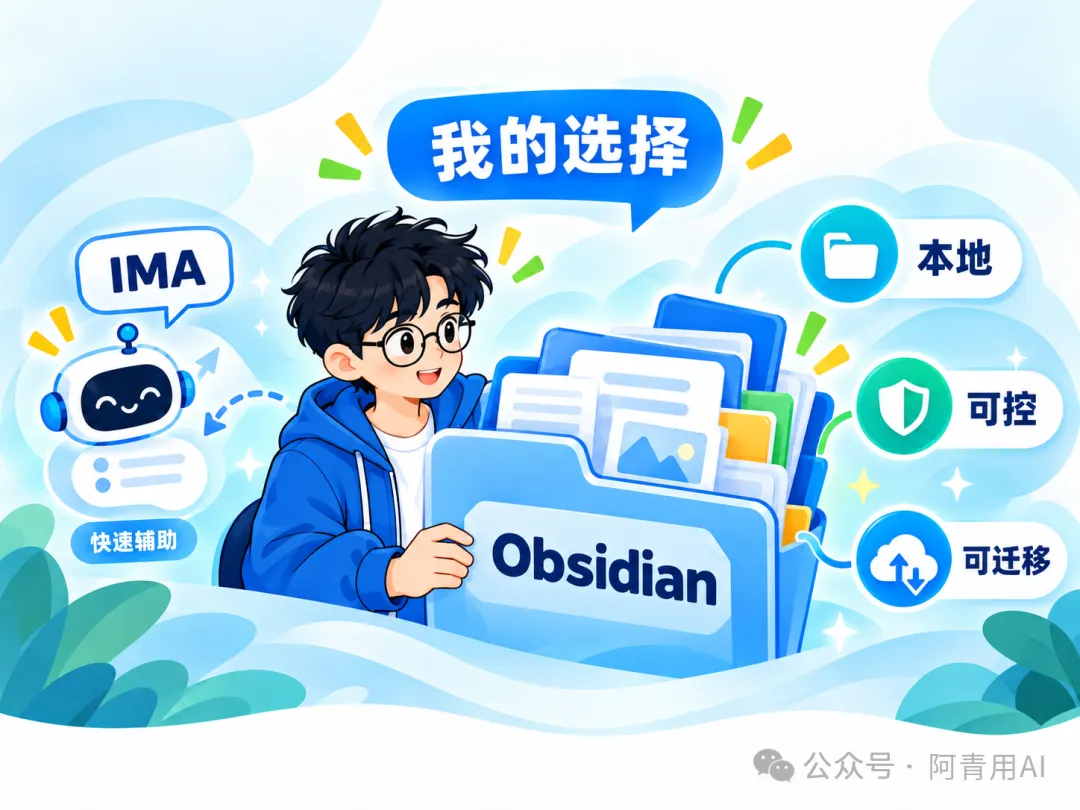
不是 IMA 不好,而是 Obsidian 更符合我想搭建的长期本地资料底座。
选了 Obsidian,就不能只把它当文件夹
当然,选择 Obsidian 不代表把所有文件拖进去就完成了。
如果没有统一的命名方式、版本规则和目录结构,Obsidian 也会变成一个更漂亮的文件堆。
我至少需要先确定几件事:
这才是知识库真正难的地方。工具只是容器,规则才决定资料能不能被稳定使用。
我现在真正关心的,已经不是工具名称
以前我总想先选对工具,再开始做事。
现在我会先问几个更实际的问题:
这些问题如果没有解决,换哪个工具都可能只是换一个地方继续堆文件。
所以,这次选择 Obsidian 只是开始。真正重要的是,我要建立一套资料进入、整理、检索、更新和调用的方法。
下一篇,我准备真正搭一个本地知识库
这篇文章先把工具选择讲清楚,下一篇我准备直接拿自己的工作资料做一次实操。
我会从最简单的一组资料开始:报价模板、产品资料、价格文件和历史案例。先给它们重新命名和分类,再测试 AI 能不能找到正确版本,最后看看这个知识库能不能和前面做好的报价 Skill 配合起来。
到那时候,问题就不再是“IMA 和 Obsidian 哪个更好”,而是:
我能不能把自己的工作经验,变成一个以后真的找得到、用得上的本地知识库?
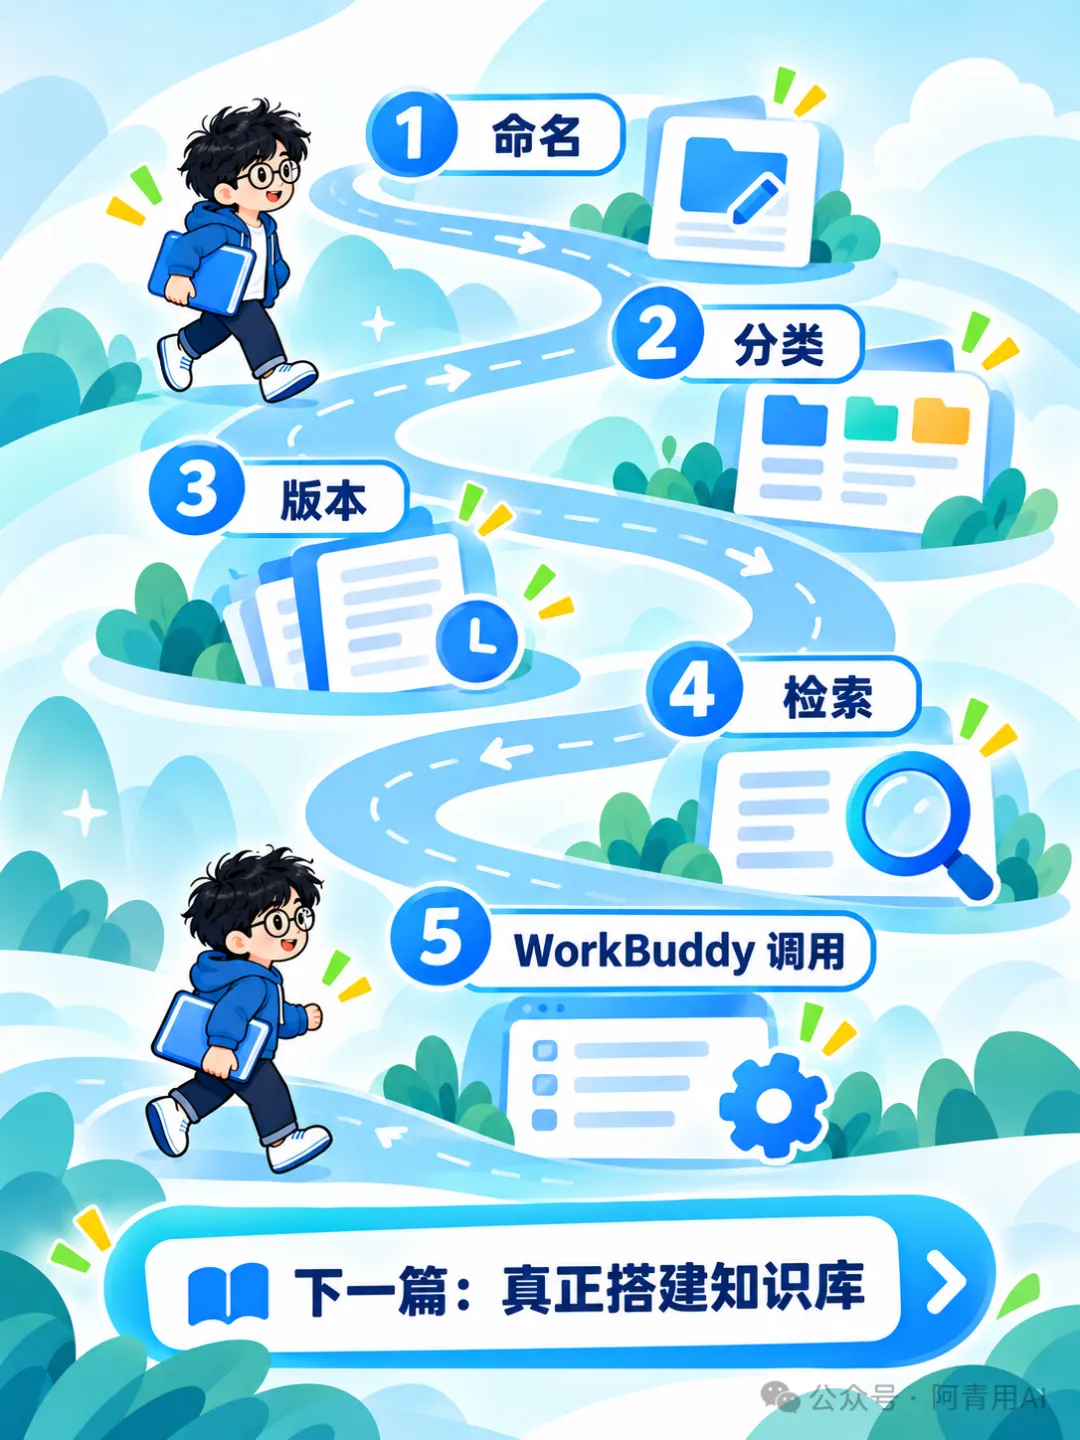
选工具只是开始,下一步要把资料真正组织起来。