ARTICLE · 1272484
Uber 如何为 AI Agent 打造工具网关
编辑:浮世Talk
Uber 如何为 AI Agent 打造工具网关
一个开箱即用的大语言模型可以解释你的代码为什么会报错,可以提示可能的原因,也能完成写一条数据库查询这样的任务。但这一切都停留在通用层面,依据的是模型训练时学到的东西。你没法指望它基于你系统的内部运转机制来给出答案。
这件事要靠工具来解决。每个工具都为一件具体的事而生。但在企业环境里,工具会越积越多,Uber 的工程团队面对的就是这个局面。
为了应对,他们造了 MCP Gateway。你可以把它理解成一个共享平台:让不同的 AI Agent 找到有哪些工具存在,并调用它们完成自己的工作。本文会详细拆解 Uber 是怎么把这座网关建起来的。我们将覆盖:
什么是工具,AI Agent 为什么需要它们 MCP 在 Uber 扮演的角色 Uber MCP Gateway 的设计 网关如何发现可用的工具 MCP Gateway 如何工作 MCP Gateway 如何处理权限与访问
声明:本文基于多方公开披露的细节整理,参考资料附于文末。如发现不准确之处,欢迎指出。
为什么 AI Agent 需要工具
如果你想让一个通用 LLM 针对你当前的系统作答,就得让它接触到关于这些系统的信息。举个例子:一位开发者问基于 LLM 的 AI 助手,XYZ 服务为什么突然开始失败。答案藏在系统的日志、部署记录、指标和事故单里。模型必须能访问这些信息,才答得出这个问题。
这就是我们需要造工具的地方。你可以把工具理解成 AI 应用可以执行的一次操作。比如,你可以有一个搜索日志的工具,一个拉取事故详情的工具,或者一个查询部署状态的工具。模型选定一个工具并给出必要输入,应用执行它,再把结果送回模型。
其中很多工具其实已经以 API 的形式存在了。你可能已经知道,API 是让一个程序向另一个程序请求东西的接口。比如我们有一个日志服务对外暴露了 API:它以服务名和时间范围为输入,返回落在该区间内的所有日志条目。
但要让 Agent 用上这样的服务,我们还得描述它做什么、需要哪些输入。这种结构化的定义,就构成了 LLM 应用可以调用的工具。而在幕后,真正执行检索的是那个 API。
MCP 在 Uber 的角色
MCP 是 Model Context Protocol 的缩写。借助 MCP,AI 应用有了一套标准方式,去发现有哪些外部能力可用,并与它们对话。Uber 的工具生态就建在 MCP 之上。
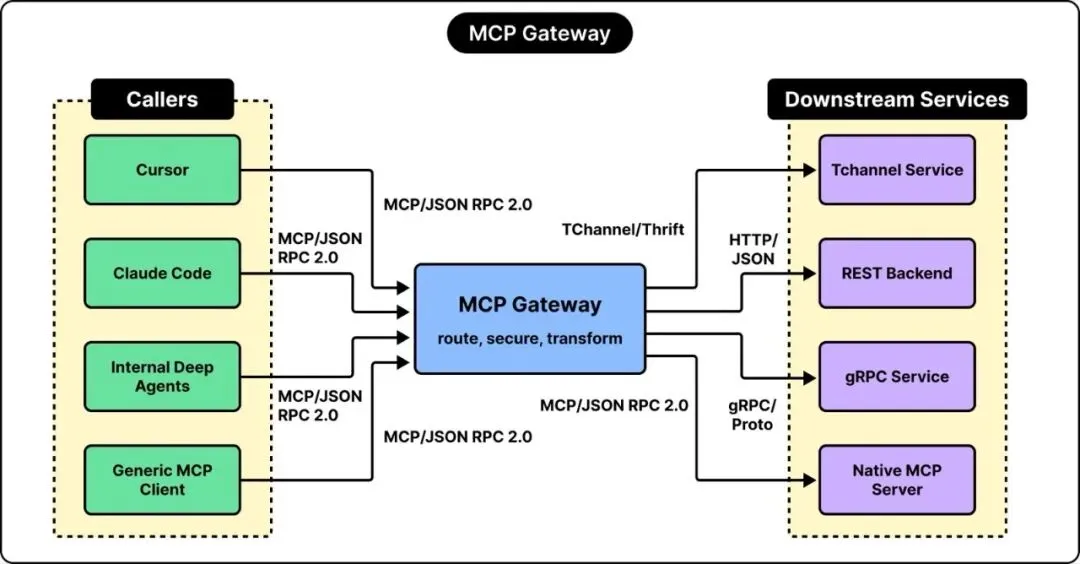
要更好地理解 MCP 的作用,必须先弄清三个重要术语。
第一是 MCP client。这个组件位于 AI 应用内部,用 MCP 通信,负责各类交互,比如请求可用工具列表,或者对选中的工具发起调用。
第二是 MCP server。它通过 MCP 把能力(也就是工具)暴露出来。在 Uber 的场景里,server 展示有哪些工具可用,并接收针对这些工具的请求。
第三是 MCP tool。它是某个 server 暴露出来的单个操作,你也可以把它理解为一项能力。一个 server 可以提供多个工具。
MCP 要求你把工具定义清楚。这份定义由名称、描述、输入 schema 等信息组成。schema 描述数据的结构:有哪些字段、哪些必填、可以接受什么类型的值。比如你可以定义一个 schema,要求 service_name 是字符串,limit 是整数。
MCP 用结构化的方式格式化请求及其参数,同样也格式化对应的结果或错误。格式通常是 JSON-RPC 2.0。这种标准化让集成变得容易:同一个 MCP client 可以对接不同的 MCP server。
不过标准化并不是免费的。总得有人决定存在哪些工具、它们跑在哪里;你还需要追踪工具的归属方以及它们的工作方式。起初,Uber 内部的工程团队各自搭建自己的 MCP 集成。在小范围内,这种自治很棒。但随着采用面扩大,很明显每个团队都在解同一类问题:暴露工具、管理连接、处理权限,等等。更麻烦的是,想知道有哪些工具可用都很困难,一切散落各处。
在此之上,Uber 既有的服务版图又带来一道难题。Uber 的所有服务并不以同一种方式互相通信:有的用 HTTP,有的用 gRPC,还有的用 TChannel。举个例子,可能一个 HTTP API 用 JSON,而一个 gRPC API 用 Protobuf 消息。你没法在不改动请求格式的情况下,把一条 MCP 请求直接转发穿过这些服务。
因此,Uber 需要一个公共层,把 MCP client 连接到工具上;他们还希望这一层承担统一的发现、安全和运维支撑。这一层就是 MCP Gateway。
Uber MCP Gateway 的设计
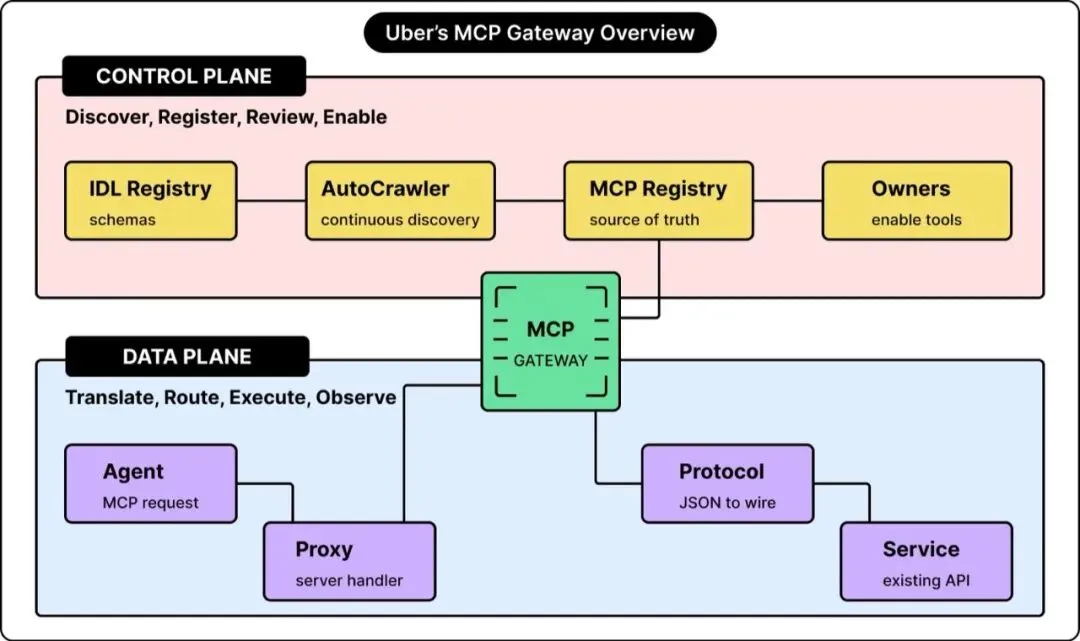
Uber 的 MCP Gateway 平台分成两个主要组件:MCP Registry 和 Proxy Gateway。这样的拆分让工程团队可以独立管理工具定义与权限。
我们分别来看。
MCP Registry
你可以把 MCP Registry 看作控制面。它持有 MCP server 与工具的目录。发现工具所需的信息、以及进一步了解工具的信息,都可以记录在 registry 里。
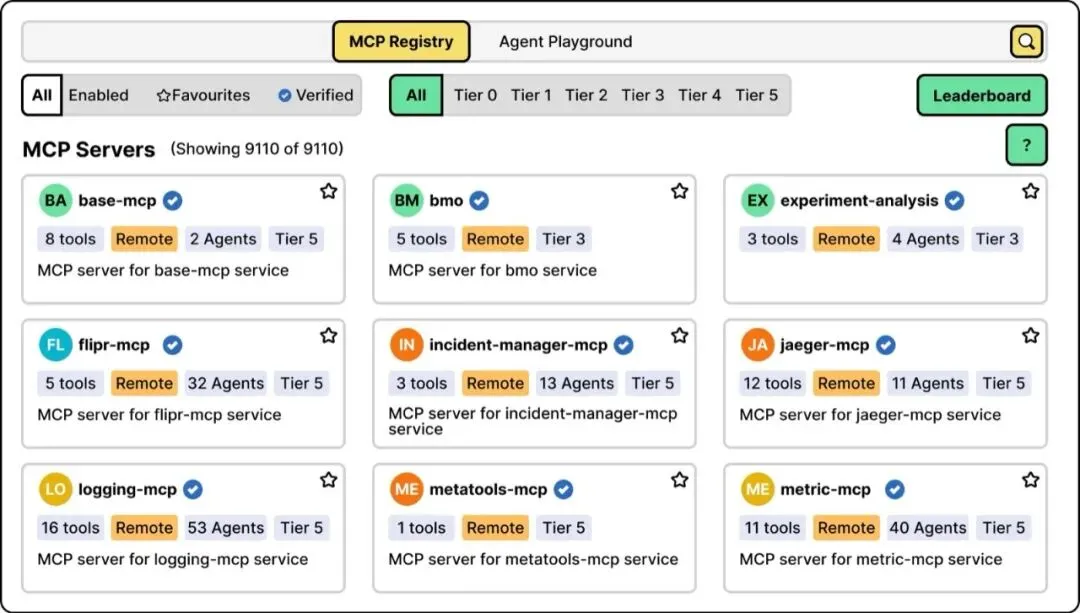
之所以叫它控制面,是因为 registry 同时管理配置。比如,你可以在 registry 里启用或停用某个工具。它也是共享的唯一事实来源。
Proxy Gateway
这是数据面。当 Agent 干活时,真实的 MCP 请求由它处理。
网关识别出被请求的工具,施加必要的控制,把请求送到正确的服务,然后返回一个符合 MCP 规范的结果。
工具是如何被发现的
你不可能手工为成千上万个服务创建 MCP 集成。工作量巨大,而且容易出错。Uber 用 AutoCrawler 把其中大部分工作自动化了。
AutoCrawler 负责发现既有的 API 和 MCP server,生成或取回它们的工具定义,并注册到 MCP registry 中。
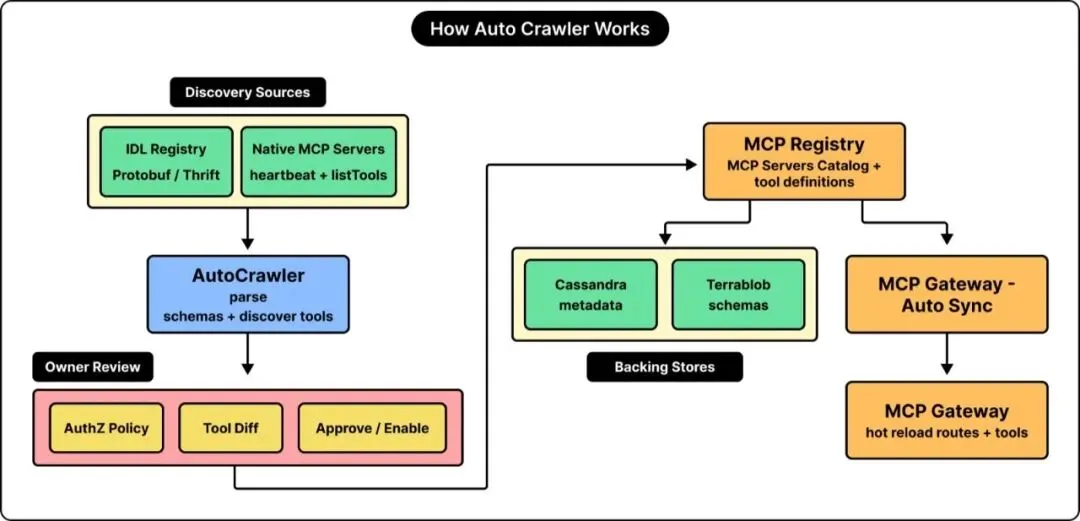
从技术上看,AutoCrawler 是一个分布式工作流系统,底层由 Cadence 驱动。在这套体系里,一个定时任务启动工作流,去寻找新的服务、API,或者 schema 变更。
那 AutoCrawler 具体怎么发现新东西?它有两条主要的发现路径。
从既有 API 定义出发
很多 API 使用内部定义语言(IDL)来描述自身。
IDL 是对服务接口的机器可读描述。你可以用它指定操作名、请求字段和文档注释。比如,你可能有一份 API 定义描述了一个名为 GetDeploymentStatus 的操作:它以部署 ID 为输入,返回状态和时间戳。
AutoCrawler 可以读取这些定义,然后走几个步骤。
首先,它为这个服务创建一份 MCP server 的表示,也可能更新已有的表示。接着,它提取出方法名、请求与响应的结构。然后,它把找到的东西翻译成 MCP 能理解的工具 schema。
AutoCrawler 还会用 LLM,基于从服务中提取到的细节,写出更好的工具描述。最后,它把这些工具定义存入 registry。
如你所见,AutoCrawler 是 Uber 无代码思路的一个好例子:既有的服务契约里已经有足够的信息,平台可以据此自动生成 MCP 接口。
发现原生 MCP server
有些服务直接实现了 MCP。在 Uber,这类服务被称为原生 MCP server。它们本身已有工具定义,所以 AutoCrawler 少了一道工序。
每个原生 server 都会发出心跳指标,用来表明自己的存在与就绪状态。AutoCrawler 持续跟踪这些信号。一旦发现某个 server,它就调用该 server 的 listTools 操作。拿到工具列表后,它在 registry 中为所有工具及其 schema 创建代理表示。
可以看到,两条发现路径最终都汇入同一份目录。
发现工具 ≠ 有权使用
Uber 做了一个设计选择:新发现的 server 和工具,初始状态是停用的。
这意味着自动发现只让平台"看得见"这项能力。之后,拥有该服务的团队应当审核并启用它,让 Agent 真正能用。是否启用是一个归属权决策。让服务团队有机会检查工具描述是否正确,这样更好。
归属团队可以通过 registry 的界面审视并更新工具定义。每一次修改都是一个新 diff,需要审批。只有通过审批的变更才会部署。如有需要,归属方还可以回滚到之前的版本。
Uber 的 MCP Gateway 如何工作
一旦工具配置存入 registry 并标记为可用,数据面就会消费这些工具详情来刷新自己的内存状态。这个过程按固定的周期进行。
网关在请求处理时使用这些映射。周期性刷新保证了任何新变更都能生效,而无需重启服务或重新部署。
网关拿这些配置细节,用来创建虚拟 MCP server。你可以把虚拟 server 理解为存在于网关内部的一个逻辑 MCP 接口:它由一组工具加上一个供 client 访问这些工具的端点组成。比如,你可以有一个叫 "logging" 的服务,暴露在 "logging/mcp" 这个端点上。
要使用工具,client 就像对待一个 MCP server 那样与这个端点对话。网关里有一个 handler,它知道这个 server 包含哪些工具,以及如何触达支撑该工具的服务。
要更好地理解,顺着一条请求的路由走一遍最清楚。
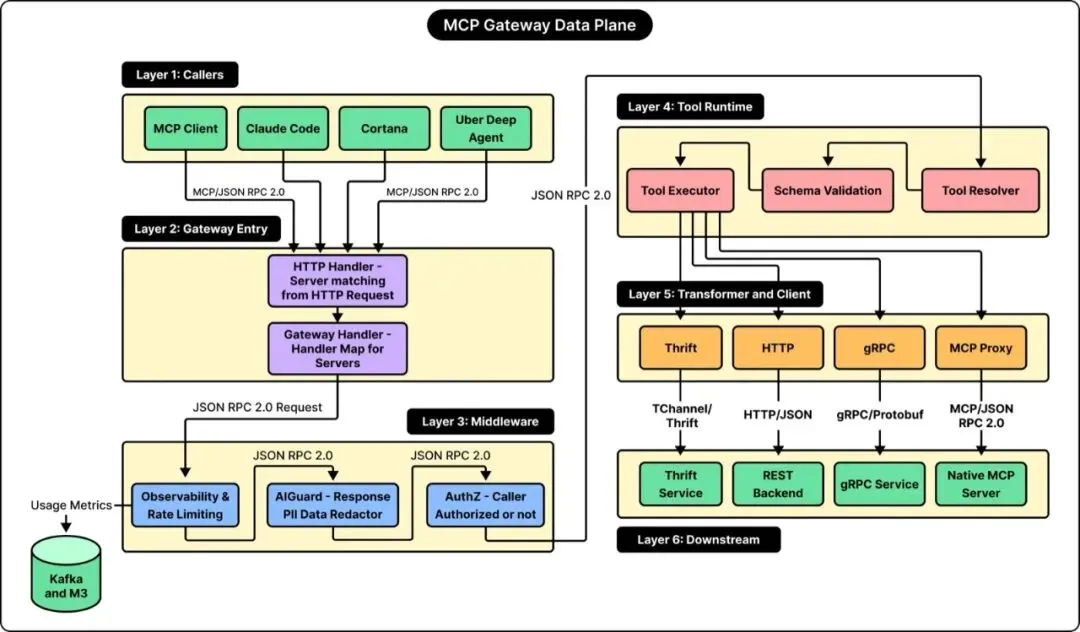
假设你有一个 AI Agent,调用了一个由 gRPC 服务支撑的工具:
首先,MCP 请求打到网关。网关找到对应的虚拟 server 以及被请求的那个工具。 接着,server handler 借助内存映射找到下游目的地与操作。这里的下游服务,就是网关要把请求发往的那个服务。 handler 把工具的 JSON 参数转换成服务期望的形式。比如对 gRPC 操作,你需要把请求序列化成 Protobuf 字节。 再往下,服务执行该操作并返回响应。 最后,网关把响应转换成符合 MCP 规范的结果,送回到调用方。
你可以想见,同样的路径对其他类型的服务也成立。比如 HTTP 后端接收的就是一个 HTTP 请求,而 TChannel 服务走的是 TChannel 或 Thrift 通道。
网关如何管理访问
你可以把网关看作一个统一执行所有工具访问规则的地方。
Uber 工程团队用内部的 Access Control System 来施加访问规则与策略。这些策略以调用方为依据——调用方可以是人,可以是某个服务,也可以是一个 AI Agent。你可以在 server 级别配置策略,如有需要,甚至可以细到为具体工具设置专门策略。因此这套系统提供了很大的灵活性。
这意味着平台支持工具级别的授权。举个例子,你可以让一个事故管理 server 暴露两个工具:读取事故和变更事故状态。即便它们属于同一个 server,你也可以用策略给这两个操作授予不同的访问权限。
网关还能对响应做脱敏,处理个人可识别信息(PII),或工具响应中可能存在的其他敏感数据。
对于 Jira、Google 这类第三方服务,还需要额外做一次身份校验。因为 Uber 的内部凭证与第三方系统可能接受的凭证不是一回事。网关会把调用方的内部用户 token 作为流程的一部分发给这个服务。该服务用这个 token 去换取外部认证 token,然后带着外部 token 把请求发往外部的 MCP server。
如你所见,职责是分开的:网关负责通用的访问控制与执行细节,第三方服务负责对接外部世界。
网关如何应对庞大的工具目录
Uber 运行着的庞大工具目录,会给 MCP gateway 带来一个上下文问题。
你可以让网关开放成千上万个工具,但 AI Agent 需要有高效的方式来挑选有用的那些。原因在于,每个工具定义都会占用模型上下文窗口的空间。可以把上下文窗口理解为模型输入中可用的空间,这个空间是有上限的,而且你还需要用它来放系统指令、对话历史,以及从工具返回的结果。
如果一个应用提前把成千上万个工具的描述和 schema 都加载进来,它们会占掉上下文的很大一块。同时,模型要处理的输入量也会飙升。工具响应也是同理:一个 API 可能返回一个字段繁多的对象,而任务其实只需要其中两个字段就能完成。
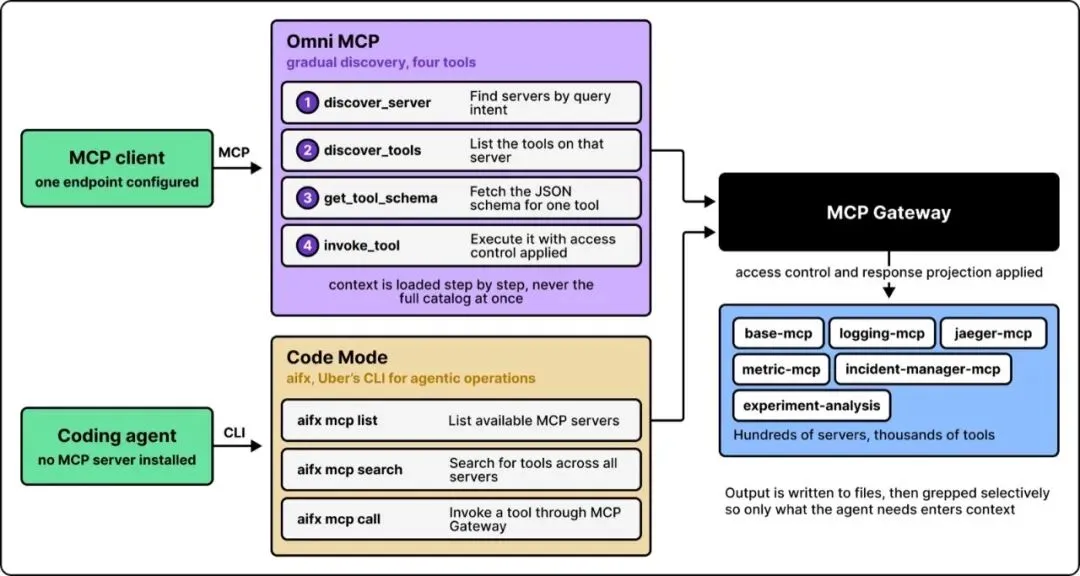
为解决这些问题,Uber 给网关加了三样东西:
Omni MCP:帮助 Agent 渐进式地发现能力。它是一个单一的代理 server,让 MCP client 以逐步发现的方式访问网关上的任意 server。它提供 discover_server、discover_tools、get_tool_schema 等工具。 Response Projection:减少工具结果中返回的字段。这是面向 MCP 工具的一种类 GraphQL 模式。你在工具请求中注入一个新字段,告诉网关响应里应该包含哪些字段,网关会把其余字段剔除。 Code Mode:让编码类 Agent 用 shell 命令和文件来处理结果。
结语
构建 MCP Gateway 这件事,在很大程度上改变了 AI Agent 在 Uber 的运作方式。
它起步于一个碎片化问题。当时有几十个团队各自独立地接 MCP 集成,工具链不一致,没有共享的安全保证,基础设施也在重复建设。现在,一切都归入一个可扩展的统一平台,任何团队都能在几分钟内接入。
驱动 Uber 团队的核心信条是:既有 API 是让 AI Agent 访问工具的最快路径。他们不希望各团队为了适配网关去重写自己的服务,繁重的活儿由 MCP Gateway 来干。
对开发者来说,最关键的启示是:构建 Agent 系统最难的部分不是 AI。你更该操心的是把正确的"连接组织"建起来。发现、安全、可靠性这类东西,在生产环境里至关重要。