ARTICLE · 1273342
我宣布Codex就是软件测试人神~
Codex 如何接入软件测试流程
先说结论,免得你划走。
版本迭代前一周,我们用 Codex 准备自动化回归:
自动化回归结果
自动化用例
670 条
当天产出,可直接运行
回归准备
3 天 → 1 天
原本预估时长与实际准备时长的变化
不是 demo,不是玩具,是能进 CI 的用例。
但我要先泼一盆冷水:如果你以为“把需求丢给 AI,一键生成脚本”就能做到,那你大概率会得到一堆看着像模像样、一跑全废的代码。
我们也是踩了坑才想明白:
关键认识
误区
把需求交给 AI,就能一键生成可用脚本
事实
Codex 不是代码生成器,它是测试流程的载体。
一、先说我一开始的误区:让 AI 直接写脚本
最开始我的想法很朴素:Codex 这么强,我把接口文档和需求一贴,让它直接生成 Pytest 脚本不就完了?
结果很真实:
• 第一次,它生成的脚本引用了不存在的 fixture; • 第二次,断言只有 assert response.status_code == 200;• 第三次,异常流一条没覆盖,参数为空、鉴权失败、重复提交全没管。
它能写代码,但它不知道你们团队的代码长什么样、测试规范是什么、历史踩过什么坑。
这和“把 Swagger 贴进聊天框生成用例”是同一个病:AI 不缺能力,缺的是上下文和约束。
二、转折:Codex 的正确打开方式,是“测试底座”而不是“代码补全”
我们做的第一件事,不是写 Prompt,而是搭底座。
1. 先解决“敢不敢用”的问题:权限与安全边界
测试手里有什么?接口密钥、业务敏感数据、内网地址。
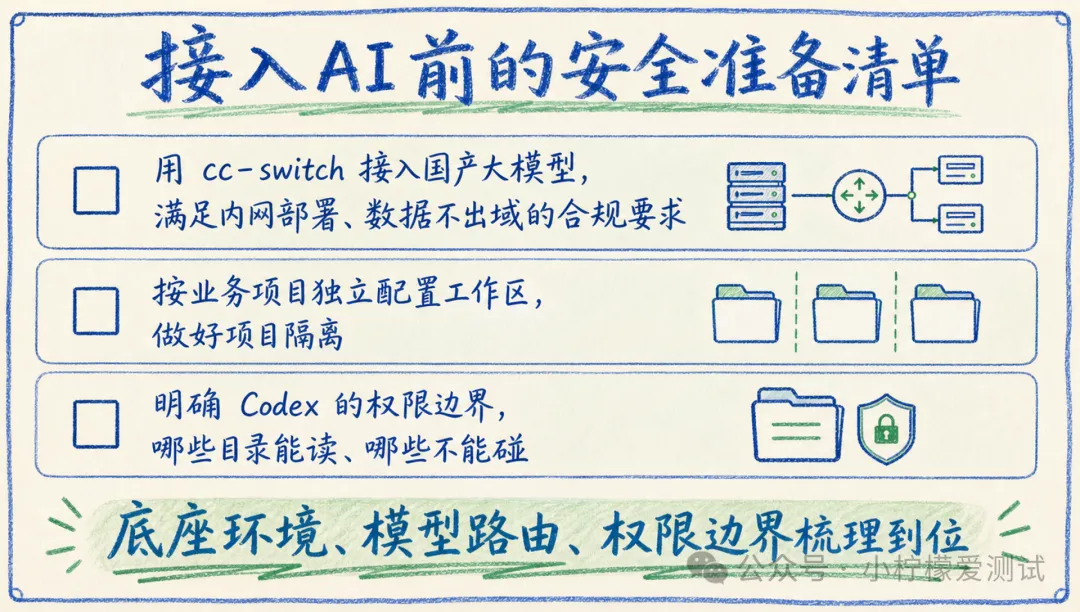
接入 AI 之前,我们先做了三件事:
• 用 cc-switch 接入国产大模型,满足内网部署、数据不出域的合规要求; • 按业务项目独立配置工作区,做好项目隔离; • 明确 Codex 的权限边界,哪些目录能读、哪些不能碰。
i
提示
这一步不做,后面全是空中楼阁。底座环境、模型路由、权限边界梳理到位,我们才敢把真实业务资料交给它。
2. 用“计划模式”拆任务,用“目标模式”盯进度
体量大的测试需求,最怕一上来就让 AI 自由发挥。
我们的做法是:
任务管理方式
计划模式
把大需求拆成可落地的测试任务清单
目标模式
沿着既定目标推进,避免思路跑偏
上下文压缩
处理长业务链路测试,解决长流程中遗忘前置条件的问题
聊天分叉
并行开启多条测试思路;多人脑暴时同步发散不同分支场景
这一步跑完,Codex 才真正开始“像测试工程师一样工作”,而不是“像代码补全一样输出”。
三、七个环节,把重复劳动交出去
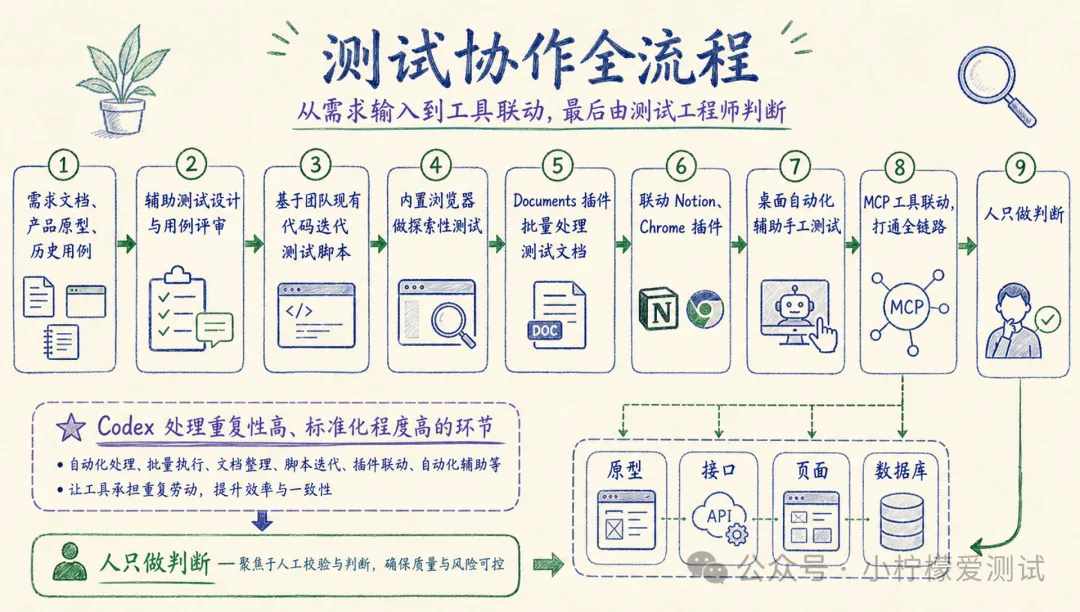
我们把重复性高、标准化程度高的环节交给 Codex,人只做判断。
环节 1:需求导入,辅助测试设计与用例评审
把需求文档、产品原型、历史用例一起交给 Codex,让它先出初稿。
然后通过对话驱动做用例评审,一来一回挖掘:
• 正向流程; • 边界条件; • 异常分支; • 对抗风险。
关键原则:Codex 产出的永远是初稿,不是定稿。
场景是否贴合业务、风险等级怎么划分、用例是否可执行,必须由测试工程师人工校验。
环节 2:脚本迭代,而不是凭空生成
很多人用 AI 写脚本,最大的坑是“凭空生成”。
我们的做法是:基于团队现有代码做迭代调整,用预览注释的方式精准修改测试脚本,而不是让 AI 从零编一套。
稳定性差多少?这么说吧:
基本不敢进 CI
当天就能跑
环节 3:内置浏览器做探索性测试
Codex 内置浏览器可以直接开展探索性测试,不用在浏览器和对话框之间来回切。
环节 4:Documents 插件批量处理测试文档
测试文档长期滞后是通病。用 Documents 插件批量解析、整理各类测试文档,比人肉复制粘贴快得多。
环节 5:联动 Notion、Chrome 插件
把测试信息、用例、报告在团队内流转共享,不用再手动搬运。
环节 6:桌面自动化辅助手工测试
有些手工测试场景,靠桌面自动化能力辅助落地,能省掉大量重复点击。
环节 7:MCP 工具联动,打通全链路
这是整套流程里含金量最高的一环。Codex 通过 MCP 协议直接联动主流测试工具:
Codex 在这里是调度中心,串联起原型、接口、页面、数据库,测试工程师不用在一堆工具之间来回切换。
四、真正拉开差距的:把团队能力封装成 Skill
工具会用只是基础。更进一步,是把团队反复执行的测试动作封装成 Skill。
把团队反复执行的测试动作封装成可复用能力。
我们做了几件事:
• 手写测试专用 Skill; • 针对业务流程开发自定义 Skill; • 引入第三方成熟 Skill 融入项目; • 借助 playwright-cli 增强自动化能力,把 Playwright 能力封装成可复用 Skill。
一次开发,全团队复用。
通用动作沉淀成 Skill 之后,Codex 就不再是通用 AI,而是适配你们业务、适配你们测试流程的专属测试 Agent。
五、团队协同与经验沉淀
最后一块拼图,是让经验留下来。
• 对接飞书,打通团队协同链路,用例、报告在团队内流转; • 用 agents.md 固化团队测试规范:评审标准、回归要求、缺陷分级规则写进 Agent 规则; • 依托 Codex 记忆管理,沉淀历史用例、线上 Bug、踩坑经验、回归案例。
项目积累越多,记忆库越丰富,后续同类需求的测试工作就越省心。
六、落地效果
这次落地测试覆盖了正向、边界、异常、对抗风险。
但比数字更重要的是:测试工程师终于不用在“读需求、写用例、调脚本、切工具、补文档”之间来回切换了。
七、Codex 会不会取代测试工程师?
不会。
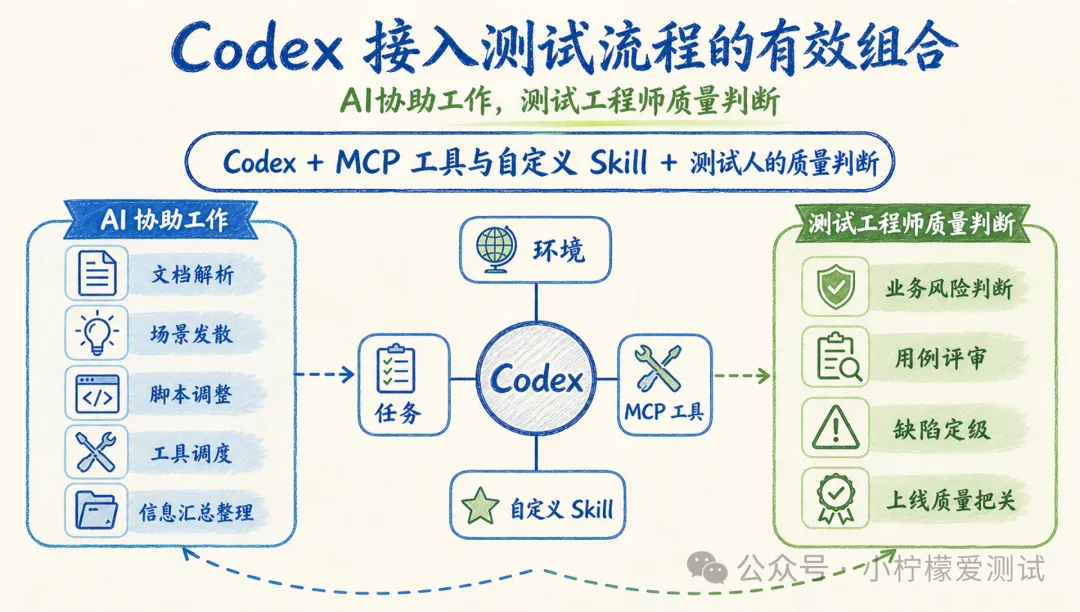
真正有效的公式是:
Codex 测试落地的有效组合
AI 负责:文档解析、场景发散、脚本调整、工具调度、信息汇总整理。
Codex 作为统一载体,串联环境、任务、MCP 工具、自定义 Skill。
而业务风险判断、用例评审、缺陷定级、上线质量把关,依旧必须由专业测试工程师完成。
会不会让 Codex 生成几行自动化脚本,并不是最关键的。
关键是:你能不能把 AI 接入完整的软件测试流程,把重复繁琐的工作释放出去,最终落地成更全面的测试覆盖、更稳定的回归能力、更低的线上漏测风险。
八、最后
我们踩过的坑、配好的环境、写好的 Skill 模板、agents.md 规范,都整理进了一份【Codex 测试落地手册】。
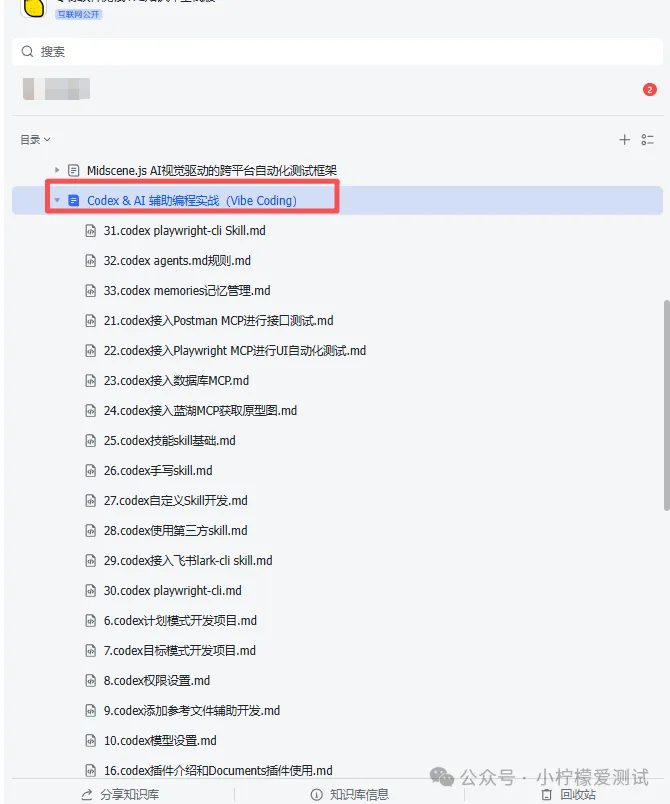
包括:
• Codex + cc-switch 环境搭建与权限边界配置; • 计划模式/目标模式的任务拆解模板; • 测试 Skill 封装示例; • Postman / Playwright / 数据库 / 蓝湖 MCP 对接说明; • 团队测试规范 agents.md 模板。
别让 Codex 停留在“帮你写几行脚本”的阶段。
把它接进流程,你才会发现:测试人真正的价值,从来不是敲脚本,而是设计覆盖策略和判断质量风险。