ARTICLE · 1278324
从 0 到 1 学 Codex 源码:一轮对话,到底是怎么发生的?
经过前几篇文章,我们已经认识了 Rust 的基本语法,也对所有权与借用有了初步理解。读到一段代码时,我们开始知道该留意什么:数据怎样组织,怎样在函数之间传递,又由谁持有和使用。这些认识,已经足够支撑我们迈出阅读 Codex 业务源码的第一步。
前两篇侧重 Rust 基础和语法阅读,第三篇进一步讲了所有权。需要回顾时,可以从这里返回:
《Rust 基础(一)》:从编译运行开始,认识变量、函数、结构体、枚举等基础写法。 《顺着 main,摸清 Codex 的启动骨架》:结合入口代码,理解属性、可见性、闭包和 async move。《理解所有权与借用》:理解数据由谁持有,什么时候发生转移,以及怎样通过借用访问它。
后面遇到暂时看不懂的语法,可以随时回到这几篇查阅,再带着具体问题继续读。我们先顺着业务流程弄清楚代码在做什么,遇到影响理解的语法和所有权细节,再停下来补上。
从这一篇开始,我们正式进入 Codex 的业务源码。第一站,就选在平时使用 Codex 时离我们最近的地方:聊天窗口里的一轮对话。
我们平时使用 Codex,往往只输入一句话:
帮我定位这个项目中失败测试的原因,做一个尽量小的修复,并重新运行相关测试。
接下来,它可能先读文件,再跑测试,接着修改代码、重新验证,最后告诉我们改了什么。中间还会陆续出现解释文字、命令输出和文件修改记录。
一句请求,为什么能带出这么多动作?测试失败后,Codex 怎样根据结果继续处理?又在什么时候,才算结束了这一轮工作?
要顺着源码回答这些问题,我们先认识三个与日常使用直接对应的概念:
- Thread(会话)
:我们在哪条聊天里持续讨论和工作。 - Turn(轮次)
:Codex 当前正在推进的这一轮工作,从开始处理到结束。 - Item(条目)
:这一轮里发生的一条消息或一次活动,例如助手回复、命令执行、文件修改。
把这三个概念放回熟悉的使用场景,我们就有了阅读入口。接下来,沿着一条用户输入往里走,看看 Codex 怎样请求模型、执行工具、收回结果,再决定继续还是结束。这个不断推进任务的过程,就是本篇要理解的 Agent 循环。
我们会先把一轮工作从启动到收尾完整走通,再看中途补充要求、等待回复和停止会怎样改变它,最后回到聊天窗口,解释这些内部过程怎样成为我们看见的 Item。
全文用同一个小任务贯穿:一个分页函数把 20 条数据、每页 10 条,算成了 3 页。我们希望 Codex 找到原因,保持函数接口不变,修复后验证测试通过。
示例中的错误实现很短:
pub fn page_count(total: usize, page_size: usize) -> usize { assert!(page_size > 0, "page_size must be greater than zero"); if total == 0 { 0 } else { total / page_size + 1 }}问题在非空分支的 total / page_size + 1:有余数时确实需要多一页,但刚好整除时不应该再加一。空数据、整页数据和有余数的数据,正好构成三个测试场景。
阅读说明:本文依据开源 Codex 的固定版本
2f3fb111…,阅读日期为 2026-10-22。分页程序是可复现的教学项目,修复前后的测试结果来自本地运行;文中 Codex 怎样安排阅读、修改和验证,是依据源码组织的教学推演,不是一次真实模型会话的录像。源码链接均固定到该版本,实际客户端的显示方式可能不同。
第 0 章 先看关系:一条会话、多轮工作、多个条目
先把三个词放在一起理解:Thread 是一条持续会话,Turn 是会话中的一轮工作,Item 是这一轮中的一条消息或一次活动。
它们是包含关系:一个 Thread 可以经历多个 Turn,一个 Turn 里面又可以包含多个 Item。我们后面要讲的“采样”,则是这一轮工作中请求模型生成内容的步骤。先分清“工作怎样组织”和“工作怎样推进”,这几个概念就容易放到各自的位置上。
0.1 先把一次修复和一次追问放进同一条会话
假设我们新建了一条聊天,先发送“帮我修复分页测试”。Codex 查看代码、运行测试、修改实现、再次验证,最后说明修复结果。这一整段工作,先记作 Turn T1。
等 T1 结束后,我们继续在这条聊天里追问:“为什么整除时不能再加一?”Codex 结合前面的修复进行解释。这是新的一轮工作,记作 Turn T2。
两轮工作属于同一个 Thread A。而 T1 中的用户请求、助手说明、测试命令、文件修改等,分别构成这一轮里的 Item。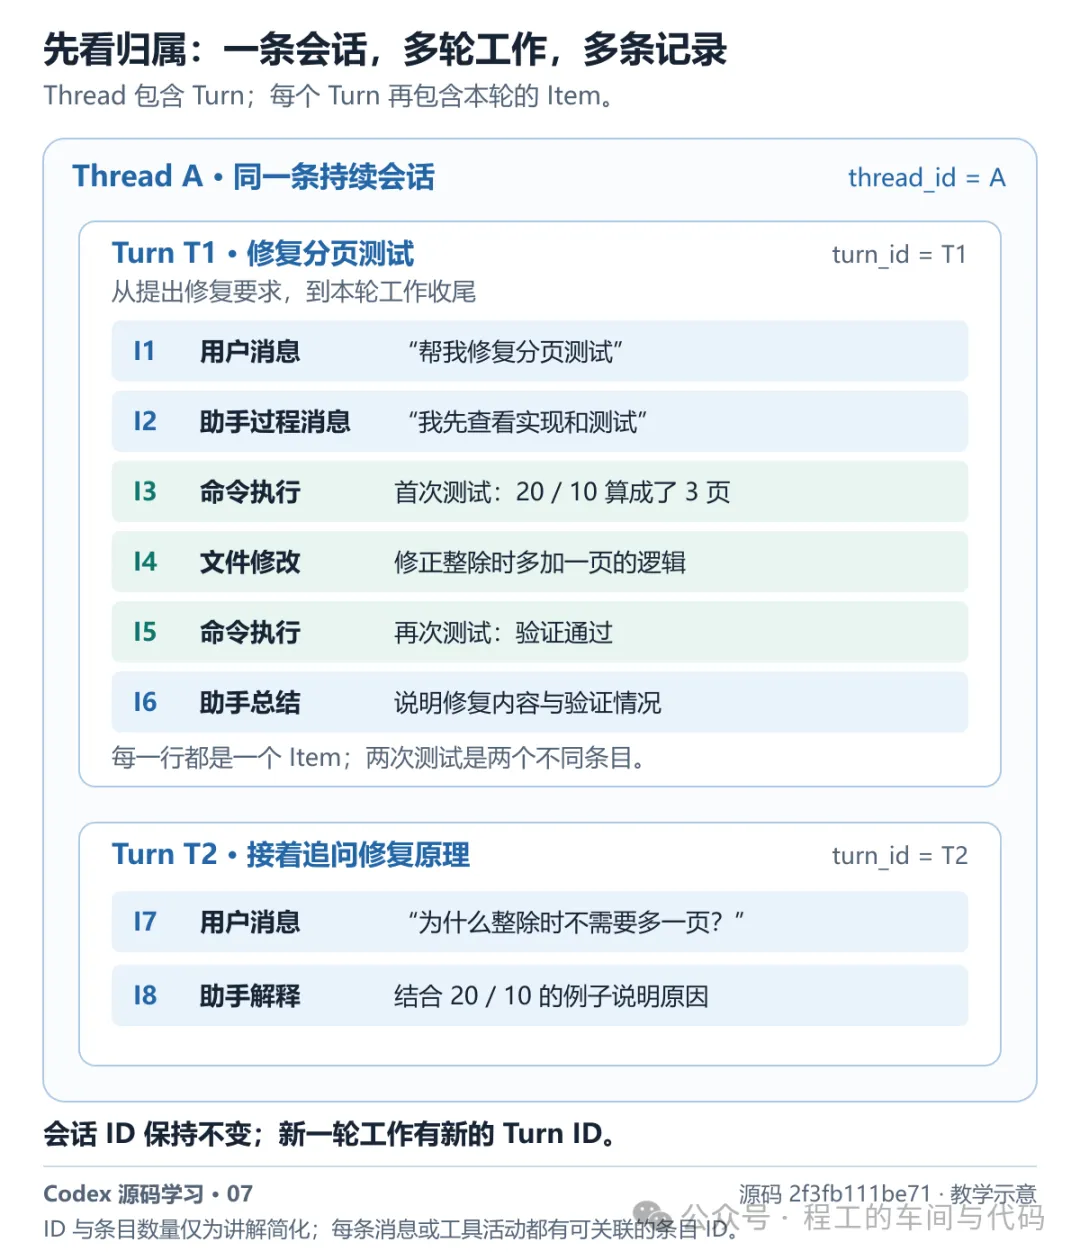
图 1:先看包含关系。外层是同一个 Thread,里面是先后发生的 T1 和 T2,各轮次再包含自己的 Item。A、T1、I1 等是便于讲解的示意 ID;图中省略了推理等其他可能出现的条目。
读这张图时,可以逐层问三个问题:
- Thread:这些工作属于哪条会话?
两次请求都在 A 里,追问时能够接上前面的修复背景。 - Turn:这一轮工作从哪里开始,到哪里结束?
修复与验证属于 T1;等它结束后发起的解释请求属于 T2。 - Item:这一轮里具体发生了什么?
一条用户消息、一次测试命令、一条助手总结,都有各自的条目。
这层关系在 Rust 结构体里也能直接看到。下面只保留 id 和列表字段,其他字段、属性与注释暂时省略:
pub struct Thread { pub id: String, pub turns: Vec<Turn>,}pub struct Turn { pub id: String, pub items: Vec<ThreadItem>,}Vec<Turn> 是轮次列表,Vec<ThreadItem> 是条目列表。我们学过的“结构体加集合”,在这里正好用来表达会话的层次。Thread 定义 Turn 定义
这里展示的是协议对象的结构关系。具体接口可能只返回会话摘要,或者只加载部分轮次、条目;看到列表为空,要先看接口的加载约定,不能据此认定没有历史。
0.2 Thread:有身份、能延续的会话,不是长连接
“Thread 是 Codex 服务启动后管理的长连接”,这个理解容易把会话对象和通信通道混在一起。
连接负责让客户端和服务端传递请求与事件;Thread 则回答“这些输入和工作记录属于哪一条会话”。在 app-server 这条路径中,客户端通过 thread/start 创建会话,拿到 thread.id;之后发起工作时,用这个 ID 指定要在哪条会话里进行。一个服务进程可以管理多条 Thread,它们并不各自等同于一条网络长连接。会话管理
可以用一个更贴近日常使用的场景来理解:今天关掉客户端,明天重新打开昨天的聊天。对于已经保存了记录的会话,thread/resume 可以根据原来的 ID 恢复会话。这里延续的是会话身份和历史,不要求昨天那条连接一直活着。会话恢复参数
因此,先把 Thread 理解成一条有独立 ID、能够继续工作的聊天会话就够了。cwd、status、turns 等字段进一步描述它的工作目录、状态与轮次记录。这里的 thread 也不是操作系统中的线程。Thread 定义
0.3 Turn:通常由一次发送发起,但包含随后的一整轮工作
在会话空闲时,发送一条请求,通常会开始一个新的 Turn。所以从使用体验出发,把 Turn 理解成“我发起的一轮对话”是可以的;还要补上后半句:这一轮包括 Codex 随后持续处理请求的整个过程。
例如,T1 从接受“修复分页测试”开始,中间可以多次请求模型、运行多个工具、输出多段文字,直到这一轮完成、中断或失败。一次测试命令结束、模型生成完一段文字,都不代表 T1 已经结束。Turn 状态
“每按一次发送,就一定新建一个 Turn”则不够准确。假设 T1 还在运行,我们补充一句“保持函数接口不变”,并通过 turn/steer 把它追加到当前工作中,这份输入仍然属于 T1。也有输入被排队、留到下一轮处理的情况,具体要看提交方式和运行状态。第 6 章再展开这些分支。运行中追加输入
所以,判断轮次时,要看这一轮工作是否已经结束、后续输入被交给了哪一轮,不能只数用户发了几条消息。
0.4 Item:一条可识别的消息或活动,不是一次采样
Item 可以先理解成这一轮工作中的“过程条目”。在面向客户端的协议里,对应类型叫 ThreadItem,它用枚举区分不同种类的消息和活动。ThreadItem 定义
把 T1 中的几个条目对应到源码,区别就很具体了:
- 示例条目
:I1;具体发生了什么:用户发送“帮我修复分页测试”; ThreadItem变体:UserMessage - 示例条目
:I2;具体发生了什么:助手说“我先查看实现和测试”; ThreadItem变体:AgentMessage - 示例条目
:I3;具体发生了什么:运行测试,得到失败结果; ThreadItem变体:CommandExecution - 示例条目
:I4;具体发生了什么:修改分页函数; ThreadItem变体:FileChange - 示例条目
:I5;具体发生了什么:再次运行测试,得到通过结果; ThreadItem变体:CommandExecution - 示例条目
:I6;具体发生了什么:助手说明修复与验证情况; ThreadItem变体:AgentMessage
这里有两个值得留意的细节。
首先,用户输入本身也是 Item。I1 在模型开始生成之前就已经进入这一轮,因此 Item 显然不能用来表示“每轮采样流程”。同样,过程说明 I2 和最后的总结 I6 都是助手消息,只是在本轮中承担的作用不同。
其次,同一个 Item 可以持续更新。I3 从开始执行到返回测试结果,仍然可以是同一个命令条目;I2 的文字逐段显示时,也是在更新同一条助手消息。消息增量通知中的 item_id 指向要更新的条目,delta 携带新增文本,不是每来一小段文字就新增一个 Item。增量通知
这一章先讨论客户端协议里的 ThreadItem。后面读到面向模型的 ResponseItem 时,还会看到另一套表示;两者有转换关系,不能仅凭名字里都有 Item 就当成同一种对象。
0.5 采样:在同一个 Turn 中,让模型决定下一步
现在再把采样放进来。本文说的“一次采样”,是运行时带着当前上下文,请求模型进行一次生成的步骤。模型可能生成解释文字,也可能提出工具调用;真正执行命令、修改文件、收集结果的是运行时。模型输入构造 输出项与工具分发
还是看 T1。假设第一次采样中,模型先说“我先查看实现和测试”,接着提出运行测试的调用。客户端就可能看到两个不同的条目:助手消息 I2,以及命令执行 I3。其中 I3 的执行状态和命令输出,由运行时在执行工具的过程中更新。一次采样与一个 Item,在这里就没有一一对应关系。
等运行时把测试结果记入历史,下一次采样才有依据判断怎样修改。修改工具返回结果后,可以继续请求模型安排验证;验证结果回来后,再请求模型组织总结。这些步骤都可以发生在同一个 T1 中。
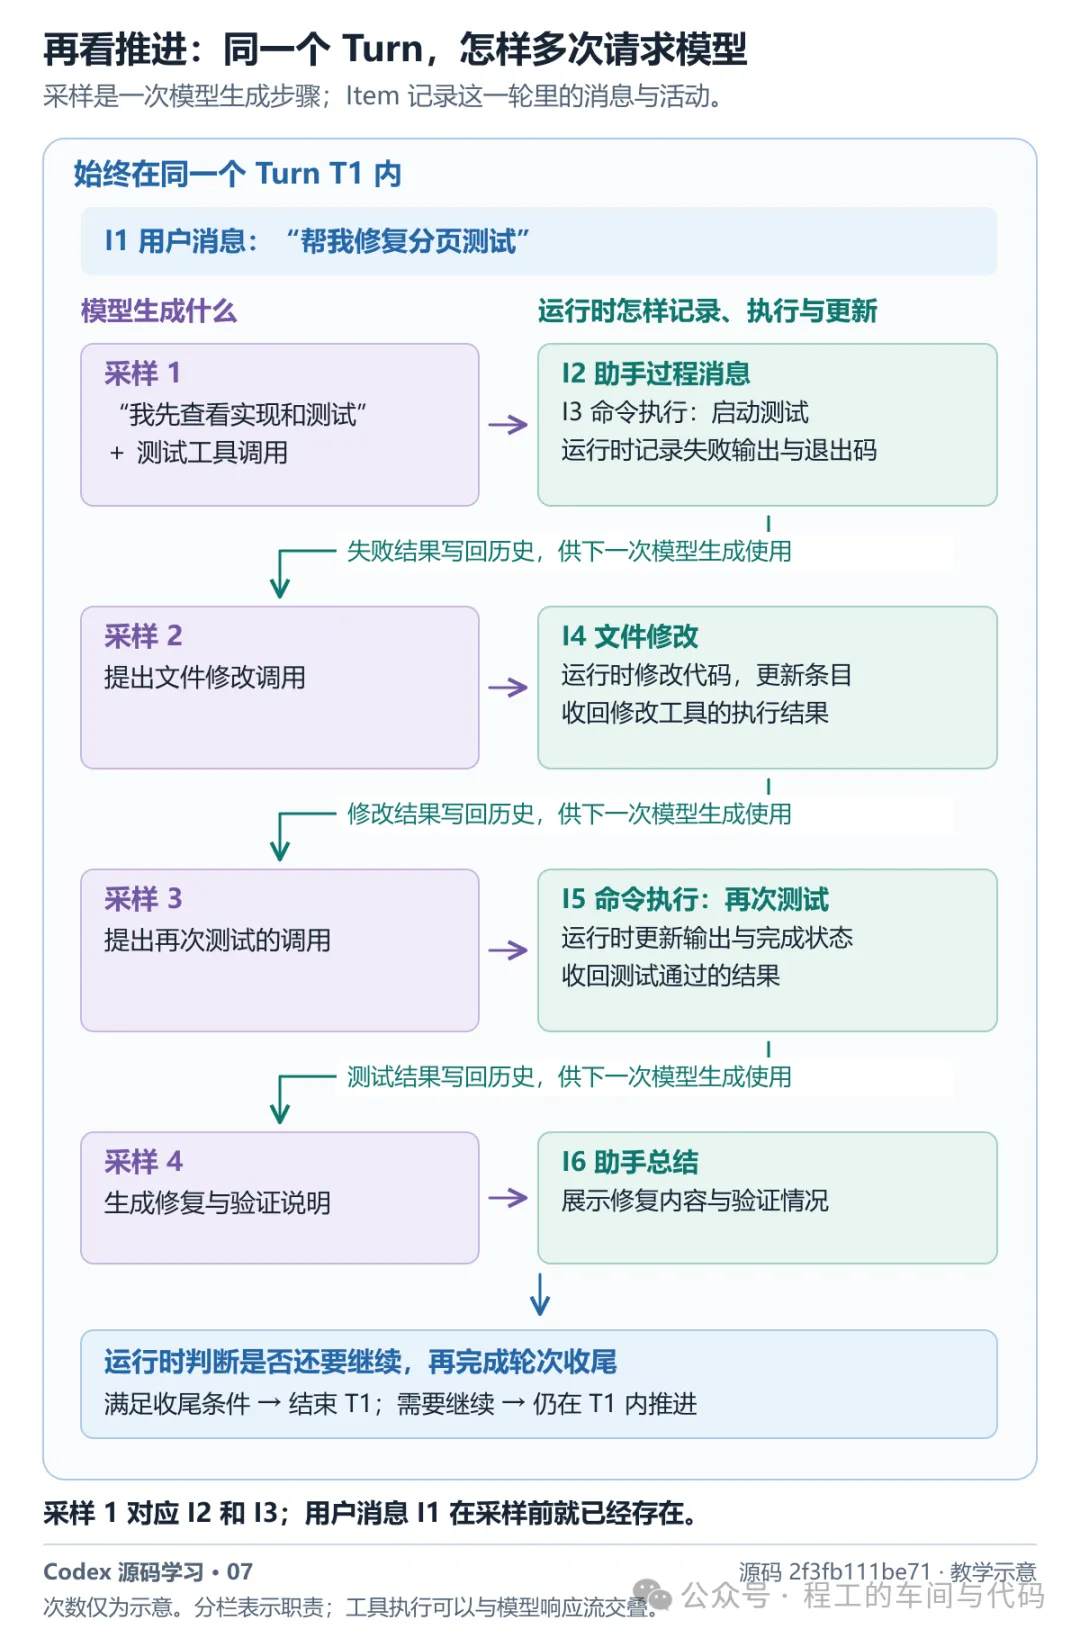
图 1b:按时间展开 T1。模型生成与运行时执行分开呈现;采样 1 可以带来 I2 和 I3,后续采样再根据工具结果继续推进。图中的四次采样和条目安排仅为教学示意,真实任务可能合并动作,也可能执行更多步骤。
看到这里,可以把四个概念连成一句话:在同一个 Thread 中,Codex 开始一个 Turn,通过一次或多次采样与工具执行推进工作,期间产生或更新多个 Item,最后再判断这一轮能否结束。
接下来要追的就是:这些对象由谁管理,用户输入怎样送进来,又是谁让这一轮工作持续运转。
第 1 章 协议对象背后,谁保存状态,谁执行任务
Thread、Turn、Item 很适合给客户端描述进展,但它们本身不会执行测试。真正工作时,还需要持有状态的对象、接收操作的通道,以及能够被调度的任务。
在 Core 中,CodexThread 的开头有两个关键字段。下面只摘出这两个字段:
pub(crate) session: Arc<Session>,pub(crate) io: SessionIo,session 指向核心会话;io 提供与它交互的通道。SessionIo 中又能看到:
pub(crate) tx_sub: Sender<Submission>,pub(crate) rx_event: Receiver<Event>,名字里的 tx 表示发送端,rx 表示接收端:向内提交操作,向外接收事件。用户输入和中断等操作从前一个方向进去,文字、工具进展和结束信息从后一个方向出来。CodexThread SessionIo
这里讨论的是与一条核心会话交互的操作与事件通路。对外的 turn/start、turn/steer 等接口表达不同提交意图,进入 Core 后再按相应规则处理;不能由这一组通道推导出整个 Codex 只有一个接口或一条通信通道。
Session 则持有会话运行所需的状态。在它的定义里,我们会遇到:
pub(crate) active_turn: Mutex<Option<ActiveTurn>>,这行值得按业务拆开读:Option 表示当前可能没有活动轮次;有的话,里面放着 ActiveTurn;Mutex 用来协调多个异步任务对这份共享状态的访问。这里使用的是 Tokio 的异步锁,取得锁时可以 .await,并不意味着把整个 Agent 的所有工作都锁死。Session 与活动轮次
前面的 Arc<Session> 解决另一个问题:多个地方可以共同持有同一份 Session。后面看到 Arc::clone(&sess),应理解成增加一个指向同一对象的共享句柄,而不是复制一整段聊天记录。共享持有和协调修改是两件事,所以 Arc 和 Mutex 经常同时出现。Rust 的 Arc 文档
普通用户任务由 RegularTask 承担。它不是模型,而是负责驱动这一轮工作的 Rust 任务实现。它调用 run_turn,后者组织模型请求和工具循环。ActiveTurn 中则保存运行任务、取消令牌等信息,让会话能找到并控制正在进行的工作。RegularTask 活动任务结构
这些名字不用一次背下来,先形成一张职责表:
- 对象
:协议中的 Thread / Turn / ThreadItem;先按什么理解:对外描述会话、轮次和过程 - 对象
: CodexThread;先按什么理解:与一条核心会话交互的入口 - 对象
: Session;先按什么理解:持有历史、活动轮次、输入队列等运行状态 - 对象
: ActiveTurn/RunningTask;先按什么理解:记录当前正在运行什么,以及怎样取消 - 对象
: RegularTask;先按什么理解:驱动普通用户任务执行 - 对象
: TurnContext/StepContext;先按什么理解:为一轮工作及其执行步骤提供所需上下文
这个版本的 Session 明确按“至多一个运行任务”管理活动工作。但一项任务内部仍然可以有流式处理和工具并发;不能从“一个活动任务”推导出“所有事情都逐条串行”。
第 2 章 点击发送之后,输入先被接受,再开始推进
2.1 Core 根据提交模式和当前状态受理输入
提交模式规定允许做什么,当前运行状态决定这次提交能否成立。
我们选择 app-server 的 turn/start 作为入口。用户提交分页修复要求后,app-server 调用 Core 的 start_or_steer_turn,以允许启动或追加的模式提交输入。在 core/src/session/turn_input.rs 中,处理函数首先按模式分流。下面省略了仅允许空闲启动等其他分支:
let result = match mode { TurnInputMode::StartOrSteer => start_or_steer(session, request, submission_id).await, // …省略 StartIfIdle、ContinueIfIdle 分支… TurnInputMode::Steer { expected_turn_id } => { steer(session, request, expected_turn_id, submission_id).await }};源码:app-server 提交入口 源码:按模式分流
这里已经能看到两种约束:StartOrSteer 允许启动或追加;Steer 还携带 expected_turn_id,要求输入进入指定的活动轮次。二者随后都会检查运行状态,但允许选择的结果不同。
再看 start_or_steer:它先调用 steer_input 尝试追加,随后区分三类结果。源码:启动或追加的实际分支
- 检查结果
:追加成功;源码里的处理:返回 TurnInputSubmission::Steered;对这份输入意味着什么:使用已有 turn ID,交给正在运行的工作 - 检查结果
: NoActiveTurn;源码里的处理:通过启动检查后调用spawn_task(..., RegularTask::new());对这份输入意味着什么:建立新轮次并启动任务 - 检查结果
:其他不满足条件的原因;源码里的处理:返回 TurnInputSubmission::NotSubmitted;对这份输入意味着什么:本次输入没有被接受
这里有两个容易读反的关系。先尝试追加,不等于一定在运行中;只有确认没有活动轮次,才进入启动路径。 而无法追加也不总能改为启动:例如当前任务不允许 steer,会返回对应原因。显式 Steer 的处理更严格,追加失败就返回未提交,不会转去创建新轮次。源码:显式 steer 的结果处理
本章先走会话空闲时启动新轮次的主线。输入通过路由检查后,会建立运行上下文并启动 RegularTask。对调用方来说,拿到的是“这份输入被接受成了哪一轮”的结果,运行中追加的消费过程留到第 6 章。
提交成功,只证明输入已被受理。 这个版本的正常 turn/start 回复可以是 inProgress,items 暂为空;修复过程由任务继续推进,通过通知陆续发出。因此,受理判断由 Core 的运行时代码完成,具体怎样修复则要等后面的模型生成与工具执行。
2.2 一条操作通道,加一条单次回复通道
再往里读,会看到 submit_turn_input 创建了一个很小的通信工具:
let (reply_tx, reply_rx) = oneshot::channel();oneshot 是用于一次回复的通道。提交方把 reply_tx 放进 Op::TurnInput,自己保留 reply_rx。操作经过 Submission 送入提交队列后,Core 的 submission_loop 取出它,处理输入路由,再通过发送端把结果回给等待方。输入提交 操作处理
我们可以把这段通信读成:
提交方:这是用户输入,请处理;处理结果发到 reply_tx。Core:根据提交模式和当前状态受理输入,返回这次路由的结果。提交方:从 reply_rx 收到结果,继续完成接口回复。提交函数末尾是下面这段。这里省略 Submission 的构造字段,只看先提交、再等回复的顺序:
self.submit_with_id(Submission { // …省略构造字段…}).await?;reply_rx.await.unwrap_or(Err(CodexErr::InternalAgentDied)).await 的意思是等待异步计算准备好结果。没准备好时,当前异步任务可以让出执行机会;不是卡住整个进程,也不是这一行自动另开一个线程。.await? 再加一层错误传播:等到 Result 后,成功就取出值,失败则向当前函数的调用方返回错误。Rust 异步基础
最后一行等待的是路由回复,不是分页修复的最终结论。unwrap_or 在这里为通道断开提供错误值,也不是直接调用 unwrap() 导致 panic。输入一旦提交,调用方不再等待回复,也不代表已经排进去的输入自动撤销。源码注释专门提醒了这个区别。
2.3 执行与进展,各自继续往前走
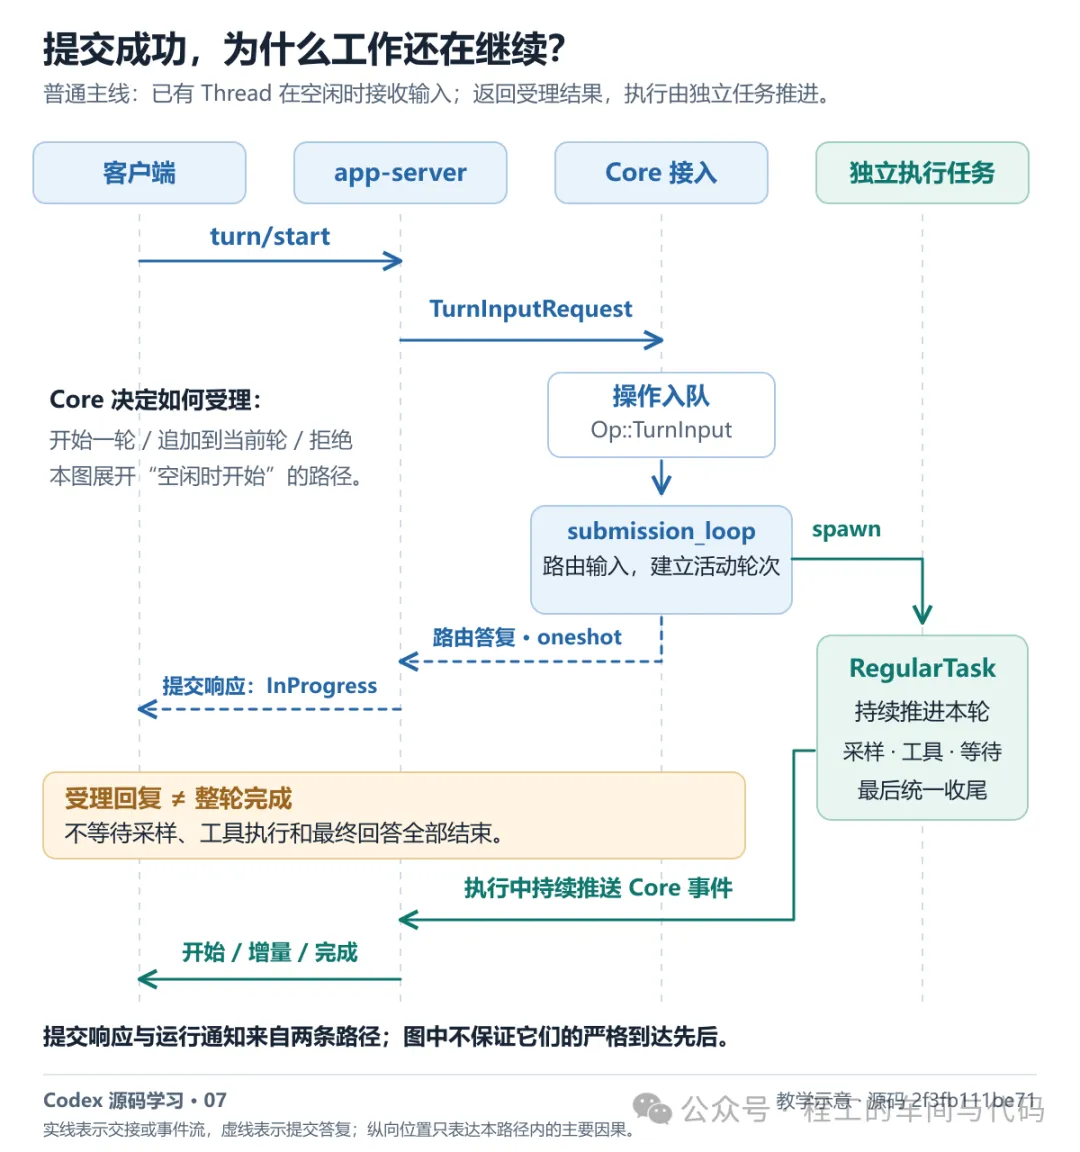
图 2:左侧文字概括受理规则,箭头只展开 turn/start 在会话空闲时启动新任务的路径;运行中追加输入不会沿图中的 spawn 再启动一个任务。接口回复确认输入归属,独立任务继续执行并产生事件。图中不承诺回复与通知到达客户端的严格先后次序。
spawn_task 把执行工作交给 Tokio 的异步任务。与 .await 相比,tokio::spawn 才是在这里显式提交独立异步任务的动作;它们可以并发推进,但不保证每项任务独占一个操作系统线程。任务启动 Tokio 的 spawn 文档
普通任务启动后,RegularTask 发出开始事件,再进入 run_turn。我们截取循环的开头:
loop { let last_agent_message = run_turn( Arc::clone(&sess), Arc::clone(&ctx), next_input, &mut mcp_startup_requirements, prewarmed_client_session.take(), cancellation_token.child_token(), ) .instrument(run_turn_span.clone()) .await?;这只是局部摘录,后面还有终态错误和待处理输入检查,不是无条件永远循环。&mut 表示可变借用;这里的 .take() 从一个 Option 中取出已有值,并在原位置留下 None;instrument(...) 附加运行追踪信息,初读时可以先跳过。RegularTask 的执行循环
另一个容易误读的地方是函数名:再次进入 run_turn,不一定意味着协议上新建了一个 turn。外层仍然可以持有同一个轮次上下文。协议中的轮次边界,要看运行时怎样创建和结束它,不能只数某个函数被调用了几次。
现在,我们已经知道输入怎样交给一个能够独立推进的任务。接下来先进入它调用的 run_turn,沿着第一次模型请求往下看:为了让模型提出行动,运行时要先准备哪些信息?
第 3 章 任务已经启动,模型怎样提出第一步行动
上一章中,用户请求已经被接受,RegularTask 也开始执行了。但运行任务本身还不知道分页函数错在哪里,更没有一套预先写好的修复步骤。接下来,它需要把已有信息交给模型,让模型提出第一步行动。
我们先跟着这份请求走到第一次生成:模型收到什么,又会交回什么?
3.1 把用户请求和已有上下文组织成模型输入
模型不能直接观察我们的本地文件系统。要让它处理“修复分页测试”,运行时需要把用户请求、相关规则和已有上下文组织成它能收到的内容。之后若想让它知道测试失败,也要通过同样的输入路径提供结果。
在 run_turn 的工作循环中,构造采样输入的代码是:
// Construct the input that we will send to the model.let sampling_request_input: Vec<ResponseItem> = async { sess.clone_history() .await .for_prompt(&step_context.settings.model_info.input_modalities)}.instrument(trace_span!("run_turn.prepare_sampling_request_input")).await;先从 Session 获取历史,再通过 for_prompt(...) 准备适合本次模型输入的条目。这里的 Vec<ResponseItem> 是一个条目列表,可以包含用户消息、之前的模型输出以及工具结果。模型输入构造
第一次处理分页任务时,历史中还没有这次测试的结果。模型能依据的是用户的修复要求,以及当前已经提供的项目上下文。等工具运行过后,同一个位置会再次构造输入,只是那时历史里会多出新的依据。
因此,读这段代码时先抓住一个关系:每一步生成,都从当时可用的历史中准备输入。 这里的历史是面向模型整理过的内容,不等于聊天窗口的完整截图,也不保证始终保留未经压缩的全部记录。
读码提示:
async { ... }形成异步计算块,块内最后一个表达式给出结果,外面的.await取得这个结果。instrument(...)附加追踪信息。ResponseItem虽然带着Response这个名字,在这里同样用来组织模型输入;第 7 章再把它和客户端看到的 Item 对照起来。
3.2 请求模型,得到说明文字和可能的工具调用
拿到 sampling_request_input 后,run_turn 调用 run_sampling_request。这条路径再进入 try_run_sampling_request,通过 client_session.stream(...) 请求模型,并读取返回的事件流。采样入口与响应流
本文把运行时组织的这样一次模型生成步骤称为“采样”。我们在这份客户端源码中看到的是请求和响应处理;模型服务端怎样逐 token 计算和选择输出,不在本篇展开。
回到分页任务,假设模型先输出“我先查看实现和测试”,接着提出运行相关测试的工具调用。前一句是解释文字,后者则是带有工具名称、参数和调用标识的结构化输出。两者都来自这次生成,但交给运行时后,会进入不同的处理路径。
此时,我们已经完成了第一段交接:用户的修复要求被组织成模型输入,模型根据这些信息提出了一个具体操作。不过,提出运行测试,还需要运行时真正把测试执行起来。 下一章就沿着这一个工具调用继续往下走。
第 4 章 模型提出的操作,怎样变成下一步的依据
现在模型已经提出运行分页测试。要让这份输出推动修复,Codex 需要完成两件事:把调用交给具体工具执行,再把工具得到的结果带回来。我们先追到测试失败的信息进入历史,看看一次行动怎样产生新的依据。
4.1 从响应流里识别一个完整的工具调用
工具调用的参数也可能随着响应流逐步到达。在这里的普通工具路径中,运行时会等相应输出项完整后,再交给 handle_output_item_done 处理,其中通过 ToolRouter::build_tool_call(item.clone()) 尝试构造工具调用。输出项处理
识别结果决定后续走向:如果得到工具调用,就进入工具路径;如果这个输出项只是消息,则按消息处理;如果识别或参数转换失败,则进入相应的错误处理。
读码提示:返回类型
Result<Option<ToolCall>, FunctionCallError>表达了这两层判断。Ok(Some(call))表示成功识别出调用,Ok(None)表示处理没有报错、但该项不是工具调用,Err(...)表示处理出错。看到Ok(None),不能据此判断模型没有输出。
进入工具分支后,运行时先用 record_completed_response_item(...) 把模型提出的完整调用记入历史,再安排执行。这样,之后的历史能够保留“提出了什么操作,以及操作返回了什么”的关联。工具分发
在分页例子中,这一步记录的是“模型请求运行测试”。真正创建进程、访问项目文件并收集命令输出的工作,还要由对应的工具实现完成。工具注册、权限与沙箱会在后面的工具篇展开;这里先沿着调用和结果把路径接起来。
4.2 分发工具,同时留下后续处理需求
执行工具与要求后续生成,是工具分支同时安排的两件事。 把这两件事一起看,才能解释为什么工具调用会推动 Agent 循环。
在 stream_events_utils.rs 的工具分支中,先记录调用,再构造 tool_future,最后有两行关键赋值:
output.needs_follow_up = true;output.tool_future = Some(tool_future);源码:工具分支的返回内容
第二行交出等待工具结果的 future;第一行则告诉上层:这次生成之后还有后续处理需求。标志在这里就已经设为 true,并没有等待测试通过才置位。 对分页任务来说,测试成功或失败都会产生值得模型继续处理的信息。
普通路径可以在完整调用到达后立即分发工具,此时整段模型响应流未必已经结束。执行与后续事件读取可以重叠,但工具是否允许并行还受运行时规则约束。工具运行时
响应处理器收到工具分支的返回结果后,再做一次汇总:
if let Some(tool_future) = output_result.tool_future { in_flight.push_back(tool_future);}if let Some(agent_message) = output_result.last_agent_message { last_agent_message = Some(agent_message);}needs_follow_up |= output_result.needs_follow_up;源码:登记结果并累积继续标志
这里要分别追踪三个值:
in_flight:登记待收集的工具结果,供后面的 drain_in_flight使用。last_agent_message:保留助手消息内容;有一段完整文字,不自动表示任务可以结束。 needs_follow_up:累积本次采样中的继续需求。 |=是布尔“或”,前面已经是true,后面一个不要求继续的输出项不会把它清掉。
于是,哪怕同一次生成中既有“我先运行测试”这段说明,又有测试调用,消息内容和工具的继续需求仍然分别保留下来。第 5 章会接着追这个标志怎样进入外层判断。
读码提示:
push_back只登记等待结果的 future,不是工具开始执行的唯一时点。这里的handle_tool_call是普通fn,普通路径先在内部通过tokio::spawn启动工具任务,再返回等待结果的 future;延后分发路径才把调用包在async move中。阅读时应同时看函数签名和调用位置,不能仅凭返回了 Future 就认定“现在什么都还没发生”。
4.3 收回测试输出,写入后续生成会使用的历史
现在测试真正执行了。配套分页示例的本地记录中,关键失败信息是:
test tests::exact_page ... FAILEDassertion `left == right` failed left: 3 right: 2test result: FAILED. 2 passed; 1 failed测试结果、退出码和复现方式整理在配套的 验证摘要 中;摘要保留原记录的验证日期,并移除了本机路径。这个结果说明整页场景的断言失败;对于“修复分页测试”的任务,它恰好提供了继续定位所需的证据。
测试在本机跑完,模型还不会自动知道结果。把结果交回来的关键动作发生在 drain_in_flight:运行时收集工具结果,再把它们记入历史。下面摘录成功收集结果的分支,省略了结果来源标记处理和错误分支:
while let Some(res) = in_flight.next().await { match res { Ok(envelope) => { // …省略结果来源标记处理… sess.record_annotated_conversation_items( turn_context, &step_context.settings.model_info, vec![envelope], ) .await; } // …省略错误分支… }}这段代码持续取得结果,再把结果交给记录函数。这里的 Ok(envelope) 表示成功收集到了工具返回内容;内容里仍然可以是刚才那份失败测试输出。工具结果可被正常收回,和业务测试是否通过,是不同的判断。工具结果回填
读码提示:
while let Some(res) = ...表示持续取得队列项,直到没有下一项。vec![envelope]构造只包含当前结果的列表。这里使用的FuturesOrdered按入队顺序提供结果,它约束收集顺序,并不要求工具都串行执行。
响应流读完后,还要收回当前采样步骤等待的工具结果。try_run_sampling_request 在退出流读取循环后,还有下面的处理。摘录省略了计时、通知和取消检查等代码,只看结果收集与返回的顺序:
if !in_flight.is_empty() { // …省略计时与追踪… drain_in_flight(&mut in_flight, sess.clone(), &step_context).await?;}// …省略通知与取消检查等后续处理…outcome源码:流读取结束后的收集与返回
outcome 保存的是流读取循环得到的结果。这里先 await 工具结果收集,再返回它,所以模型响应完成事件与整个采样步骤返回,并不是同一个执行点。await? 还表示收集过程的错误会向上传递,不会无条件当成成功继续。
正常走完这段路径后,历史中已经同时有了测试调用,以及“实际为 3、预期为 2”的输出。回填改变的是后续请求可用的上下文,不是已经发出的旧请求。
下一次请求模型时,这些内容就能成为判断依据。但还有一个动作没有解释:是谁决定再发起一次模型请求? 把结果记下来,只解决了下一步有什么依据;要让修复继续推进,还得回到外层的工作循环,看它怎样决定继续或结束。
第 5 章 有了新依据,谁让这一轮继续,又怎样结束
第 4 章解决了结果怎样回到历史。现在要补上控制上的另一半:哪些状态会让运行时再次请求模型,哪些条件允许它退出?
在之前的 《Agent 怎么知道任务做完了?答案是:它不知道》 中,我们讨论过一个判断:模型提供信号,包在模型外面的运行时决定是否继续。本章沿着具体变量和分支,把这个判断落到 Codex 的实现上。旧文使用的是 ac192cd,以下代码仍以本篇的 2f3fb111… 为准。
先记住后面要核对的三个层次:采样步骤汇总继续需求,run_turn 决定继续或进入收尾,任务层处理退出与终态。 三层都和“结束”有关,但每层检查的条件不同。
5.1 needs_follow_up 汇总的是继续需求,不是任务完成度
needs_follow_up 回答“还有没有后续处理需求”,不直接回答“用户目标完成了没有”。 这个区别可以从它的产生位置看出来。
第一处:工具路径先留下继续需求。 每次采样的响应处理开始时,局部变量初始化为 false;第 4 章的工具分支会把自己的 output.needs_follow_up 设为 true,响应处理器再通过 |= 累积它。标志初始化 工具路径 标志累积
这里没有读取“分页测试通过没有”来决定是否置位。工具执行带回了需要后续处理的结果,就需要让模型再看到它。甚至某些需要回给模型的工具错误,也会被写入历史并留下继续需求。工具错误回填
因此,多个工具调用可以共同留下一个布尔值 true,它不是工具计数器,也不表示每个调用必须分别追加一次采样。
第二处:响应结束时,再吸收协议带回的信号。ResponseEvent::Completed 包含 end_turn: Option<bool>。在 session/turn.rs 的响应结束分支,相关代码是:
if let Some(false) = end_turn { needs_follow_up = true;}break Ok(SamplingRequestResult { needs_follow_up, last_agent_message,});源码:响应结束时的继续判断
这里最值得细读的不是变量名,而是赋值只发生在 Some(false) 分支中:
end_turn的值: Some(false);这段代码做什么:将needs_follow_up设为true;对已有继续需求的影响:明确增加继续需求end_turn的值: Some(true);这段代码做什么:不执行这个赋值;对已有继续需求的影响:不会清除工具等路径已有的trueend_turn的值: None;这段代码做什么:不执行这个赋值;对已有继续需求的影响:保留其他路径算出的结果
None 表示没有提供这份明确值,字段注释也要求依赖其他逻辑处理。end_turn = true 不是强制结束整轮的命令,None 也不能直接当作 false。 这里说的是运行时收到的响应信号;不能仅凭字段名,把它理解为对业务完成情况的可靠判断。字段定义
break Ok(...) 退出的是响应流读取循环。它后面仍有第 4 章展示的工具结果收集,随后才把整个采样步骤的结果交回 run_turn。
第三处:工作循环把采样结果与新输入合起来。 在 run_turn 中,返回值被拆开,并与待处理输入共同参与判断。下面摘录两处关键语句,省略中间的邮箱处理和状态收集:
let SamplingRequestResult { needs_follow_up: model_needs_follow_up, last_agent_message: sampling_request_last_agent_message,} = sampling_request_output;// …省略邮箱处理和状态收集…let needs_follow_up = model_needs_follow_up || has_pending_input;源码:采样结果进入工作循环
结构体解构中的冒号是在给字段绑定一个局部名字。因此,model_needs_follow_up 接住的正是前面汇总的那个标志,包含工具路径产生的需求;它不只表示“模型自己说还要继续”。has_pending_input 则让运行中追加的新输入也有机会推动工作。
- 采样步骤要求继续
:是;存在待处理输入:任意;此处合并的结果:继续处理 - 采样步骤要求继续
:否;存在待处理输入:是;此处合并的结果:继续处理新输入 - 采样步骤要求继续
:否;存在待处理输入:否;此处合并的结果:进入收尾检查,尚未直接结束
把这几处代码连起来,就能解释分页例子中的下一步:测试工具留下继续需求,结果被写入历史,run_turn 再次走到 clone_history().await.for_prompt(...)。模型这时才会在新的请求里看到“实际为 3、预期为 2”,并据此判断如何修复。
策略边界:解释文字本身不构成执行承诺。 如果模型只输出“接下来我会运行测试”,没有提出工具调用,也没有其他路径留下继续需求,这句话不会因为语义上带着“接下来”就自动把本节的标志设为
true。普通消息路径记录消息内容;是否再采样,仍要看实际信号与控制分支。普通消息处理
5.2 修改和验证,是带着不同依据重复同一套机制
Agent 循环重复的是执行机制,每次推进所依据的信息则在变化。
沿着我们的教学推演,模型读到失败结果,再结合实现发现问题出在 total / page_size + 1:整除时也无条件加了一页。一个保持原接口和输入前提的修复是:
pub fn page_count(total: usize, page_size: usize) -> usize { assert!(page_size > 0, "page_size must be greater than zero"); total.div_ceil(page_size)}div_ceil 是整数向上取整除法。保持 page_size > 0 这个前提后,0 条数据得到 0 页,20 条得到 2 页,21 条得到 3 页。完整修复和测试保存在配套的 after.rs。
模型要采用这个修复,仍需提出修改工具调用,让工具实际写入文件。随后,修改结果进入历史,继续标志促使运行时再次生成;模型根据修改结果安排验证,测试工具又带回新的输出。配套示例的本地验证记录是 3 passed; 0 failed,测试进程退出码为 0。
- 历史中新增加的依据
:测试失败,实际为 3、预期为 2;模型在后续生成中可以做什么:结合实现定位问题,提出修复 - 历史中新增加的依据
:修改工具返回了写入结果;模型在后续生成中可以做什么:安排测试,检查修改后的行为 - 历史中新增加的依据
:三个场景的测试结果已返回;模型在后续生成中可以做什么:组织修复说明和验证结论
测试全部通过,也不会让前面那条工具分支直接执行“任务成功,退出”。它仍然返回工具结果,后续生成才能据此组织说明。工具结果影响模型的下一步判断,运行时的继续条件控制下一步是否发生。
这是便于讲解的路线,不要求每一行恰好对应一次独立请求。真实任务可以合并动作,也可以补充检查。普通的测试、修改、验证主要在 run_turn 内部的工作循环中推进;函数内部还可能先处理上下文,再进入下一次生成。
读码提示:
run_sampling_request内另有请求重试,用来处理符合条件的传输或流读取错误。它和“模型看见测试失败后继续修复”分属不同层次,不能把采样步骤数、底层请求尝试数、工具调用数当成同一个计数。采样中的重试
5.3 Stop hook 怎样把准备结束的工作送回循环
needs_follow_up == false 只意味着进入收尾检查,Stop hook 仍可以阻止这次收尾。
这就是旧文“提示词可以影响模型,控制分支才能决定是否继续”在源码中的具体落点。Stop hook 是运行时的扩展检查:在准备收尾时执行配置的钩子,将结果交回工作循环。它能提供续跑要求,但不能因此被当成默认就具备的业务验收器。
在 session/turn.rs 中,入口条件和调用是:
if !needs_follow_up { last_agent_message = sampling_request_last_agent_message; let stop_outcome = run_turn_stop_hooks( &sess, &step_context, stop_hook_active, last_agent_message.clone(), ) .await; // …后续消费钩子结果…}源码:进入 Stop hook 检查
这里的顺序很明确:先汇总正常续跑需求,确认没有之后,才尝试收尾检查。 已经有工具或待处理输入要求继续时,不需要先让 Stop hook 再给一次续跑理由。
对于本文的普通用户任务,关键消费路径如下。代码省略了内部记忆整理会话的特殊拒绝分支、邮箱处理和警告发送细节,保留改变控制流的部分:
if stop_outcome.should_block { if let Some(hook_prompt_message) = build_hook_prompt_message(&stop_outcome.continuation_fragments) { sess.record_response_item_and_emit_turn_item( &turn_context, &step_context.settings.model_info, hook_prompt_message, ) .await; // …省略当前轮次的邮箱接收处理… stop_hook_active = true; continue; } else { // …发送警告:没有有效续跑提示,忽略这次 block… }}if stop_outcome.should_stop { break;}源码:钩子结果怎样改变控制流
这段可以沿四个动作读下来:
- 判断是否阻止收尾。
should_block中的 block 阻止的是“本轮结束”,所以它表达的是续跑要求。 - 构造并记录续跑提示。
运行时用 continuation_fragments生成模型能够收到的消息,再写入历史。只有控制流继续、没有新信息,模型仍可能做出相同判断。 - 通过
continue回到工作循环。下一次准备模型输入时,历史里已经包含这份提示。到这里,“要求继续”才真正变成了再次生成。 - 按条件处理无法继续或要求停止的情况。
如果 block 没有生成有效提示,运行时发出警告并忽略这次 block; should_stop则使当前run_turn工作循环退出。
假设我们自己配置一个检查,发现缺少验证记录时返回“请先运行分页测试,再给出结论”。它若产生了有效的 block 和续跑提示,就能走上面这条“记录提示 → continue → 再次生成”的路径。检查什么、依据是否可靠,取决于这个钩子的实现;Codex 提供的是接入检查和改变控制流的机制。 这只是说明扩展点的示例,并不是本篇执行过的配置。
多个钩子给出不同意见时,还需要一个合并策略。在 hooks/src/events/stop.rs 中:
let should_stop = results.iter().any(|result| result.should_stop);let stop_reason = results.iter().find_map(|result| result.stop_reason.clone());let should_block = !should_stop && results.iter().any(|result| result.should_block);源码:多个 Stop hook 的结果聚合
关键是第三行的 !should_stop:只要有钩子要求停止,聚合后的 block 就不会成立。 因而不能只看调用方“先检查 block、后检查 stop”的顺序,就认定续跑优先;优先关系已经在结果聚合时确定了。
stop_hook_active是状态标记,不是自动防死循环的次数上限。 在当前这次run_turn中,block 生效后它被设为true,后续调用钩子时会带上这个状态。Core 没有在这里写出“已经 block 过一次就不再允许”的判断。仓库的stop_hook_can_block_multiple_times_in_same_turn测试断言两次 block 后仍是同一个 turn,三次检查收到的标记依次为false、true、true。这里用的是测试代码的静态证据;重复拦截应怎样收敛,需要钩子自身结合状态与证据设计。连续 block 的测试
如果钩子没有让工作返回循环,也没有提前触发本节的停止分支,后面仍有其他收尾处理,例如兼容的 after-agent hook 和按条件执行的轮末压缩,最后才到正常的 break。这些是生命周期处理,不能被简化成“测试全绿才允许跳出”。后续收尾路径
5.4 run_turn 返回后,RegularTask 还要检查什么
退出内部工作循环,还没有越过任务层的最后一道边界。 现在回到第 2 章只展示了前半段的 RegularTask::run。
它调用 run_turn(...).await? 后,紧接着执行:
// Terminal errors are already reported. Let task completion preserve pending// input instead of restarting the failed turn for that same input.if ctx.terminal_error.lock().await.is_some() { return Ok(last_agent_message);}if !sess.input_queue.has_pending_input(&sess.active_turn).await { return Ok(last_agent_message);}next_input = Vec::new();源码:RegularTask 的退出与再次进入
这里的先后顺序就是任务层的处理策略:
- 先看终态错误。
如果已经记录错误,就让任务结束,不因待处理输入再启动这次失败的运行;剩余输入由任务收尾路径保留。 - 没有终态错误,再看待处理输入。
队列为空就返回;仍有输入则到下一次循环,沿用同一个 ctx再进入run_turn。 next_input = Vec::new()清空的是再次调用时的显式输入参数。它没有删除 pending 队列;新输入仍由前面介绍的队列消费路径处理。任务结束时保留输入
所以,普通的连续采样在 run_turn 内推进;RegularTask 外层循环还会在它返回后检查是否需要接续。同一个上下文被继续使用,不能把再次调用 run_turn 直接算成协议上新建一个 Turn。
还有一个容易漏看的事实:第一个分支明明检测到了 terminal_error,返回的却是 Ok(last_agent_message)。这说明Rust 函数的 Ok、轮次的成功状态、用户目标是否完成,不能互相替代。 错误已经通过生命周期路径记录,这个 Ok 让任务走完相应的结束处理。
任务收尾构造 TurnCompleteEvent 时,会把 terminal_error 放进事件的 error 字段。实时 app-server 则利用已记录到轮次摘要的错误,确定对客户端报告什么状态:
let (status, error, last_agent_message) = match turn_summary.last_error { Some(error) => (TurnStatus::Failed, Some(error), None), None => (TurnStatus::Completed, None, turn_summary.last_agent_message),};源码:Core 终态事件 源码:客户端终态判断
因此,看到 TurnComplete 或收到 turn/completed,首先应理解为“这一轮已经走到终态通知”。还要继续看其中的状态和错误字段;通知名称本身并不保证是成功完成。中断也有自己的处理路径,第 6 章接着展开。
5.5 三种完成边界,为什么都不能代替业务验收
把刚才的控制流放回普通修复过程,主要路径是:
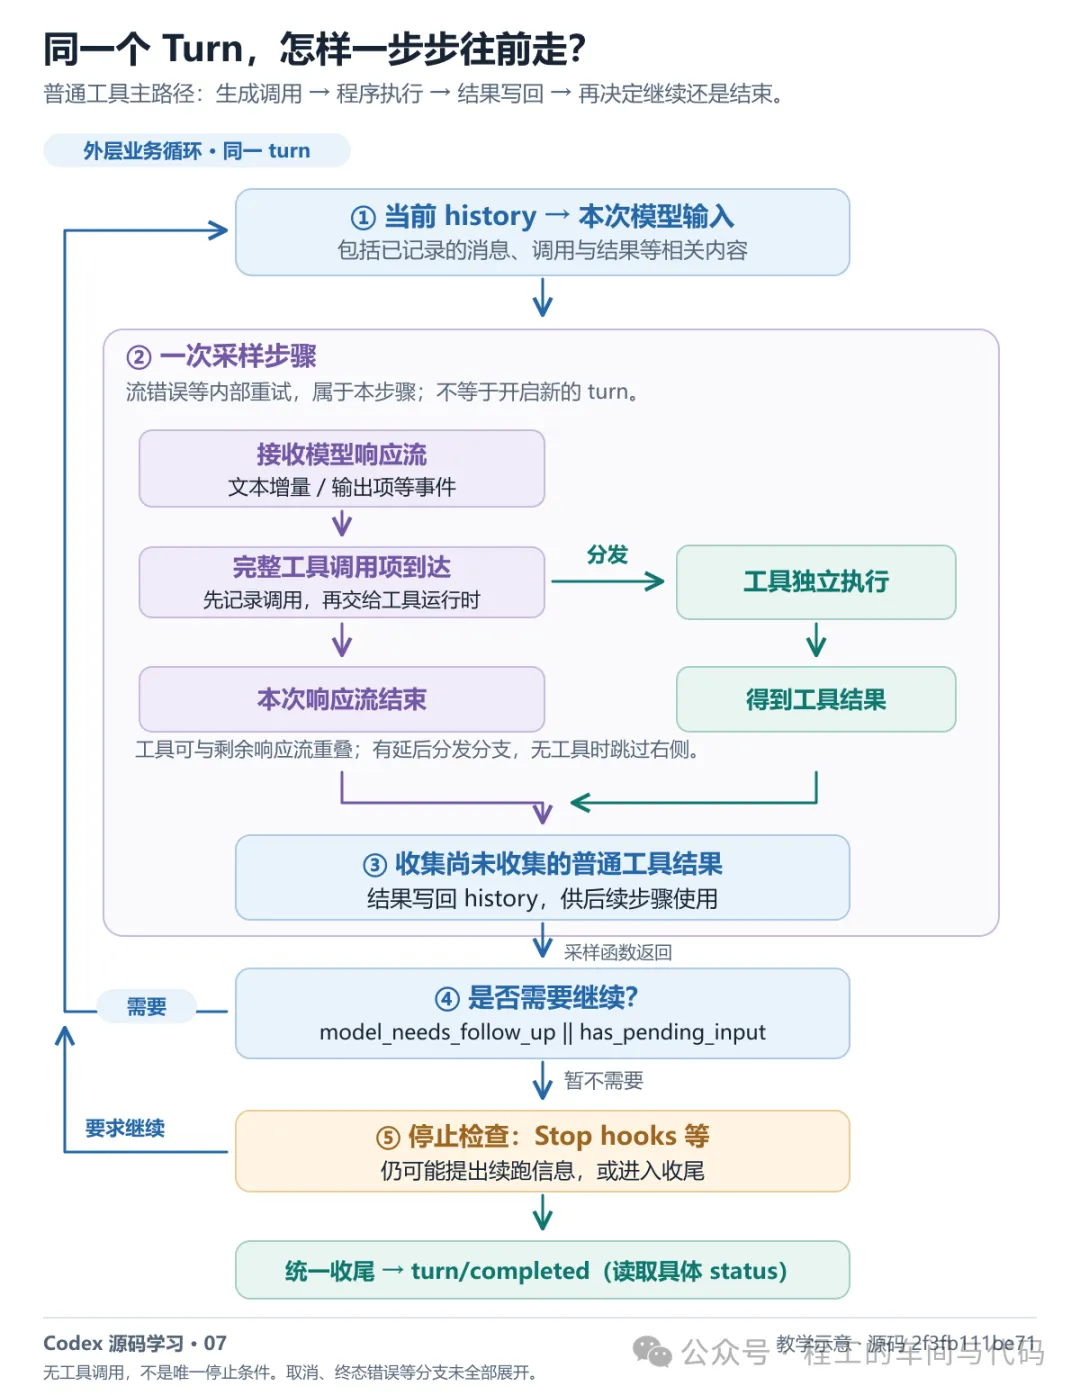
图 3:采样步骤汇总继续需求并收回工具结果,run_turn 综合新输入和收尾检查决定后续走向,任务层再处理退出。图中概括的是普通推进路径;错误和中断可以提前改变控制流。
其中,“完成”会出现在不同位置:
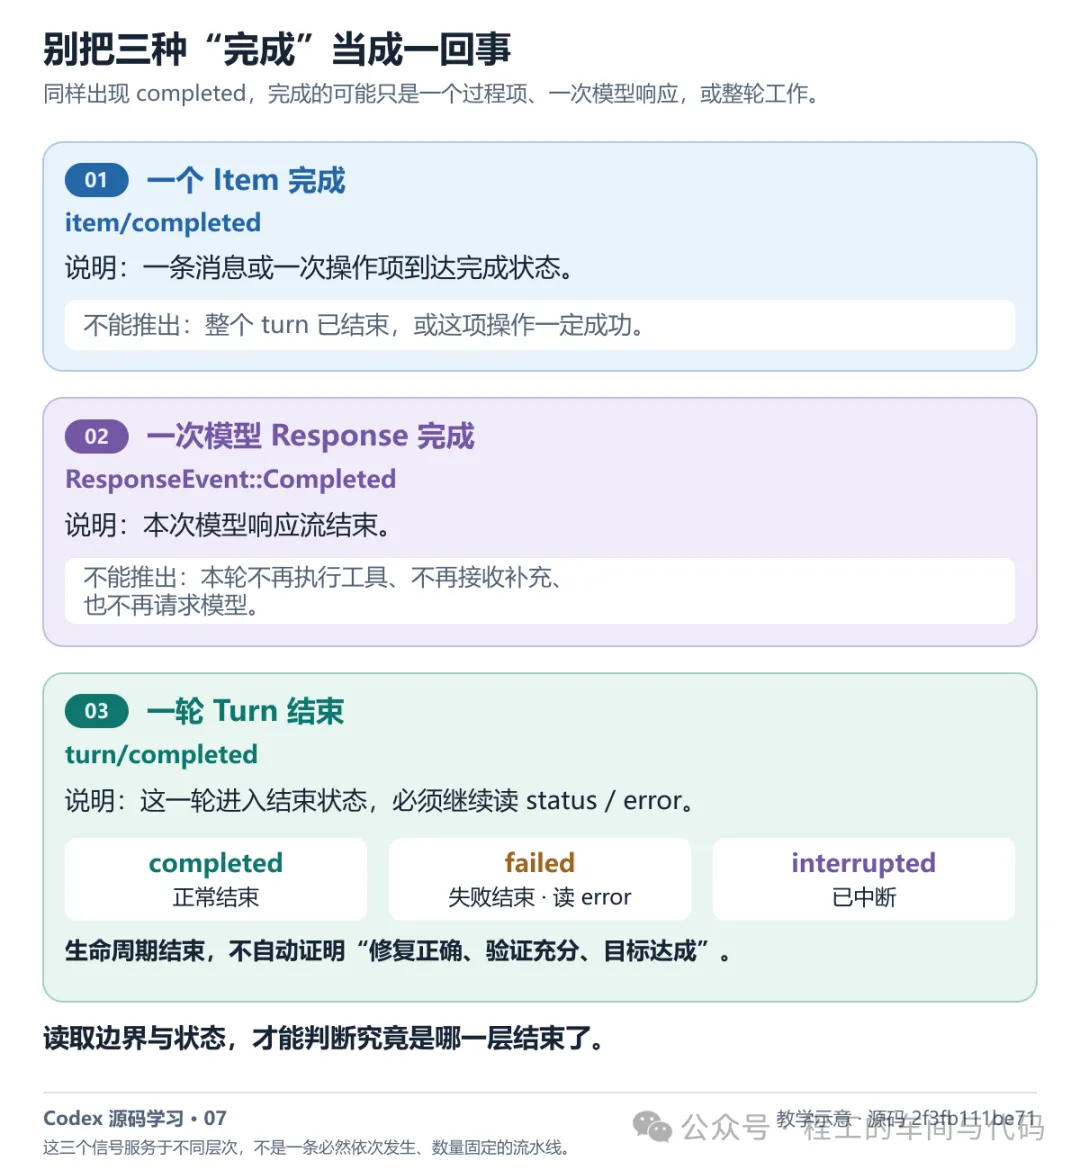
图 4:完成一个条目、读完一次模型响应、结束一轮任务,对应不同层次的边界。
- 完成发生在哪里
:Item 完成;已经确定的事实:该条消息或活动完成了相应处理;不能据此推出什么:一次测试命令完成,不代表测试通过 - 完成发生在哪里
:模型响应完成;已经确定的事实:当前响应流读到了完成事件;不能据此推出什么:工具结果可能仍需收集,之后也可能继续生成 - 完成发生在哪里
:Turn 结束;已经确定的事实:这一轮走到了相应的终态处理;不能据此推出什么:还要区分完成、失败、中断,更不能自动等同于业务验收通过
对于分页例子,真正支持“修复完成”的证据,是整除错误已修复、接口和输入前提保留、三个测试通过。主循环的继续标志和终态事件,则说明程序怎样推进、怎样结束。它们解决的是不同层次的问题。
这就是从源码得到的关键结论:运行时有明确的结束条件,但结束条件不是用户目标本身。 提示词和上下文影响模型怎样工作;工具、新输入、钩子和错误状态进入实际控制分支;业务结果仍要用与目标相符的证据判断。
到这里,我们已经走通了没有中途干预时的一轮修复。但继续条件里还有 has_pending_input。如果我在测试运行时补上一句“不要修改公共接口”,这份输入在哪里入队、又在哪里被取出?接下来就沿这条路径,回到已经建立起来的循环。
第 6 章 循环运行时,我们怎样改变它
前面为了看清主线,先让一轮任务从启动一直走到收尾。实际使用时,我们还可能补充要求、回复工具提问,或者主动停止。它们都发生在同一套运行机制上:有的改变后续输入,有的让工作等待,有的使任务进入中断处理。
6.1 追加引导,让正在工作的这一轮获得新输入
steer 接受的是一份待处理输入,不是直接修改正在生成的回答。 要理解它如何影响工作,需要把入队和消费两端都找到。
假设 Codex 正在调查分页问题,我们补充一句:
不要改公共接口,只修计算逻辑。
如果客户端通过 turn/steer 提交,目标已经限定为指定的活动轮次。steer_input 首先取得 active_turn 的锁,然后检查活动任务、目标 ID 和任务类型:没有活动任务就返回 NoActiveTurn,ID 不符就返回 ExpectedTurnMismatch,Review 或 Compact 类型则返回不可追加的原因。源码:活动轮次与输入校验
这里的锁协调的是“检查状态并将输入交给这轮工作”这一段访问。 它并不意味着要等整个 Agent 执行完,才能处理下一条消息。检查通过后,函数末尾执行:
pending_input.push(input);self.input_queue .extend_pending_input_and_accept_mailbox_delivery_for_turn_state( active_turn.turn_state.as_ref(), pending_input, ) .await;Ok(( active_turn_id.clone(), active_task.turn_context.root_turn_id(),))源码:输入入队与返回原轮次 ID
这一段完成的是向已有轮次的待处理输入追加内容,并返回已有的 ID。它没有调用 spawn_task,也没有发出模型请求。原来的 RegularTask 继续承担执行工作。turn/start 通过 StartOrSteer 模式追加到活动任务、返回原 turn ID 的行为,也有对应测试覆盖。活动轮次追加测试
输入入队后,再回到 run_turn 的工作循环。在准备下一次模型请求之前,可以看到消费端:
let pending_input = if can_drain_pending_input { sess.input_queue .get_pending_input(&sess.active_turn) .await .0} else { Vec::new()};紧接着,运行时把取出的输入交给 run_hooks_and_record_inputs(...),按 PersistContext::SteeredUserInput 处理和记录。之后构造模型输入时,新的要求才会随历史一起进入请求。源码:待处理输入的消费与记录
现在,前一章的 has_pending_input 也有了具体位置:它帮助决定是否还需要推进工作;这里的 get_pending_input 则负责取出要处理的内容。检查队列非空、消费输入、从历史准备请求,是相互衔接的三个动作。
can_drain_pending_input 还说明了消费存在时机约束。源码注释指出,轮次刚启动时会先处理初始输入,部分自动压缩后的情形也会推迟消费。因此,“输入被接受、进入历史、被模型请求带上”不必发生在同一瞬间。模型拿到这份要求后,才能结合已有失败证据调整修复操作。
这个版本还包含响应流抢占和排空路径,具体行为取决于传输方式和当前阶段。不能把 steer 简化成“立即修改旧请求”或“必定立即中断生成”。流抢占处理
路径辨析:
Submission通道把操作交给 Core;活动轮次的 pending input 保存等待消费的追加输入;扩展层的持久输入队列可以等待会话适合启动时再提交。选择“等当前工作结束后处理”,不能保证约束及时进入正在进行的修改,要看客户端使用的提交路径。持久输入队列
6.2 等待回复,让工作停在相应的执行点
还有一种情况是运行时主动等待:测试命令触发审批,或者工具需要向用户提问。此时任务可以停在相应等待点,收到回复后再继续。
对分页修复来说,等待审批意味着运行测试的动作还需要这个决定,并不意味着修复这一轮已经完成。公开线程状态可以附带 waitingOnApproval、waitingOnUserInput 等活动标记,帮助客户端表达当前等待原因。等待状态
这也让第 2 章中的 .await 有了具体场景:某个异步任务等待一个结果时,可以让出执行机会,其他接入和事件处理仍能继续。暂时没有新的助手文字,要结合任务生命周期和等待原因来判断。
6.3 点击停止,让活动任务走向中断收尾
用户停止走的是取消路径,不需要等模型主动给出结束信号。 客户端指定目标轮次,app-server 检查后把中断操作交给 Core,Core 找到对应的活动任务。中断入口
在 tasks/mod.rs 的 handle_task_abort 中,取消请求落到这个动作上:
task.cancellation_token.cancel();源码:触发活动任务取消
这个调用发出共享的取消信号。运行中的异步代码在相应等待点或检查位置观察它,转入中断处理。例如,采样路径在收集工具结果后、返回结果前,还有一次明确检查:
if cancellation_token.is_cancelled() { return Err(CodexErr::TurnAborted);}源码:采样返回前检查取消
这段不是全部取消处理,而是一个能直接看见的观察点:即使响应流已经结束,随后发生的取消也不会被当作普通成功结果直接返回。
任务层还会留出短暂的协作取消机会,等待运行任务结束;之后中止任务句柄,执行任务自身的 abort 处理,再记录和发出中断事件。**“发出取消信号”“运行代码响应取消”“完成中断收尾”是相连的过程,不是模型回复一句“好的”就算停止。**源码:取消后的等待与任务收尾
停止可能发生在读文件时、修改后或测试中。已经写入的修复不会随 Turn 中断自动撤销,外部副作用也不会仅靠取消任务回滚;后台终端的清理还有单独路径。
这条 Thread 仍然保留。我们之后可以继续说“接着验证刚才的修改”,运行时需要利用已保留的历史来接续工作。仓库中的中断测试也覆盖了相关工具调用与中断结果的历史行为。中断后的历史测试
这样,追加、等待和停止都能放回前面的工作循环:追加为后续生成提供新要求,等待让任务暂留在执行点,停止则让活动工作进入中断收尾。接下来还剩一个离使用体验最近的问题:这些内部变化,怎样成为聊天窗口里不断更新的消息、命令和修改记录?
第 7 章 运行中的工作,怎样变成聊天窗口里的 Item
我们已经从 Core 内部走通了一轮修复,也知道运行中可以怎样干预它。现在回到最初的聊天窗口:同一轮工作,为什么会逐步出现助手文字、测试命令、文件修改和最终状态?
第 2 章的图里已经留下了一条进展通路。执行任务在推进工作的同时发出事件,app-server 再把必要的过程信息转换成客户端通知。沿着这条通路,就能把内部执行与开篇认识的 Item 接起来。
7.1 一次测试的执行过程,怎样更新同一个条目
还是看第一次运行分页测试。客户端可以先建立命令条目,在执行过程中更新输出,最后标记这次命令的完成信息。助手文字也可以逐段显示,不需要等整轮修复结束才一次性出现。
这些变化有不同来源。模型响应流中的 OutputItemAdded、OutputTextDelta、OutputItemDone 等事件,描述模型输出项的变化;工具执行则产生自己的过程事件。Core 将相关事件发出,app-server 再转换成面向客户端的协议通知。流事件处理
从客户端协议看,可以先掌握三个常见通知:
- 通知
: item/started;接收方可以怎样处理:建立或标记开始的条目;分页任务里的表现:测试命令开始运行 - 通知
: item/agentMessage/delta;接收方可以怎样处理:按item_id追加助手文本;分页任务里的表现:“我先查看实现和测试”逐步出现 - 通知
: item/completed;接收方可以怎样处理:更新该条目的完成信息;分页任务里的表现:某次命令或消息已经完成
命令输出等内容也有自己的通知路径,并不共用助手文本的增量通知。客户端根据条目和状态组织消息、工具卡片或终端输出,具体样式由客户端决定。Item 通知类型
增量更新指向已有条目,协议字段本身就表达了这层归属。 以助手文字通知为例,app-server-protocol 中的定义是:
pub struct AgentMessageDeltaNotification { pub thread_id: String, pub turn_id: String, pub item_id: String, pub delta: String,}源码:助手文字增量通知
thread_id 和 turn_id 确定所属会话与轮次,item_id 指向要更新的条目,delta 携带本次新增的文本。一次增量并没有因此变成一个新 Item,也没有携带“本轮任务已完成”的判断。
这就接上了第 0 章的关系:一个 Item 可以从开始持续更新到完成。第 5 章区分的完成边界也同样适用——测试条目完成时,修复这一轮可能还要继续。
7.2 同一份执行结果,分别让模型有依据、让用户看见过程
第 4 章中,测试输出被记入历史,后续模型请求因而能够看到“实际为 3、预期为 2”。本章中,执行进展通过事件和通知送到客户端,让用户看到测试何时开始、怎样输出、何时结束。
这两个方向服务于同一项工作,但各自承担不同职责:
- 进入模型上下文的路径
,为后续生成提供判断依据,让修复能够继续。 - 发送客户端通知的路径
,表达正在发生的过程,让用户能够观察它。
它们贯穿执行过程,可以在同一项工作附近发生。不能把“用户已经看见输出”当成“模型已经消费这份结果”,也不能把通知路径放到全部执行结束之后才理解。
刷新或恢复会话时,还需要利用已有记录重建可用的过程条目。过去的实时增量已经发出,客户端不能只依靠它们恢复界面;源码因此还有历史条目投影等处理路径。历史条目投影
理解这两个方向后,再看上下文管理和事件系统,就能知道各自在解决什么问题:前者影响后续工作能使用哪些信息,后者帮助用户理解工作正在如何进行。
7.3 三种 Item,分别表达不同边界上的内容
沿着刚才的两条路径读源码,会遇到三个相近的名字。它们分别服务于模型交互、Core 过程表达和客户端协议:
- 类型
: ResponseItem;主要服务哪一层:模型协议与上下文历史;在本例中怎样理解:表达消息、测试调用、调用结果等内容,也用于构造后续输入 - 类型
: TurnItem;主要服务哪一层:Core 对轮次过程项的表达;在本例中怎样理解:配合核心事件描述可识别的过程内容 - 类型
: ThreadItem;主要服务哪一层:app-server 面向客户端的协议;在本例中怎样理解:表达用户消息、助手消息、命令执行和文件修改等条目
例如,模型协议里的 FunctionCall 与 FunctionCallOutput 通过调用标识关联;客户端更关心一次命令的参数、输出和执行状态。转换时会按具体内容选择表达方式,不必把每个内部对象原样变成一张可见卡片。模型条目 Core 条目 映射逻辑
因此,模型输出项完整到达,可以只是意味着“工具调用已经生成完整”;客户端命令条目的完成,还要结合实际执行过程来看。理解了这种转换,就不会仅凭几个类型名都有 Item,把不同层次的完成事件混在一起。
现在再回到 Thread、Turn、Item:Thread 关联持续的会话,Turn 表达这一轮工作的生命周期,Item 描述其中的消息和活动。前面几章追踪的生成、工具执行、输入干预和收尾,正是这些对象背后正在发生的事。
第 8 章 把整个分页修复任务重新走一遍
最后,把源码中的交接点放回最初那句“帮我修复失败测试”。这一次,我们可以同时看清:工作走到了哪里、已经得到了什么、下一步为什么能够发生。
- 阶段
:空闲时提交修复要求;这一阶段得到什么:Core 接受输入,建立 T1并启动RegularTask;工作怎样进入下一步:运行任务进入run_turn,准备模型输入 - 阶段
:模型提出运行测试;这一阶段得到什么:得到完整的工具调用;工作怎样进入下一步:运行时记录调用,并交给测试工具执行 - 阶段
:收回失败结果;这一阶段得到什么:历史增加“实际为 3、预期为 2”的证据;工作怎样进入下一步:采样步骤交回继续标志,工作循环再次准备输入 - 阶段
:根据证据修改实现;这一阶段得到什么:模型提出修改,工具返回写入结果;工作怎样进入下一步:更新后的历史支持模型继续安排验证 - 阶段
:重新运行测试;这一阶段得到什么:三个场景的验证结果进入历史;工作怎样进入下一步:后续生成可以据此组织修复和验证说明 - 阶段
:判断是否结束;这一阶段得到什么:检查继续需求、待处理输入和收尾条件;工作怎样进入下一步:条件允许后完成任务级收尾,发出轮次终态
沿着这条路线,前一步产生的信息会进入后一步的判断,运行时则负责执行动作、记录结果并控制继续或收尾。对于分页例子,具体修复思路来自模型对代码和失败证据的分析;使这些步骤能够接续发生的,是刚刚读过的 Agent 循环。
与此同时,执行过程中的消息、命令和修改持续通过事件通知呈现在客户端。它们是这条路线的可见过程,不是全部工作完成后额外补上的一个阶段。如果中途追加“不要改接口”,新输入会沿第 6 章的路径进入活动工作;如果点击停止,则走中断与收尾路径。
整个普通修复过程可以发生在同一个 T1 中,包含多次生成和多个 Item。等这一轮结束后,我们再问“为什么整除时不能再加一”,才是在同一个 Thread 中开始后续的解释工作。这样,开篇的包含关系与后面的执行过程就对上了。
如果要自己重新沿源码走一遍,可以按这条路线阅读:
从 turn/start 看输入怎样被提交和受理。 到 RegularTask 找到任务入口,再进入 run_turn。从 模型输入构造 跟到生成,再沿 输出项处理 进入工具路径。 跟进 工具结果回填,随后返回 继续判断,看下一步怎样重新开始。 最后读 停止检查 与 任务收尾,确认这一轮在哪里结束。
第一次读时,可以在每个交接点问自己:这里拿到了什么,交给了谁,下一步靠什么继续?先把这条数据与控制的关系读通,再回头展开工具、事件、上下文管理和异步语法,就能知道每个细节在整轮工作中承担什么作用。
本文配套的 分页示例与复现说明 包含修复前后程序、三个测试和实际输出,可以用来亲手验证分页问题。文中的 Agent 路线仍是依据源码组织的教学推演,真实任务的动作安排和生成次数会有所不同。
下一篇,我们继续深入第 3 章留下的模型交互部分:准备好的上下文怎样变成请求,流式返回的文本、工具参数和完成事件又怎样被逐步读出来?这一篇已经确定了它们在工作循环中的位置,接下来就沿这次请求与响应向里走。
固定版本源码阅读入口
源码仓库地址(复制到浏览器打开):
https://github.com/openai/codex/tree/2f3fb111be71d277c80bd5b96d9019748b921f5a
以下路径均以该提交的 codex-rs/ 为根:
输入路由: core/src/session/turn_input.rs#L231-L290。任务外层循环: core/src/tasks/regular.rs#L40-L125。工具分发: core/src/stream_events_utils.rs#L348-L370。结果回填: core/src/session/turn.rs#L2585-L2613。继续需求合并: core/src/session/turn.rs#L582-L609。Stop hook 控制分支: core/src/session/turn.rs#L742-L772。Stop hook 优先关系: hooks/src/events/stop.rs#L396-L429。任务终态: core/src/tasks/mod.rs#L842-L875。客户端状态: app-server/src/bespoke_event_handling.rs#L1561-L1589。
我是程工造Agent,做 Agent 系统与 RAG 的工程师。这个专栏记录我从零学习 Rust、阅读 Codex 源码的过程。
下一篇:准备好的上下文怎样变成请求,流式返回的文本、工具参数和完成事件又怎样被逐步读出来。