ARTICLE · 1278681
ESP-Claw源码剖析-08_技能系统
技能是 ESP-Claw 中最小、也最贴近用户的产品化扩展单元:一份 SKILL.md 文档加一个资产目录。本章从"为什么扩展单元是一份文档"出发,剖析技能的真实格式、/system/skills 与 DATA skills/ 双源注册表的构建与同 id 遮蔽机制、{CUR_SKILL_DIR} 占位符的展开实现、构建期烘焙链路 skill_builder,以及 cap_skill_mgr 如何让 LLM 自己列出、激活、安装技能,最后厘清技能、能力与 Lua 模块三者的边界。
目录
设计动机:为什么扩展单元是一份文档
技能模型:SKILL.md 与资产目录2.1 SKILL.md 的真实格式2.2 技能 id 与资产目录约定2.3 execution:声明式的启动器入口2.4 manage_mode:三种管理档位
双源注册表:固件烘焙与运行时安装3.1 启动期的双源注册3.2 递归扫描与"技能是叶子"3.3 同 id 冲突:注册顺序即优先级3.4 固件与运行时的边界
{CUR_SKILL_DIR}:可移植的路径占位符
skill_builder:构建期的技能烘焙
cap_skill_mgr:LLM 的技能管理入口6.1 四个能力描述符6.2 activate_skill:激活即注入6.3 register 与 unregister:运行时安装的闸门6.4 自我扩展闭环:用技能安装技能
激活态与上下文注入7.1 两级注入:目录常驻,正文按需7.2 会话状态与能力组解锁7.3 从扫描到执行的完整时序
技能、能力与 Lua 模块的边界
本章小结
1. 设计动机:为什么扩展单元是一份文档
给一个跑在 ESP32 上的 Agent"加功能",传统路径只有一条:改 C 代码、重新编译、OTA 升级固件。这条路在 MCU 上代价高昂——签名校验、分区切换、失败回滚,任何一环出错都可能变砖。而动态加载代码(DSO、字节码热更新)在无 MMU、内存紧张的环境里又同时引入安全与稳定性风险。
ESP-Claw 的关键洞察是:对一个以 LLM 为决策核心的 Agent 而言,运行时行为的最小变更单元其实不是代码,而是"提示"。模型不知道怎么控制灯带,通常不是缺一个驱动(第11章《Lua运行时与驱动体系》的驱动早已就位),而是缺一份"怎么想、怎么做"的说明书。于是技能被定义为:一份机器可解析的 Markdown 文档,加一个可选的资产目录(脚本、参考资料、图标)。
这个选择带来三个直接收益:
LLM 读得懂:SKILL.md 就是模型最擅长的自然语言加结构化示例,无需任何运行时编译或解释新语言;
用户写得动:一个技能就是一个文件夹,手写即可,这与 Anthropic Agent Skills、Claude Code 的 SKILL.md 机制同构,是业界验证过的扩展形态;
渐进式披露(progressive disclosure):常驻提示词的只有"id 加一行描述"的目录,技能正文按需激活时才注入,上下文成本与技能数量解耦。
代价是纪律:技能必须通过 frontmatter 声明自己的身份、必须经过注册表统一管理(本章第 3 节)、必须经能力组解锁它用到的工具(与第5章《能力系统》的衔接点)。
2. 技能模型:SKILL.md 与资产目录
2.1 SKILL.md 的真实格式
规范 .agents/spec/claw-skill-spec.md 规定:SKILL.md 必须以一对 --- 包裹的 JSON frontmatter 开头,正文是恰好包含一个 H1 标题的 Markdown。以真实技能 light_switch 为例:
1 2 3 4 5 6 7 8 9 10 11 12
---{"name": "light_switch","description": "Turn a board light on or off, set LED strip color or brightness, and control GPIO lights. Requires board_hardware_info skill.","metadata": {"cap_groups": ["cap_lua"],"manage_mode": "readonly"}}---
frontmatter 必须是单个合法 JSON 对象。解析发生在 claw_skill.c 的 parse_skill_document_metadata():extract_skill_frontmatter_json() 先剥掉可选的 UTF-8 BOM,再定位首行 --- 与闭合的 \n---,把中间文本交给 cJSON。注意这里没有引入 YAML 解析器——JSON frontmatter 让固件端几十行代码就能完成解析,也避免了 YAML 歧义带来的构建期与运行期行为不一致。
description 是被规范单独立规的字段:"它影响技能匹配,必须描述用户意图而非实现细节"。light_switch 的描述写的是"turn a board light on or off"这类用户措辞,而不是"call led_strip_switch.lua"——因为 LLM 是靠这行目录文字决定要不要激活技能的,写错对象就等于技能永远不被选中。
2.2 技能 id 与资产目录约定
技能 id 就是 frontmatter 的 name,且必须与目录名严格一致。validate_registry_entry() 强校验文档相对路径必须是 <id>/SKILL.md,同时 skill_path_is_valid() 拒绝绝对路径、.. 与反斜杠——id 同时充当文件系统目录名,所以校验既是格式问题也是安全问题。
一个技能目录除 SKILL.md 外全部可选,惯例布局为:
scripts/:技能自带的 Lua 脚本,如light_switch的scripts/led_strip_switch.lua;references/:给模型读的补充文档;assets/:图标等静态资源。
正文写法在真实技能中高度收敛:先说"什么时候用"(Use this skill when…),再给脚本参数的 JSON Schema,再给若干可直接照抄的工具调用示例,最后是一份编号的 Recommended Flow。light_switch 的推荐流程多达 15 步,逐步约束"先激活 board_hardware_info 查占用的 IO,不要猜引脚""脚本报错就直接上报用户,不要换参数重试"。这份文档本质上是写给 LLM 的操作规程,而非写给人的 README。
2.3 execution:声明式的启动器入口
frontmatter 顶层的 execution 对象是可选的,声明一个 System UI 启动器入口,固件侧对应 claw_skill_execution_t:
1 2 3 4 5 6 7
typedefstruct {constchar *entry; /* 可执行脚本的绝对路径(源自技能内相对 .lua 路径) */constchar *icon; /* 可选的启动器图标绝对路径(.jpg/.jpeg) */constchar *args_json; /* 可选的紧凑 JSON 参数串 */int order; /* 启动器排序提示 */bool visible; /* 为 false 时对启动器消费者隐藏 */} claw_skill_execution_t;
parse_skill_execution() 的处理体现了一贯的"容错降级"策略:entry 缺失或后缀不是 .lua 就整段跳过;图标路径非法只忽略图标;注册时还会实际 fopen 校验脚本存在,不存在则把 execution 整体摘除并降级为普通技能——一个坏声明不应让整份技能失效。
2.4 manage_mode:三种管理档位
metadata.manage_mode 取值 readonly、web、runtime。设备端 json_parse_manage_mode() 把 web 与 readonly 归并为同一档:web 是 Skills Lab(技能商店)打包技能的标记,设备上的管理规则与 readonly 相同——不可在运行时注销。runtime 留给运行时注册的技能。这枚小标志划出了"谁能删这份技能"的边界,第 6.3 节会看到它如何被执行。
3. 双源注册表:固件烘焙与运行时安装
3.1 启动期的双源注册
技能有两个物理来源:固件烘焙的只读 SYSTEM 分区(/system/skills)与可写 DATA 分区(<DATA>/skills,DATA 为 /fatfs 或 SD 卡挂载点)。应用外壳(第3章《启动流程与应用外壳》)的 init_skills() 完成双源注册:
1 2 3 4 5 6 7 8 9 10 11 12
staticesp_err_tinit_skills(constapp_claw_storage_paths_t *paths){ESP_RETURN_ON_ERROR(claw_skill_init(&(claw_skill_config_t) {.session_state_root_dir = paths->memory_session_root,.max_file_bytes = 20 * 1024, /* 单份文档上限 20 KB */}),TAG, "Failed to init claw_skill");/* 按优先级顺序注册扫描根 */ESP_RETURN_ON_ERROR(claw_skill_add_directory(paths->system_skills_root_dir), TAG, "...");ESP_RETURN_ON_ERROR(claw_skill_add_directory(paths->skills_root_dir), TAG, "...");return ESP_OK;}
claw_skill_add_directory() 的契约写在头文件里:幂等(重复注册直接跳过,不触发重载),每次新增目录都调用 claw_skill_reload_registry() 全量重建内存注册表。load_registry_from_markdown() 逐根扫描,缺席的根(比如某块板没有 SYSTEM 技能分区)只告警跳过,不会让加载失败——双源中任何一源都是可缺省的。
3.2 递归扫描与"技能是叶子"
扫描核心是 load_registry_dir_recursive()。它有一个关键的"叶子"约定:
1 2 3 4 5 6 7 8 9
/* 技能是叶子:本目录已有 SKILL.md 时,其子目录(scripts/、references/、* assets/)是技能负载而非嵌套技能。提前探测,避免下钻。 */while ((item = readdir(dir)) != NULL) {if (item->d_name[0] && is_skill_document_file(item->d_name)) {has_skill_doc = true;break;}}rewinddir(dir);
没有这个约定,扫描会误把 scripts/ 里的文件当技能文档、或把技能目录嵌套出层级技能树;有了它,技能树的深度被天然限制在两层(根目录下的 <id>/SKILL.md),递归深度可控,主任务栈不会被深目录拖垮。注册表还有硬上限 CLAW_SKILL_MAX_FILES(64 条),单文档读取受 max_file_bytes(应用配 20 KB)约束——嵌入式设备上,"能装多少技能"必须是有界的。
3.3 同 id 冲突:注册顺序即优先级
两个根里出现同名技能时,裁决逻辑就在扫描循环末尾:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
/* 先注册(更高优先级)根中已加载的同 id 技能获胜,本副本被遮蔽。* 这让可写分区可以覆盖同 id 的固件烘焙技能。 */bool shadowed = false;for (i = 0; i < *entry_count; i++) {if (strcmp((*entries)[i].id, entry->id) == 0) {ESP_LOGW(TAG, "skill id %s in %s shadowed by %s",entry->id, root_dir, (*entries)[i].root_dir);shadowed = true;break;}}if (shadowed) {free_registry_entry(entry); /* 后到副本直接丢弃 */continue;}(*entry_count)++;
机制层面,规则非常简单:先入表者胜(earlier wins)。模块内部注释声明的设计意图是"roots[0] 是可写根,DATA 覆盖固件烘焙技能"。不过剖析源码要留意一点:裁决权完全在调用方的注册顺序,而当前 init_skills() 实际先注册 /system/skills 再注册 <DATA>/skills——以现有调用点顺序,同 id 时固件烘焙副本反而先生效。无论哪个方向,遮蔽都只打一条警告,对 LLM 不可见;但"覆盖谁"取决于 claw_skill_add_directory() 的调用顺序,这一点读代码时必须到调用点确认,不能只看模块注释。
3.4 固件与运行时的边界
双源分立的本质是存储介质的可写性差异:SYSTEM 分区由 fatfs_create_rawflash_image(system ...) 生成的原始镜像烧录,运行时只读、不可变;DATA 分区是 wear-levelled 的可写镜像,运行时安装的技能都落在这里。
运行时侧的边界由 cap_skill_mgr 守住:cap_skill_mgr_register_group() 接收的 skills_root_dir 被绑定为 DATA 根(app_capabilities.c 传入的是 paths->skills_root_dir),因此 register_skill、unregister_skill 的所有写操作永远够不到 /system/skills。仓库里 application/edge_agent/fatfs_image/storage/skills/ 出厂预置了 light_switch、plan_mode、scheduled_task 三个技能——它们随 DATA 镜像首次烧录就位,此后与运行时安装的技能混居同一根下,享受同样的注册表待遇。
4. {CUR_SKILL_DIR}:可移植的路径占位符
技能文档不可避免要引用自己的脚本,但同一份文档可能躺在 /system/skills/<id> 也可能躺在 <DATA>/skills/<id>——硬编码任何一边都会破坏可移植性。规范给出的答案是 {CUR_SKILL_DIR} 占位符,展开实现在 claw_skill_read_document():
1 2 3 4 5 6 7 8 9
written = snprintf(cur_skill_dir, sizeof(cur_skill_dir), "%s/%s",entry->root_dir, skill_id); /* 根目录 + 技能 id */err = str_replace_required_len(text, "{CUR_SKILL_DIR}",cur_skill_dir, &required_len); /* 先精确算长度 */if (required_len >= size) { ... return ESP_ERR_INVALID_SIZE; }snprintf(buf, size, "%s", text);free(text);/* 展开 {CUR_SKILL_DIR},让 LLM 直接看到解析后的绝对路径 */str_replace_inplace(buf, size, "{CUR_SKILL_DIR}", cur_skill_dir);
两个工程细节值得注意。其一,替换分两遍:先 str_replace_required_len() 预计算展开后的精确长度,放不下就返回 ESP_ERR_INVALID_SIZE,而不是原地替换到一半截断——截断的路径比没有路径危险得多,模型可能拿着半截路径去调工具。其二,展开后的绝对路径直接呈给 LLM:light_switch 正文里的 {"path":"{CUR_SKILL_DIR}/scripts/led_strip_switch.lua"} 示例,模型读到的已是 /system/skills/light_switch/scripts/led_strip_switch.lua,抄下来即用。规范同时约定:占位符只用于正文,不进 frontmatter;正文文件访问一律走绝对路径加占位符,禁止 ../ 逃逸。
5. skill_builder:构建期的技能烘焙
技能进 SYSTEM 镜像是纯构建期行为,由 components/common/skill_builder 承担。契约是:任何构建组件都可以带一个 skills/ 目录,构建系统负责把所有组件的技能汇拢进镜像。应用侧的接线只有一段:
1 2 3 4 5 6
# 技能/Lua 资源烘焙进只读 system 分区,# 这样运行时格式化 storage 分区也不会丢失它们。skill_builder_configure_skill_sync(TARGET fatfs_system_binSKILL_OUTPUT_DIR "${EDGE_AGENT_FATFS_SYSTEM_BUILD_ROOT}/skills")
skill_builder_configure_skill_sync()(cmake/skill_sync.cmake)注册自定义目标 skill_builder_sync_skills,并把镜像打包目标 fatfs_system_bin 依赖到它之后,保证打镜像前技能已同步完毕。目标执行的 components/common/skill_builder/tools/sync_component_skills.py 从 build/project_description.json 的 build_component_info 枚举全部组件,逐个检查 skills/ 目录:用正则解析 frontmatter 取 name,校验 id 全项目唯一(重复直接构建失败),然后按相对路径原样拷贝到输出目录的 skills/<skill_id>/ 下。清单(manifest)机制还会把上次构建记录、本次已不存在的组件技能文件从输出目录清除,防止僵尸文件混进镜像。
这里能看到构建期与运行期两套校验的分工:构建期在开发机上做重校验(id 唯一性、路径冲突),失败即阻断;运行期在设备上做轻校验(frontmatter 合法性、64 条上限),失败只丢条目不崩系统。注释里"storage 可被运行时格式化而不丢技能"一句点破了双源设计的另一层动机:可写分区随时可能被用户重置,只读分区是技能的安全底座。
6. cap_skill_mgr:LLM 的技能管理入口
6.1 四个能力描述符
cap_skill_mgr 是第5章《能力系统》中的一个普通能力组(group_id 为 cap_skill),却承担着"Agent 自我扩展"的特殊职责。它注册了四个描述符:
list_skill | ||
register_skill | ||
unregister_skill | ||
activate_skill |
activate_skill 的描述符最能说明设计意图:
1 2 3 4 5 6 7 8 9 10 11 12 13
{.id = "activate_skill",.name = "activate_skill",.family = "skill",.description = "Activate a skill from skill_id and return its full Skill markdown document ""inside a <skill_content name=\"skill_id\"> block. When multiple skills are needed, ""call activate_skill multiple times in a single response ...",.kind = CLAW_CAP_KIND_CALLABLE,.cap_flags = CLAW_CAP_FLAG_CALLABLE_BY_LLM,.input_schema_json ="{\"type\":\"object\",\"properties\":{\"skill_id\":{\"type\":\"string\"}},\"required\":[\"skill_id\"]}",.execute = cap_skill_activate_execute,},
list_skill 是唯一不带 CLAW_CAP_FLAG_CALLABLE_BY_LLM 的——描述符注释写明原因:目录本来就常驻提示词(第 7.1 节),再暴露给 LLM 只会浪费一次无信息量的工具调用。这种"能不给模型就不给"的克制贯穿整个能力系统的设计。
6.2 activate_skill:激活即注入
cap_skill_activate_execute() 的执行顺序是理解激活语义的钥匙:
claw_skill_read_document()读出技能全文({CUR_SKILL_DIR}已在此展开);claw_skill_activate_for_session()把技能 id 写入该会话的持久激活集;cap_skill_sync_session_visible_groups()把激活技能声明的cap_groups设置为该会话对 LLM 可见的能力组;最后把全文包进
<skill_content name="skill_id">…</skill_content>作为工具返回值送回模型。
注意第 4 步:技能正文不是进系统提示,而是作为本轮工具调用的结果进入对话。这正是渐进式披露的第二级——目录(id 加描述)常驻系统提示,正文只在模型主动激活的那一刻注入当前上下文,token 成本从"所有技能之和"降为"被激活技能之和"。
6.3 register 与 unregister:运行时安装的闸门
register_skill 不写文件——它假设技能文件已由别的通道(通常是 Lua 脚本)落到 DATA 根,自己只做三件事:校验 file 匹配 ^[^/]+/SKILL\.md$、确认文件存在、调用 claw_skill_reload_registry() 热重载并校验重载后注册表里的条目确实指向该文件。写文件与登记注册分离,让"下载"可以流式进行而"登记"保持原子。
unregister_skill 的防御更完整:先查注册表条目,manage_mode 为 readonly 直接拒绝(web 在设备端已归并为 readonly,所以 Skills Lab 技能同样删不掉);删除前先把旧 markdown 读进内存,若删除后 claw_skill_reload_registry() 失败,就把旧文件原样写回再重载一次——用回滚保证注册表与磁盘永不出现"磁盘没有、内存还在"的分裂。且删除操作只能命中 DATA 根下的路径,SYSTEM 分区物理只读,双保险。
6.4 自我扩展闭环:用技能安装技能
仓库里最有代表性的技能是 skill_builder 组件自带的 skills_lab_downloader:当用户说"帮我装个贪吃蛇技能"时,模型激活它,按文档流程用 {CUR_SKILL_DIR}/scripts/download_skill.lua 从技能中心 skills-lab.esp-claw.com 拉取 _metadata.json,由模型(而非 Lua)阅读元数据、对照 board_hardware_info 技能核对本板外设清单,确认兼容后把技能文件流式写入 DATA 目录,最后可选调用 register_skill 让新技能立即可激活。
这个过程没有任何人工环节:解释需求的是 LLM,做安装决策的是 LLM,执行下载的是技能自带的 Lua 脚本,落点在可写分区,权限边界由 manage_mode 与只读分区兜底。固件无需重新编译,Agent 的能力面在运行时自我生长——这是"文档即扩展单元"能走到的最远处,也回答了第 1 节的动机问题。
7. 激活态与上下文注入
7.1 两级注入:目录常驻,正文按需
技能进入 claw_core(第4章《Agent核心设计》)上下文的两条通道泾渭分明。第一级是常驻目录。claw_skill 模块导出一个标准的上下文提供者:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
staticesp_err_tclaw_skill_skills_list_collect(constclaw_core_request_t *request,claw_core_context_t *out_context,void *user_ctx){/* 渲染 "Available skills:\n- <id>: <summary>\n" */...out_context->kind = CLAW_CORE_CONTEXT_KIND_SYSTEM_PROMPT; /* 注入系统提示 */out_context->content = content;return ESP_OK;}constclaw_core_context_provider_t claw_skill_skills_list_provider = {.name = "Skills List",.collect = claw_skill_skills_list_collect,.user_ctx = NULL,};
应用外壳把它注册进 claw_core 的提供者列表,每次会话运行时目录都从内存注册表实时渲染——这意味着运行时 register_skill 触发的热重载,在下一次会话自然生效,无需重启。第二级即第 6.2 节的 <skill_content> 正文注入。两级合起来,系统提示只承担"货架标签"的成本,正文按消费付费。
7.2 会话状态与能力组解锁
激活集是按会话持久化的。build_session_state_path_dup() 先用 sanitize_session_id() 把会话 id 清洗为字母数字加下划线,再计算 FNV-1a 哈希,最终路径形如 <session_state_root>/s_<safe>_<hash>.skills.json——清洗防路径注入,哈希防碰撞,文件内容就是一个技能 id 的 JSON 数组。claw_skill_activate_for_session() 的实现是"读、去重追加、写回";激活集清空时直接删除文件,不留空壳。会话生命周期的清理(claw_skill_delete_session_state())则与第7章《记忆系统》的会话目录联动。
cap_groups 是技能与第5章能力系统之间的桥。claw_skill_load_active_cap_groups() 汇总一个会话所有激活技能声明的能力组(如 scheduled_task 声明的 cap_lua、cap_scheduler、cap_router_mgr),cap_skill_sync_session_visible_groups() 再调 claw_cap_set_session_llm_visible_groups() 将其设为该会话的工具可见集。于是"激活一个技能"同时完成了两件事:给模型一份说明书(知识),给模型开一串工具(权限)。技能解锁能力、能力反哺技能,两者在会话维度精确对齐。
7.3 从扫描到执行的完整时序
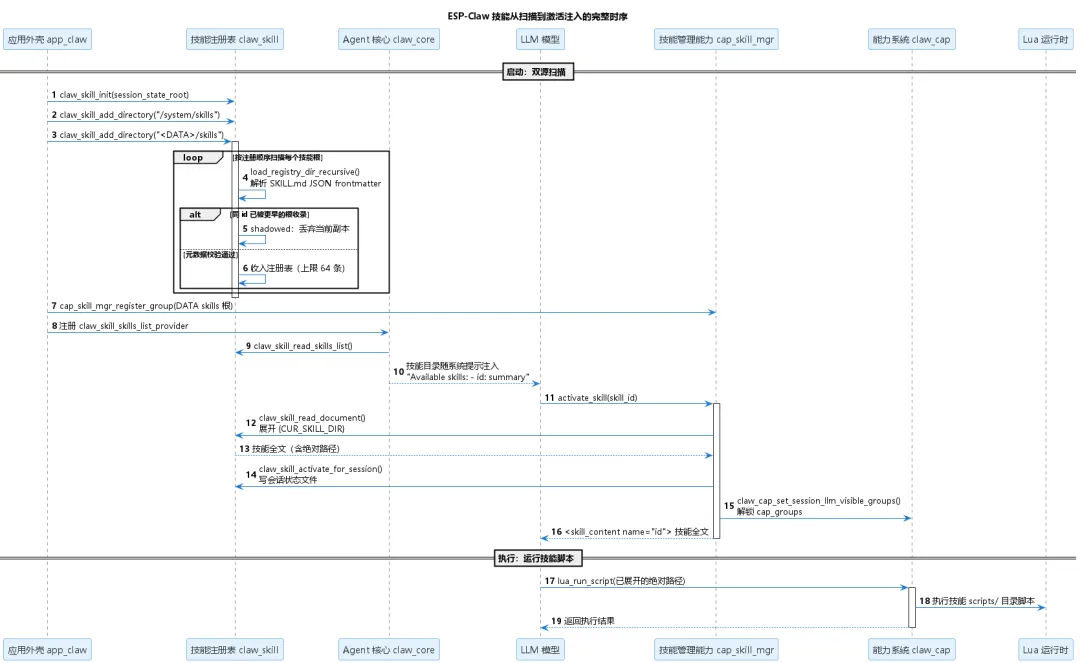
流程执行说明:
启动扫描阶段(步骤 1-8):应用外壳先
claw_skill_init()建立空注册表,再依次注册/system/skills与<DATA>/skills两个扫描根,每次注册触发claw_skill_reload_registry()全量重建。load_registry_dir_recursive()按"技能是叶子"约定逐份解析 SKILL.md 的 JSON frontmatter;遇到同 id 技能时先注册者胜、后到副本被遮蔽丢弃;合法条目收入注册表(上限 64 条)。随后cap_skill_mgr_register_group()绑定 DATA 根并注册四个技能管理能力,claw_skill_skills_list_provider注册为claw_core上下文提供者。目录常驻阶段(步骤 9-11):每次会话运行,
claw_core调用提供者渲染"Available skills"目录并注入系统提示。目录只有 id 与一行描述,成本恒定,与技能正文长度无关。激活解锁阶段(步骤 12-17):模型依据目录判断需要某技能,调用
activate_skill。管理能力先读出全文(展开{CUR_SKILL_DIR}),再写入会话激活集文件,然后把该技能的cap_groups设为会话可见能力组,最后以<skill_content name="id">包裹全文返回——正文从此进入对话上下文,工具权限从此解锁。脚本执行阶段(步骤 18-21):模型按技能文档的示例调用
lua_run_script,路径已是展开后的绝对路径,指向技能自带scripts/下的 Lua 脚本,由第11章《Lua运行时与驱动体系》执行并回传结果。至此,"扫描→激活→注入→执行"闭环完成,全程无编译、无重启。
8. 技能、能力与 Lua 模块的边界
第5章的能力、本章的技能、第11章的 Lua 模块构成三层扩展机制,一句话概括:技能是给 LLM 的知识,能力是给 LLM 的手,Lua 模块是驱动的脚。
cap_groups 解锁能力 | |||
.lua | lua_run_script |
三者的分工是刻意的不对称。能力用 C 写,因为它要的是确定性的权限边界与执行效率,描述符的 cap_flags、输入 schema、能力组都是编译期定死的契约;技能用 Markdown 写,因为它要的是"模型读了就会做"的可传播性,用户和技能商店都能生产;Lua 居中,用脚本换取免编译的灵活性,但被沙箱约束在能力授予的 API 之内。技能不能自带 C 代码——签名链、内存保护、OTA 回滚这些 MCU 上的硬约束决定了原生代码必须走固件升级;但技能可以声明 cap_groups,把自己需要的手脚借过来,再把自己的脚本当肌肉使。scheduled_task 是标准范本:文档教模型何时介入,cap_scheduler 与 cap_router_mgr 提供系统调用,scripts/add_scheduled_task.lua 完成带回滚的编排。
9. 本章小结
技能系统是 ESP-Claw"文档优先"哲学的集中体现:SKILL.md 用 JSON frontmatter 声明身份,用正文向 LLM 传授操作规程;双源注册表把不可变的固件烘焙技能与可生长的运行时技能统一在一个内存目录里,同 id 冲突由注册顺序裁决;{CUR_SKILL_DIR} 以两遍替换保证文档可移植且绝不截断;skill_builder 在构建期把组件技能烘焙进只读 SYSTEM 分区;cap_skill_mgr 则让 LLM 自己完成列出、激活、安装与卸载,配合"目录常驻、正文按需"的两级注入与 cap_groups 能力解锁,构成一个无需编译、无需重启的自我扩展闭环。下一章将离开设备本体,看 Agent 如何跨越网络与 IM 平台对话(第9章《IM通信集成》)。
参考文献
[1] ESP-Claw 技能规范 claw-skill-spec.md:https://github\.com/espressif/esp\-claw/blob/master/\.agents/spec/claw\-skill\-spec\.md。
[2] ESP-Claw 官方仓库:https://github\.com/espressif/esp\-claw。
[3] Anthropic Engineering:Equipping agents for the real world with Agent Skills:https://www\.anthropic\.com/engineering/equipping\-agents\-for\-the\-real\-world\-with\-agent\-skills。
[4] ESP-IDF FATFS 文件系统与分区 API:https://docs\.espressif\.com/projects/esp\-idf/en/stable/esp32/api\-reference/storage/fatfs\.html。
[5] ESP-Claw Skills Lab 技能中心:https://skills\-lab\.esp\-claw\.com。