ARTICLE · 1279202
PDF转MD格式必备-GitHub上82.5K星的开源神器-审小黑工具分享
审小黑的偷懒笔记 · 工具合集
日常学习和工作中,经常要把一批 PDF 转成文字:教材、准则、案例集、各种资料,一转就是一堆。
比如一些学习资料审计会计类的书都是扫描版,PDF 里一般复制不出来;遇到文件大的常用的 AI 工具直接传不上去。
最近我发现一个免费的PDF转换MD等多种格式的工具 MinerU
我习惯先把 PDF 转成 MD 格式,再喂给 AI,这样准确度很高。
GitHub 上 82.5K 星,上海人工智能实验室出品,开源免费。
传送门:https://github.com/opendatalab/MinerU
网页版:https://mineru.net
01 MinerU 是什么?
它是一个能把 PDF、扫描件、图片、Word 等文件,通通转换成 Markdown(MD)格式的神器。
它支持的具体格式非常丰富:
输入格式:不仅包括 PDF(含扫描版)、各类图片(PNG/JPG等)、Word、PPT、Excel,还支持 RTF、ODT、EPUB、HTML、CSV 等。
财税亮点:它甚至支持国内电子发票和公文常用的 OFD 格式
解析机制:对于 Office、OFD、EPUB 等文档,它会直接读取原文数据,不需要经过 OCR 识别,速度和准确度更高。
输出格式:主推 Markdown,另外也支持 HTML、LaTeX、DOCX、EPUB、PDF 及结构化 JSON 等(不同使用端口开放的格式略有差异)。
顺便提一句,MD 是什么?
它是一种用简单符号来排版的纯文本。比如用 # 表示标题,用 | 隔开表格的格子。
为什么要转成它?因为它是现在 AI 最爱读的格式。
让 AI 读 MD 文档,比直接喂 PDF 或图片要稳得多,AI 再也不用费力去“看图猜字”了。无论是 PDF 扫描件、手机拍的照片,还是各类 Office 文档或网页,都可以先用它转成 MD,再投喂给 AI。
02 它比普通 OCR 强在哪?
普通的 PDF 转文字工具,大多只能应付排版简单、字迹清晰的文档。
一碰到报表、合同、扫描件、复杂表格,转出来就没法直接用。
MinerU 的思路是:先看版面,再认字。
1. 表格还是表格
普通工具转表格,格子全塌,变成一串数字。
MinerU 会先认出"这里是一张表",按行列还原,能整理进 Excel。
2. 双栏不串行
很多 PDF 是两栏排版,普通工具从最左读到最右,左栏一句右栏一句,顺序全乱。
MinerU 按人的阅读顺序拼回去。
3. 扫描件直接认
没有文字层、复制不出一个字的扫描 PDF,它内置识别,直接转。
4. 页眉页脚自动去掉
页码、页眉页脚、脚注这些"噪音",自动剔除,正文是连贯的。
普通 OCR 只管"认字",MinerU 管的是"这份文档是怎么排的"。
03 有哪几种用法?先看文件去了哪
重点说一下客户端。
客户端只是网页版换了个窗口,文件照样要上传。实际工作中需要保密的资料还是建议本地部署
网页版和客户端,限制也一样:
单个文档不超过 200MB、200 页
单张图片不超过 10MB
一次最多 20 个文件
04 网页版怎么用:四步
打开 mineru.net,注册登录,在线使用。
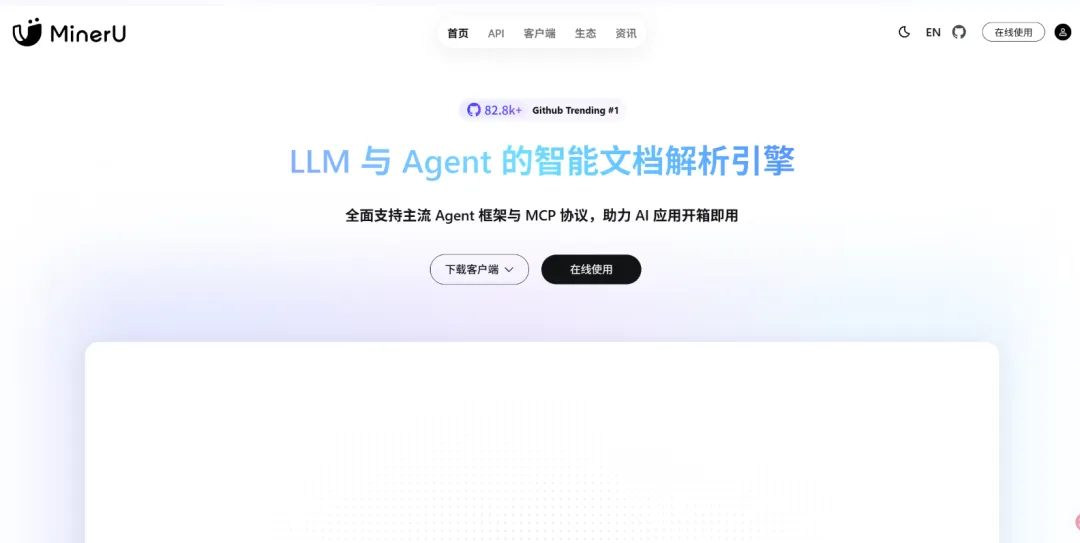
点「设置」看一眼:文档解析用默认的「MinerU VLM」(推荐);Word、PPT 默认走「原生解析」,官方说这样速度快、不会出错,一般不用动。
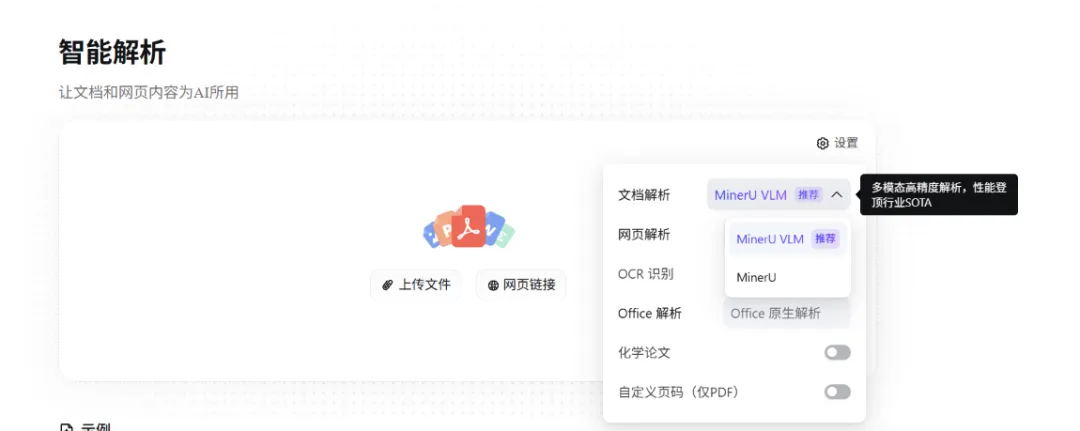
传文件:超过 200 页会弹窗让你填页码,比如先填 1-200,剩下的再传一次
对照、导出:左边原文、右边转好的文字,逐段扫一眼,没问题就下载 Markdown
转好的 MD 文件,丢给常用的 AI,或者传进上一篇讲的 Gemini Notebook,它读起来就稳了。
做审计和财务的伙伴们转完也别直接信,最好抽查看看,复杂表格、跨页表格错列等一定要回原件抽查。
APPENDIX
下一篇预告
下一篇讲:把 MinerU 装在自己电脑上。
附一份"装机说明书"提示词,贴给 AI,它一步步陪你装完;
审小黑的偷懒笔记
重复的活交给AI,判断留给自己。