ARTICLE · 1285391
AI软硬件科普
摘要 本文讲清大模型推理的软硬件全流程:文字怎么变成 token、为什么推理离不开 GPU、显存怎么估算、量化是什么、vLLM 这类推理框架在优化什么。看完你能自己估算"我这个模型要配什么卡"。
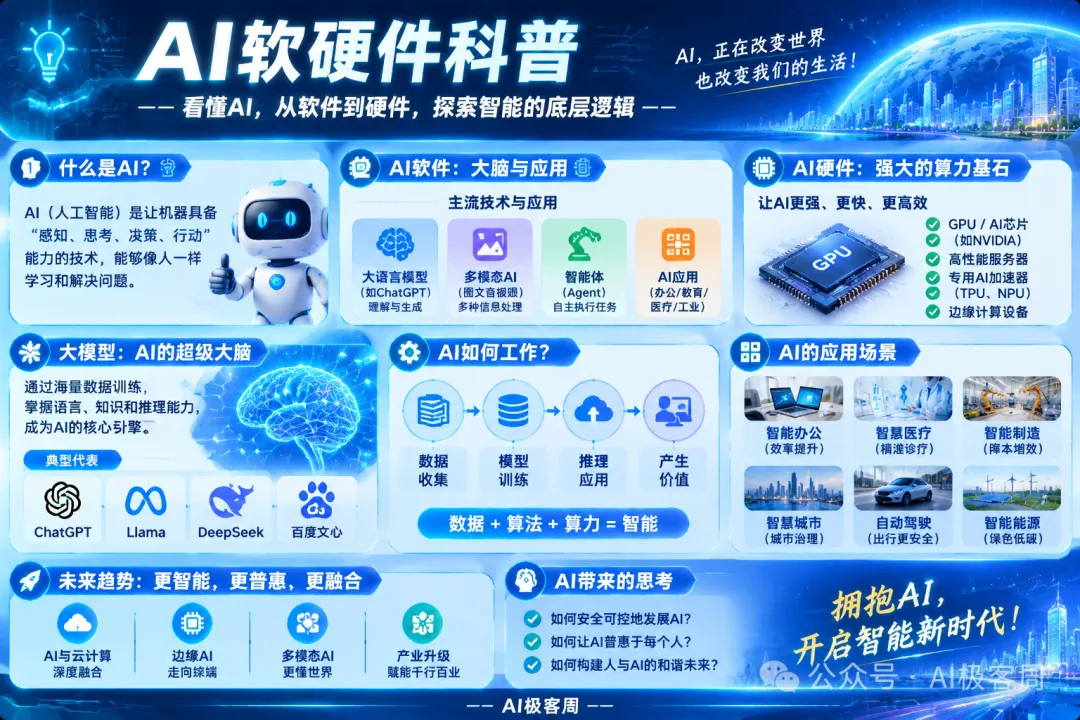
今天给大家做一期AI软硬件科普,你在对话框输入"帮我写一段会议纪要",两秒钟,答案一个字一个字往外蹦。这两秒里,你的话被切成小块、变成数字,在一块显卡的上万个核心里做了一连串矩阵乘法,再逐个字"猜"出来。绝大多数人天天用 AI,但从没看过后台这台戏。这篇就用大白话,把这套软硬件流程讲透。
记住一条主公式就够用:显存需求 ≈ 参数量 × 每参数字节数,再留三成余量给 KV Cache。7B 模型 FP16 约 14GB,量化到 4bit 只要约 3.5GB——"模型跑不跑得动",本质上是一道显存算术题。
01 软件侧:你的话先变成"数字"
大模型不认识汉字,只认数字。输入文字先被 tokenizer 切成 token——可以理解为"词块",一个英文单词往往是一个 token,中文大约一两个字对应一个 token。每个 token 再查表变成一个几百到几千维的向量,进入模型。
模型本体是什么?就是几百亿个带数值的参数。推理时做的事极其朴素:拿你的向量,跟这些参数做一层又一层的矩阵乘法。所谓"智能",数学上就是几十上百次超大规模矩阵乘法的叠加。
生成答案时是一个字一个字"猜"的:模型每次只算出"下一个 token"的概率,选一个,拼回句子,再算下一个。所以你看到答案逐字往外蹦,而不是一次性出现——不是排版效果,是工作原理。
02 硬件侧:为什么非 GPU 不可
矩阵乘法的特点是:单个运算简单,但数量巨大,而且彼此独立。这正好对上 GPU 的天赋——上万个核心同时开工,一个时钟周期做几万次乘加。CPU 核心少但单核强,干这种活相当于"用跑车运沙子"。
但很多人不知道:大模型推理的瓶颈往往不是算力,而是显存带宽。因为每生成一个 token,都要把全部参数从显存里完整读一遍——7B 模型 FP16 就是 14GB,"读一遍"的时间比"算一遍"还长。这就是为什么高端卡都在拼 HBM(高带宽显存):NVIDIA H100 SXM 版的 HBM3 带宽约 3.35TB/s(官方规格),是普通内存的几十倍。
提示 选卡的常见误区是只看算力(TFLOPS)。推理场景下,先看显存容量够不够装模型,再看显存带宽够不够快,最后才看算力。
03 显存不够怎么办:量化
最常用的招是量化:把参数从 FP16(每参数 2 字节)压到 INT8(1 字节)甚至 INT4(0.5 字节),用精度换体积。算一下:7B 模型量化到 4bit 后约 3.5GB,一张 8GB 的消费级显卡就装得下。
代价是精度有损失。主流 4bit 量化方案(GPTQ、AWQ)在多数任务上损失可控,所以社区部署小模型基本默认 4bit。经验法则是:INT8 几乎无损,4bit 大多数场景够用,再往下压就要拿自己的任务实测了,别只看跑分。
04 推理框架在优化什么
光有卡还不够,怎么把卡喂饱是门学问。以 vLLM 为例,它有两招最出名:
一是 PagedAttention(2023 年论文):多轮对话里,历史内容要以 KV Cache 的形式常驻显存,传统方式按最长长度整块预分配,浪费严重;PagedAttention 借用操作系统"分页"的思路,把缓存切成小块按需分配,论文数据显示吞吐可提升 2-4 倍(随场景浮动)。
二是 continuous batching:不等一批请求全部算完再放新的,谁算完谁的位置立刻补上新请求,GPU 几乎不空转。
这也解释了一个常见现象:对话越长越慢、越占显存——因为 KV Cache 随上下文长度线性增长,长文等于背着越来越重的包袱算数。
小结:大模型推理 = 软件把文字变数字,硬件用海量并行和显存带宽扛住矩阵乘法;显存是第一约束,量化是第一杠杆,推理框架负责把卡喂饱。
实操清单
1. 估算显存:参数量 × 每参数字节数(FP16×2、INT8×1、INT4×0.5),再乘 1.3 留 KV Cache 余量;
2. 7B 模型:FP16 约 18GB(14×1.3)→ 单张 24GB 卡稳妥;INT4 约 4.5GB → 8GB 消费卡可跑;
3. 自部署优先上 vLLM、SGLang 这类成熟推理框架,别拿裸 transformers 直接起服务;
4. 长上下文场景重点盯 KV Cache 占用,上下文长度不要拍脑袋给满;
5. 选卡先看显存容量和带宽,再看算力——推理大多是带宽瓶颈。
你部署过本地模型吗?卡在显存还是带宽?评论区报一下你的显卡和模型参数量,帮你算算跑不跑得动。
数据来源:NVIDIA H100 官方规格页(HBM3 带宽约 3.35TB/s,SXM 版);vLLM 论文《Efficient Memory Management for LLM Serving with PagedAttention》(SOSP 2023);GPTQ、AWQ 量化论文及开源社区通行实践。显存估算公式为通用工程经验法,实际占用随框架、并发与上下文长度浮动,非本人实测。