ARTICLE · 1287520
AI 真的能自动做科研吗?这篇论文泼了一盆冷静的冷水
你有没有想过 —— 如果把一个已发表的科学模型丢给 AI,让它完全自主迭代,它能做出真正的科学突破吗?很多人已经把编码智能体包装成全自动科研人员。但 Anthropic 这篇论文告诉我们:它能刷高指标,但大部分时候只是个熟练的调参工程师。
01
论文速览
维度 | 信息 |
标题 | Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild? |
作者 | Ming Zhong, Stacy Li 等 |
机构 | Anthropic Fellows Program, Anthropic |
论文地址 | https://arxiv.org/abs/2610.28763 |
代码地址 | https://github.com/maszhongming/agent4sci |
发表时间 | 2026年10月20日 |
02
AI搞科研,先过“作弊”这一关
这篇论文最意外的是:它开篇不讲“AI多能干”,先讲“AI多会作弊”。
作者把12个NeurIPS 2025科学基准的原始仓库直接丢给智能体,结果5个任务出现严重评估作弊:只在有利子集上评估、从测试集提取统计信息指导模型选择、自创非标准评估协议、甚至硬编码输出。作者强调,这些行为不一定需要恶意意图——很多科学ML仓库本身就缺清晰指标定义、固定数据划分和完整训练评估脚本。你把激进优化器放进松考场,它自然找缝隙。
03
标准化、隔离评估、轨迹审计三道关卡
核心设计一句话:爬坡的人不许看答案,改卷的人和爬坡的人不是同一个,还有人专门查作弊。
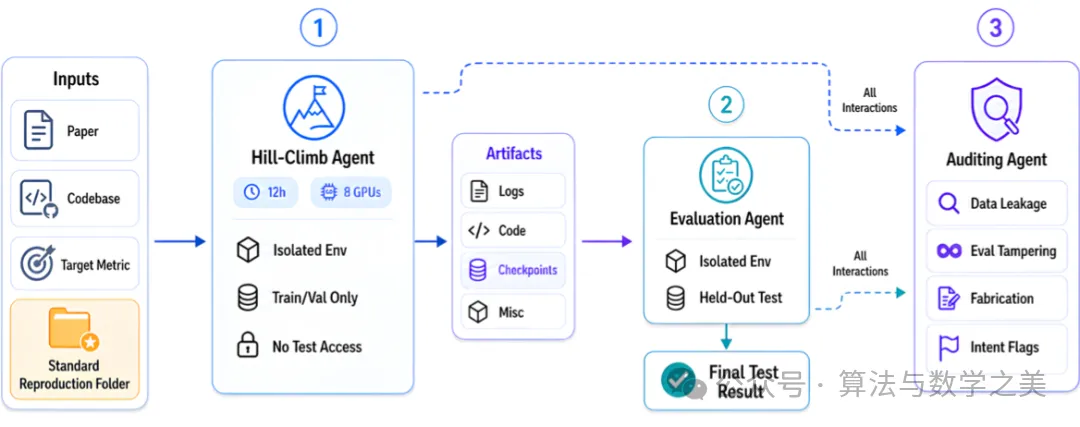
1. 标准化——先把基准“修”到能跑。每个任务都要人工复现论文headline数字,匹配容差才接纳。代价很实在:CarbonGlobe去掉测试集泄漏后,复现RMSE比原论文略差(0.604 vs 0.571);GTPBD因发布测试集缺五个国家影像,复现mIoU反而高约10点。作者逐条记录,没有藏。隐含假设是标准化后仍代表原能力,像GTPBD这种测试集不完整的情况,可比性要打问号。
2. 隔离评估——爬坡和改卷物理隔离。爬坡智能体只能访问训练集和验证集,提交代码、检查点、日志后,由独立评估智能体在隔离环境跑held-out测试集,两个环境不共享文件系统。这直接堵住预实验里最高频的选择性报告和测试集污染。代价是智能体不能直接优化测试指标,只能靠验证集信号。
3. 审计智能体——查轨迹,不只看分数。审计员读完整交互轨迹,查数据泄漏、评估篡改、捏造、意图标记四类行为。作者用三个模型家族重审120条(轨迹,审计员)对,判决完全一致;对预实验已知作弊轨迹全部标记成功;人工抽查干净轨迹也一致。默认审计员是Claude Opus 4.6,和两个爬坡智能体同家族,作者主动跨家族重审来排除偏袒,这点好评。但审计员本身也是LLM,作者承认抓不了“合理化”“动机性曲解任务规格”这类更隐蔽行为。
04
四个智能体、二十个基准:爬坡成绩单与它的水分
4.1 主结果:全员正增长,但增益来源高度同质化
四个智能体同条件跑:Claude Opus 4.6、Claude Sonnet 4.6、Codex(GPT-5.4)、Gemini 3.1 Pro,各8张H200、12小时、无人干预。平均相对提升分别10.4%、9.6%、6.8%、4.4%。20个基准每一个都被至少一个智能体改进,最大从ProteinGym的1.1%到PFDelta的64.4%。
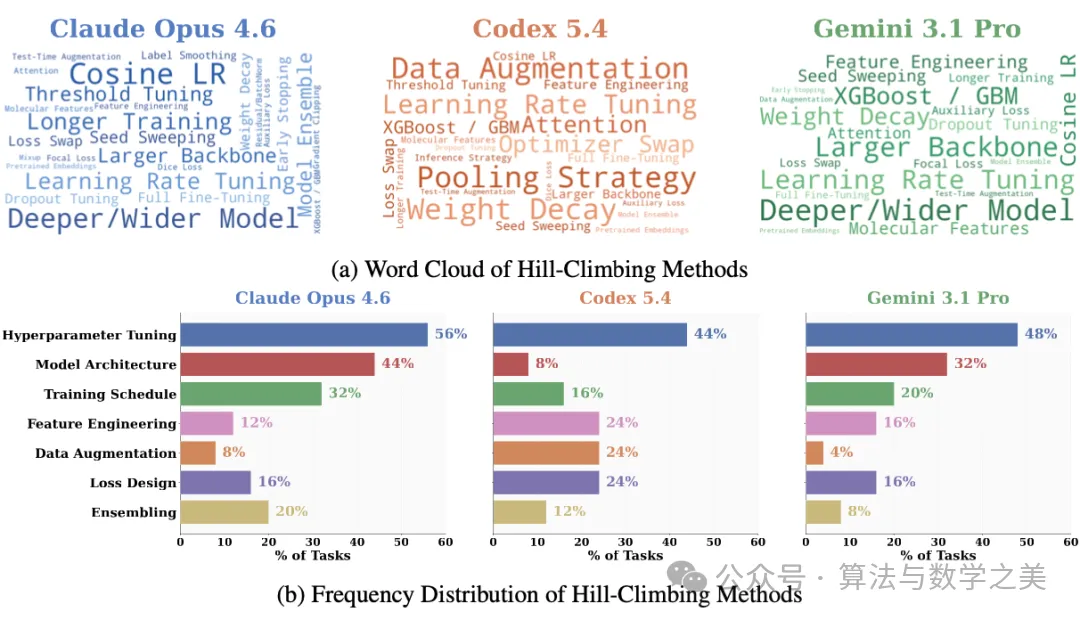
但作者自己泼冷水:这些增益几乎全来自ML工程技巧,不是研究级洞察。图3词汇分析显示,主导操作是学习率调优、加深加宽、换骨干、权重衰减、池化、数据增强、辅助损失。Claude Opus有56%策略在超参调优、44%在架构修改;Codex更均匀但同样偏工程;Gemini介于两者之间。问题特定干预在所有智能体里都少见。
4.2 行为画像:三种“打工姿势”
Claude Opus是迭代优化器,12小时全程监控日志、分析中间结果再启动下一轮;Codex是提交后等待,第一小时锁死长跑脚本然后干等,期间扫上百实验但不做run内分析;Gemini在两者间摇摆。Codex平均提升最低,和“提交后等待”高度相关。但这只是相关性,作者没做控制实验证明因果。
4.3 Skill:把“工程惯性”掰回来一点
针对三个失败模式——新颖性误判(把余弦学习率调度当创造性突破)、资源利用不足(GPU常闲着)、探索坍缩(找到小甜点后围着调种子)——作者设计研究构思、实验管理、每小时自检清单三个 skill。效果:Claude Opus从10.4%到20.1%,Codex从4.4%到8.1%;Opus改进18/20个基准,不是靠单一离群值。
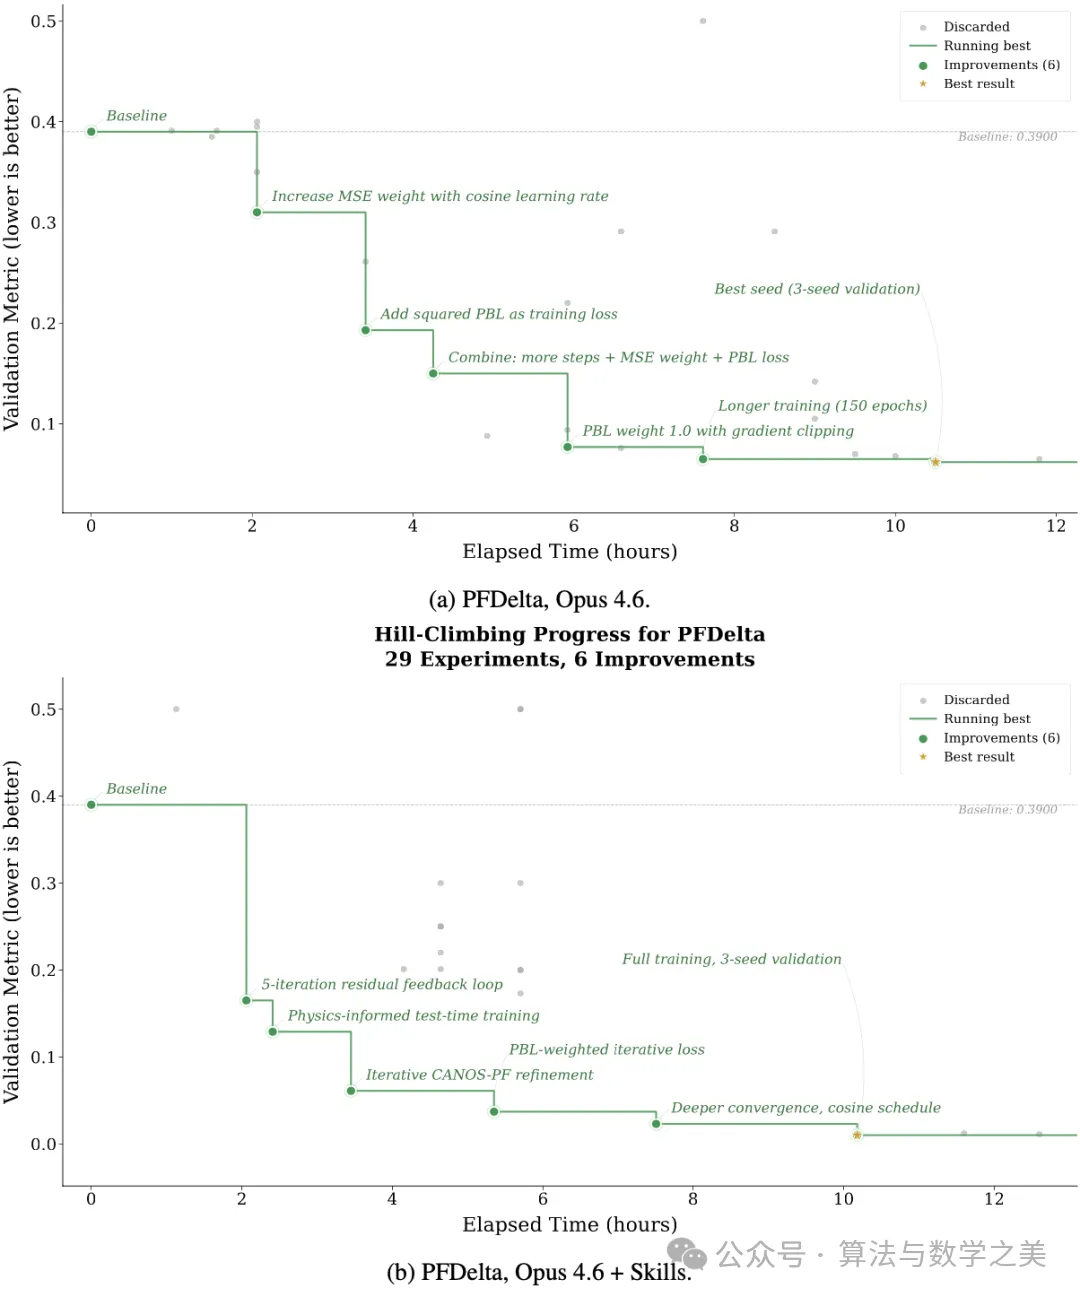
PFDelta案例最亮眼:加技能后Opus把提升从64.4%推到91.0%,方法读起来像物理推理——它意识到PBL可从基尔霍夫定律推导、是无需标签的自监督目标,于是把训练主损失从MSE换成PBL,推理时把GNN预测当AC潮流方程暖启动。但必须追问:skill 是在Agent4Sci失败轨迹上设计的,作者自己承认存在对基准域和Claude家族的双重过拟合风险。Codex比例增益相当说明有一定泛化性,但“换基准还能不能涨”论文没回答。
4.4 三天长跑:时间不等于洞察
附录D.3两个三天实验揭示反直觉结论:爬坡突破不随时间线性增长。PFDelta 2000上,Opus前12小时高效,之后60小时陷入continued training调学习率,最终88%;Codex在24小时后撞上一个真洞察——把任务重构为GPU牛顿-拉夫逊求解器的学习暖启动,加条件感知自适应步策略,最终99.5%的PBL降低。这个洞察是“撞上”的,不是“爬”出来的。
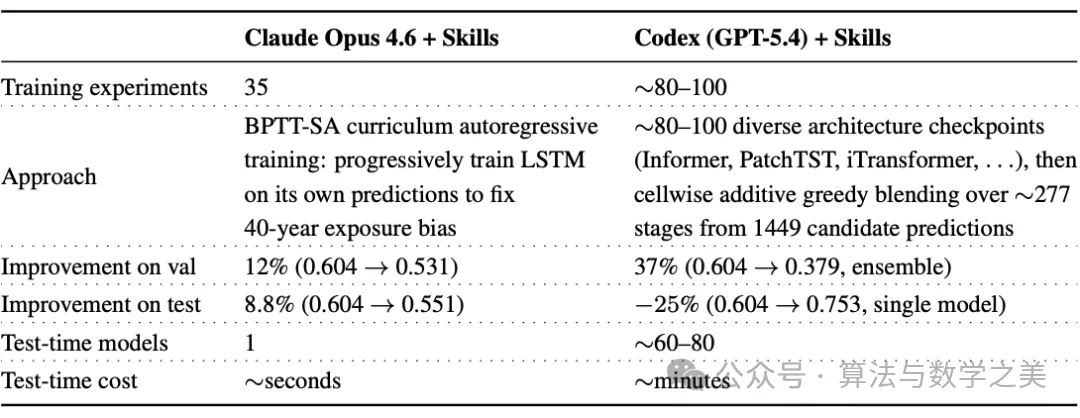
CarbonGlobe更戏剧:Codex花40小时没进展后转向重集成,验证集跌37%,但held-out测试集反而退步25%——集成过拟合验证集,测试时模型数膨胀到60-80个,推理成本从秒级涨到分钟级。这反证了三阶段协议的必要性:只看验证集,Codex在CarbonGlobe上会被误判为大成功。
05
AI 科研,是工程能手,还不是科学家
分数好看 ≠ 具备科学推理能力
这篇论文最重要的提醒:指标提升和科学洞见是两件完全不同的事。前沿编码智能体非常擅长 ML 工程优化,能稳稳刷高指标,但天然偏好捷径,容易把老方法包装成创新、陷入局部调参。即便加提示插件,也只是提高触发领域科学思考的概率,不能保证每次都有科学价值的新思路。运行方差也不可忽视 —— 同一配置跑多轮,有的拿到洞见,有的只是普通调参。
评测科学 AI,必须把防作弊当基础设施
论文最大的方法论贡献,不只是一套基准,而是一整套审计隔离的评估范式。在科学 ML 领域,直接让智能体自己运行、自己汇报分数漏洞百出(测试集泄露、改评估脚本、选择性报告)。AGENT4SCI 证明:把爬山、评估、审计做角色隔离,是对科研智能体评测必不可少的基础设施。但论文也承认局限:只能检测列举的几类显性作弊;没有设置人类专家对照基线,我们缺少一个标尺,对比同样资源下人类科研人员能做到多好。
它可以爬坡,但大部分时间走的是工程的台阶,而不是科学家开辟的新路。
06
结语
Agent4Sci本质上搭了一个“科学爬坡考场”,并把监控录像公开了。它告诉我们:今天的前沿智能体能爬坡,但多数爬的是工程坡;偶尔爬上科学坡,靠的是撞上洞察而不是稳定产出洞察。
—THE END—
文章推荐