ARTICLE · 1287718
国产 GPU 能不能打,重点在软件栈
点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
前几天的时候,天数智芯办了一场媒体开放日。会议主题围绕着四个字展开:从模型到世界。
这场发布会讲了很多内容,比如云端芯片天垓 300 通用 GPU、IXL144 超节点、异构计算平台、彤央 TY1000 / TY1100 算力模组等,确实了解到了很多关于硬件、GPU、超节点方面的内容。
但关注我的读者大部分都是搞软件出身的,所以我特别想聊聊发布会中的软件栈这个东西,这也是我最关注的模块。
先看一张全景图
先放一张全景图给大家看下
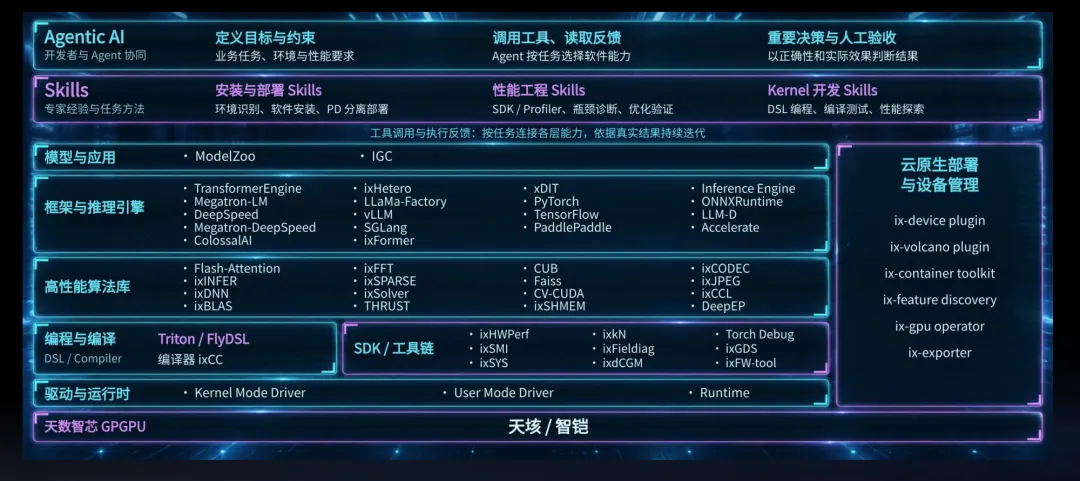
天数智算软件栈全景
从下往上看:最底层是天垓与智铠,训练和推理两条产品线共用同一套栈;往上是驱动与运行时;再往上是编程与编译、高性能算法库、框架与推理引擎、模型与应用;
最上面两层才是这一代新增的:Skills和 Agentic AI。
值得注意的是那些 ix 前缀的名字:ixCC 编译器,ixBLAS / ixDNN / ixINFER / ixFFT / ixSPARSE / ixSolver 算子库,ixCCL 集合通信,ixSHMEM 共享内存,ixSMI / ixHWPerf 设备管理与性能分析。对照 CUDA 那一套就好懂了——nvcc、cuBLAS、cuDNN、TensorRT、NCCL、nvidia-smi、nsys,位置一一对应。
框架一侧尽量贴着现成的生态:PyTorch、TensorFlow、PaddlePaddle、vLLM、SGLang、DeepSpeed、Megatron-LM、LLaMA-Factory、ONNXRuntime。
右边单独一列是云原生部署与设备管理:ix-device plugin、ix-volcano plugin、ix-container toolkit、ix-gpu operator、ix-exporter。看名字就知道是 Kubernetes 那一套,设备插件、调度器、容器工具链、监控导出。
这就回到了那个问题:Agent 为什么能装环境、能调优、能写 kernel?因为它下面有整套技术栈,可以调用、可以读反馈、可以验证结果。Agent 是门面,软件栈是底座。
软件栈要解决的三件事
天数智芯自己把软件栈的价值拆成三层:
• 可用:环境就绪,服务跑起来;
• 高效:识别瓶颈,释放实际性能;
• 持续进化:跟随模型和应用的创新。
对应三个"Easy":Easy to Use、Easy to Optimize、Easy to Develop。
下面四段演示,正好分进这三类:安装和部署是能用,调优是好用,算子开发是能改。
第一段:智能安装
手动安装时,人一步一步敲命令、选组件,中间遇到报错、中断重装,再重新执行。
换成 Agent 之后,开发者只给一句目标。Agent 调用安装工具、读取执行结果、处理遇到的问题、最后检查环境是否可用。同一个案例:人工操作 1 句指令、人工排障 0 次、总用时 4 分 40 秒,过程中的 3 个问题由 Agent 自动处理。
第二段:智能部署
在智能部署这块,场景更贴近生产:把一个 PD 分离的推理服务从零跑到能对外响应。
如果按照人工经验估计 ≥1 小时,实际 20 分钟以内;操作从数十步压缩到 2 步。最后浏览器里已经能打开 Open WebUI,模型是 Qwen2.5-7B-Instruct。
第三段:智能调优
在调优这块,Agent 先采基线、分析耗时,再对采样、同步等环节动手,然后复测。
最后的结果是:稳态窗口时间下降 45.82%(3.5877s → 1.4491s),Top-3 热点 kernel 里 scan 降 99.0%、radix sort 降 100%、mr_fast_gemm 降 19.6%,同步开销从 2346.4ms 降到 0,GPU 利用率从 60.5% 提升到 72.8%,API 时间从 3923ms 降到 1159ms。
如果按照正常人工调优来说,这个实例的经验估计是 1 周,Agent 辅助下不到 2 小时完成分析、优化与验证。
第四段:智能开发
第四段最难,也最能说明这套东西成色的:算子开发。
演示的路径是:结合 SGLang 跑起模型、建立性能基线、定位瓶颈,再围绕瓶颈尝试优化。
结果有两组:
一组是优化前后对比:TTFT 中位数 100.8 → 98.3ms(降 2.5%);gate_up 配对微基准 M=1 降 1.1%、M=16 降 1.3%;gate_up 的 data_load(CUPTI 口径)从 92.6% 降到 83.9%,降 9.4%。
另一组是自研算子库 ixaite 与 torch 的对比:9 组形状上 ixaite 全部更快,最高 1.39×。
如果按照正常人工开发来说:原预估 10 人天,Agent 辅助下不到 2 小时完成;候选实现的编译反馈时间下降 90% 以上,最终正确性与性能均通过验证。
顺带说一个技术细节:演示里提到了 FlyDSL。
FlyDSL 是一套用于编写 GPU 计算内核的 Python DSL 与编译技术,能帮助开发者用更结构化的方式表达计算意图。
天数智芯是国内首个深度接入 FlyDSL 的 GPGPU 厂商。
深度接入要参与编译链路、要能把编译结果、正确性和性能反馈接进 Agent 的循环中。DSL + Agent 的组合,做的事情是围绕计算任务探索候选实现 → 读编译和正确性反馈 → 用实测性能指导下一轮。
成绩单
软件栈好不好用,最终是要体现在速度上的。演示里用了一套浏览器端的测速工具(界面叫 LLM SPEEDTEST),同一时刻、同一套参数,把天垓 300 和 H100/H200 放在一起跑。
三个场景,三份结果。
场景一:训练
左边跑 H100,右边跑天垓 300,同一个训练任务、同样的 global batch size 256,跑 100 个 iteration,看每次迭代的耗时。
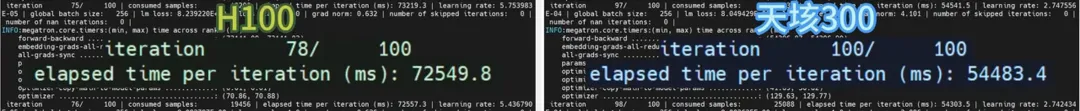
训练实测:H100 与天垓300 每迭代耗时对比
• H100:iteration 78/100,72,549.8 ms / iteration;
• 天垓 300:iteration 100/100,54,483.4 ms / iteration。
同一个任务,天垓 300 的单迭代耗时只有 H100 的约 75%,折算下来单迭代吞吐高约 33%。
训练是软件栈最硬的考场:框架、通信、算子、调度,任何一层掉链子,迭代时间都会立刻变难看。这一组说明的不是某个 kernel 快,是整条链路一起跑满。
场景二:文生视频
第二个场景换成了生成式负载:1024×576、20 步去噪、5 秒、24FPS。
• 天垓 300:平均完成时间 24.73 s,其中模型耗时 2.426 s、纯生成耗时 4.779 s;
• H200:平均完成时间 25.23 s,其中模型耗时 2.378 s、纯生成耗时 5.046 s。
总时间几乎打平;细看的话:纯生成这一段,天垓 300 是 4.779s,H200 是 5.046s
也就是说,总耗时的大头在计算之外,排队、传输、调度、视频编码,每一项都很占用时间。这也解释了为什么这类演示要拆成模型耗时 / 生成耗时 / 平均完成时间三个指标。
场景三:LLM 推理
第三个是最贴近日常的:长上下文、并发 16,测解码速度和整轮吞吐。
| 52.2 tok/s | ||
| 622.0 tok/s | ||
| 5.65 s |
虽然三项都在前面,但幅度不一样:decode 均值高约 7%,整轮吞吐高约 4%,平均总耗时少了 1.19 秒。
写在最后
回到最开始那个问题:Agent 为什么能装环境、能调优、能写 kernel?
路径分为四步:理解环境 → 组织步骤 → 处理反馈 → 验证目标。
对应到工程上,需要三种机制:
1. 可调用的工具:安装、部署、profiling、编译,都得是 Agent 能调用的命令或 API;
2. 可读的反馈:报错、日志、性能计数器,知道下一步要做什么;
3. 可验收的标准
环境、配服务、调性能、写算子,这四件事是成本开销的大头,而且它们的经验是踩了无数次坑的人才具备的,而天数智芯这次要做的,是把这些经验固化成工具、Skills 和验收规则。
如果这件事真做成,国产 GPU 的竞争力就不只在跑分表上,而在交付了多少项目上。
从模型到世界,中间隔着的其实不是算力,是这条从驱动到 Agent 的路,这才是最重要的。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。