ARTICLE · 1293029
你以为 AI 让你快了 20%,计时器说慢了 19%
读完 METR 这篇对照实验,我先记下这一点:人连自己快没快,都量不准。
三个数字并排放:
·允许用 AI 时,完成同样任务要多花约 19% 的时间;
·开干之前,开发者预测自己会快 24%;
·做完之后,他们仍估计自己快了 20%。
计时器和自我感觉差了将近 40 个百分点。周报里写「本周 AI 提效」,未必在撒谎,更像是被体感骗了。我也干过:看完一堆 diff 觉得很猛,一对钟,大半时间花在读、改、重跑上。
这组数来自评估机构 METR 在 2025 年初做的随机对照试验。
图:METR 博文首页标题与「多花约 19% 时间」结论;页内已提示结果过时。
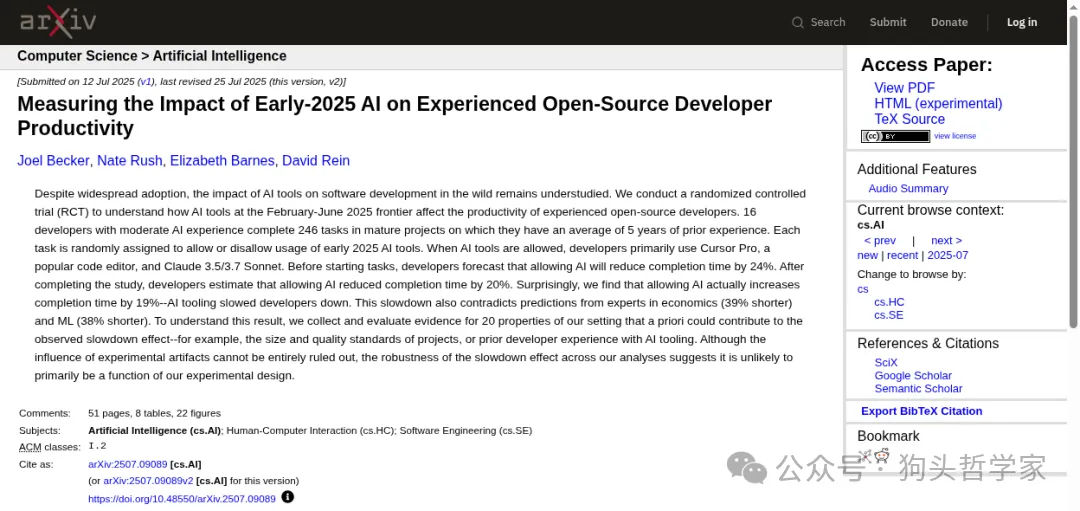
图:arXiv:2507.09089 摘要页——事前预测约快 24%,实测约慢 19%。
实验怎么做
他们招了 16 名资深开源开发者——人都是在自家长期贡献的成熟大仓上干活(仓库平均约 2.2 万 star、百万行量级代码,人均相关经验约 5 年)。开发者先报出真实 issue:修 bug、加功能、重构,一共 246 个任务,平均每个大约两小时。
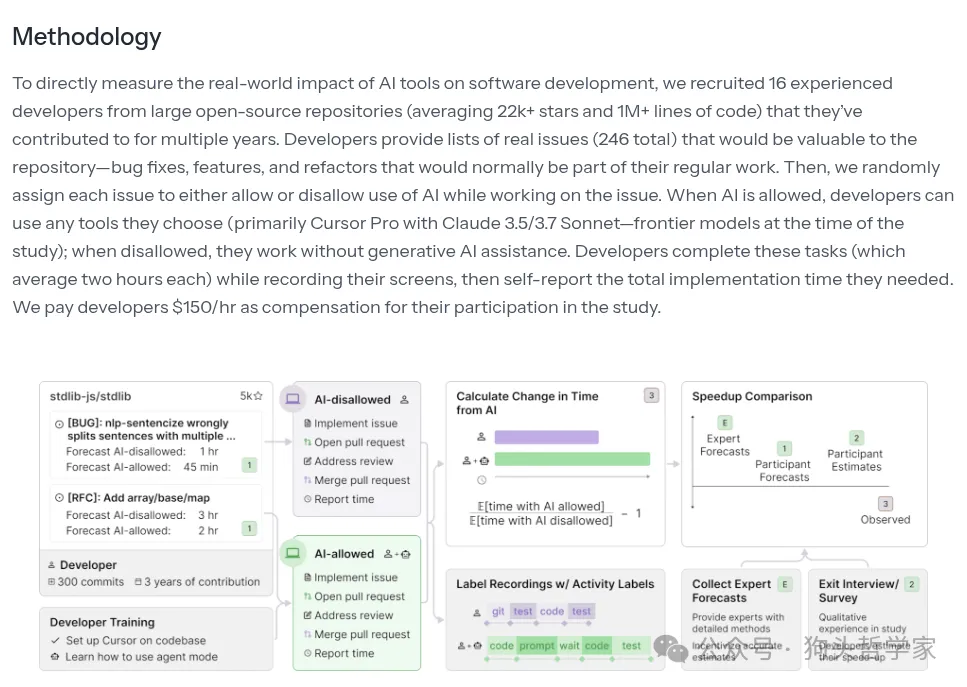
图:官方博文方法说明与实验设计示意。
任务先定,再随机分到「允许用 AI」或「禁止用 AI」。这样不容易把「拆成更多小任务」「写得更啰嗦」误当成提效。允许 AI 时,可以用当时的前沿工具——研究里主要是 Cursor Pro + Claude 3.5/3.7 Sonnet(2025 年 2–6 月那一档)。禁止组不用生成式 AI。屏幕录下来,自己报实现耗时;报酬当时是每小时 150 美元。
被试大多用过大模型,但并不都是重度 Cursor/agent 用户:约 93% 用过,约 44% 有 Cursor 经验。有工具底子,但不是人人都是 agent 老手。
结果:慢了,还以为快了
允许用 AI 时,完成时间约 +19%(更慢)。
事前预测自己会快 24%,做完仍估计快了 20%。经济与机器学习方向的专家事前也大幅高估加速(官方解读里分别约缩短 39%、38%)。体感、专家判断、计时器,对不上。
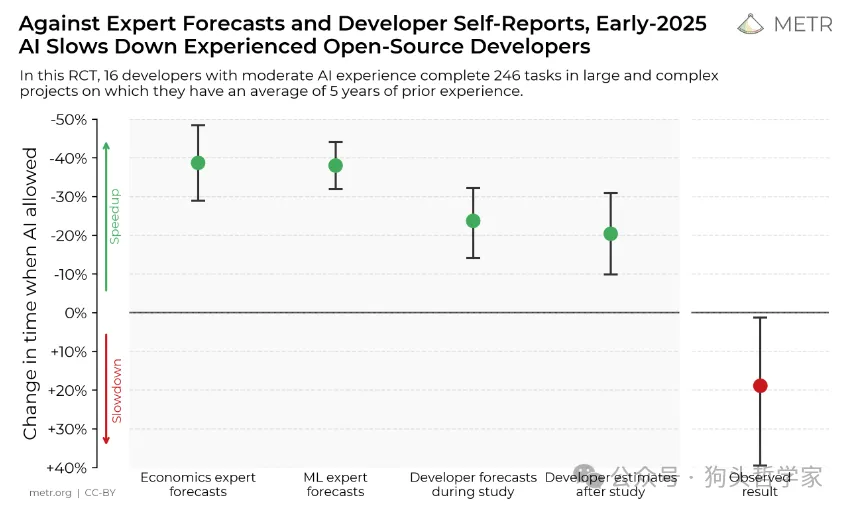
图:专家/开发者事前预测的加速幅度,对照实测约 +19% 耗时(更慢)。来源:METR 博文配图。
他们把结论钉在这一帧:2025 年初、资深开源、成熟大仓、真实 issue。不覆盖大多数软件开发、不覆盖别的行业、不锁定以后一定慢,也不否定现有工具可能有更好用法。
为什么可能更慢、为什么会误判
他们筛了二十来个可能因素,更像真在拖时间的有:成熟仓库质量门槛高、熟悉自己代码的人本来就快、AI 建议要反复核对、工具工作流本身有摩擦。也排除了不少假线索——比如 AI 组并没有故意扔掉难题,两边合入质量也大致可比。证据有强有弱,没有单一元凶。
误判更好解释:AI 不断给你「我在推进」的反馈——代码蹦出来、diff 刷屏、对话很热闹。忙不等于快。逐段标注屏幕录像时,读建议、改建议、对齐仓库规范,往往比「生成」本身更长;记忆却更爱留住生成那一下。
校准失灵:你以为在加速,计时器说你在绕路。
企业现场:完成任务数约 +26%
同一年前后,另有一组公开实验,结论方向相反。
Cui 等人在 Management Science(2026)报告了三场企业现场实验:微软、埃森哲,以及一家匿名世界 500 强,合计约 4867 名开发者。随机给一部分人智能代码补全助手,合并后完成任务数大约 +26%;经验较少的人采纳率和增益更大。
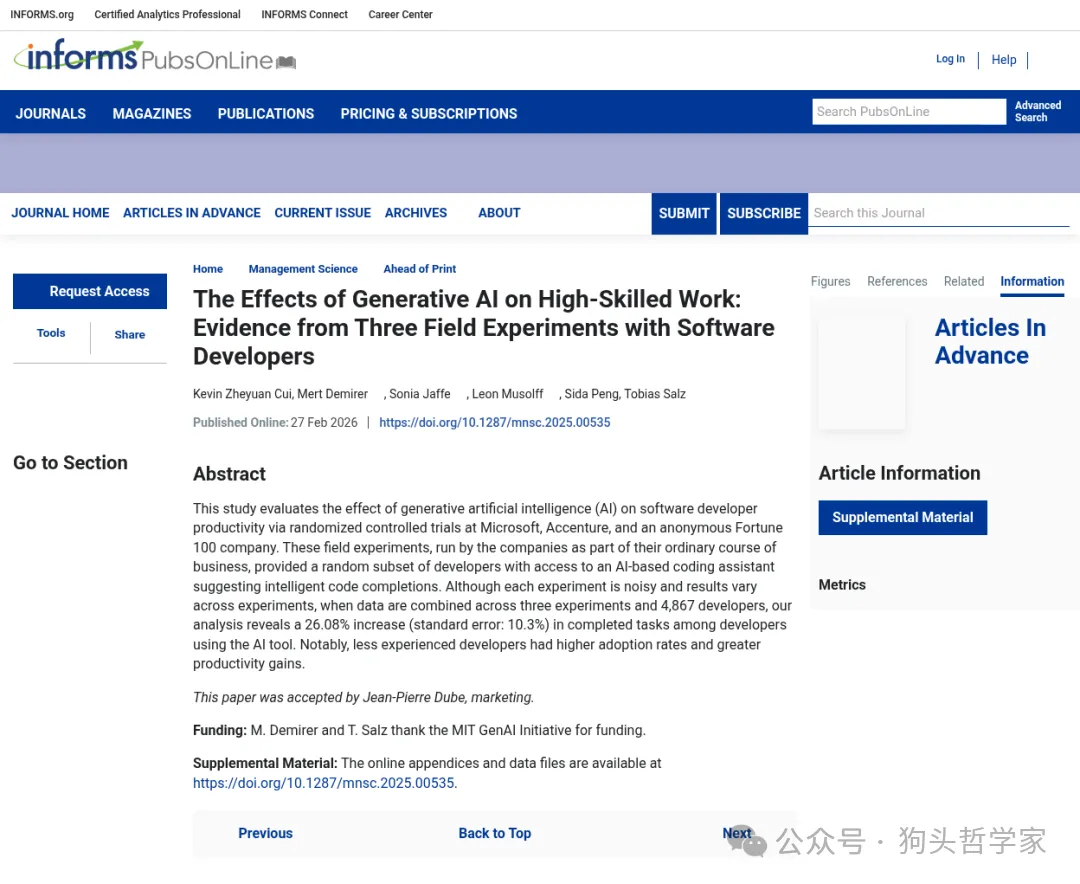
图:Management Science 公开摘要页(三场企业现场实验)。
两篇度量不一样:METR 盯同一批真实 issue 的耗时;企业实验盯完成任务数量,工具更偏补全助手,人也是大厂混合人群。一边问「同一个活会不会更快做完」,一边问「单位时间能清掉多少单」。场景一变,百分比就会翻面。
「提效」没有单一百分比。 只记得对自己有利的那一个,和开发者事后仍报快了 20%,是同一种自我叙事。
装 agent,不等于吞吐上去
装 agent 往往只让写代码变快;合并吞吐真上去,靠测试、评审、CI、规则、自动合并整条链一起改——之后瓶颈还会挪到「该建什么、谁拍板」。METR 的「变慢」、聊天框里的「感觉在加速」、企业实验的「完成数上去」,并排放,看的是不同边界。
可执行自检
别急着在周报里写「AI 提效 xx%」。可以先做这几件:
1.先定任务再开工具。 任务描述写完、接受标准写清,再决定用不用 AI。先聊后拆活,很容易把拆票当成产出。
2.同一类活抽几单计时。 允许 AI/尽量不用,各做几单同难度的,只比实际耗时。样本量不用大,够打脸自己就行。
3.把「读改重跑」单独记账。 生成很爽;核对、对齐规范、修测试才是常驻成本。
4.周报只写可复核的。 合入数、回滚、缺陷、评审轮次,比「感觉快了」硬。感觉可以写在备注,别写在结论句。
5.换场景就换预期。 生疏小脚本、补全密集型活,和企业大仓资深维护,对应不同的百分比区间。
快照会过期,校准习惯不过期
METR 在 2026 年 2 月发了续作:想用更新工具重测,但信号变脏了——越来越多人不愿在「禁止 AI」条件下干活,高预期会变快的活干脆不送进实验;报酬从每小时 150 美元降到 50,也可能加剧人选偏差;有人并行多个 agent,自报耗时更不可靠。粗看像转为加速,但区间宽、偏差方向清楚,官方自己说:不足以可靠估计当前加速幅度。访谈里他们更倾向相信 2026 年初比 2025 年初更容易加速,同时承认这是很弱的证据。
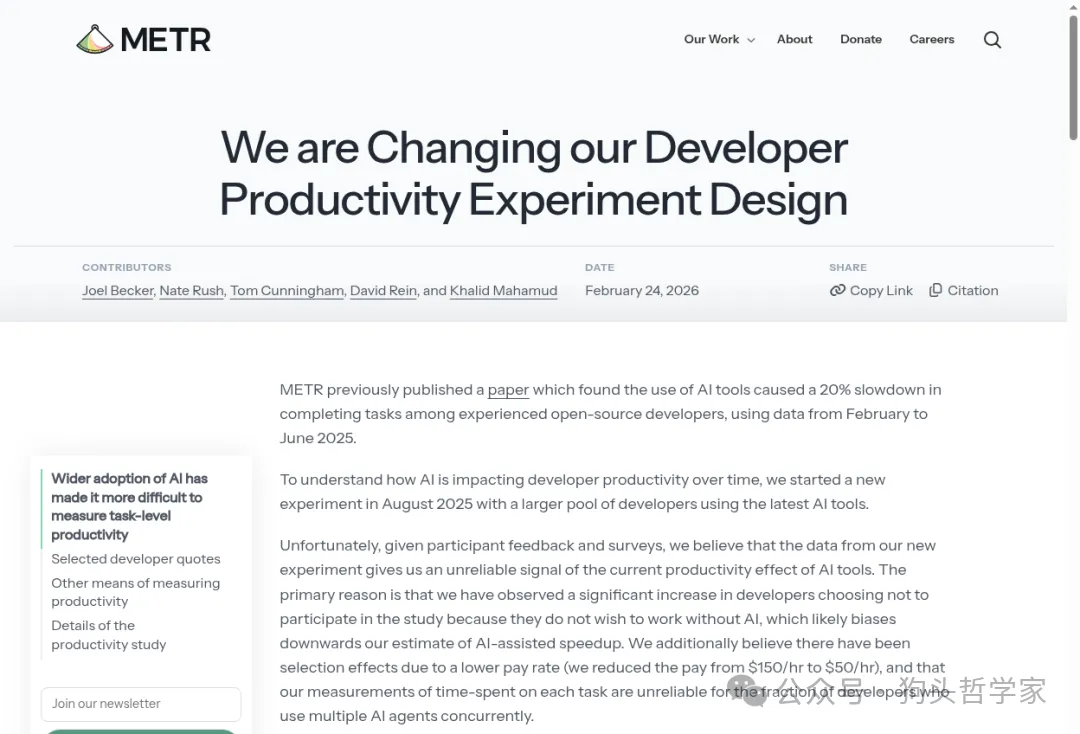
图:2026 年 2 月官方更新——人选偏差等使新实验难以可靠估计加速幅度。
2025 上半年那张多花约 19% 的快照,METR 已标明过时;2026 的新数,又被人选偏差拧歪。 能拿走的是这一条——
还没计时之前,别太信自己的提效故事。
16 个人、246 个任务,外推不了全体白领,也裁判不了你司下季度的 Copilot 预算。它只做了一件事:把「我感觉我很快」按在计时器上搓了一下。
—
据 METR 公开博文与 arXiv 预印本、以及 Cui et al. Management Science 公开摘要改编;非合作、非投资建议。工具名仅作研究时点说明。