ARTICLE · 1293028
我被一套 AI 配图的规矩,折腾了三个晚上
上周三晚上十一点多,我在给一套课程材料配图。
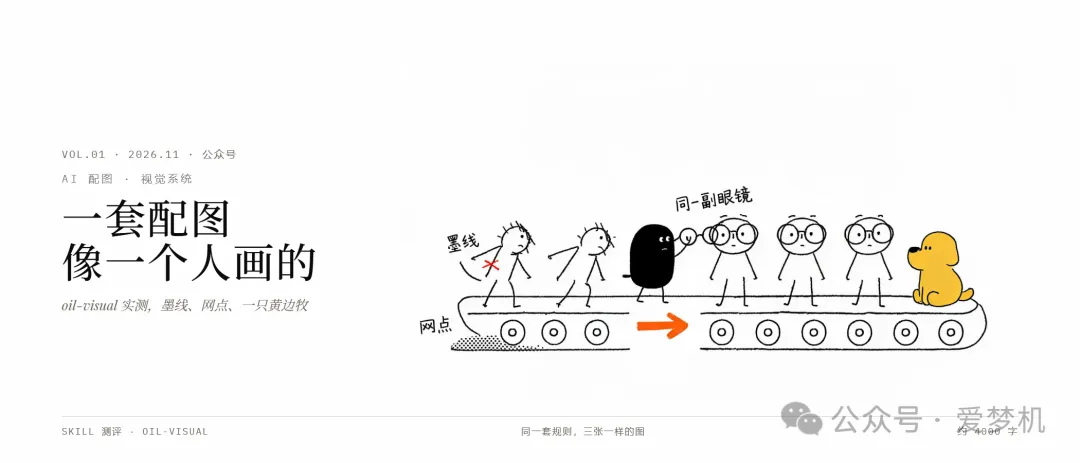
五张。第一张粗线条,第二张变成细马克笔,到第三张,画风已经完全像换了个画师,还凭空多出一只长得像柯基的狗。第四张我放弃了,直接从图库拖了张照片塞进去。
整份材料读下来,像一个五人小组各自交了各的作业。
我当时就愣住了。不是生气,是那种特别熟悉的无力感,同一个模型,同一段提示词,前后就隔了十分钟,它给我五张来自五个平行宇宙的图。
这三年我一直在跟这件事打交道,也一直以为问题出在模型。它还不够听话,它还不够稳,等下一代就好了。
我猜不止我一个人干过这种事。凌晨一点,明天要交一份课件,或者要发一篇笔记,你在素材库里翻了半小时,翻到眼睛发酸,最后挑中一张「大概还算像」的图,安慰自己说观众不会在意。
观众会在意的。
他们不会说你这张图风格不统一,他们只会觉得这份东西有点草率,然后划走。
这话听着有点刺耳,但我是真的这么觉得。
上周我把这个结论推翻了。
推翻它的东西叫 oil-visual,是别人写的一个配图 skill,我拿它跑了一张图。看到结果那一刻,我第一个反应不是「画得真好」,而是「等等,画风居然没变」。
坦率的讲,那一下给我整不会了。
先说清楚它是个什么东西。它不是模型,也不是某个网站,它就是一个文件夹。里面有一份 SKILL.md,写了这套图该怎么描述、提示词该怎么拼、出问题该怎么改,还有七张示例图,一个抠图脚本,叫 cutout.py。
就这么点东西。
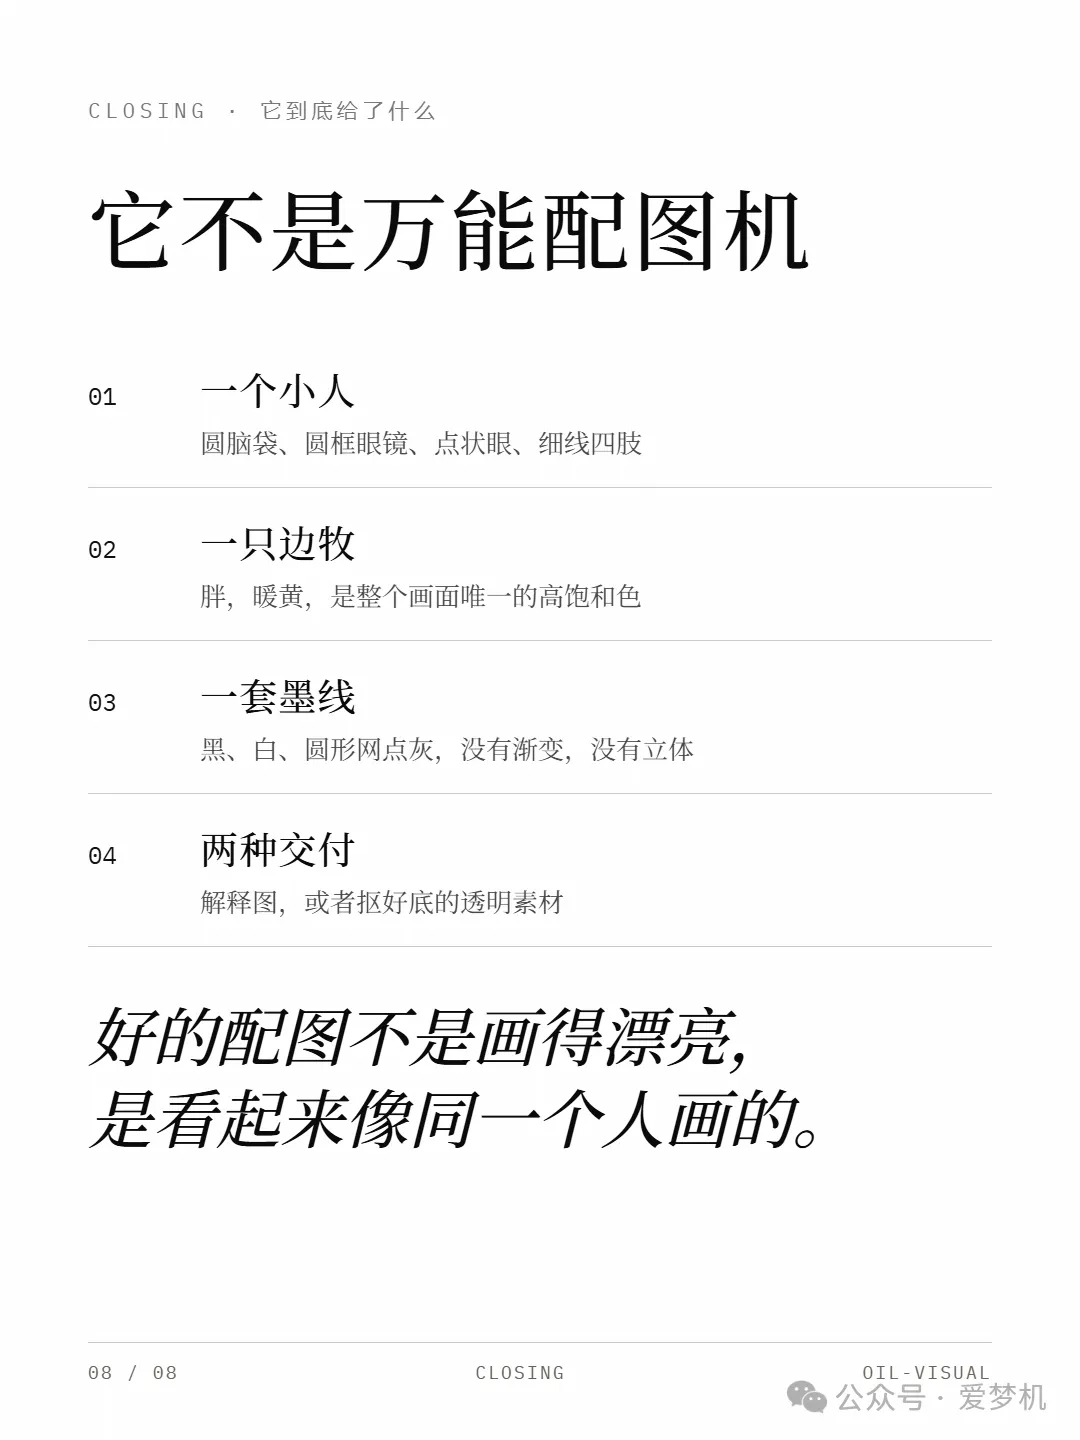
但这份文件里的规矩,写得非常死。黑色的漫画墨线,粗细要有变化。灰的地方不用渐变,用那种老印刷品上的圆形半调网点。主角是一个火柴人,圆脑袋,细圆框眼镜,点状的眼睛。旁边永远跟着一只胖胖的暖黄色边牧。整张图的底色只有黑白灰加暖黄,另外最多再给你两种语义色,蓝色代表输入的东西,橙色代表动作或者代价,绿色代表成功的结果。
我一开始觉得这不就是限制创作吗。
后来才反应过来,我要的根本不是创作,我要的是「这五张图看起来像同一个人画的」。
你想想看,一个 agent 读完这份文件,等于领到了一支固定的笔。它下一次再画,还是这支笔。
顺着这个再聊聊它是怎么干活的。
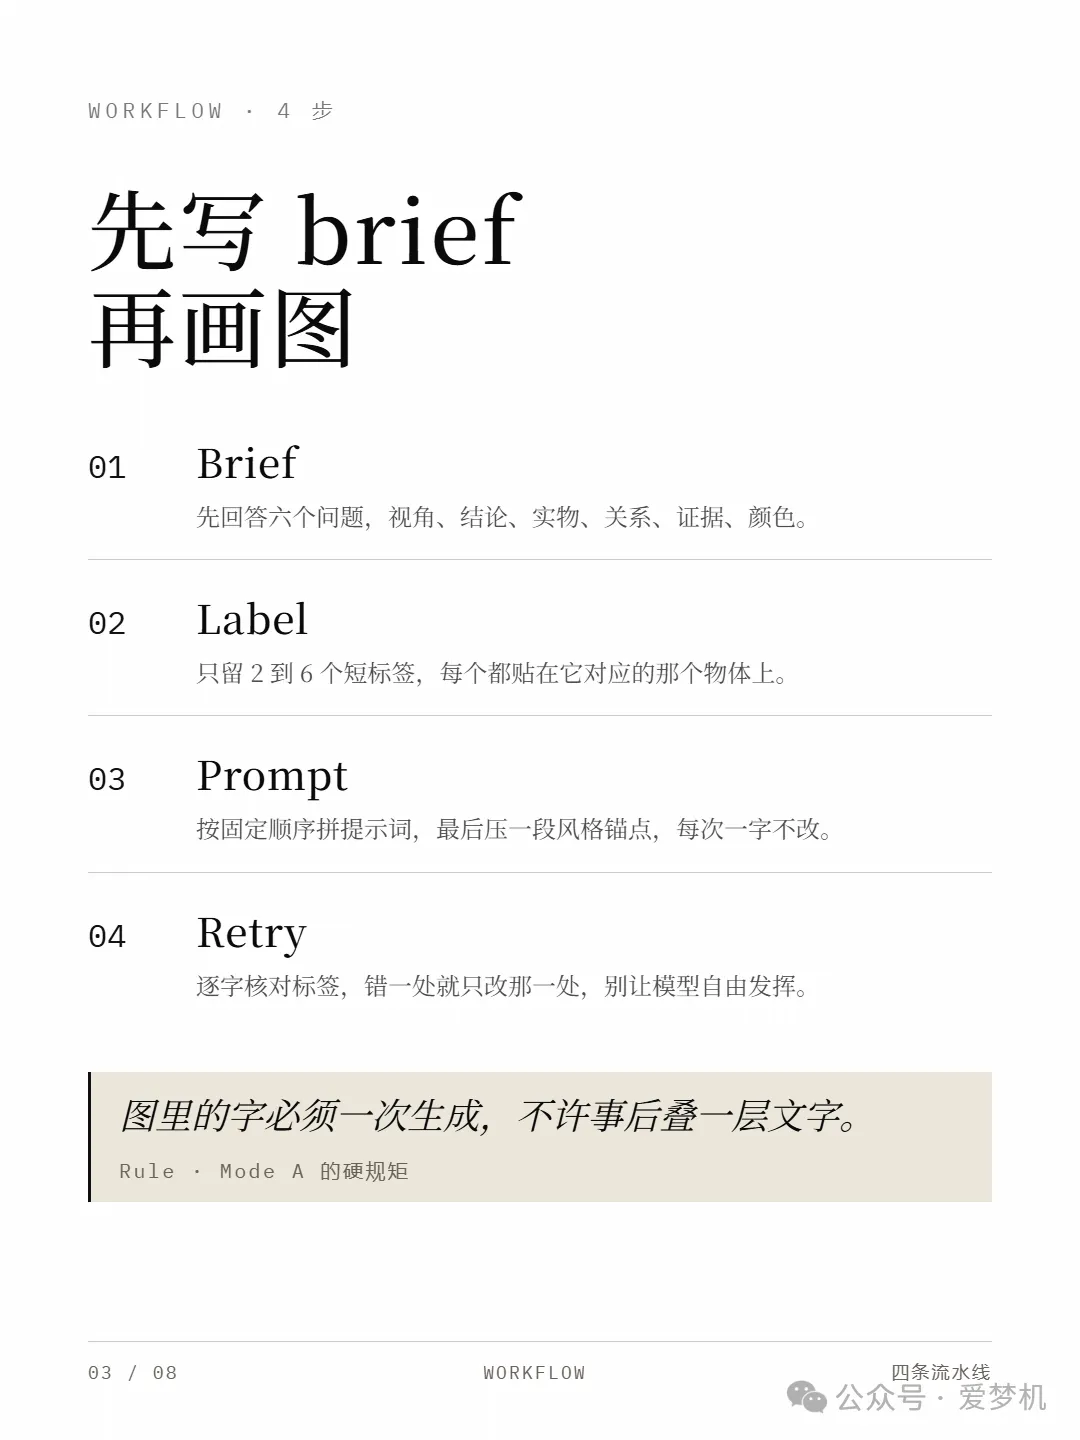
它把整件事拆成四步,而且这四步的顺序是硬性的。
第一步是先写 brief。它逼你在动笔之前回答六个问题,看图的人在十秒内应该看懂什么,一句话的结论是什么,画面里有哪些真实存在的物件,这些物件之间是什么关系,把文字全抹掉之后画面还能不能看懂,场景里该摆哪两三个有用的小东西。
这六个问题问得我有点脸红。我以前配图,从来没想过「把文字抹掉还看得懂吗」这件事。我以前的思路是先想一句话,再让模型想办法把那句话画出来。
第二步是标签。只留两到六个,每个都必须贴在它对应的那个物件上,不许飘在半空当装饰。
第三步才是拼提示词。按固定顺序拼,最后压上一段风格锚点。这段锚点每次都要原样粘贴,一个字都不许改。
第四步是核对。图出来之后,逐个字跟 brief 对一遍,错一处就只改那一处,别让它自由发挥。
那份 brief 我写了差不多二十分钟,比我以前写一段提示词的时间长了十倍。填进去的东西大概是这些。十秒内要让人看懂的是,同一套规则能产出一样的结果。一句话结论是,重复不靠手感,靠规则没变。画面里的真实物件是散稿、印刷机、卡片。关系是流水线。把字全抹掉,左中右三块东西还在,还能看懂。场景是一张工作台,两条环境线索就够,一盏台灯,一叠卷边的纸。颜色用三种,蓝给输入,橙给动作,绿给结果。
写完这六条,提示词几乎是自动长出来的。我甚至没怎么改措辞。
写到一半我突然明白了,这套东西真正难的地方不在提示词。难的是把「我觉得这样好看」翻译成一句别人能复述的话。审美一旦变成句子,别人就能抄,机器也能照做。
这四步走下来,看着特别笨,但每一步都在把变量往下砍。
我一开始还嫌它啰嗦,跳过第一步直接写提示词。出来那张图,构图挺好,两个标签贴错了物件,一个飘在空白处,另一个贴在了狗身上。
我寻思了一下我没寻思明白。回过去补完那六个问题,同样的提示词,第二张就对了。
但我按这四步跑出来的那张图,是我这三年里第一次,生成完之后不用修。
画面是这样的。左边一摞散着的稿纸,蓝色的,堆得歪歪扭扭。中间那个戴圆框眼镜的火柴人正在摇一台老式印刷机,边牧蹲在旁边看着他。右边出来三张一模一样的绿色卡片,卡片上都是同一个火柴人。
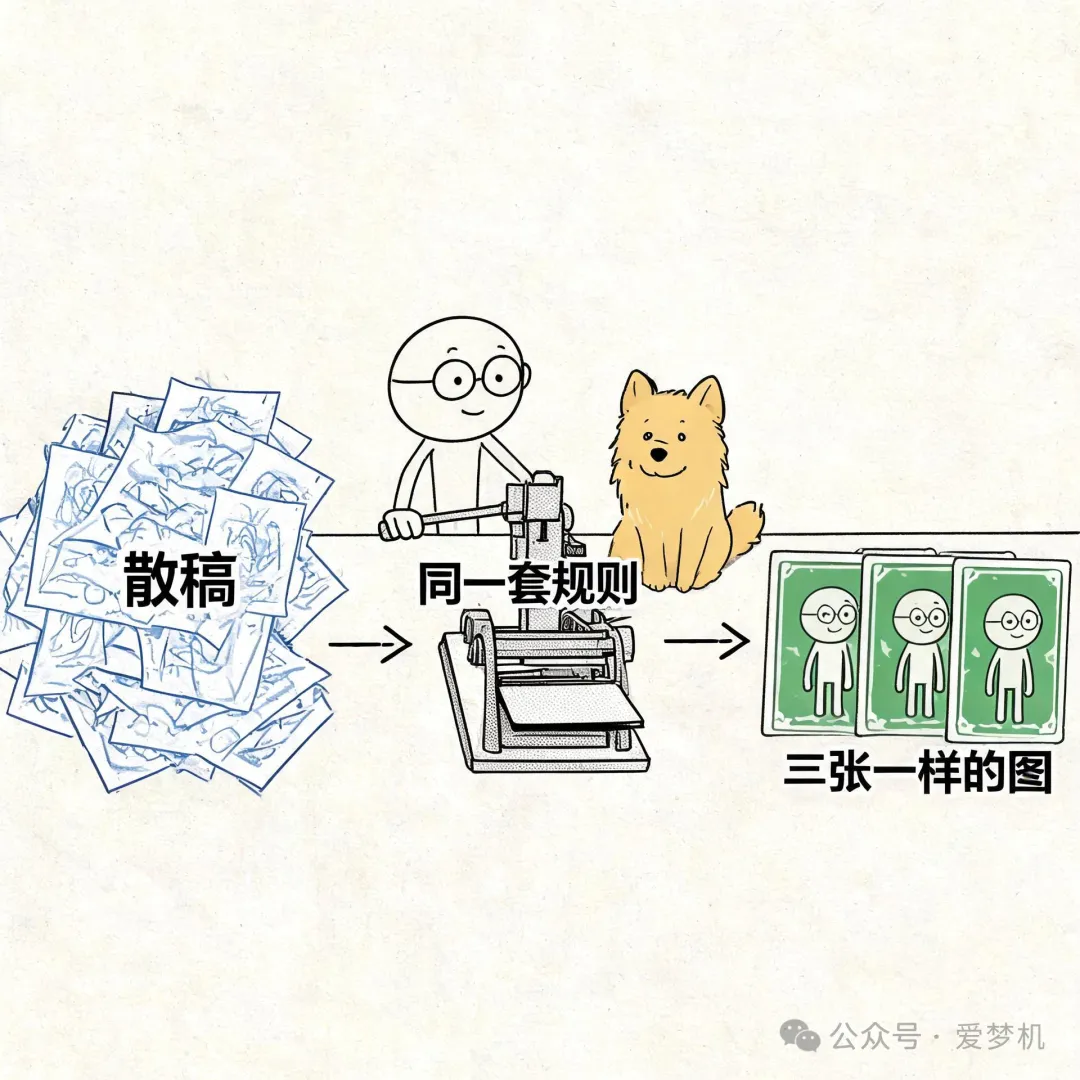
三个标签,散稿、同一套规则、三张一样的图,一次全中。一个错字都没有,也没多写别的字。网点也是真的网点,我放大看过,是一个个圆点排出来的,不是那种贴上去的灰渐变。
我当时盯着屏幕看了挺久,说实话有点不真实。
不是因为画得多漂亮。那张图谈不上多漂亮,它就是干净,字对,线对,圆点对。
当然它也有毛病。右下角那行「三张一样的图」压到了图边,差一点点就要出画。这一处没法修,只能重生成。
我没重生成。
留着这个瑕疵,反而让我更相信前面那些好。一个会出错的东西,通常是真的在做事。哪哪都完美的那种,我反而更信不过。
这张图我后来一直没删,就躺在项目文件夹里,文件名起得特别朴素,ov-test-run。
再说它为什么能稳。逻辑其实特别简单,风格锚点是常量,内容才是变量。颜色、线、网点、角色,这些全部写死在锚点里,模型只负责把这一张图的物件摆对。变量少了,结果自然就收敛了。
那段锚点里还有一句我一直记着,图里的字必须一次生成,不许事后叠一层文字。
以前我干的正好是相反的事。先生成一张干净的图,再打开设计软件把标题压上去。折腾过的人都知道,字和画面永远贴不严,字不是压住了狗的眼睛,就是字号跟画面气质打架。
它把这条路堵死,等于逼你在构图阶段就把字当成一个物件摆进画面里。
聊到这儿我脑子里突然冒出中世纪的画坊。
那会儿画一幅教堂的圣像,不是一个人从头画到尾。师傅定一套图样,学徒照着同一套线描去描、去填色,所以一排圣像看过去,气质是同一个人给的。他们甚至有一种东西叫画样书,就是一本照着抄的样本。
这套办法跟 AI 一点关系都没有,它是手艺活的老规矩。手艺要传下去,靠的从来不是每个徒弟都天赋异禀,靠的是那本谁都能翻的样本。
oil-visual 干的事,其实就是把画样书塞进了提示词里。
说到这儿我又想起一件不太相干的事。全世界的地铁线路图,画法都差不多,细直线,四十五度的拐角,换乘站一个白圈。你说那是审美吗?不全是,那是一套让陌生人在三十秒里读懂一座城市的约定。
它里面的颜色也是这个意思。蓝色永远代表输入的东西,橙色代表动作或者代价,绿色代表结果。你不用每次都解释一遍颜色代表什么,看图的人自己就接上了。
我做了三年内容,第一次觉得配图居然是一门有语法的语言。语法不自由,可语法让人看得懂。
我知道有人会说,Midjourney 早就有风格参考码了,贴一个 sref 不就一致了吗?
我自己也用过。它能让你靠近那个味道,但靠不到同一个点,每次还是在那个附近晃。oil-visual 给的不是一个范围,是一份能逐字复述的说明书,你把它抄一遍,出来的东西就该是那个样子。
说大一点,这件事在广告公司叫视觉规范。品牌手册里写清楚主色、字体、图形怎么用,不是为了限制设计师,是为了让十个供应商交上来的东西拼在一起不打架。
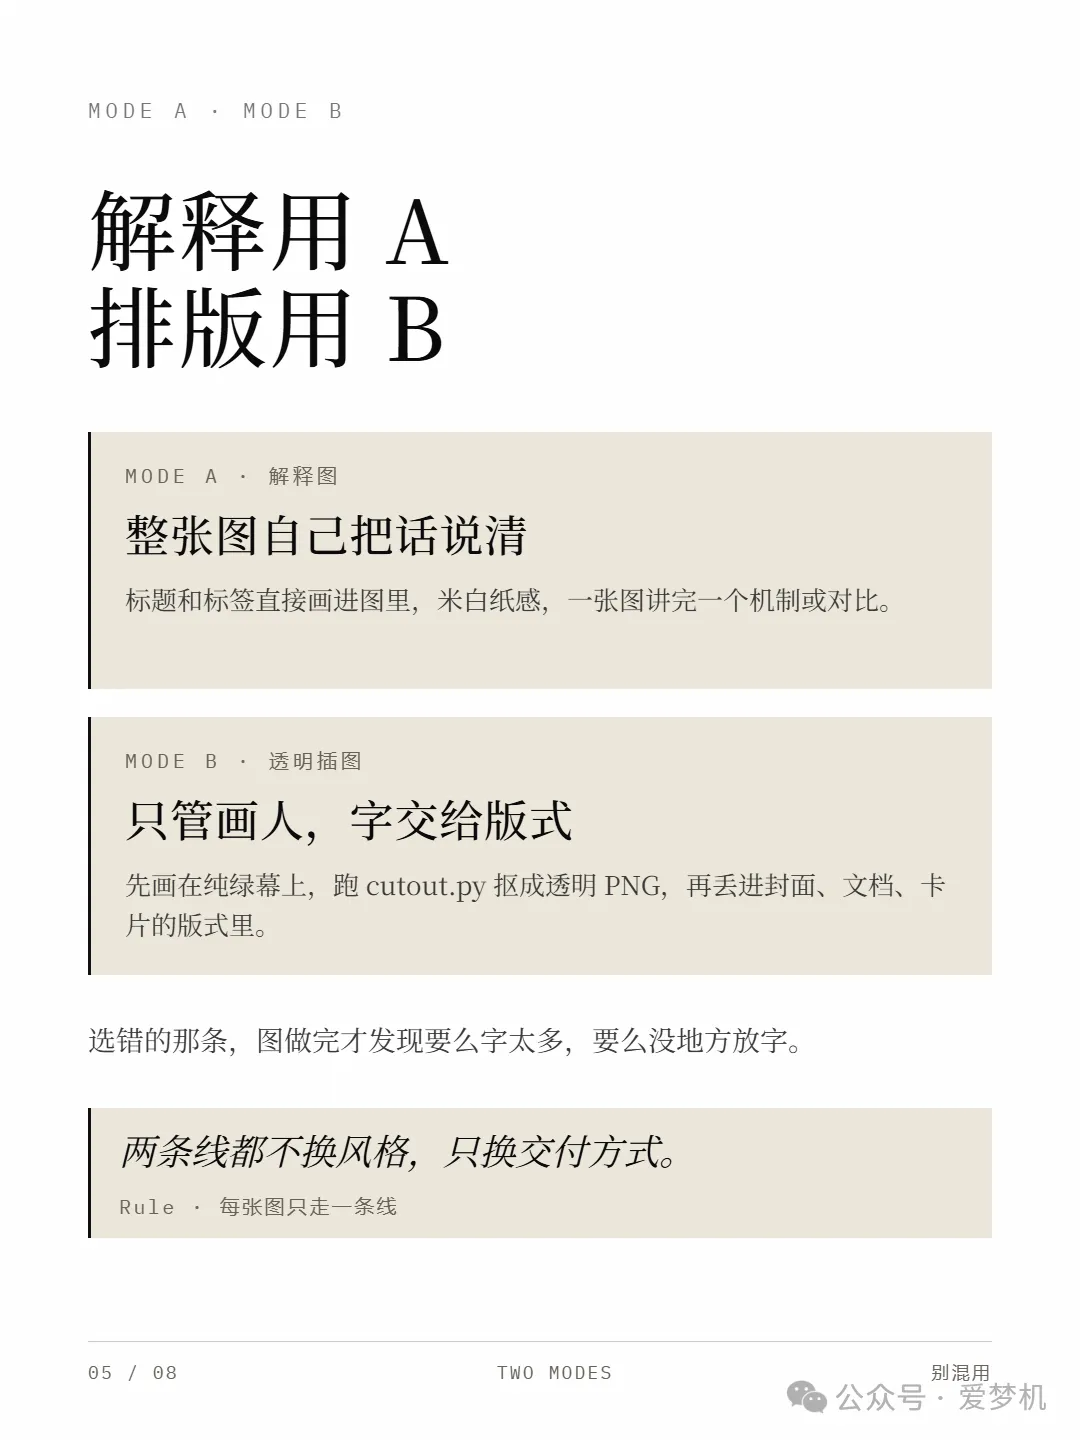
它还有第二条线,叫 Mode B,专门出透明素材。先用纯绿幕画,绿得特别纯粹的那种,色值是 00FF00,然后跑 cutout.py 把背景抠掉,输出一张透明 PNG,丢进封面、文档、卡片里,字交给版式去排。
我第一张绿幕图就翻车了。
背景看着是纯绿,但四个角其实有一层特别淡的渐变。抠完以后,人物边缘留了一圈灰边,放大到百分之百才看得见,不放大根本发现不了。
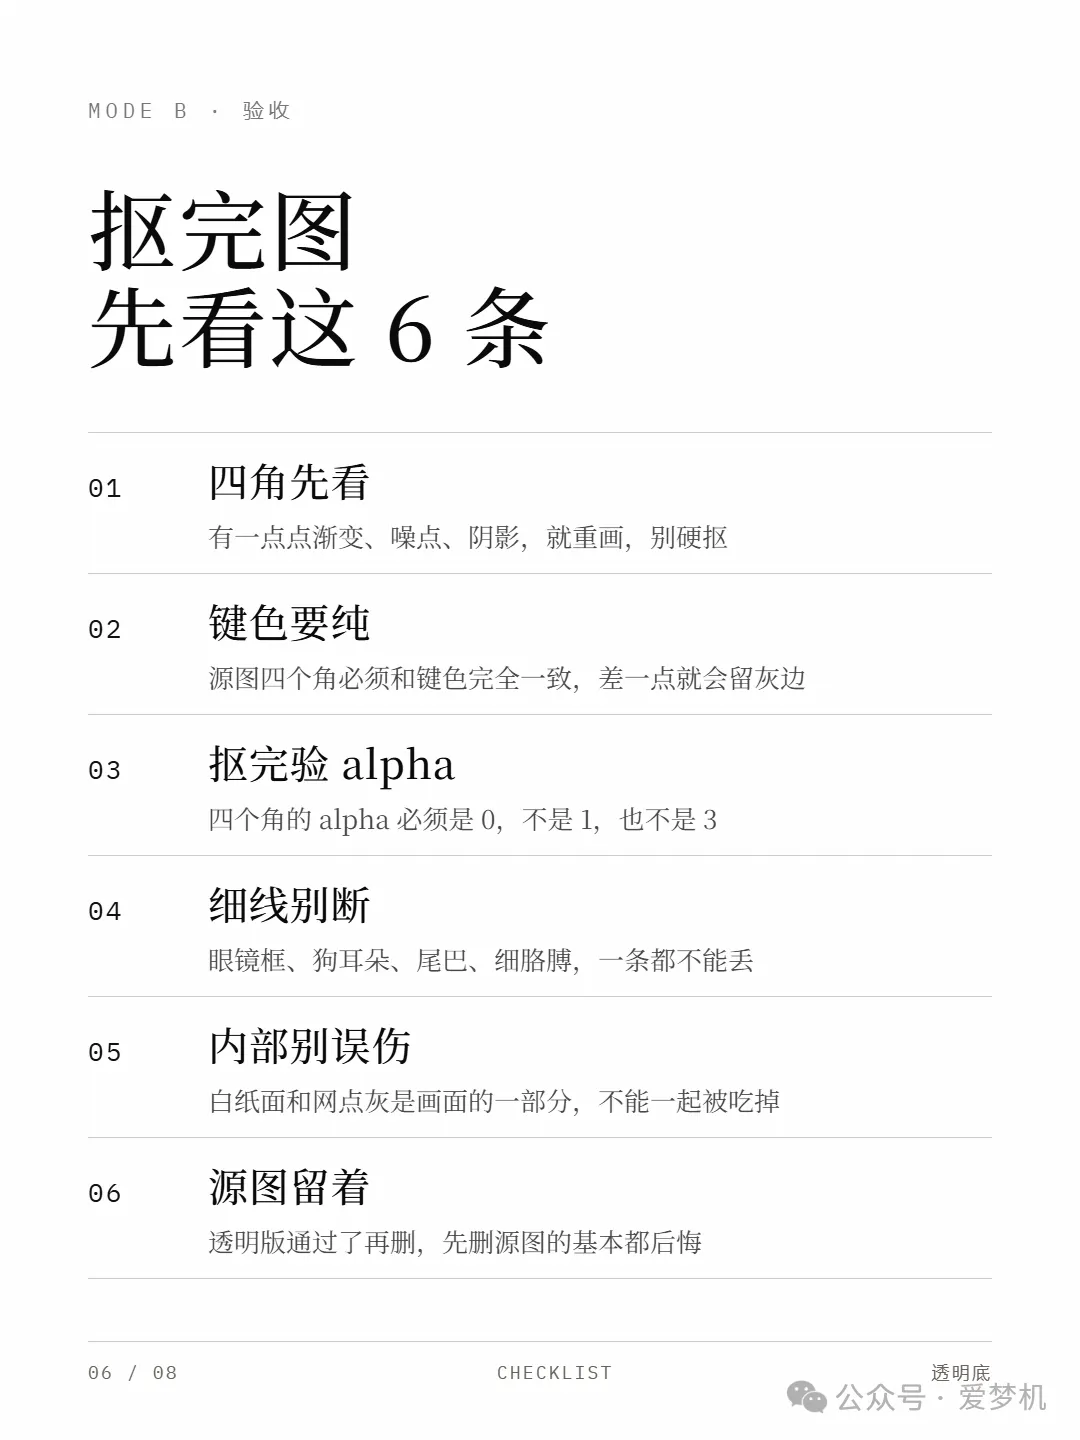
它的检查清单第一条就写着,四角先看,有一点渐变、噪点、阴影,就重画,别硬抠。
我当时不信,觉得抠图脚本应该能扛住。。。
后来重画了一张干净的,抠出来四角 alpha 全是 0,眼镜框、狗耳朵、尾巴、细胳膊,一根线都没断,白纸面和网点灰也都在。这一版我才敢用。
顺便说一句,它自带的示例图有七张。解释 agent 工作流的,讲成本对比的,把一团乱麻变成清晰结构的,画反馈回路的,画流水线卡点的,一张方形版,一张透明插画。
七张图摆在一起看,才是它最想说的话。它们不是七个作品,是同一套语言说了七遍。
再补一句角色的事。连载漫画有个东西叫角色设定表,发色、瞳色、一件始终不换的外套,画师换人了也得照着这张表画。读者记住的从来不是那张脸,是那张脸背后的规矩。
它里面那个火柴人,圆脑袋、细圆框、点状的眼睛,就是一张极简的设定表。狗也一样,必须是胖的,必须是暖黄的。这两个角色每张图都在,看久了你会觉得他们是熟人。
我第一眼看到那只狗的时候有点走神。它蹲在印刷机旁边,什么也不干,就那么看着。我后来才反应过来,它在画面里的作用不是可爱,是温度。一张讲规则的图,光有规则会很冷。
那它有没有做不到的?
有,而且不少。
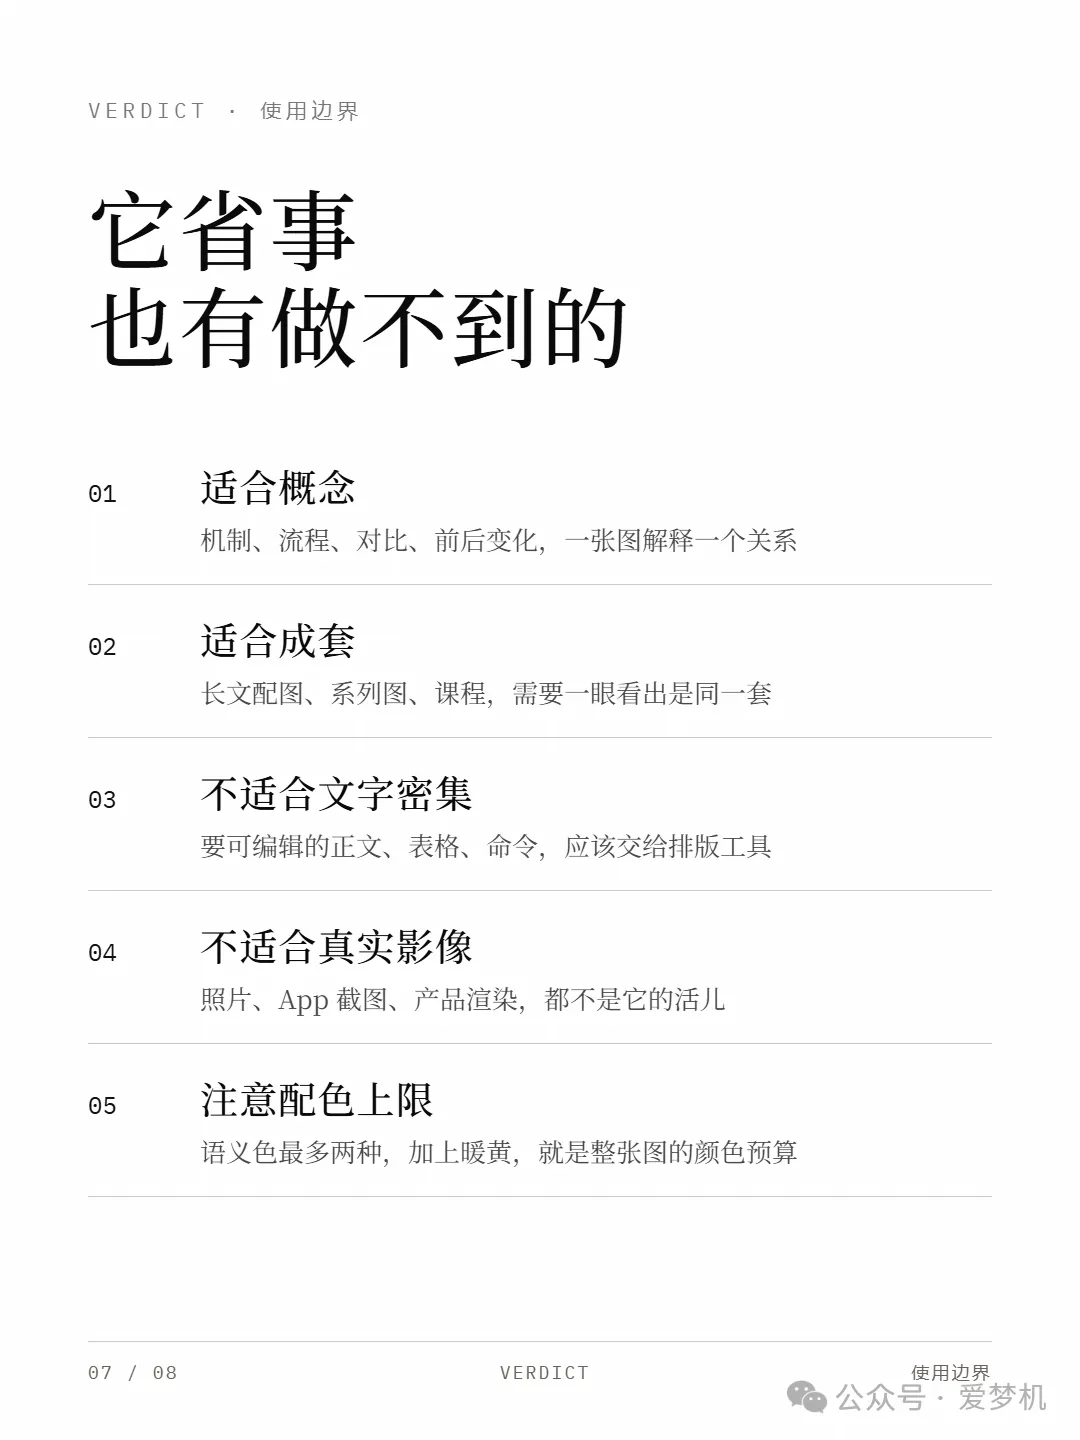
它不适合文字密集的画面。我试过让它画一张带三段配置代码的图,出来以后代码像一堆乱码,字号也忽大忽小。这类东西本来就该交给排版工具,不该让模型烤进图里。
它也不适合真实影像。照片、App 截图、产品渲染图,都不是它的活。真需要照片的地方,你还是得去拍,或者去买,这套东西替代不了摄影。
颜色上是硬上限,语义色最多两种,加上那只暖黄的狗,就是这张图的全部颜色预算。我贪心试过第三种,加了紫色去区分两个阶段,出来那张图的花哨程度,跟这套黑白墨线完全不是一个世界。
还有一条,一张图只讲一件事。我试过让它在一张图里同时讲流程和对比,出来那张图我看了三遍才看懂,读者大概一遍就划走了。
一张图同时讲两件事,特别像一个人在你耳边同时说两段话。他每个字都没错,你就是听不进去。
这三件事的共同点,是我一直在逼它干它说好不干的事。它的边界写得清清楚楚,是我自己没读。
说到这儿我得替另一拨人说句公道话。
如果你一周只配两张图,这套规矩对你是负担。写六个问题、压一段锚点、逐字核对,这些时间够你手动修三张图了。它真正值钱的地方,是你有一整套东西要出,二十张、五十张,而且必须看起来像同一个人做的。那时候一致性才是成本,其他都不是。
这块需要注意一下,前几次一定会比手动做还慢。
你要逐条回答那六个问题,要一个字一个字对标签,要重画一张干净的绿幕图,心急的话很容易在第二张就放弃。我自己第三次才摸到节奏,前面两次纯属给自己添堵,一边写 brief 一边想,我用这时间都画完三张了。
我自己也是在做到第八张的时候,才真正感觉到这套规矩的力气。
如果你也在做内容,你可以回想一下,上一次因为配图风格不统一而返工,是什么时候。我想大多数人的答案,都不会太久远。
回到最开始那个晚上。
五张图,五个画师,我盯着屏幕发愣。
现在我再看那套材料,八张图摆在一起,线是同一种线,灰是同一种灰,狗还是那只狗。中间当然有瑕疵,有一张的字压边了,有一张我重画了三次。
但它看起来是一个人的东西。
我一直觉得,配图这件事最贵的地方,不是你画得多好。画得好的人太多了,模型现在也能画得挺好。
最贵的是「像」。像同一个人,像同一个系列,像同一套语言。
我们做内容的人特别容易被「好看」牵着走。看到一张漂亮的图,第一反应是我也要这种。可读者其实不太在意你这一张有多惊艳,他们在意的是翻到第三页的时候,还认不认得出这是你的东西。
好看是这一张的事,像是一整套的事。这句话我一开始不太懂,做完那八张卡之后,懂了。
手艺传了几百年,传的都不是某一幅画。
传的是那本画样书。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧。想第一时间收到推送,也可以给我个星标。
谢谢你看我的文章,我们,下次再见。