ARTICLE · 1304126
AI 助手总在失忆,问题出在「会话」这个单位上
现在大部分 AI 助手都是会话制的:开一个窗口,聊一件事,关掉就忘。
DeepSeek Harness 团队最近发了一篇架构文章,标题是《Exploring Super-agent Design》,讲的就是这件事。他们的判断是:会话不该是 agent 的基本单位。
文章开头承认,过去一年 coding agent 已经证明了模型能用工具解决复杂问题,人管得越来越少。但今天主流的 agent 设计,撑不起「同时跑多个任务」或者「一整个团队共用」这种用法。
原因在于,agent 还是拿一个会话当基本工作单元,会话之间互相隔离。一个人并行跑几个任务,就得自己当调度器,来回切窗口。加 CLI、加 MCP、加外部连接器,能让它收到外部消息,但限制没变:它还是跑在一个同步会话里,长操作会阻塞,不同任务的上下文会混在一起,人一走开它就停。
一、会话其实是 API 时代的遗留
文章里有个判断挺锋利:在现有设计里,一个会话其实干了两件事——管理模型的上下文,以及充当用户的项目管理单位。
这两件事被绑在一起,是因为底层 LLM API 就是这么设计的。一旦产品跟这个 API 解耦,这两件事就该分开。用户在 IM 里说「用方案 A」,后来在另一个地方改成方案 B,不应该还要人自己记着哪个窗口里有哪条信息。
二、拆成两层
方案是把工作拆成两层。
Router 层是一个长期活着的全局路由层,接收所有入口的人机交互,跨任务的信息和决策都汇总到这里。它不干具体的活,只负责派活。
Worker 层是真正执行任务的会话,每个都有隔离的上下文和一套完整工具,只对付一个任务。Worker 不跟人直接对话,它的推理过程和工具调用不会流到外部渠道,只向 Router 汇报状态。
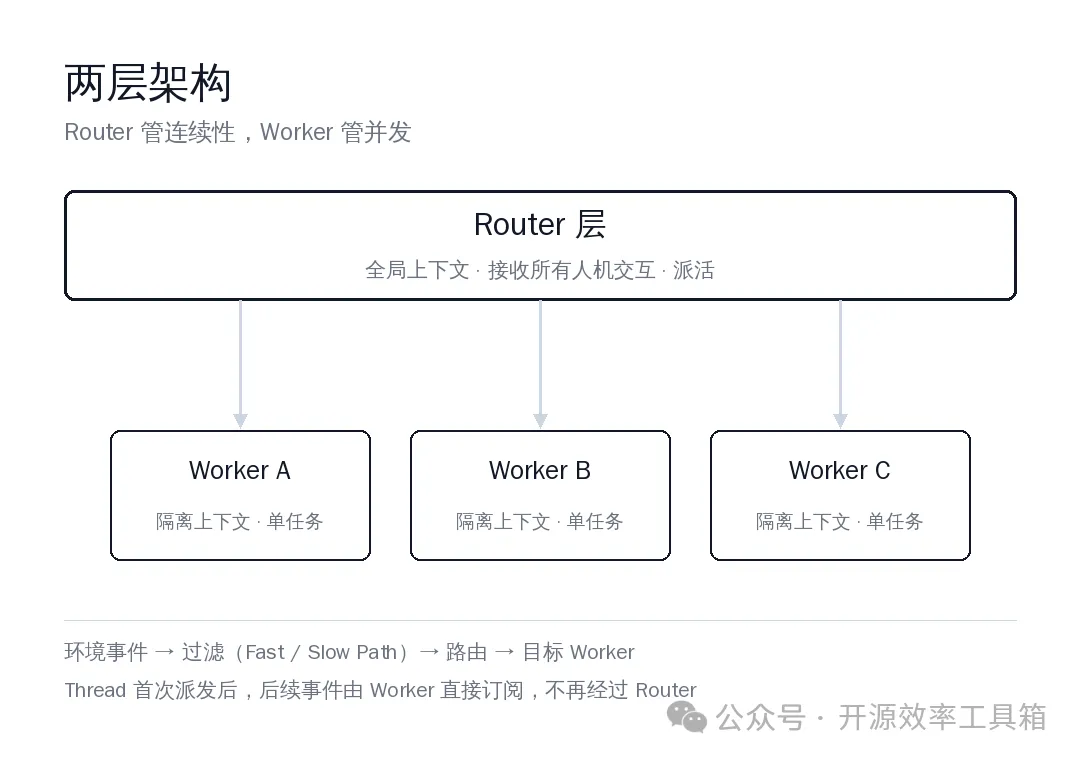
并行跑的时候,每个 Worker 各干各的,通常不需要互相通信。冲突一般发生在 Router 层,因为它们争的是同一份资源。
文章还提到一点:这两层是逻辑上的职责划分,不是物理上的。Router 内部不一定要是一个会话,有些逻辑甚至不需要调用大模型。
三、让事件来驱动
要让 agent 主动起来,得换掉驱动方式:把主要输入从「人在会话里敲的 prompt」换成「环境里发生的事件」。
但接进真实群聊和代码平台后,事件流噪声极大,绝大多数日常消息不需要响应。所以先过滤,分两条路:
· **Fast Path**:代码快速检查来源、群组、白名单这类确定性条件,拦掉大部分噪声。
· **Slow Path**:通过初筛的候选事件才交给大模型,由它结合上下文判断要不要动。
然后是路由。同一个 GitHub PR、IM 话题、邮件串里的连续事件,构成一个 Thread(线程)。Router 为 Thread 的第一个事件创建 Worker 之后,Worker 直接订阅这个 Thread,后续事件走快速通道直达,不用再过一遍 Router。
四、把上下文当缓存用
事件送到目标会话后,下一个问题是往上下文窗口里塞多少信息。
他们借了计算机体系结构的思路,把有限的上下文窗口当 CPU 缓存来管,方法叫 Inline & Spill:
· 先给最少的信息:只有当前对象的 ID 和内容摘要。
· 按局部性逐步内联:先给强相关对象的 ID,再给它们的内容。
· 超长内容外溢:设一个长度上限,超出窗口的部分不塞进来,留摘要和入口。
对象都有唯一 ID,模型可以从当前消息的 Thread 出发,顺着内联的 ID 找到相关的 Worker Session,再找到另一条代码评审线程。
五、全双工
经典 ReAct 循环里,模型调一次同步的 run(),整个循环就阻塞到工具返回。这期间会话没法响应任何新输入。
他们的做法是把耗时的命令和工具调用换成异步的 start() 和 stop()。start() 立刻返回「已启动」,结果晚点再推回来。这样子前台对话跟后台任务解耦,人说话的时候任务还在跑。
文章自己承认:dsh 已经实现了这套异步任务机制,但还没有默认开启。
六、把计算、状态、环境拆开
默认情况下,本地 agent 把三样东西绑在一台机器上:跑 Agent Loop 的计算、需要持久化的会话状态、以及代码仓库和本地工具这类执行环境。
他们拆了两刀。
第一刀:计算可以无状态,只有会话状态需要持久化。于是把计算放进无状态弹性容器,状态单独存。
第二刀:真正难同步的是环境本身,那就不搬环境。Agent Loop 跑在云上,执行环境留在本地,按需连接。
文章提到 Anthropic 的「解耦大脑和手」走的是同一路线:harness 保持无状态,会话日志存在外面,执行环境通过守护进程按需接入。
七、用 agent 监控 agent
要一直在线,光有计算存储分离还不够,还得能自己从异常里恢复。
文章强调,agent 系统需要的监控不止是进程存活探针。很多异常不是崩溃——进程还在跑,但模型卡在无效循环里。
他们的做法是让 Control Loop(控制回路)成为一个独立的 Watchdog Session,跑在主系统外面,由定时消息驱动。因为它本身就是一个有全套工具的 agent 会话,维护者可以直接用自然语言问它「刚才为什么失败」。
八、实测数字
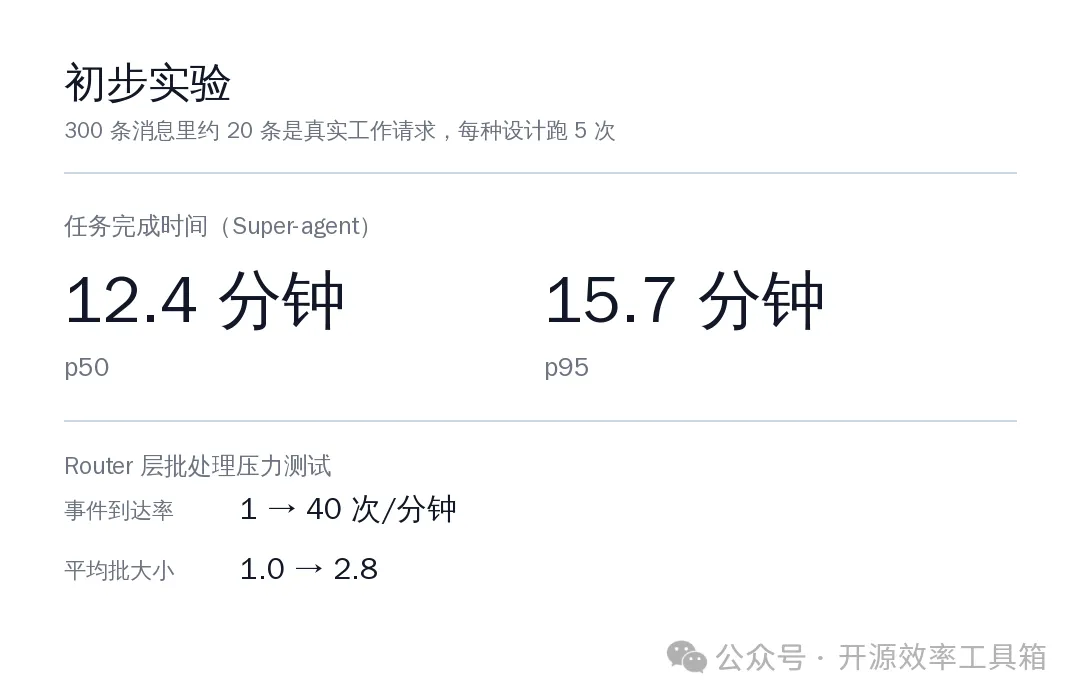
他们在群聊和 GitHub CI 的消息流上跑了四组设计对比,每组约 300 条消息,其中约 20 条是真实工作请求,每种设计跑 5 次。
Super-agent 的任务完成时间:p50 12.4 分钟,p95 15.7 分钟,明显快于「单会话 + Subagent 工具」的设计。
代价写在明面上:Super-agent 因为维持多个独立会话,每次运行的缓存读取 token 更多。它拿 token 换了更短、更稳的完成时间。
Router 层的压力测试:需要决策的事件从每分钟 1 个涨到 40 个,平均批大小从 1.0 涨到 2.8,单次请求的处理时间随之增长,但还在可接受范围。
九、还没解决的问题
文章最后列了四个开放问题,都是硬骨头:
· 两层架构怎么扩展。目前一个长期存活的 Router Session 加订阅直通,已经够用且工程成本低,但内存是硬上限。
· 没有会话之后,产品交互怎么设计。会话不再对应用户的执行单元,人中途要介入某个任务时该怎么找它。
· 跨实例协作。多个组织各有一个 Super-agent 时,边界之间怎么通信。
· 安全与隐私。事件驱动让更多环境能驱动 agent,也把更多不可信输入放了进来;而「云端和执行端互相信任」这个隐含前提并不成立。
文章末尾注明:文中部分设计实现在 dsh-superagent-prototype 这个插件里,只是验证技术路线的原型,不是 DeepSeek 官方产品。作者是 Yujia Qiao,系统和文章都是他做的。