ARTICLE · 1304281
AI 卖的不是软件,是工资
2026 年 9 月,一份招股书递到美国证监会。
在一堆关于算力、租赁和风险因素的表格中间,有一个不起眼的数字:
净收入留存率:900%。
这个指标的意思是:同一批客户,今年花的钱,是去年的九倍。
如果你不在软件行业,可能感觉不到这个数字有多离谱。
(ps:SaaS 行业的天花板是 120%,做得好的 130%。超过 150%,分析师就要追问你是不是在压货。900% 不是“一家更好的 SaaS 公司”,它是“一个不属于 SaaS 的东西”。)
这家公司叫 Anthropic,产品叫 Claude。
它的招股书里还有另一个数字:80.2% 的收入来自使用量计费,订阅只占不到两成。
一个卖订阅的公司,留存率不可能到 900%。因为订阅的计量单位是人头和月份——一个人,一个月,只能付一次钱。
那 900% 是从哪来的?
这篇文章想回答的就是这个问题。因为答案不在 Anthropic 身上,在“AI 到底在卖什么”这件事上。
一、定价锚:一门生意值多少钱,取决于它跟谁比价
先讲一件看似无关的事。
同样一杯咖啡,在便利店卖 1 美元,在星巴克卖 5 美元,在威尼斯圣马可广场卖 15 美元。
咖啡豆没变,杯子没变,变的是它跟什么比价。
便利店跟“提神”比价;星巴克跟“一个能坐两小时的第三空间”比价;圣马可广场跟“你一辈子可能只来一次的旅行”比价。
经济学里有个词叫锚定。一门生意的规模,从来不由成本决定,由它把自己锚在哪个池子里决定。
这也是为什么,同样是“卖水”,有人卖一块钱一瓶,有人卖二十块一瓶——差别不在水,在你口渴的时候,旁边还有没有别的选择。
定价单位的变迁,本身就是一部经济史。
19 世纪,工厂按件计酬——你做一双鞋,拿一双鞋的钱。20 世纪,泰勒制把计件改成了计时——因为计件会让工人拼命赶量、不管质量,而且机器一开,到底是人的功劳还是机器的功劳,说不清。
软件时代,计费单位变成了“座位”——一个人,一个月,一份钱。这个单位很妙,因为它把“人在不在场”变成了可计量的东西。至于你到底用了多少,不重要。
现在,AI 把单位改回了“件”。
(ps:这不是倒退。19 世纪的计件,卖的是人的力气;今天的计件,卖的是判断。前者可替换,后者不可替换。这才是定价能往上走的原因。)
每一次计价单位的改变,都会重新分配一次风险。
计件,风险在工人;计时,风险在老板;按座位,风险在“用不用得上”;按任务,风险又回到了“做没做成”。
而风险在谁身上,钱就流向谁。
AI 现在就站在这道选择题前面。
如果它跟软件比价:一个知识工作者一年 200 美元,全球 10 亿人,市场是 2,000 亿美元。
如果它跟人比价:一个知识工作者一年 5 万美元,哪怕只替代 20%,市场是 10 万亿美元。
同一个产品,两种锚,差 50 倍。
而过去三年所有让人看不懂的数字——900% 的留存、80% 的按量计费、3.2 万亿美元的基建承诺、50% 的财富 500 强渗透却只有 0.1% 的钱包份额——都指向同一件事:
它正在换锚。
二、三层定价锚
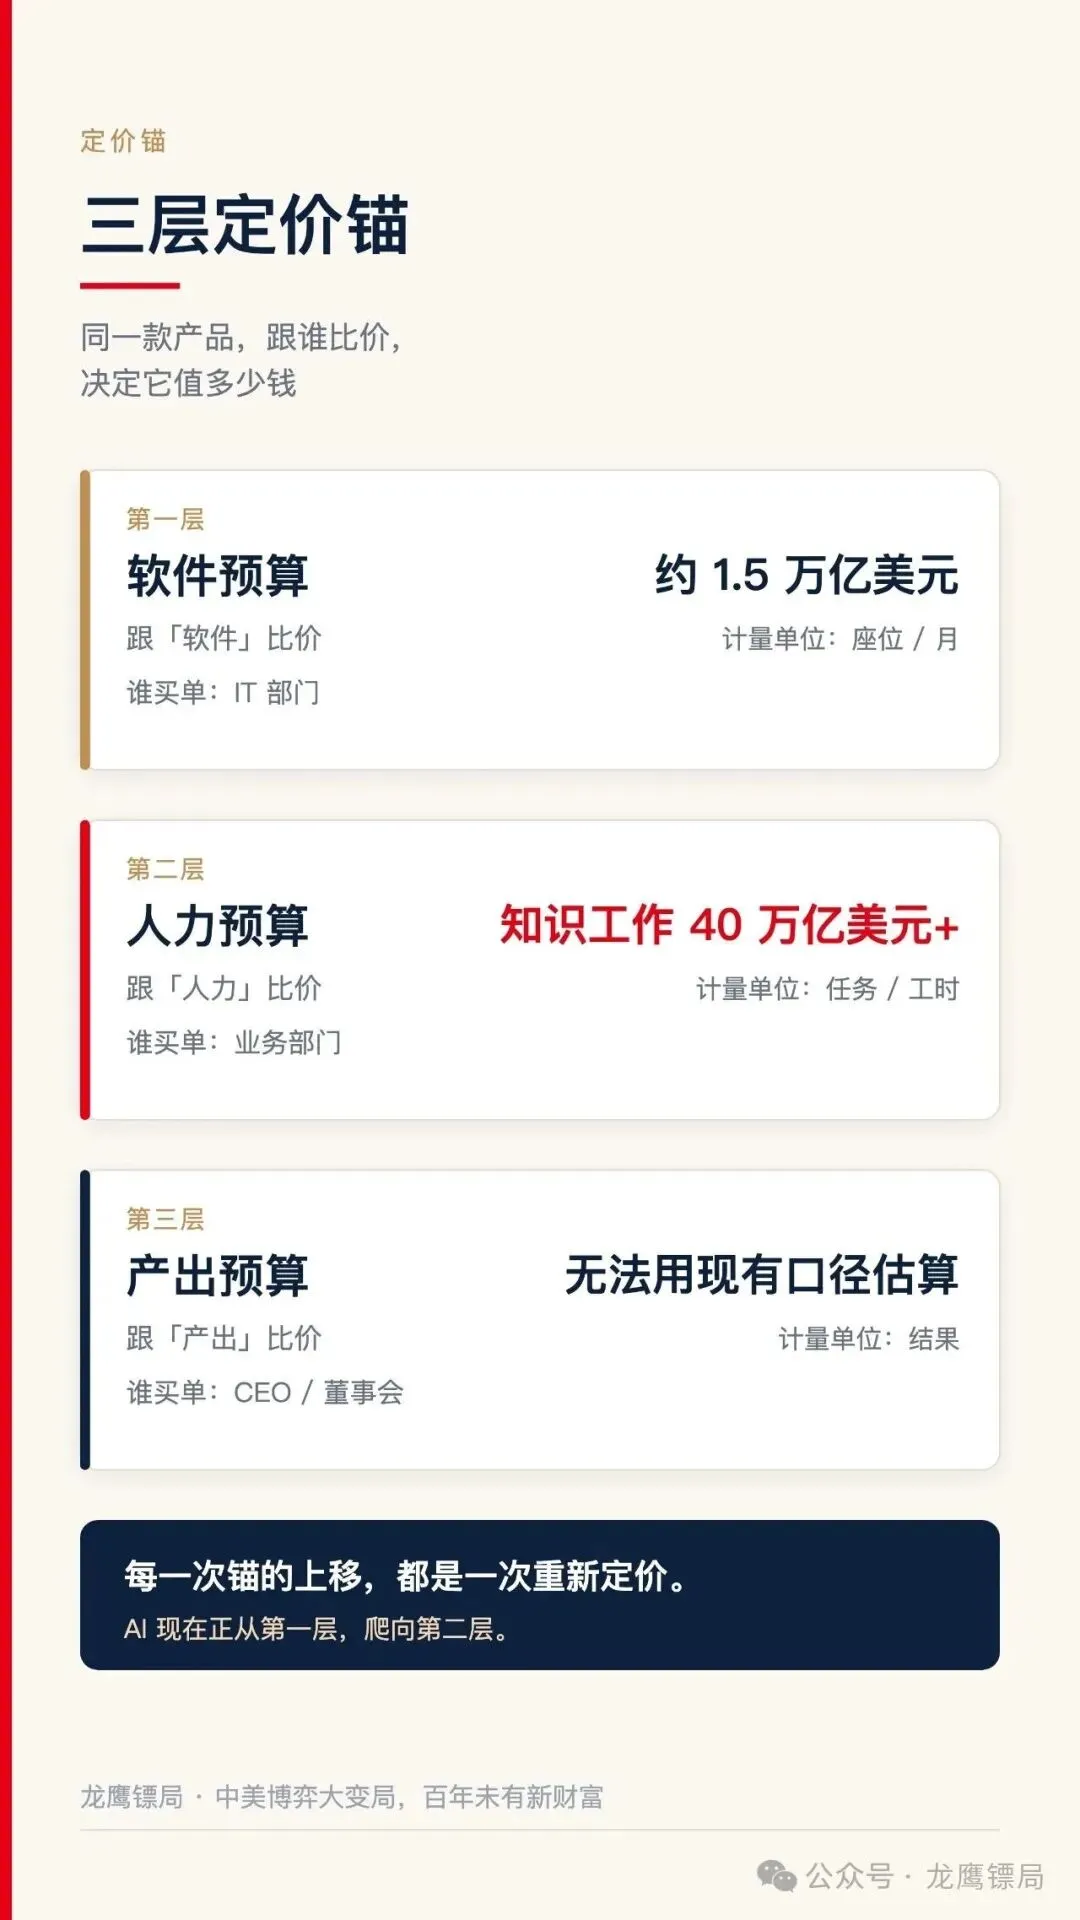
我把 AI 的商业价值拆成三层,每一层对应一个可以比较的对象。
| 第一层:软件预算 | ||||
| 第二层:人力预算 | ||||
| 第三层:产出预算 |
(ps:这里要澄清一个容易被专业读者抓的漏洞。40 万亿是知识工作“创造的经济价值”,是产出,不是工资总额。AI 真正能定价的,是这个过程里的成本项——工资、外包费、咨询费。所以后面的测算会再打一次折。但即便打了折,量级也不是软件市场能比的。)
第一层,是所有人一开始以为的市场。
AI 是个软件,软件按座位卖,一个人一个月 20 美元。全球 10 亿知识工作者,一人一年 200 美元,2,000 亿美元。
这个池子的天花板很硬:它等于客户有多少个员工。
第二层,是 AI 实际上已经爬上去的地方。
当 AI 能独立完成一份合同审查、一次数据清洗、一版代码重构的时候,客户不再拿它跟 Office 比价,而是拿它跟“一个初级律师”、“一个数据分析师”、“一个程序员”比价。
一个初级律师的年薪是 15 万美元。AI 干他 30% 的活,值 4.5 万美元。
这就是 900% 的来源。
第三层,是还没到、但招股书已经写出来的地方。
Anthropic 的招股书里有这么一段:最终,“数以百万计的虚拟协作者可以并行运行”,形成“数据中心里的天才之国”(a country of geniuses in a data center),服务经济中的每一个组织。
这句话不是修辞。它在描述一种新的定价单位——不是座位,不是任务,是结果。
如果 AI 能直接对“一份通过审批的新药”“一单成交的并购”负责,那它的价格就不再参照成本,而参照收益。
到那时,TAM 这个词就失效了。因为你没法给“经济增长”估一个 TAM。
(ps:a16z 在 2025 年做过一个测算,结论和这个框架惊人地一致:AI 的可触达市场,不是 4,000 亿美元的软件市场,而是 13 万亿美元的劳动力市场——30 倍。他们算的是钱,我算的是定价单位,指到的是同一个地方。)
三、算一笔具体的账:同一家公司,两种算法差 60 倍
抽象地讲“锚”,不如看一家真实的公司。
假设有一家 500 人的专业服务公司——咨询、法务、审计都行。
• 年收入 1 亿美元;
• 人力成本占 60%,就是 6,000 万美元;
• 人均成本 12 万美元。
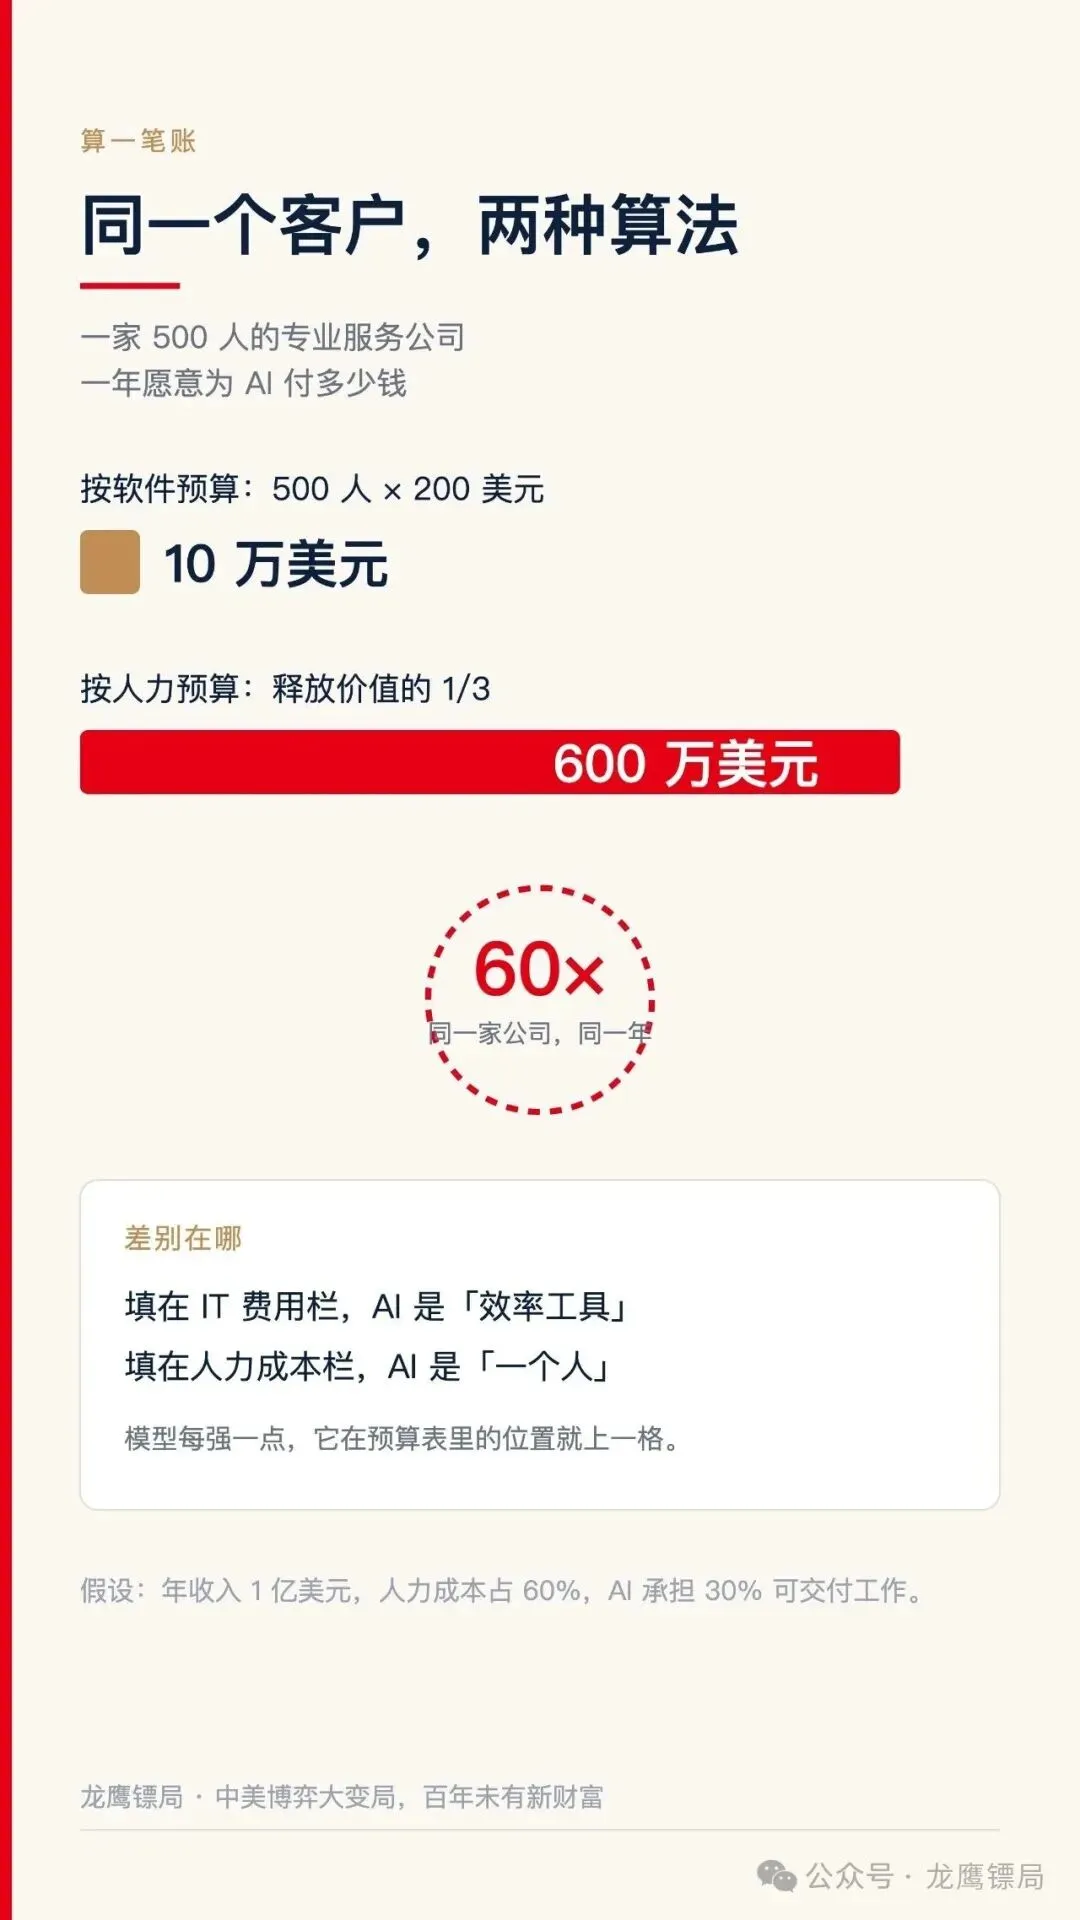
现在,如果 AI 能承担其中 30% 的可交付工作,一年就能释放出 1,800 万美元的人力成本。
那么,这家公司愿意为 AI 付多少钱?
按软件预算算:
500 人 × 200 美元/年 = 10 万美元。
按人力预算算:
如果 AI 供应商拿走释放价值的 1/3,就是 600 万美元。
60 倍。
(ps:同一家公司,同一个产品,同一年。差别只在于——它把 AI 填在哪一栏预算里。填在 IT 费用,是 10 万;填在人力成本,是 600 万。)
这就是为什么,Anthropic 的 CFO 会说“每次新模型发布,TAM 都在扩大”。
不是市场变大了,是同一个客户,愿意掏钱的科目变了。
模型每强一点,能接的活就多一点;能接的活多一点,它在客户预算表里的位置就往上一格。
从“效率工具”这一栏,挪到“人力外包”这一栏,再挪到“业务成果”这一栏。
每一次挪动,都是一次重新定价。
四、为什么按量计费是必然,不是选择
有人会说:按量计费只是一种定价策略,想改随时能改回订阅。
改不回去。
因为计量单位决定了商业模式的上限。
订阅的计量单位是“座位”。座位数跟什么走?跟人头走。一家公司有 1,000 人,最多买 1,000 个座位。想多收钱,只能等它招人,或者涨价。
按量计费的计量单位是“任务”。任务数跟什么走?跟业务量走。
一个 20 人的法务部,去年审 1,000 份合同,今年因为并购审了 10 万份。座位数没变,任务数涨了 100 倍。
这就是为什么 Anthropic 80.2% 的收入来自使用量计费。
(ps:这不是它想不想的问题。如果它坚持按座位卖,那个法务部今年和去年付的钱是一样的,而它消耗的算力涨了 100 倍。按座位收费的 AI 公司,会在客户用得最狠的时候亏得最惨。)
所以按量计费不是定价技巧,是成本结构的必然:AI 有边际成本——每一 token 都要烧电、占显存、排队列——而软件没有。有边际成本的东西,只能按用量收费。
而一旦按用量收费,收入的增长曲线就跟客户的工作量绑定了,不再跟客户的员工数绑定。
这是整个 AI 商业模式的第一块基石。
它还有一个副作用,很多人没注意:按量计费把风险从供应商转移给了客户。
订阅模式下,客户用得少,是供应商赚;客户用得多,是供应商亏。按量计费反过来——用得少客户省钱,用得多客户掏钱。
所以客户会开始算 ROI。而一旦客户开始算 ROI,他参照的就不是“这个软件值不值 200 美元”,而是“这个人值不值 12 万美元”。
定价锚,就是这样被客户自己往上推的。
五、900% 是怎么算出来的
现在可以把那个数字拆开了。
SaaS 的 NRR 公式很简单:老客户今年付的钱 ÷ 老客户去年付的钱。
• 客户去年 100 人,买 100 个座位;
• 今年 110 人,买 110 个座位;
• NRR = 110%。
这就是 SaaS 行业 120% 天花板的由来——它约等于客户自己的招聘增速。
AI 的 NRR 公式看起来一样,但分子分母的性质完全不同:
• 客户去年用 AI 处理 1 万份文档;
• 今年处理 10 万份;
• 每一份的价格还降了 40%;
• NRR 还是 900%。
注意这里最反直觉的一点:单价在降,收入在涨。
Anthropic 的招股书写明,Opus 5.5 相比上一代,客户每任务成本降低约 40%。同时,2026 年第二季度收入同比增长 1,368%,而算力与基础设施费用只增长 300%。
经济学里有个名字解释这个现象,叫杰文斯悖论:效率提升让单位成本下降,但总消费量上升得更快,结果总支出反而增加。
19 世纪是煤炭,20 世纪是汽油,21 世纪是 token。
(ps:Anthropic 的 CFO 在播客里明确用这个词解释他们的增长。这不是我硬套的。)
还有一组数字,能把“降得有多快”说清楚:一项针对 3,237 个模型定价的研究算出,AI 推理价格的半衰期大约是 1.1 年——每过 13 个月,同样的智能,价格腰斩一次。这比摩尔定律还快。
价格每 13 个月腰斩,而收入在翻倍增长。
这意味着什么?
意味着客户买到的智能,一年比一年多;而他付的钱,一年比一年多得更快。
这不是悖论,这是需求曲线在往下移的同时,往右移得更快。
而需求曲线为什么往右移?因为每一次降价,都会把一批“以前做不起”的任务,变成“现在做得起”。
以前请不起律师的小公司,现在能请了;以前做不起全量质检的工厂,现在能做了;以前只能抽查 1% 合同的法务部,现在能审 100%。
杰文斯悖论的本质,不是“人用得更多”,是“原来不存在的需求被创造出来了”。
这一点,是判断这轮 AI 是“真扩张”还是“假繁荣”的关键。
如果是纯替代,客户的总支出应该下降——因为他只是把人换成机器,机器更便宜。
如果是真扩张,客户的总支出会上升——因为他开始做以前做不起的事。
900% 的留存率,说明是后者。
六、渗透率 50%,钱包份额 0.1%
这是招股书里最容易被忽略、也最值得盯的一对数字。
截至 2026 年 9 月 30 日:
• 财富 500 强中,超过 50% 是 Anthropic 的客户;
• 财富 10 强,全部是;
• 但在这些客户的总支出里,Anthropic 的收入平均只占 不到 0.1%;
• 前十大客户,也只占它们支出的不到 1%。
翻译一下:客户已经进门了,但还没开始真正花钱。
很多人看到“50% 渗透率”会觉得增长快到头了。恰恰相反——这个数字说明的是“开户率”,不是“使用率”。
真正的增长空间,不在拉新,在加深。
而“加深”这件事,在订阅模式下几乎做不到(一个员工不能买两个座位),在按任务计费模式下却是自然的(同一个员工可以让 AI 干十倍的活)。
钱包份额从 0.1% 到 1%,就是 10 倍。而这 10 倍,一个新客户都不需要。
Anthropic 的 CFO 在播客里讲过一个场景:一个客户在 20 分钟内,签下了两笔八位数美元的合同。
(ps:不是在买一个软件,是在给一个部门重新定编制。这两笔合同如果按座位算,大概是几百份订阅;如果按人力算,是一个团队的预算。同一件事,两种记法。)
一个可以对照的细节:Anthropic 的客户里,TTM 收入超过 1,000 万美元的只有约 250 家,超过 100 万美元的有 1,900 家。
也就是说,一万一千多家十万美元级的客户,正排在这条升级路径的起点上。
七、人均 660 万美元:AI 第一个重组的,是自己
2025 年 9 月,Anthropic 每员工滚动 12 个月收入是 140 万美元。
2026 年 9 月,是 660 万美元。
一年,4.7 倍。
(ps:微软、谷歌这个数字大约在 200 万到 300 万美元之间,而且已经是很高的水平。660 万不是“效率高一点”,是“组织的形状不一样了”。)
5,300 名员工,年化收入 326 亿美元。
它凭什么?
招股书给了一个答案:公司 90% 以上的代码,由 Claude Code 自己写。
这形成了一个“闭合循环”——更强的模型帮助研究员更快地做实验、生成训练数据、跑评估、写代码;更快的研发又产出更强的模型。
Anthropic 的 CFO 说,他把 30% 到 40% 的时间花在算力上。
一个 5,300 人的公司,做出 326 亿美元的年化收入,还顺手把自己 90% 的代码外包给了自己的产品。
这是第一个证据:AI 不是“给企业提效的工具”,它是“重写企业形状的模具”。
而它第一个重写的,是自己。
这件事还有一层含义,很多人没往下想。
如果一家 AI 公司自己能做到 660 万美元/人,那么它的客户会问一个问题:“你能做到,我为什么不能?”
这个问题一旦被问出来,客户买的就不再是“一个工具”,而是“一套重组方法”。
而这套方法的交付物,不是软件许可,是组织变革。
组织变革没法按座位卖。它只能按项目、按人头、按结果卖。
定价锚就是这样,被客户的需求推着,一层一层往上爬的。
八、治理结构不是道德,是商业基础设施
讲到这里,得说一件容易被当成“公关话术”的事。
Anthropic 是一家公益公司(PBC)。它的董事会依法要在三件事之间权衡:股东的经济利益、受公司行为影响者的利益、以及公司的公益宗旨。
它还设了一个“长期利益信托”(LTBT)——五名不持有任何经济权益的受托人,通常有权选举董事会多数成员。
IPO 前,它把 5% 的股权(8.47 亿股)捐给了一个公益基金;此后股价每较上一里程碑上涨 50%,董事会可再发最多 2%。
七位创始人各自承诺,把个人股权的 80% 捐给慈善。
它还做了三个“主动放弃收入”的决定:
1. Claude 永久无广告。 招股书原话:广告“很可能成为一笔可观的收入来源”,但“一旦广告成为公司收入目标的一部分,为提升用户参与度而优化的压力就会随之增长”。
2. 最强的模型没有立刻发布。 内部判断 Mythos Preview 的网络安全能力过强,先建防护、再以 Fable 5 的形式开放,向网络防御方提供了约 1 亿美元的额度。招股书承认:这“放弃了可观的收入,也把先发优势拱手让给竞争对手”。
3. 拿出 2 亿美元,与各国政府一起研究 AI 带来的“经济颠覆”该怎么应对。
如果你只看道德,这是一家很有情怀的公司。
但如果你看商业,这是一套极其精密的采购摩擦消除装置。
企业买 AI,最怕三件事:
• 我的数据会不会被你拿去训练?
• 你的模型会不会被广告污染,给我的答案不干净?
• 你会不会为了下个季度的财报,突然涨价或者砍掉服务?
PBC + LTBT 回答第三个(使命的否决权不在股东手里);无广告回答第二个;公开的模型系统卡、可解释性研究、企业级控制,回答第一个。
换句话说:治理结构不是在表达价值观,是在签发一份不可撤销的承诺书。
(ps:这就是经济学里的“可信承诺”。承诺之所以可信,不是因为你说了,是因为你把自己绑住了——绑得越死,对方越敢下单。一家公司愿意为了这条承诺放弃广告收入,这句话的分量,比任何一份 SLA 都重。)
还有一个小细节,我觉得比前面几条都更说明问题。
创始人在致股东信里写:
“永远不要让你的公司比它实际的价值多值一美元。”
(ps:一家公司在招股书里劝投资人别出高价。这不是谦虚,这是把“不夸大”写进了募资文件——因为你一旦这么说了,以后吹牛的成本就变得极高。)
OpenAI 走的是另一条路:从非营利,到“有限利润”,再到公益公司方向,边做边改。
两条路的起点不同,终点是同一个问题:怎么让“使命”比“季度财报”更硬。
因为客户买的不是模型,是“我敢不敢把核心业务交给你”。
而这,恰恰是第二层定价锚能不能站稳的前提。
一个客户不会把 12 万美元的人头预算,交给一个随时可能为了财报改定价的供应商。
九、产品不是模型,是发布节奏
Anthropic 的招股书里有这么一句:截至 2026 年 9 月 30 日的三个月里,近 90 天内发布的模型版本,贡献了 80% 以上的收入。
这句话值得停下来想三秒。
它意味着:三个月前的模型,已经不值钱了。
在一个旧产品迅速贬值的地方,静态的技术护城河是没有意义的。你今天领先两个版本,六个月后可能落后一个版本。
所以真正的护城河不是“模型有多强”,是“你有多快能发布下一个更强的模型”。
产品不是模型,是发布节奏。
这也解释了那 3.2 万亿美元的算力承诺。它不是“买产能”,是“买时间”——要在对手之前,把下一个模型的训练排进队列。
回头看这三年的产品演进,脉络很清楚:
每一步,都是把定价锚往上挪一层。
Claude Code 卖的不是“代码补全”,是“一个能规划、编写、测试、调试的初级工程师”。所以它敢按 token 收费,因为客户心里算的是工程师的工资。
Claude Cowork 更进一步,直接把“虚拟协作者”这个词写进了招股书:它拥有组织授予的权限、能调用内部工具、能执行跨多步骤的工作流。
OpenAI 那边有一句话,把这层意思说得更透:
“Agent 最有价值的能力,不在于它能替你做什么,而在于它能替你等什么。”
“替你等”,等的是人的时间。而时间是有工资的。
产品往下走,还有一个方向:从“帮你做”到“替你做决定”。
Claude Code 的负责人说,他手机上同时跑着几百个子智能体,夜间有数千个并行。这个场景描述的不是“工具”,是“一个团队”。
一个团队是有编制的,有编制的就有预算,有预算的就能被定价。
这就是第三层锚的入口。
十、从对话到物理:三把钥匙
过去三年,AI 的能力推进有一条清晰的路线:
对话 → 编程 → 完成任务的 Agent → 物理世界。
2022 年,它学会了聊天。2025 年,它学会了写代码。2026 年,它开始学着把一件完整的事做完。再往后,是机器人、自动驾驶、实验室里的移液枪。
很多人以为,这条路是按“模型有多聪明”排的——模型越强,走得越远。
不完全是。
决定一个行业先被吃下还是后被吃下,不是模型有多聪明,是它能不能同时凑齐三把钥匙。
第一把钥匙:数字化。 工作的产物是比特,还是原子?
第二把钥匙:可验证。 对错能不能被自动检查?
第三把钥匙:可承受。 错了的代价,能不能兜住?
编程为什么是第一个被吃下的? 三把钥匙全有。
代码是纯比特;编译器、测试、CI 会自动告诉你对错;写错了可以回滚、可以重来。在整个经济里,编程几乎是唯一一个“AI 可以自己给自己打分”的行业。
结果就是那个刺眼的数字:代码审查的单任务成本,从 48 美元降到 0.72 美元,66 倍。
客服为什么紧随其后? 数字化(对话是文本)、可验证(客户满意度)、可承受(答不好转人工)。成本从 4.18 美元降到 0.46 美元,9 倍,回本周期 4.1 个月。
营销为什么更快? 一份营销简报,人工 185 美元,Agent 2.4 美元,77 倍。因为它的验证标准最松——“看着像回事”就算过。
法律为什么慢? 三把钥匙有两把半。文档是数字化的,对错也能查,但错了的代价兜不住——一份合同漏掉一个条款,可能是几千万的官司。回本周期 14.8 个月,是客服的三倍多。
医药为什么最慢? 只有半把钥匙。临床前的文献检索、分子筛选是数字化的,但验证要等三期临床,周期八年起,错误代价是人命。回本周期 18.4 个月,是所有职能里最长的。
物理 AI 为什么最后? 三把钥匙只剩一把半。原子不是比特,现实世界没有测试套件,撞了人是不可回滚的。
(ps:所以“AI 什么时候能进制造业”这个问题,答案不在模型参数里,在“工厂能不能给 AI 提供一个可回滚的沙盒”里。数字孪生之所以重要,不是因为酷,是因为它把原子变成了比特,把不可回滚变成了可回滚——它是在给物理世界补第二把钥匙。)
10.1 冲击最大的,和价值最大的,不是同一批行业
这是这一节最反直觉的地方。
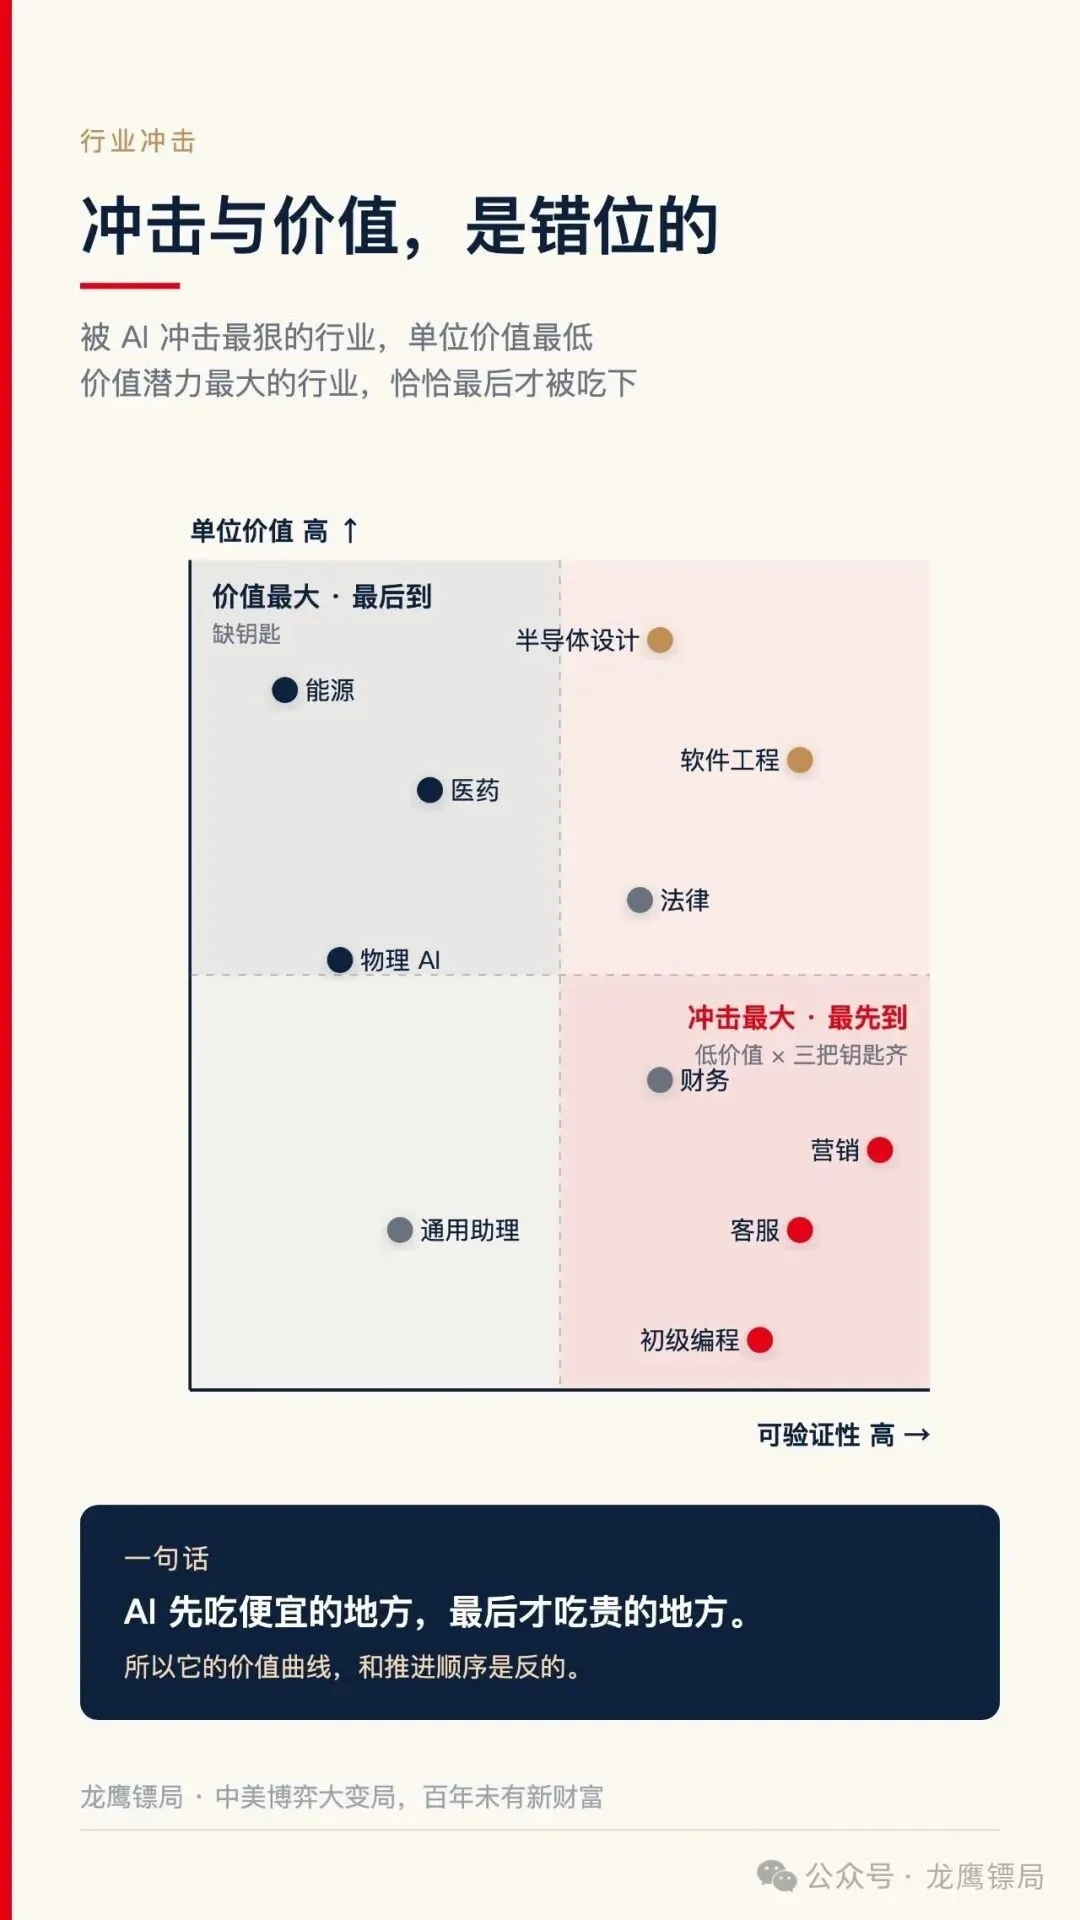
冲击最大的行业,是那些“三把钥匙齐全、但单位价值低”的行业。
客服、销售开发、初级编程、基础营销、基础财务——人力密度高、单价低、流程标准。AI 一进去,效率立刻翻几倍,因为它们的工作本来就是“可拆解、可验证、可替换”的。
价值潜力最大的行业,恰恰是那些“三把钥匙不全、但单位价值极高”的行业。
医药: 全球制药年支出超过 2 万亿美元,一个新药十年、二十亿美元。AI 只要能提高临床前筛选和试验设计的效率,省下的就是百亿美元级。有数据显示,AI 辅助可以把一期临床的成功率从 52% 提到 90% 量级——但这条路要走 24 到 36 个月才见回报。
半导体: 一次流片失败,损失 3,000 万美元起。这里的 AI 不是“省人力”,是“避免灾难”——回报不在成本表上,在资本开支的废品率里。
能源、制造、国防: 单位决策的价值极高,但物理约束最硬,可验证性最差。
换句话说:AI 先吃便宜的地方,最后才吃贵的地方。
这就解释了一个看起来矛盾的现象——
为什么 AI 的收入在暴涨,但全要素生产率还没动?
因为它现在主要在下沉市场,吃的是客服、营销、初级编程这些单价低、人力密集的环节。这些环节加起来工资总额不小,但对 GDP 的边际影响有限。
真正能撬动生产率的,是医药、半导体、能源这些高价值行业。而它们,恰好是三把钥匙最难凑齐的地方。
所以 AI 的价值曲线,和它的推进顺序,是反的。
先来的价值小,后到的价值大。
(ps:这也给了一个判断框架:如果你看到某家 AI 公司的主要客户集中在客服、营销、内容生成,它的增长是真的,但天花板也看得见;如果它开始出现在晶圆厂、临床试验、电网调度里,那才是第二层锚真正焊死的时候。)
十一、索洛悖论:为什么钱还没到
讲到这里,必须泼一盆冷水。
1987 年,经济学家罗伯特·索洛说了一句后来被引用了几十年的话:
“你到处都能看到计算机时代,除了在生产率统计里。”
(原文:You can see the computer age everywhere but in the productivity statistics.)
那一年,个人电脑已经卖了十年。此后的八年,生产率依然没有起色。直到 1995 到 2005 年,美国全要素生产率才突然加速。
中间那二十年,技术一直在,生产率一直没来。
为什么?
因为计算机不是自己产生效率的。它需要企业重写流程、重排岗位、重新定义谁对什么负责。而这些事,比买电脑难得多。
今天,同样的事正在发生。
模型的能力已经在前,组织的重组在后。
一家公司买了 Claude,如果只是让员工“用 AI 写写邮件”,它得到的是 5% 的效率提升,付的是软件预算的钱。
如果它敢把整个法务审核流程重写、把初级岗位重新定义、把考核标准从“工时”改成“交付”,它得到的可能是 30% 的成本下降,付的是人力预算的钱。
两种用法,差 6 倍。差别不在模型,在组织。
所以,AI 公司真正的产品,不是模型,也不是工具。
是“组织重组的路径”。
(ps:这也是为什么,Anthropic 要花大力气做 Claude Cowork、做行业垂直应用、和埃森哲德勤毕马威普华永道这类 SI 合作。它不是在卖软件,它是在卖“重组方法论”的分发渠道。)
这一节讲的是怎么用。下一节要问一个更狠的问题:就算组织重组了,多出来的那些钱,到底是凭空长出来的,还是从别人口袋里掏出来的?
十二、反驳:这不是创造价值,只是转移价值
有人会说:AI 把人干的活变成 token 成本,这不过是价值转移,不是价值创造。一家公司裁掉十个初级员工、买一份 AI 服务,GDP 一分没多,只是钱从工资单挪到了供应商的报表上。
这个反驳很硬,而且它抓住了一个真问题。
但它只对了三分之一。
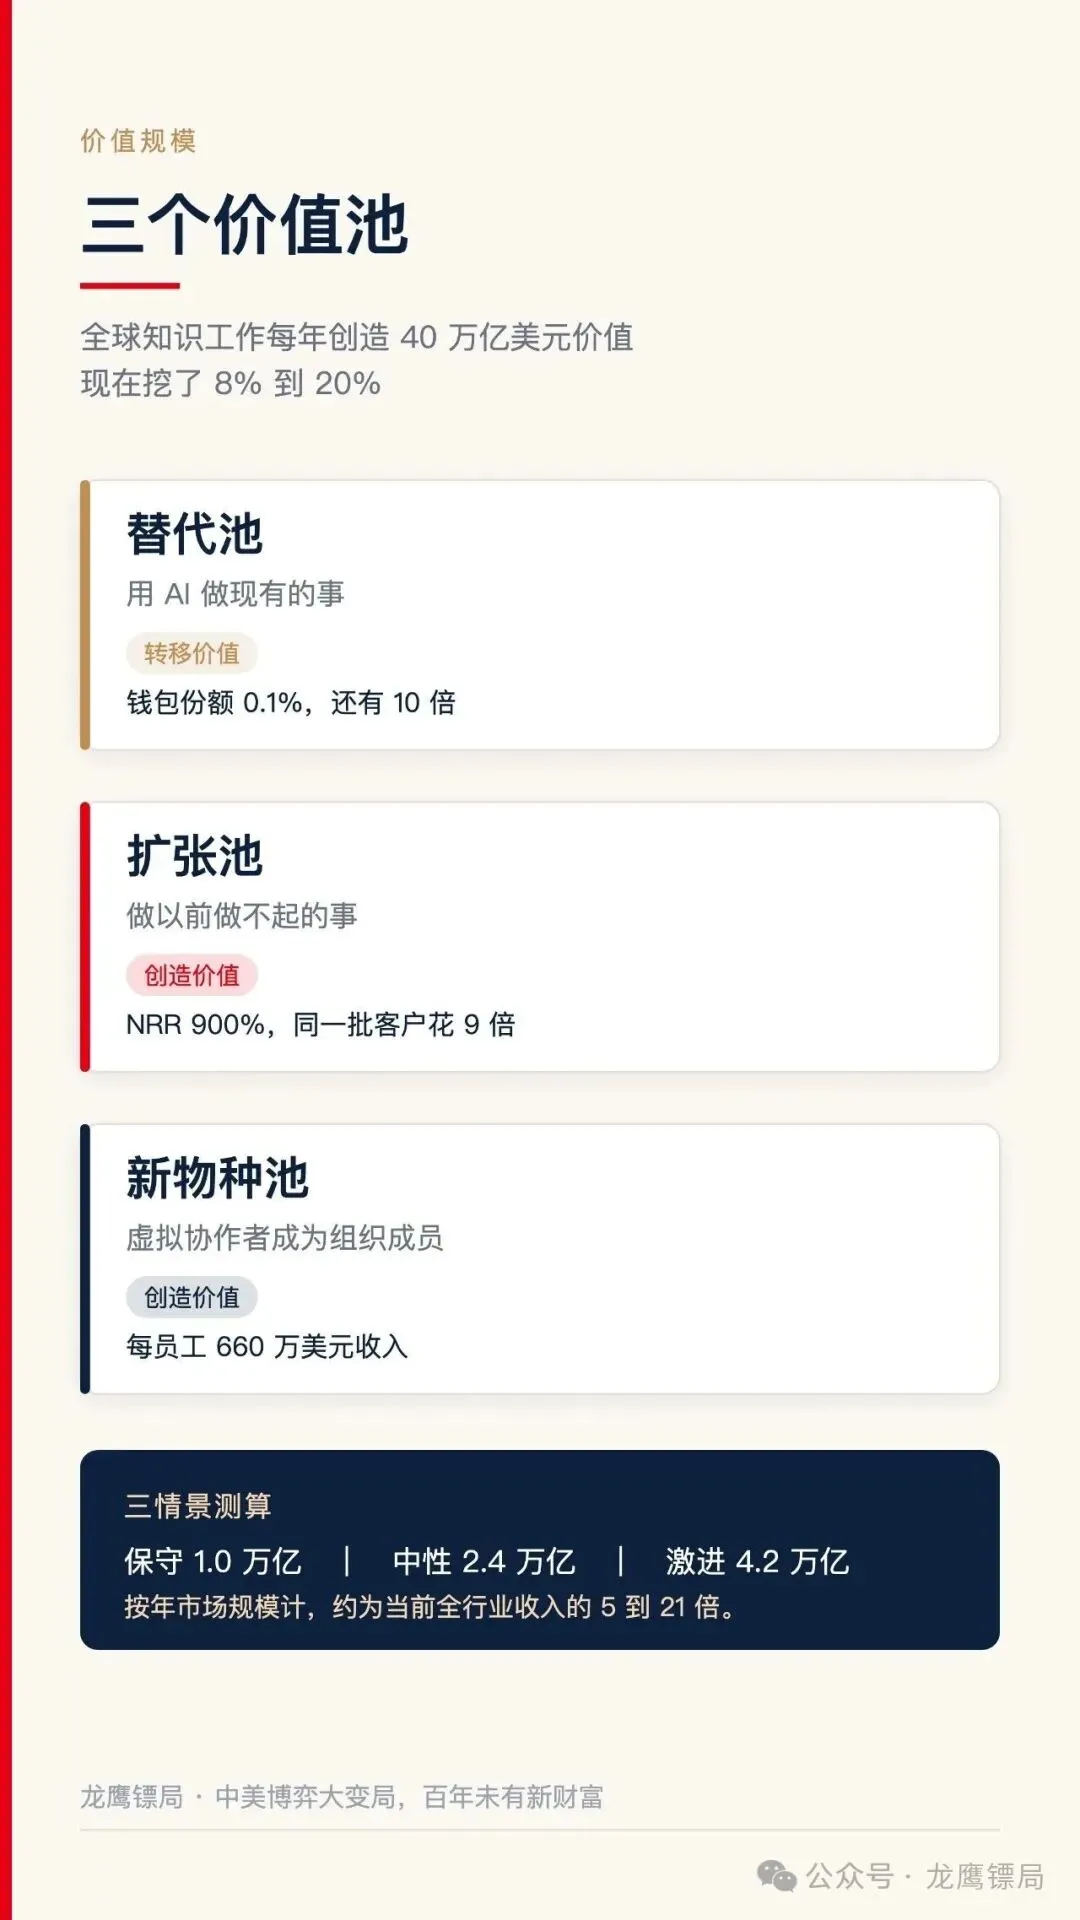
因为 AI 的价值池,其实是三块,而不是一块:
| 替代池 | 转移 | |
| 扩张池 | 创造 | |
| 新物种池 | 创造 |
第一块,确实是转移。它不增加 GDP,只是把工资变成了采购。这部分的天花板,就是被替代岗位的工资总额。
但第二块和第三块不是。
一个以前只抽查 1% 合同的法务部,现在能审 100%——这不是把原来那 1% 的工作换个人做,这是多做了 99% 原来根本不会做的工作。
一家以前请不起律师的小公司,现在能请了——这不是替代,这是把一个原本不存在的需求,变成了真实的市场。
全球有 46 亿人没有基本医疗服务。这个需求一直存在,只是从来没有人能负担得起供给。AI 如果能把它变成可支付的,那不是转移价值,那是凭空长出来一个市场。
900% 的留存率,正是“扩张”而非“替代”的证据。
如果是纯替代,客户的总支出应该下降——因为他只是把人换成机器,机器更便宜。
但 Anthropic 的客户,支出涨了 9 倍。
只有当客户在做以前做不起的事时,支出才会这样涨。
(ps:当然,这里面有一部分是“提前消费”——客户在为未来的能力预付。这正是上一篇讲的信用前置。但那是节奏问题,不是方向问题。)
十三、开源的反向压力:锚会不会被拽下来?
讲到这里,必须处理一个来自侧面的压力。
如果开源模型——DeepSeek、Kimi、Qwen 这些——把前沿能力的价格一路打到接近零,那 AI 的定价锚还爬得上去吗?
一个客户会问:既然开源模型免费,你凭什么收我一年 5 万美元?
这个质疑很硬。它也确实在发生:开源模型的每一次迭代,都会把上一代闭源模型的价格压下去。
但开源压的是第一层的价格,压不动第二层。
为什么?
因为第二层卖的根本不是模型。
回到那家 500 人的专业服务公司。它付 600 万美元,买的不是“一个能审合同的模型”——模型它能自己下载。它买的是:
• 谁帮我把审核流程重写一遍?
• 谁保证这套流程在监管检查时站得住?
• 出了问题,谁负责?
这三件事,开源给不了。
(ps:这个逻辑在软件史上验证过。Linux 免费了三十年,红帽卖订阅卖到几百亿美元,AWS 靠它赚得更多。安卓开源,谷歌靠服务赚钱。开源的从来是“地基”,卖的从来是“在上面盖楼的能力”。)
更反直觉的一点是:开源可能不是威胁定价锚,而是加速它上移。
因为当 token 价格被开源打到极低时,按座位卖 AI 这件事就变得没有利润了——一个座位一年 200 美元,扣掉算力和服务成本,几乎不剩什么。
逼得所有玩家只能往上走:不能靠“卖使用量”赚钱,就得靠“卖结果”赚钱。
开源把第一层的路堵死了,反而把所有人赶向了第二层。
这也是为什么,Anthropic 要把大量精力花在 Claude Cowork、行业垂直应用、以及系统集成商身上——它不是在卖模型,它是在铺“重组方法论”的分发渠道。
模型会开源,方法论不会。
这也是中美 AI 竞争真正的分水岭:一边在卷模型,一边在卷重组。
说句公道话:中国在开源模型上的推进速度,本身就是这场竞争的另一个答案。模型越便宜,企业重组的成本越低,越敢把 AI 塞进真实的业务流程里。卷模型和卷重组,不是高下之分,是分工之别——只是利润最后会落在后者。
而被追平的永远是价格,不是方法。那些写不进论文、只能从一千个真实项目里长出来的“暗知识”,才是第二层定价锚真正的地基。
十四、算账:三个池子,现在挖了 8% 到 20%
现在可以算规模了。
先把锚定物摆好。Anthropic 招股书引用了一个数字:2025 年,全球知识工作者所从事的工作,创造了超过 40 万亿美元的经济价值。
另一个数字来自 IDC:到 2031 年,对 AI 解决方案和服务的投资,将带来累计 22.5 万亿美元的全球经济影响。
第三个:到 2028 年,全球知识工作者将超过 10 亿人。
基于这三个数,做一个简单的三情景测算:
| 1.0 万亿美元/年 | |||
| 2.4 万亿/年 | |||
| 4.2 万亿/年 |
(ps:这三个假设都可以吵。但请注意,即便按最保守的一档,市场也是现在的 5 倍。而这三个数的乘数关系,才是真正该盯的东西——效率提升一点、捕获率高一点,结果就差一倍。)
再看今天的位置。
全行业 AI 收入,大致在 2,000 亿美元这个量级。这是把 Anthropic 年化 326 亿、加上 OpenAI 和其他玩家加总的粗估,不同统计口径之间可能差出不少。
拿它去比:
• 除以 40 万亿的“全部知识工作价值”,是 0.5%;
• 除以保守情景的 1 万亿“可被 AI 定价的市场”,是 20%;
• 除以中性情景的 2.4 万亿,是 8%。
所以,请记住 8% 到 20% 这个区间,而不是 0.5%。
(ps:0.5% 这个数字很抓人,但我不建议用它。因为 40 万亿是产出,不是可被定价的成本。把产出当分母,会系统性高估空间。8%–20% 这个区间,才经得起专业读者推敲。)
把这三个池子分开看,会更清楚:
| 替代池 | |||
| 扩张池 | |||
| 新物种池 |
前两个池子,可以用现有口径算。第三个不能。
因为当“虚拟协作者”成为组织的标准配置,一家 100 人的公司可以调度 1,000 个智能体时,“公司有多少人”这个统计口径本身就失效了。
而所有的 TAM 测算,都建立在“公司有多少人”之上。
所以真正的上限,可能比 4.2 万亿还高,也可能根本算不出来。
这不是含糊其辞。这是这门生意第一次出现“分母失效”的情况。
十五、反面:四个刹车
这套逻辑很漂亮,但它有四个可能断掉的地方。
前三个,Anthropic 的 CFO 自己在播客里列出来了:
第一,企业扩散放缓。 模型能力强,但客户用不起来。用例追赶不上能力,收入就会停在那儿。
第二,规模定律失效。 如果算力堆上去、能力不再涨,“买时间”的算力承诺就变成了纯粹的负债。
第三,前沿竞争加剧。 价格战会把毛利打下来,而按量计费的生意,毛利一薄,规模越大亏得越多。
我要补第四个,也是这篇文章的核心:
第四,定价锚爬不上去。
如果 AI 最终只能停在第一层——客户始终拿它跟 Office 比价,一年 200 美元一个座位——那么 900% 的留存率就是一次性的异常,40 万亿就是一个永远够不着的数字,3.2 万亿的基建承诺就是一场豪赌。
爬上去,还是爬不上去,这是这轮 AI 唯一的真问题。
而判断它爬没爬上去,不需要看模型跑分,看五个数就够了:
1. 使用量计费占比(现在 80.2%)还在不在涨
2. 每员工收入(现在 660 万美元)还在不在涨
3. 钱包份额(现在 0.1%)有没有突破 0.5%
4. NRR 有没有掉到 300% 以下
5. 每任务成本下降时,收入是不是还在加速(杰文斯悖论还成不成立)
这五个数里,最灵敏的是第五个。
因为前四个都是结果,第五个是机制。只要“降价→用量暴涨→收入上升”这个链条还在转,这门生意就还是活的;这个链条一断,前面四个数迟早会跟着塌。
十六、铁匠铺的第二夜
上一篇讲过一个铁匠铺的故事。
铁匠赊镐头给矿工,账本上记的不是镐头,是对金矿的信仰。
这一篇,讲它的下半段。
铁匠后来发现,赊镐头这生意有个天花板:一个矿工一年最多用坏三把镐头。就算全村的矿工都来赊,他也只能赚三把镐头的钱。
于是他做了个决定:不要镐头钱了,改分成。
矿工挖到金子,分他一成。
定价单位从“镐头”变成了“金子”。
头一年,他的收入翻了十倍。因为金子比镐头值钱得多。
第二年,他开始睡不着觉。
因为分成意味着,他得懂矿。矿脉往哪走、哪个坑该弃、哪支队伍靠谱——这些他以前不用管的事,现在全成了他的事。
而且,如果矿挖空了,他一分钱都拿不到。
(ps:这就是从“软件预算”爬到“人力预算”的代价。你赚得多了,但你也得对人家的结果负责。)
铁匠最后想明白一件事:
卖镐头的人赚的是手艺钱,分金子的人赚的是判断钱。
而这一轮 AI,所有公司都在从前者变成后者。
Anthropic 把 5% 的股权捐了出去,承诺永不放广告,为了安全主动延迟发布最强的模型——这些看起来像“不赚钱”的决定,其实是在做同一件事:
它在说服矿工,自己不是来卖镐头的。
因为只有当你相信对方不是来卖镐头的,你才会把矿脉图给他看。
所以,回到最开始那个问题:900% 的留存率,是怎么来的?
不是因为它把软件卖得更贵了。
是因为它换了一个比价的对象。
从“一个座位一年 200 美元”,换成“一个知识工作者一年 5 万美元”。
从软件预算,换到人力预算。
这一步跨过去,AI 就不是一个 1.5 万亿美元的行业,是一个 40 万亿美元价值池里的定价者。
跨不过去,它就是一场被误读成革命的软件升级。
上一篇的结尾问:山里的金子,挖出来了没有?
这一篇的答案是:
金子一直在那儿。问题从来不是有没有金子,是你打算按镐头收费,还是按金子收费。
本文数据来自 Anthropic S-1 招股说明书、CFO 公开访谈、OpenAI 官方分享及 IDC 等公开研究。40 万亿为知识工作创造的经济价值,非工资总额;相关测算为基于公开假设的推演,非公司披露口径。
本文不构成投资建议。