ARTICLE · 1306848
不同文档的知识冲突,RAG 应该信谁?
召回来的文档之间如果对同一问题给出矛盾的答案,相似度帮不上忙——两篇都和 query 很像,系统分不清谁更可信。这一关必须靠元数据与规则。
一、冲突为什么相似度解决不了
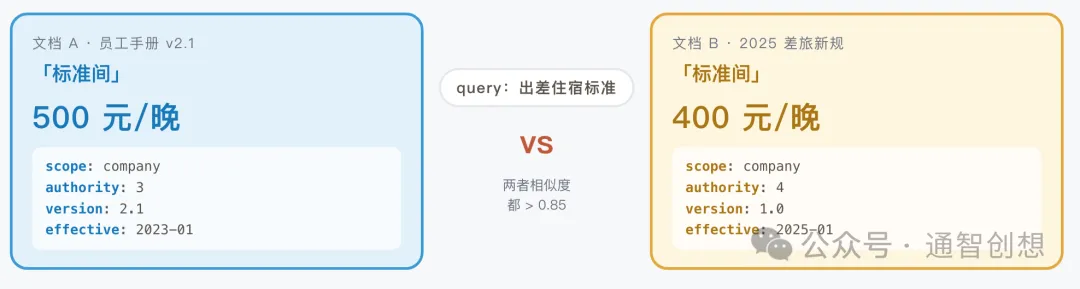
用户问「出差住宿标准是多少」。库里两份文档:一份是 2023 年版《员工手册》写着「标准间 500 元/晚」,一份是 2025 年新发的《差旅管理办法》写着「标准间 400 元/晚」。两者与 query 的相似度可能都是 0.85 以上,Embedding 模型看不出谁更新、谁更权威,它的训练目标只是语义相近则向量相近,不是「判断谁更可信」。
这还不是最糟的。更糟的是冲突可能不是显性的数值矛盾,而是隐性的前提不同。手册里写「国内出差住宿 500 元/晚」,制度里写「境外出差住宿 200 美元/晚」,单看 chunk 文本两者都完整、都没错,但混着用就会出错——用户问国内差旅时拿境外标准去答,或反过来。这类隐性冲突只能靠元数据里的适用范围字段区分,文本本身不会告诉你。
冲突分两类:显性冲突是数值或结论直接矛盾(500 vs 400),容易发现;隐性冲突是适用范围或前提不同(国内 vs 境外、普通员工 vs 高管),表面看文本没矛盾,但用错场景就出错。隐性冲突比显性更隐蔽,是 RAG 系统最容易「自信地答错」的地方。
二、裁决四层顺序:从最硬到最软
裁决顺序是固定的:适用范围 → 权威度 → 版本号 → 生效时间。前一层能裁决,就不再往下。
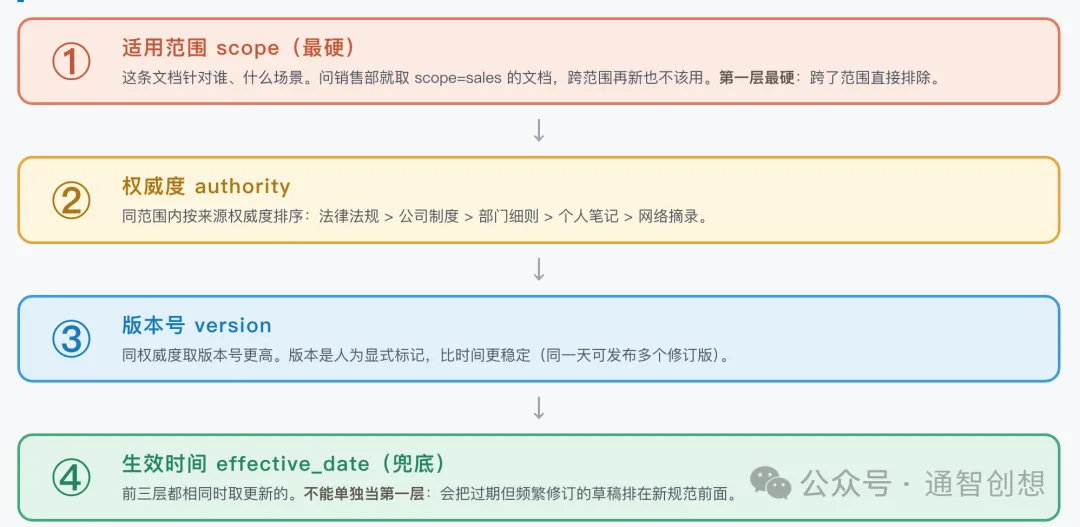
第一层,适用范围。这条文档针对谁、什么场景。用户问的是「销售部报销标准」,就优先取 scope=sales 的文档;财务部那份再新也不该上场。适用范围是冲突裁决里最硬的一层,跨了范围的文档不管多权威都不该用。元数据里用 scope 字段记录,常见取值如 company、department:sales、region:cn、role:manager。
第二层,权威度。同适用范围下,来源的权威等级决定优先级。法律法规 > 公司制度 > 部门细则 > 个人笔记 > 网络摘录,这个顺序在元数据里以 authority 字段(如数字 1~5 或标签)记录。比如同是公司级规范,董事会决议比普通行政通知权威度高。
第三层,版本号。同适用范围、同权威度下,取版本更高的。元数据里的 version 字段,常用语义化版本号(如 v1.3.0)。版本是对文档演化的显式标记,比时间更稳定——同一文档可能在一天内发布多个修订版,单纯看时间会漏。
第四层,生效时间。前三层都相同时取 effective_date 或 updated_at 更新的。这一层是兜底,不能单独当第一层用。常见错误是只看时间:把一份 2020 年发布、2024 年修订的内部 wiki 笔记排到 2025 年发布但 2022 年定稿的正式制度前面,因为笔记修订时间更新。时间必须配合前三层用。
顺序为什么是这个?因为每一层都比下一层更「硬」。适用范围是文档自身的定位,权威度是来源的等级,版本号是人为显式标记,生效时间是自动记录。越硬的字段越难被错误修改,越该优先。反过来用,就会把过期的草稿排在新规范前面。
三、元数据是身份证:缺字段就拒绝入库
四层裁决都依赖元数据,元数据不全,裁决就跑不起来。每条 chunk 的元数据至少包含:source(来源文件)、author(作者或部门)、scope(适用范围)、authority(权威等级)、version(版本号)、effective_date(生效时间)、updated_at(最后修订时间)、topic(文档主题分类)。
其中 scope、authority、version、effective_date 是裁决必备;source、author、topic 用于溯源与检索过滤(第 3 篇讲过 metadata 在检索时的过滤作用)。这些字段在切块时就要写进 metadata,入库后很难再补。
工程上要做一条入库校验规则:元数据四字段(scope/authority/version/effective_date)缺一个就拒绝入库,强制补全。缺字段入库是冲突裁决跑不起来的根因,比后面的检测算法更该优先治理。很多团队在建库初期忽略元数据,等出现冲突才发现整库都得返工补字段——这一步是治本。
四、冲突检测两条线:离线主动发现、在线兜底把关
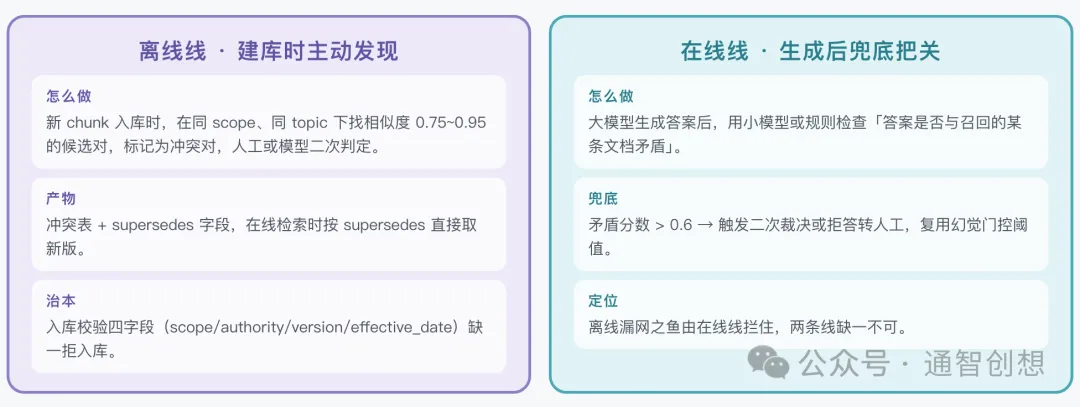
离线线在建库时跑。做法是:对每个新入库的 chunk,在同 scope、同 topic 的已有 chunk 里找相似度 0.75~0.95 的候选对(阈值要调:太低会拉来不相关文档,太高几乎就是重复),把它们登记到冲突表,由人工或大模型二次判定是否真的冲突。确认为冲突的,记录冲突对 ID、冲突类型(显性/隐性)、当前裁决结果,并在新文档 metadata 里挂一个 supersedes(替代)字段指向旧文档。这样在线检索时遇到这一对,直接按 supersedes 取新版。
在线线在生成之后跑。做法是:大模型生成答案之后,用一个小模型或规则检查「答案是否和召回的某条文档矛盾」。例如召回到 5 条文档,答案与其中 3 条一致、与第 4 条矛盾,就触发二次裁决:第 4 条是否被正确处理?是否该被排除?如果无法自动裁决,就拒答并转人工(第 14 篇讲的幻觉门控阈值 0.3~0.6 在这里可以复用:矛盾分数超过 0.6 就拒答)。
两条线缺一不可。离线线能发现已知冲突、写入 supersedes 让在线直接走;在线线兜底漏网之鱼——新文档刚入库还没跑离线检测、或者离线检测的阈值漏判,都由在线线拦住。
五、无法裁决时:诚实暴露,不要硬选
四层裁决走完,仍有分不出胜负的场景:两份文档同 scope、同 authority、同 version、同 effective_date,但结论不同。可能是不同部门对同一问题发布了冲突规范、或者同一文档被多人同时修订出了分叉。
这种场景千万不要硬选一个。RAG 系统硬选一个错的,用户下次不再信这个系统,信任成本很高。正确做法是诚实暴露:把两个(或多个)符合条件的答案连同它们的元数据一起展示给用户,例如「根据《员工手册 v2.1》(人力资源部,2024-06 生效)住宿标准 500 元/晚;根据《2025 差旅新规》(财务部,2025-01 生效)住宿标准 400 元/晚,请联系 HR 确认适用条款」。用户能根据来源自己判断,而且这种回答会建立「这个系统不糊弄」的信任感。
诚实暴露不是偷懒,是生产系统对知识边界的自觉。能裁决就裁决,不能裁决就说清楚,比假装知道更值钱。
六、灰度发布:新文档不能瞬间覆盖全量
新规范入库时最容易出事故:一条新文档覆盖了旧文档,所有相关问题瞬间换了答案。如果新文档写错了、或者适用范围比预期更广(比如原本只针对海外员工的规范被误标为 company scope),整个库的回答会污染一批才被发现。
做法是灰度发布。新文档入库后按流量比例逐步切换:先给 1% 的用户用新答案,观察几天;没有投诉或点踩上升就放到 10%;再观察几天放到 100%。有问题一键回滚,回滚只是切流量开关,秒级完成。工程上通常用一个 release_flag 字段在 metadata 里标记灰度状态(如 canary/stable),检索时按灰度策略过滤。
灰度发布的成本很低,但能挡住绝大多数「新文档覆盖错」的事故。这是 RAG 系统进入生产环境之后必备的一道安全网,与冲突检测、诚实暴露一起组成可靠性治理的三件套。
最后一个边界:冲突治理是 RAG 可靠性的一部分,与第 14 篇的幻觉防控、第 16 篇的持续更新一起,构成上线后必须持续投入的治理工作。它不是「写一次规则就完事」,而是文档库在演化过程中一直要维护的能力。
如果这篇让你能讲清「相似度 ≠ 可信度」「四层裁决顺序」,点个赞与「在看」,让这个系列被更多准备面试的朋友看到。