ARTICLE · 1310287
DIA-NN 引擎源码考古 · 1.7.12 · 第四回 · 打分不算完,越揉越靠谱 ~
上一回 《DIA-NN 引擎源码考古 · 1.7.12 · 第三回 · 候选排队过堂,证据都在峰里》,咱们把一条候选在一轮检索里的路走完了:找位置、取曲线、认峰、打分、选峰。每个候选都拿到了自己的最优峰,也拿到了一摞 110 维的证据和一个总分。
可文章结尾小编就说过,分打完了,事儿没完,还欠着三笔账:分数折算用的那套权重从哪儿来?所有候选排到一条队上,可信度怎么算?还有校准,上一回 RT 窗口怎么算的、扫描半径什么时候定死,都留给了校准。
这一回就把这三笔账一次结清,外加把它们串起来的那台机器:学权重、算 q 值、做校准,三个部件,装进一个循环里反复转。
本篇范围
这一篇只讲打分之后的下半场,权重怎么学、q 值怎么算、校准怎么对表、循环怎么转。干扰怎么精修、定量结果怎么产出,不在这一篇,留给后续文章。
起手:一轮检索的下半场
上一回的结尾,小编留过一句 "分打完了,事儿没完",现在就来对对账:这没完的事儿到底是啥?说白了就是开头欠下的那三笔:打分用的权重从哪儿来、一队候选的可信度怎么算、校准又在对什么表。三笔账都记在 "打分之后" 的下半场里,咱们一笔一笔地来。
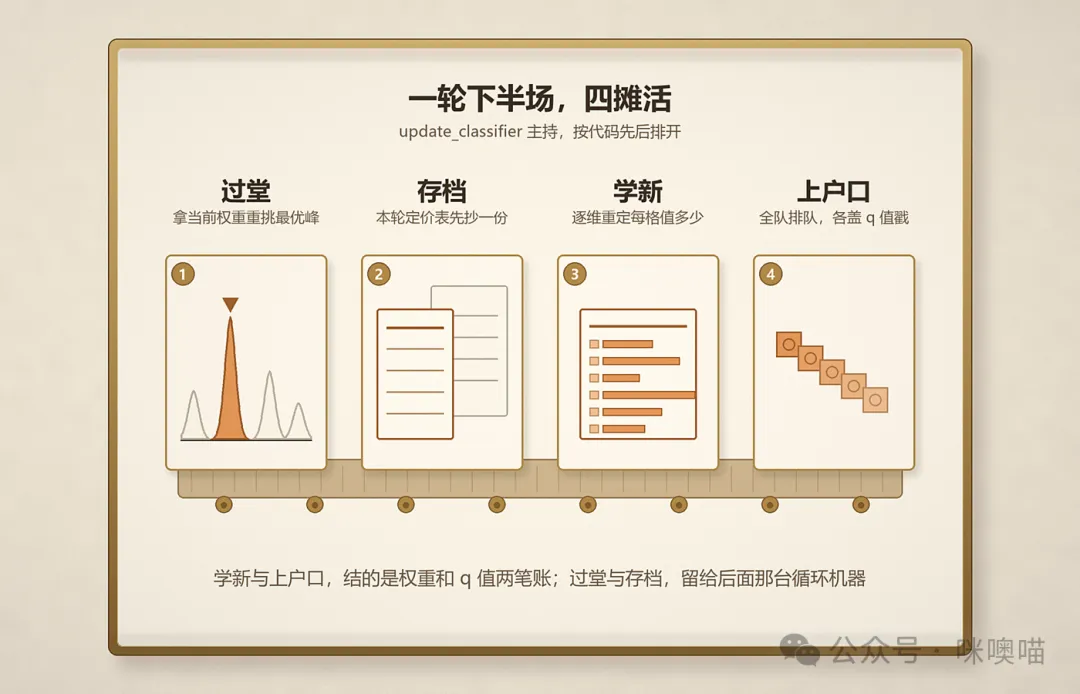
不过在动手算账之前,得先认识一下管账的人。上一回讲的 search(),说到底只是个干活的工序,它只负责 "按当前的规则打分",可规则本身(每维证据值多少钱)它管不着。真正管规则的,是 update_classifier()(L9670)。这个函数像个班组长,一轮的下半场由它主持,手头有这么几摊活:重新过堂挑峰、抄一份存档、学一套新定价表、给全场上户口。下面按代码里的先后,一摊一摊看过去。
头一摊:重新过堂,挑出各自的最优峰
seek_precursors()(L9682)干的就是这摊活。镜头先从代码拉回实验台,做过液质联用的都熟这个画面:一条肽段跟着流动相洗脱下来,在质谱里被检出;把这条候选的离子信号沿时间轴铺开,就是它的提取离子色谱。真正洗脱的那一刻,信号会实打实地鼓起一个包。这个 "峰",就是它在本次进样里的一次露头。
可真实数据没那么干净:一条候选的曲线上往往不止一个包,有的是共流出的离子凑热闹,有的是噪声鼓的小包,也有的确实就是它自己。哪个包才算数?靠肉眼挑可不靠谱。引擎的办法是逐个过秤:曲线上每一个峰都算一摞 110 维证据(峰形长得正不正、时间对不对得上、谱图像不像),再按 "每维证据值多少钱" 折成一个总分。
分最高的那个峰,就是这条候选的最优峰:引擎认定 "就是它了",这条候选的成绩和那一摞证据,全记在这个峰头上(上一回 "认峰、打分、选峰" 讲的就是这个挑法)。"各自" 的意思是每条候选各挑各的,你的最优峰和我的互不相干。
可挑峰的秤(权重)是会变的,第三摊马上就要学一套新的。秤一变,每个峰的分数跟着变,原来的第一名说不定就易主了。所以每轮开头都得重新过一遍堂:拿当前的秤给所有峰重新打分,重新选出各自的最优峰。
放心,重新的只是打分和挑峰,挖好的峰和证据不动,靠的是第三回埋的那条伏笔:峰和 110 维特征只挖一次(fInit 缓存),权重一换,seek() 只需拿新权重对缓存的特征重新点一次积(L8136)。反正证据不用重挖,重算的只是 "怎么给证据定价",这是后面所有 "反复" 能够便宜行事的前提。
第二摊:抄一份定价表存档
copy_weights()(L9683–L9684)干的就是这摊活:把这轮打分用的定价表原样抄一份存档。定价表就是权重,110 维证据各占多少分量,相当于批卷子用的评分标准。每轮学新标准之前先抄一份留底,将来论功行赏、翻车回滚都从这份存档起算,它是在为谁打底,到 "循环" 一节见分晓。
第三摊:学一套新定价表
fit_weights()(L9690)干的就是这摊活:拿这轮的成绩单当教材,学一套新定价表。教材是这轮 Target 和 Decoy 陪练对的答卷,真目标比诱饵高在哪、高多少,一维一维都是线索;怎么拿线索反推 "每维证据该值多少钱",是下一节 "学权重" 的正题。
第四摊:重折分数,给全场上户口
calculate_qvalues()(L9691)干的就是这摊活:用新定价表把所有候选的分数重折一遍,再给全场上户口,全部候选按新分数排成一条长队,靠混在队伍里的诱饵反推错判率,给每条候选盖一个可信度戳(q 值)。这一手 "让诱饵自己报错判率",正是 "q 值" 一节的正题。
四摊活看完,跟开头那三笔账正好对上:学新定价表是 "权重" 那笔账,给全场上户口是 "q 值" 那笔账;挑峰和存档这两摊,则是后面那台循环机器的零件。剩下两节各有各的正题:"校准" 结第三笔账,它不在这四摊里,是按轮次插进来跑的另一桩活,拿高置信的真目标把时间表(RT)和质量表(m/z)各对一次;"循环" 讲那台机器本身,三笔账连同这份存档装进去反复转十二圈,怎么分工、什么时候翻面、怎么论功行赏,全在那儿。
学权重:拿 "该过" 和 "不该过" 的对比解方程
教材:诱饵怎么造
权重的教材,是 Target-Decoy 对照,这套对照前面几回都露过面:每条真序列(Target)旁边都陪着一条造出来的假序列(Decoy),假的和真的一起下锅、一起找峰、一起打分。这套对照怎么靠它算 FDR,之前专门写过一篇科普:《质谱鉴定的 「打假办」,FDR:我来算算这伙里面骗子占多少!》。
可还有一件事科普替不了,那就是 这假货具体是怎么造的。第二回只留过一句 "跟常规的序列反转不是同一种造法",这里按 1.7.12 的源码把话头接上:它的造饵路数,跟早年软件那套 reverse(反转序列)的策略,从根上就不一样。
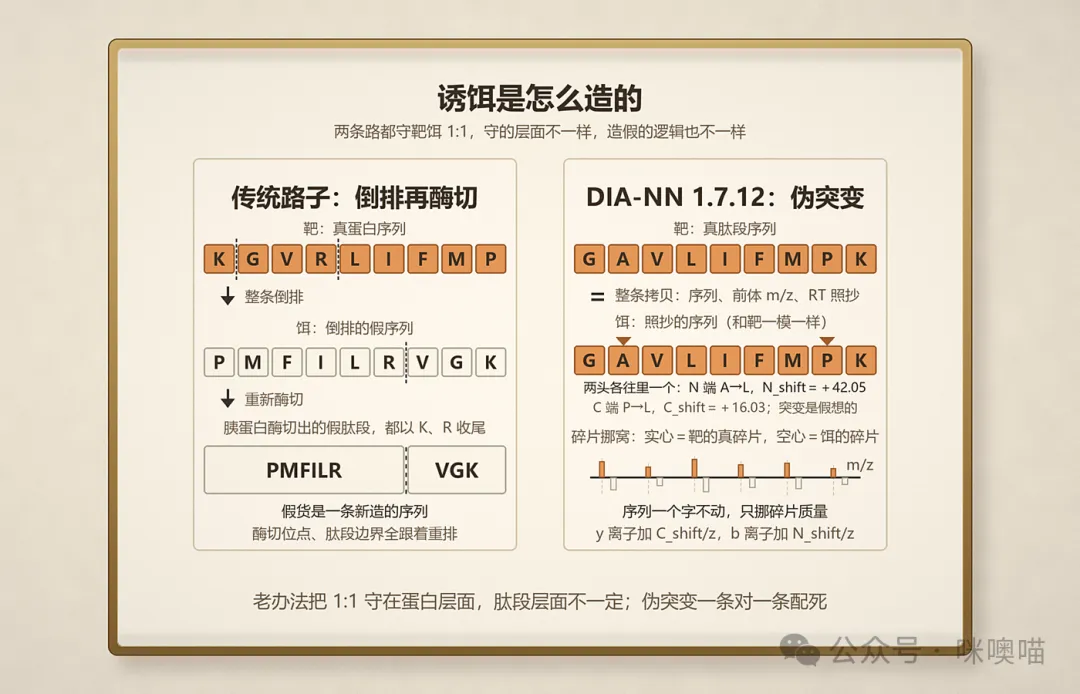
早年主流搜索引擎(SEQUEST、Mascot、MaxQuant 那一路)的常规造法是蛋白级反转:把整条蛋白的序列倒过来排,再拿同一把刀酶切,还是胰蛋白酶在 K、R 后面下刀,假肽段照样以 K、R 收尾。可序列一倒,K、R 的前后位置挪了窝,酶切位点、肽段边界跟着重排,切出来的是另一批假肽段,假货是 "新造的一条序列"。
DIA-NN 1.7.12 默认不走这条路。它的造法只有一招,可这招相当刁钻(generate_decoy,L3590–L3653)。说白了就是 序列一个字不动,只把碎片的质量整体挪个窝,名字叫 "伪突变"。
具体这么造:引擎先把 Target 原样拷一份当 Decoy(L3593),肽段名、氨基酸序列、前体 m/z、预测保留时间,全部照抄。然后在肽段两头各假想一处突变。挑位点有讲究:不挑最末端,而是两头各往里一个,N 端第 2 个、C 端倒数第 2 个(L3626–L3636);末端残基常挂着修饰,往里挪一个躲开它,真被修饰占了才退到末端。
突变成什么?对照表 MutateAAto 给 20 种氨基酸各配了一个假想去处(L1369–L1370):比如 V 和 L、N 和 Q、D 和 E 两两互换,质量差恒是 ±14.02 Da,恰一个 CH₂ 的分量;也有的单向换,比如 A 假想换成 L。
突变本身是假想的,序列一个字不改,只把置换的精确质量差记下来:N 端那处的记作 N_shift,C 端那处的记作 C_shift(譬如下文配图里面:N 端第 2 个 A→L,N_shift=+42.05;C 端倒数第 2 个 P→L,C_shift=+16.03)。
接着给碎片挪窝:假想突变在 N 端那头,就只挪 b 离子(带 N 端的半边碎片),统一加 N_shift/z;在 C 端那头的只挪 y 离子,统一加 C_shift/z(L3638–L3642)。序列、前体全没变,变的只有碎片该去 m/z 轴上哪个位置报到。
这门手艺有三处心思。一是 1:1 是结构性的:每条 Target 恰配一条 Decoy(Entry 里 target, decoy 并排声明,L3564),没有 "造几倍饵" 的旋钮。
靶饵 1:1 本是 Target-Decoy 的老规矩,两条路都守,差在守的层面。老办法守在蛋白层面:蛋白条数、氨基酸总数严格对得齐;可肽段层面就不一定了,倒排重切出来的是另一批肽段,条数对不齐、去重后构成还有出入,算 FDR 得按 "有效大小" 再校一道。DIA-NN 干脆守到每一条,一条对一条配死,不多不少。
造假的逻辑也不一样:传统是 "换条假序列从头再来",DIA-NN 是 "同一条序列,把证据挪到查不到东西的地方"。
二是挪窝的幅度是挑过的:假想突变的质量差从 −85 到 +56 Da 不等(W→T 最大,G→L 次之,摊到电荷上更小),碎片不会挪出仪器的采集范围,只会挪出真实碎片该在的位置,真肽段的信号峰盖不到它,Decoy 想拿高分,只能指望噪声峰侥幸凑合。
三是靶饵共享一切先验:同样的质量、同样的预测 RT、同样的搜索窗,挑假想突变位点时还特意绕开带修饰的残基(L3624–L3636),两伙的差别只剩碎片证据一样,对打比出来的才是谱证据的真假区分力。
引擎另留了一个备选开关 --reverse-decoys(L1850),走的是 "伪反转":序列内部倒排(首尾不动),碎片按倒排后的新序列重算(L3643–L3652)。可它只是备选,默认路数就是上面那套伪突变。假货的门道看完了,本篇只用它一个性质,就是 Decoy 是明知是假的。明知是假的还拿到高分,说明这套打分规则漏了。
第一级:解方程定权重
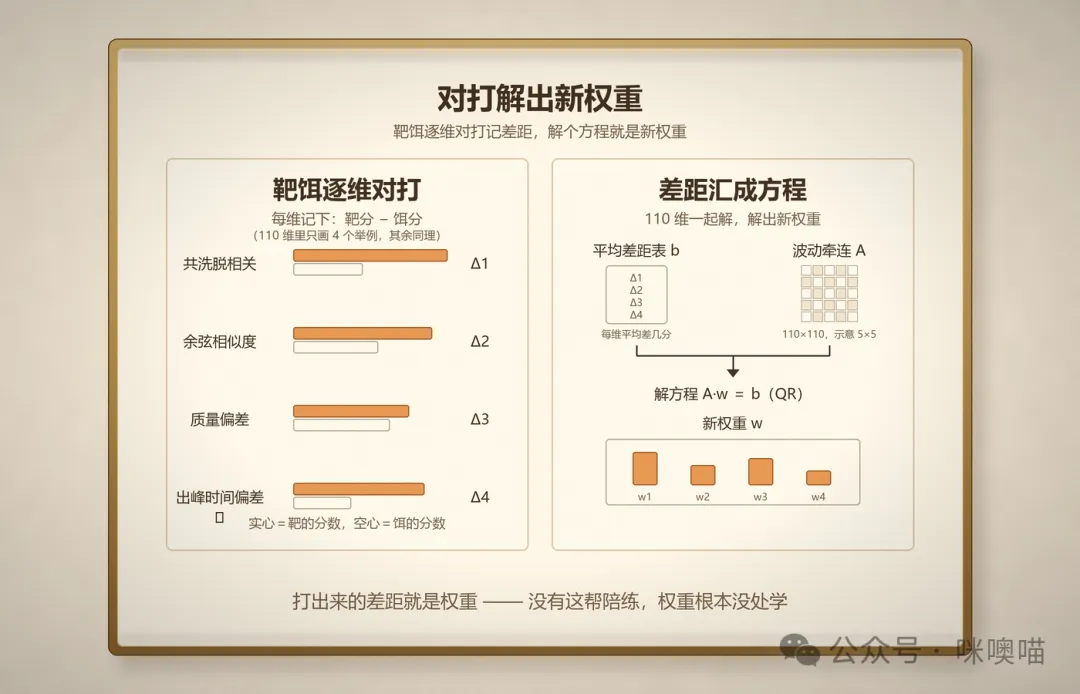
教材备好了,回头看第一级,线性分类器:110 维证据各乘一个权重、加成总分。这权重怎么学出来?fit_weights()(L9281)的思路就是这么朴素。它先扫一遍所有候选,只收 Target 和 Decoy 都找到了峰的那些条目(L9364),一对一的 "陪练对"。对每一对,逐维记下 Target 比 Decoy 高多少分(L9366–L9369),最后平均,得到一张 110 维的 "平均差距表":这一维上,真目标平均比诱饵高几分。
光有差距表还不够,还得知道每一维自己有多 "抖"。抖得厉害的维度,单看一次高下说明不了什么。所以第二遍扫描把差距表升格成方程组:一边是 "各维之间的波动怎么互相牵连"(A,一个 110×110 的方阵,L9284),一边是刚才那张平均差距表(b,L9285、L9414–L9415)。
解这个方程组(A·w = b,Eigen 全主元 Householder QR 求解,L1051–L1055),得到的 w 就是新权重,它保证:顺着这个方向把 110 维证据折起来,真目标和诱饵的分离度最大。
这套解法有个正式名号,叫 Fisher 线性判别。不过对咱们做分析的人来说,名字不重要,思路一句话就能记住,那就是 让真目标和诱饵在同一套标准下对打,打出来的差距就是权重。造 Decoy 花的那点功夫,在这里先收回一笔,没有这帮陪练,权重根本没处学(更大的一笔,到 "q 值" 一节才算)。
两个细节值得单说。一是门槛:配对少于 20 对,方程组根本不成形,这一轮直接放弃学权重(L9375–L9378),把权重重置回默认,只留头一维,其余全归零(reset_weights,L6585–L6589),接着转,宁可慢一点也不瞎学。
二是 110 维并不全员参战。每一维都在一张 "课程表" 上(pars,L6606–L6658),标着自己从第几轮起才准学习:最早的一批(共洗脱相关等 4 维)第 0 轮就能学;另一大拨(余弦相似度、质量偏差、出峰时间偏差等)要等校准收工再过两轮(CalibrationIter + 2,也就是第 6 轮)才放开,校准没做完,这些维度自己都还没对准表,学了也是白学;还有一批(预测 RT 位置、参考谱强度这些)从头到尾不学,它们是先验或中间量,学了反而添乱。
第二级:一排小神经网络
线性权重讲完了,该轮到那个 "招牌" 登场了。第一回就盘点过:DIA-NN 名气挂在神经网络上,可神经网络在引擎里统共只占约 240 行。那 240 行在哪儿?就在这儿,try_nn(L9436),而且是第二级。
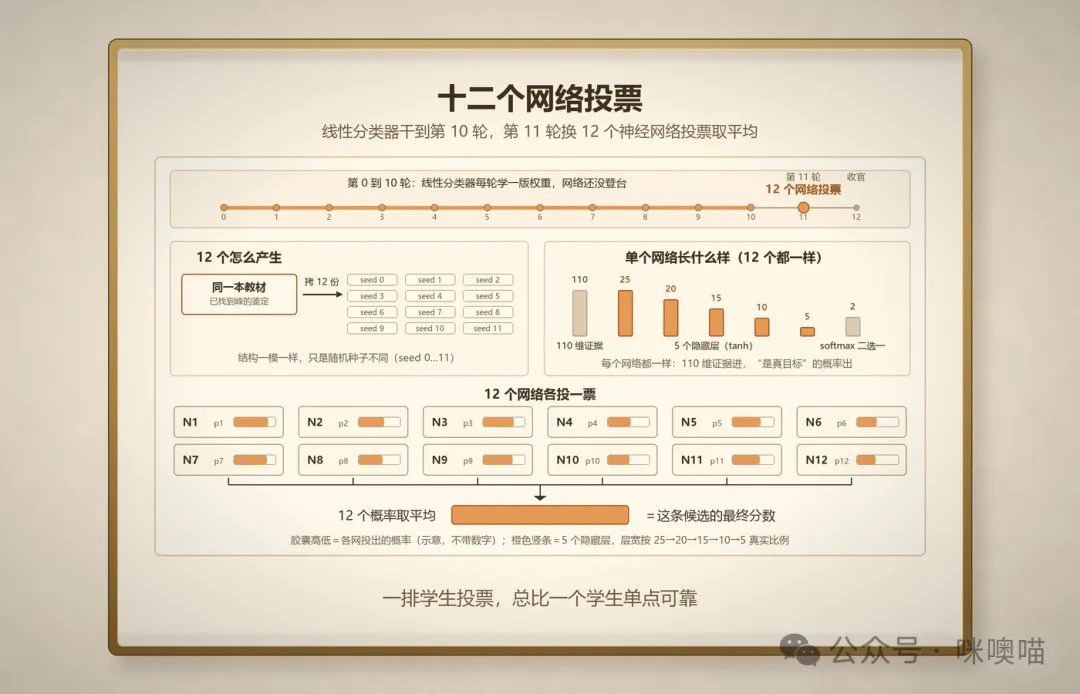
线性分类器先干到第 10 轮(nnIter - 1,nnIter 默认 11,L122)。到了第 11 轮,引擎才亮出神经网络的家底:NNClassifier(L6277),手头是 12 个小网络(nnBagging = 12,L191),每个网络的构造都一样:110 维输入,5 个隐藏层(宽度依次 25、20、15、10、5,L6300),tanh 激活(L6301),最后 softmax 二选一输出(L6310),交叉熵损失(L6312),Adam 优化器(L6317)。
训练就一个来回(nnEpochs = 1,L192),这套网络本来就小,教材也只是手头已找到峰的鉴定(默认还会剔掉带小修饰的肽,nnFilter,L196、L9346),高置信度那道门槛管的是够不够格开训,并不逐条挑教材。
12 个网络用的教材相同、随机种子不同(L6311),等于 12 个学生用同一本笔记各自复习。打分时,每个网络对每条候选独立给一个 "是真目标" 的概率(L9468–L9490),最后把 12 个概率平均(L9514–L9526),当这个候选的分数。一排学生投票,总比一个学生单点可靠。
开训也有硬门槛:q ≤ 0.5 的真目标不足 200 条且 q ≤ 0.1 的也不足 100 条(两道线一道都没过),或者诱饵不足 100 条,这一轮就干脆不训网络(L9438–L9441),样本太少,网络学到的只会是噪声。
另外还有个 "交叉验证" 开关(--nn-cross-val,默认关,L197):关着的时候,12 个网络全员用全部样本训练、也全员在全部样本上打分,纯粹靠种子不同凑多样性;打开后,nnBagging 被强制成 4 的倍数(L2226–L2227),每 4 个网络成一组,组内轮流扣出一部分样本不给自己训练、专门留着给它打分(L9322–L9328),训练和考试分开,防的是背题。
小编碎碎念:讲到这儿,第一回立的那个 "招牌与实物" 的账才算彻底对平,神经网络确实有,而且是十二个一起上;但它排在线性分类器后面,线性先把 10 轮的活干完,它才登台加一把劲。叫它 "锦上添花",不算委屈它。
q 值:让诱饵自己报错判率
权重换新的了,分数也重折了,接下来这步是给全场上户口:calculate_qvalues()(L9532)。
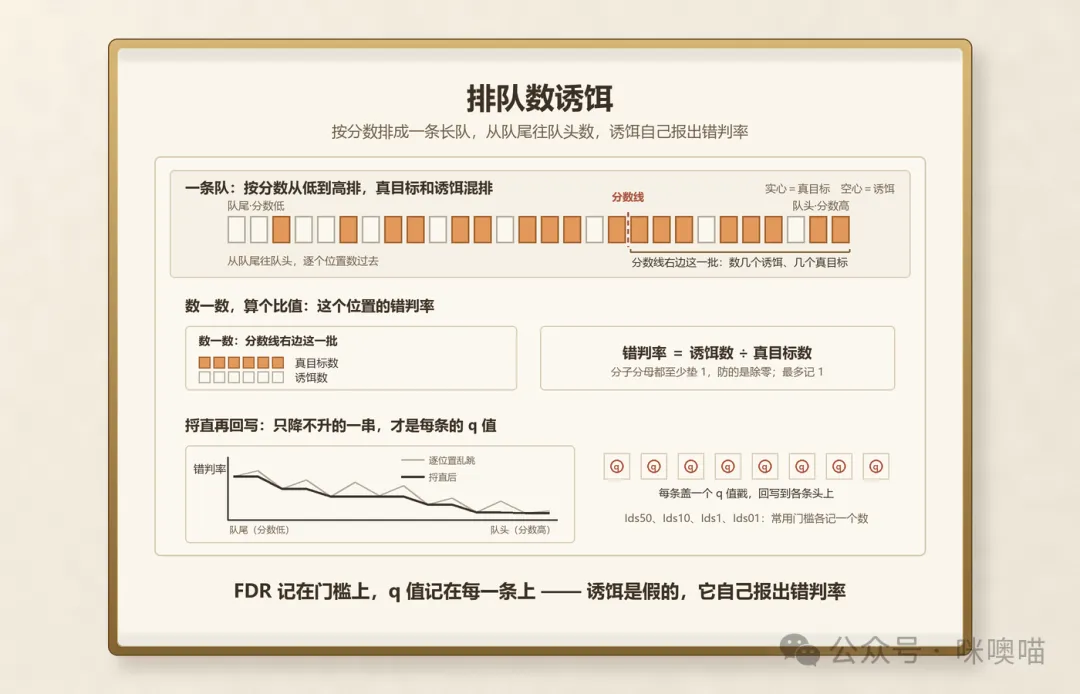
它干的事,说穿了简单得很:把所有找到了峰的候选按分数排成一条长队,然后从队尾往队头数,数诱饵(源码里真目标、诱饵各排一条队,对着同一条分数线各数各的,跟混排一条长队数出来一模一样)。排在某个位置上,往上(分数更高的那半边)数,一共多少个真目标、多少个诱饵;这个位置的错判率,就是诱饵数除以真目标数(L9585–L9594),分子分母都至少垫 1(防的是除零),最多记 1。
这个比值有个学名,就是那篇 "打假办" FDR 科普算的 FDR(错误发现率),分数线以上这一批里,骗子占多少。
不过 FDR 记的是一整批的账,还得按条落名才算到每条候选头上。
把分数线定在某个位置上时的 FDR,就是排在这个位置上的候选的 q 值。
所以 q 值不是另起的一本账,也不是 FDR 之外的新概念,它是同一笔账按条记的版本。FDR 记在门槛上,q 值记在每一条上。
道理还是那个朴素的道理:诱饵是假的。如果高分区里混进的诱饵多,说明这套标准下 "高分" 不值钱,这一段的鉴定整体可疑;诱饵越稀薄,前面这段越可信。所以 q 值 0.01 的意思就是:按这个分数线往上收,收进来的东西里,错判率估计不超过百分之一。 Target-Decoy 这套对照,从造出来到派上用场,等的就是这一下,前面几回它一直在名单里陪跑,到这里才真正开始算账。
逐位置算出来的错判率还不能直接当 q 值用:比例天然上下乱跳,一个位置比前一个位置 "更可信却算出更高的错判率",逻辑上说不通。所以算完还要顺一遍,保证沿队伍只降不升(L9601–L9616),捋直的这一串才是每条的 q 值,回写到各条头上。
最后按几道常用的门槛分别数数存档:q ≤ 0.5、0.1、0.01、0.001 各记一个数(Ids50、Ids10、Ids1、Ids01,L9635–L9640),循环机器待会儿就是拿这几个数当仪表盘的。
这里还藏着一个保险丝。神经网络是第 11 轮才上场的,可万一它登台之后 Ids10(10% 门槛下认下的条数)还不如登台之前线性分类器的战绩(这个战绩在第 10 轮就锁了档,L9666),或者 Ids1 掉得更狠、或者 Ids10 压根不足 100 条(L9648–L9650)?
引擎不恋战:把网络训练标记一撤,整轮按线性结果重算(L9648–L9654)。
招牌是招牌,账是账,转不动就退货,绝不为了面子硬上。
校准:RT 和质量,各对一次表
第三个部件是校准,落在 update()(L9694)。校准校的是两张表:一张是时间表(RT),一张是质量表(m/z)。
时间表校的是 "库里说它第几秒出峰" 和 "它实际第几秒出峰" 的对应关系。做法是先攒对子:凡是可信度够高(q ≤ 0.1)或分数够高的真目标(L9707–L9714),把它的库 iRT 和实测 RT 组成一对存起来(L9726–L9728),一条候选一个点。点攒够了,用分段三次 Hermite 样条把它们连成一条映射曲线(map_RT,L1184;spline,L1099–L1151)。
拟合分两遍:先按全部点连一条线,算出每点的偏差,把偏差最大的那 20% 扔掉,再连一遍(L1185–L1201),头一遍里混着的脏点,第二遍就不作数了。分几段也不固定:样本少就少分几段,最多 20 段(L9732)。
这条曲线就是引擎的 "换算表"。预测 RT 一律拿库 iRT 过一遍这张表(L7180),换算成本次进样时间轴上的刻度。第三回那个没有 GUI 旋钮的 RT 窗口,也是在这次校准里用残差算出来的(那笔账第三回已结,不重复)。顺手还有一件事在这里定死:扫描半径,拿可信鉴定的峰宽平均一下、乘个系数,一次定死、全程通用(L9763–L9772)。
质量表校的是 m/z 的系统偏差。做法同样朴素:拿高置信度鉴定里实测与理论的质量差,拟合一条校正曲线(L9842–L9872)。这曲线默认不带 RT 漂移,引擎留了按 RT 分箱、箱间插值的机关(L9823–L9831),可箱数上限默认只给一箱(MassCalBinsMax,L162);要它按 RT 分段漂移,得拧开 --mass-cal-bins 旋钮(L2143),点数还得够(每箱至少约 500 条)。
校正完,重新统计残差,取 70% 分位定为新的质量精度(MassAccuracy,L9889–L9890),意思是 "七成的鉴定,校正后偏差都在这个数以内"。
还有一条纪律:如果校完七成分位反而变大,这套校正直接弃用(L9910–L9924),校准不是走过场,校得更糟就当没校。
两个 RT 别混
这里拟合的样条,是 "库 iRT → 本次进样实测 RT" 的校准对表。它跟引擎里那条给候选报 "理论出峰位置" 的预测线(第一回点过名的
predict_irt,按氨基酸逐项加和的线性模型,不是深度学习)不是一回事,预测线报点,校准对表,各管一段。顺带说清一件事:"库 iRT" 这列数字的来历分两种,library-based 是谱库实验攒的,library-free 是模型算出来的(预测库直接报 iRT,FASTA 条目走predict_irt)。列的来历不同,对表这一套校准策略却完全一样。
循环:一台转十二圈的机器
三个部件都齐了,现在拆那台机器:process()(L10356)。
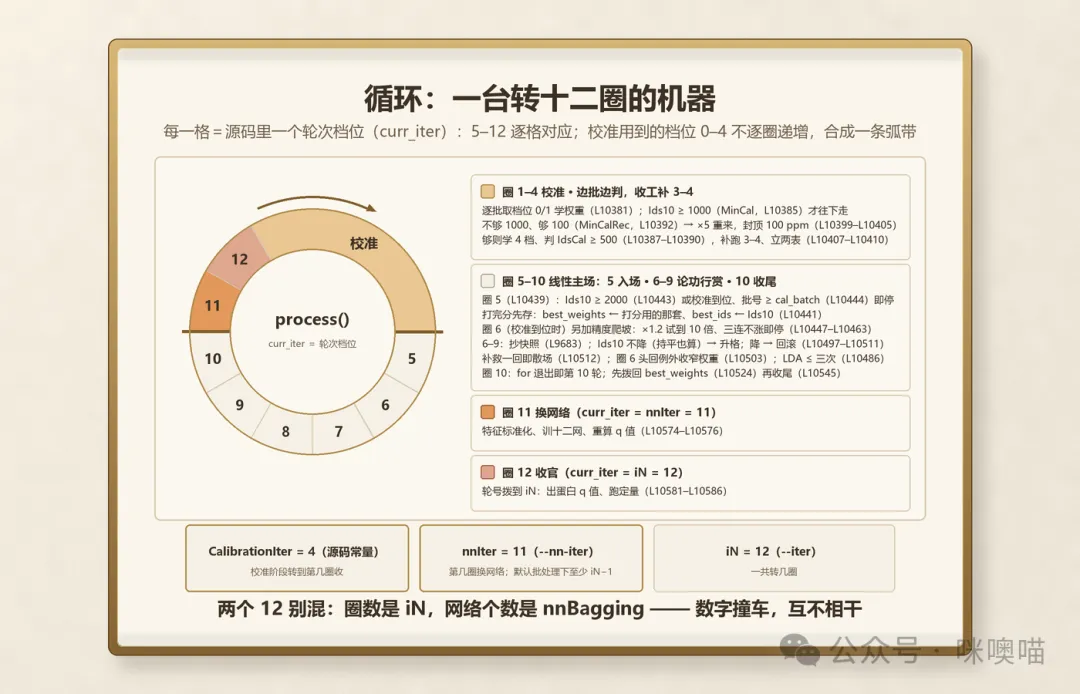
它不是均匀地转十二圈,而是把十二圈(iN = 12,L121)切成了几段,每段干的活不一样:圈 1–4 边批边判做校准,圈 5–10 线性主场论功行赏,圈 11 换网络,圈 12 收官结算。底下按段拆开看。
圈 1–4:校准冲刺,边批边判
开局是 "校准冲刺":批次一批一批地往下过,每批先学一遍权重、重数一遍 q 值(update_classifier(true, …),L10382);攒够 1000 条 10% 门槛内的鉴定(ids = Ids10,L10382;MinCal,L243),并且能喂给质量校准的那部分鉴定(q ≤ 0.1 且质量偏差不为零,L9636)也过半(IdsCal ≥ MinCal/2,L10390),才跳出批循环。
跳出后先补跑档位 3、4(L10407),再一次性把时间表和质量表立起来(L10410–L10418),校准这两张表,正是上一节那套活。
要是攒不够 1000 呢?攒到 100 条(MinCalRec,L242)就不再往下等,带着这批数据推倒重来;重来前还顺手把质量精度放大 5 倍给下一次留余量(MassAccuracy = Min(CalibrationMassAccuracy, MassAccuracy * 5.0),L10399,封顶 100 ppm;MS1 同此,L10400;整块在 L10394–L10405)。表立住了,才轮到真正的主菜。
圈 5–10:线性主场,论功行赏
第 5 到第 10 轮是线性分类器的主场,但三段干法不一样。第 5 轮是入场(轮次档位拨到 CalibrationIter + 1,L10439):还是一批一批地过,每批打完分,先把这轮打分用的权重和战绩存成 best_weights、best_ids(L10441),存的是打分用的那套,不是刚学出来的那套。
再看要不要停,10% 门槛内的鉴定数过 2000(MinClassifier,L244;L10443),或者这一批已经走过校准用的那几批(acc_calibrated && curr_batch >= cal_batch,L10444),就停。
等到第 6 轮正式开局前,这两样还会按同样的规矩再重设一遍(L10483),论功行赏真正从那儿起算。
第 6 到第 9 轮才是论功行赏的循环体(for (; curr_iter < nnIter - 1; curr_iter++),L10484;nnIter 默认 11,所以循环体最多走到第 9 轮)。
每一轮学新权重之前,update_classifier() 会先把这轮打分用的权重抄一份快照(起手埋的那份 selection_weights,L9683);打完拿 10% 门槛下的战绩(Ids10,L9638)跟 best_ids 比:没退步(持平也算),快照升格成 best_weights(L10497–L10498);退步了,把权重拨回 best_weights 重学补救,回滚退的就是它(L10500–L10511)。
第 6 轮还多一摊活,但只在质量校准到位、又没被 ForceMassAcc 强制指定时才做(if (acc_calibrated && !ForceMassAcc),L10447):正式开局前先爬一遍质量精度,从当前精度起每次乘 1.2 往上试,一旦超过起点的 10 倍就停,连着三次不见涨也停,最后回到试得最好的那一档(L10448–L10463)。
清零重学一遍要是还不如,就把 par_limit 打开、收窄分类器可用的权重(L10469–L10472),顺手把这一档记成全局质量精度(L10475)。
不过这场论功行赏不恋战:失手要记档,补救一回之后不论结果,就把档位直接拨到 nnIter - 1、跳过剩下的轮次(L10512–L10515);唯一的例外在第 6 轮,头一回失手不记档,改为收窄分类器可用的权重(L10503–L10505)。
更有意思的是它还有后手,线性分类器本身有两种构造(LDA 开关,L6529),这一路不灵就翻到另一路重学,最多翻三次(switched <= 2,L10486–L10495)。
循环退出时档位停在 nnIter - 1,也就是第 10 轮;这里先把权重拨回最好的那套(copy_weights(weights, best_weights),L10524),这一步是无条件执行的,上面那个 if (Batches > 1)(L10518)里只包着 assert(nnIter >= iN - 1) 和 free_precursors()(L10519–L10521)。
拨回之后再跑一次 update_classifier() 收尾(L10545),顺手把线性战绩记下来(L9666),留着跟网络版比高低。
圈 11–12:换网络,收官结算
第 11 轮,档位拨到 nnIter(L10560,默认 11):先做特征标准化(if (Standardise),L10574,默认开着),再让 "学权重" 那一排十二个网络登台训练、重打分数(fit_weights、calculate_qvalues,L10575–L10576)。这个十二是网络个数,跟圈数无关,下一条注细说。
默认 11 < 12,所以这一轮训练会跑;真把 --nn-iter 调到 12,L10563 的 curr_iter >= iN 就成立,直接跳过训练去出报告(L10564–L10571)。
最后一圈把档位拨到 iN = 12(L10581):出蛋白 q 值(L10583)、跑定量(L10585–L10586);报告文件不在这一节里写,由主程序最后写出(L11160–L11162)。
转几圈,谁说了算
整个循环的节奏,全看三个数:CalibrationIter = 4(校准阶段转到第几轮收)、nnIter = 11(第几轮换神经网络)、iN = 12(一共转几圈)。
这三个数在源码里有出厂默认(L121–L122、L214)。其中总圈数和换网轮次有命令行旋钮(--iter、--nn-iter,L2071、L2101),可两个旋钮都带着跟校准圈数挂钩的下限(CalibrationIter + 4 与 CalibrationIter + 3),校准圈数本身则是源码常量(const,L214),没有旋钮。
三只还互相夹着,nnIter 被夹在校准阶段和总圈数之间(L2224),默认的批处理模式下还会被再抬到至少 "总圈数减一"(L2229),换网这旋钮真正能挪的,只剩最后两个轮次。
两个 12 别混
"转十二圈" 的 12 和 "十二个网络" 的 12,是两个互不相干的旋钮,数字撞车而已:圈数是
iN(L121,命令行--iter,L2071),网络个数是nnBagging(L191,--nn-bagging,L2103)。圈数改成 20,网络还是 12 个;网络改成 8 个,圈还是 12 圈。跟圈数挂钩的是nnIter(第几轮换网络),它被夹在校准阶段和总圈数之间(L2224),跟网络个数没有关系。
界面上,"Use neural networks" 勾选框管神经网络的总开关(默认勾选,不勾就下发 --no-nn),"RT profiling" 管二轮 iRT 精修;至于转几圈,界面没给入口,只能从 "Additional options" 手工传参。
写在后面
到这里,第三回收尾欠的三笔账全部结清:权重是拿真目标和诱饵对打学出来的,q 值是让诱饵自己报错判率报出来的,校准是拿高置信鉴定把时间和质量两张表对出来的。而这三个部件不是各干一票就散,它们被 process() 串成一台循环机器,转十二圈,每圈换一次定价、重排一次队伍、再校一次表。
回头看这条链,最讨人喜欢的一点是它不逞强:学不动、训不好、校得更糟,机器都宁可退回去不硬来,"不如不动" 这四个字,它是当真的。
所以这一回的标题说 "越揉越靠谱",揉的其实不是同一个动作转十二遍,而是每圈都在换着法子把标准往准里掰。对做原始数据分析来说,这道理不陌生:一次比对说明不了什么,反复校过表、对过陪练的标准,才敢拿去下结论。
干扰怎么精修、定量结果怎么产出,是这台机器吐出结果之前的最后一道工序,留待后续文章接着聊。
如果这篇对各位观众老爷有用,请伸出您尊贵的小手点个赞,小编也有更多的动力接着往下写 ~