ARTICLE · 1311533
从初高中数学到AI小摊:世界模型No.1接下来写什么
从初高中数学到AI小摊:世界模型No.1接下来写什么
这是一次本地文本分类实验。最扎眼的还不是复核名单太长,而是把门槛调低之前,这个用样本训练过的小模型,准确率还输给了一套关键词规则。 同样是给一条商品评论打标签,下面两种错,你更愿意接受哪一种? 把一条好评送给同事,多看一眼。 把一条差评留在普通队列里,没人优先看。 如果你只算准确率,两种错都扣一分。到了售后团队手里,它们占用的时间、造成的影响,可能完全不同。 所以我想把这篇「世界模型No.1」总导读,做成一次从榜单走到验收的实测。前半程,拆开公开榜单,看排名从哪儿来;再用一份真实的中文评论测评数据,训练一个自己能算懂的小模型。后半程,看一个已经公开运营的AI服务能核实到哪一步,以及它离一份能交付的验收单还有多远。 即使你已经忘了方程怎么解,也能从“答对几条”“漏掉几条”读起。三个合集会在这一路上各自出现:AI原理课,负责把分数算懂;大模型实验室,负责把系统跑起来、把错误找出来;AI小摊,负责核对真实需求和交付。 我先打开Arena 的 Text Overall 榜。本次可读取的页面快照标注为 2026年10月27日。那一页上,Gemini 4 Carbon (High) 的显示分为 1528±9,标注 Preliminary;Gemini 4 Argon (High) 为 1520±6。这里的名称包含具体配置,不能只截成“Gemini 4”三个字。榜单会继续更新,读者点开时看到的顺序可能已经不同。 1528 是什么?至少有两个常见读法需要先排除:它既不是“做对了1528道题”,也不是“比1520多答对8道题”。 按Arena 官方说明,平台把用户对模型回答的成对偏好汇总,用 Bradley–Terry 模型估计相对表现。你能把它理解成:参与者一次比较两个答案,很多对局连起来,才推断出整体的相对排序。榜上另列不确定范围和可能的名次范围。它提供的是比较证据;看见两个点估计有先后,不能把这点差距当成你自己任务上的胜负。 这张榜有用。我要给团队挑一批模型做通用对话试用,可以先从它缩小名单。但如果我的问题是“能不能区分催物流和商品破损”“引用的数字来自哪张表”“没权限时能不能停下来”,就得再换一张题纸。 同一天,排除平局视图上的次序有个变化:Claude Opus 5.5 (High) 在总榜显示第3,Muse Wonder (Max) 第4;切换后,Muse 显示第3,Claude 第4。新视图里,两者显示分四舍五入后都为1530,名次范围仍重叠。能下的结论是这两个视图的显示次序对调了。没有证据说明两者的能力出现显著反转。 看榜时,我会先抄下四件事:哪一天、哪个赛道、什么版本、什么算赢。第四项尤其容易被漏掉。有人选更清楚的回答,有人选更简洁的回答;两份答案都可能被偏爱,却仍有数字出错。一个设定好的规则测试则可以直接问“这个数对不对”,但也未必测得出回答是否容易理解。 我想看看分母到底能把数字拉开多少。于是取了Arena 在 Hugging Face 公开的一页历史投票,按这一页的完整100条记录复算。这是2025年的研究样本;我们只读取对局编号、模型、轮次和票型,不去估计今天的榜单分。 100条里,左侧 A 胜39条,右侧 B 胜32条,普通平局16条,双方都差13条。A、B只是位置,不能说“A模型赢了”。你若只保留有胜负的票,分母立刻从100变成71,连在描述什么都变了。 再把同一页里名为 Claude Opus 4 的具体版本挑出来(记录名为 claude-opus-4-20250514)。在这10条里,它赢3条、输3条、平3条,还有1条双方都差。 问:这一页里,它参加的对局有多少被判为赢? 3 ÷ 10,是30%。 问:只看有明确胜负的对局呢? 3 ÷ 6,是50%。 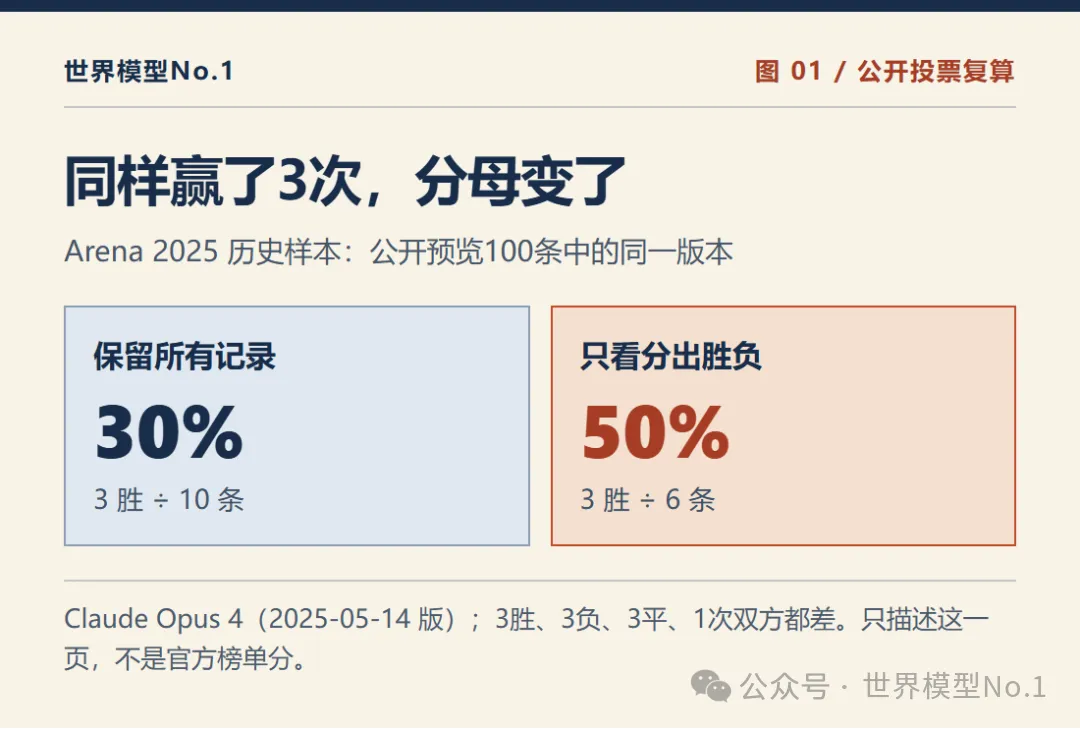
这两个数可以同时正确。前者保留了平局和双方都差,后者问的是“分得出输赢时,它赢了几次”。拿其中任何一个数字说“这个模型只有多少正确率”,都偷换了问题。100条也只是历史公开数据的一页,既不代表整个数据集,也不能替官方重算排名。 读到这儿,下次看到“模型提升20%”,可以先停一下:总共测了什么?什么被算进分母?双方都没做好时,又怎么算?比记住今天谁第一更耐用的,是能把评分规则问出来。 把这张题纸带回中文评论,就能看见区别:原始评论已经有正负标签,我们可以逐条对答案;至于某条评论应不应该优先派给人、应不应该退款,那得由业务另立规则。同一段文字,换一项任务,及格线也跟着换。 这次的小模型用的是FewCLUE 的 EPRSTMT。它给电商评论标正向或负向。我们用项目的公开数据做研究演示,保留原始标签;不把它想象成某一家店今天的投诉记录,也不用这套标签替商家判断责任。 把一段中文交给这个程序,它先把文字拆成可以计数的片段。例如“包装不错”,除了单字,按两个相邻字滑过去,还会得到“包装”“装不”“不错”。这和我们读评论的方式不同。人知道“不错”在夸,也知道包装好不一定代表商品好;程序只会先问:这些片段在过去的好评、差评里各出现过几次? 从初中数学看,这里发生的变化很简单:把一句话换成几项能计数的东西,再比较两边。 “电脑认得这个词”听上去很玄,落到程序里,是它给某一类存了一份计数表。 拿“差”这个字算一次。训练用的32条评论里,负向部分一共贡献了531个单字或二字片段,“差”出现5次;正向部分贡献了1,329个片段,“差”一次都没出现。这里数的是出现次数,同一个片段可以重复。 训练词表一共有1,100种片段。给每种片段都先补1次以后,负向一侧的分母变成1,631,正向一侧的分母变成2,429。于是,“差”占负向片段的 6 ÷ 1,631,约0.368%;占正向片段的 1 ÷ 2,429,约0.041%。以这次训练的频数来估计,它在负向这边相对更常见,比例约是正向那边的8.94倍。 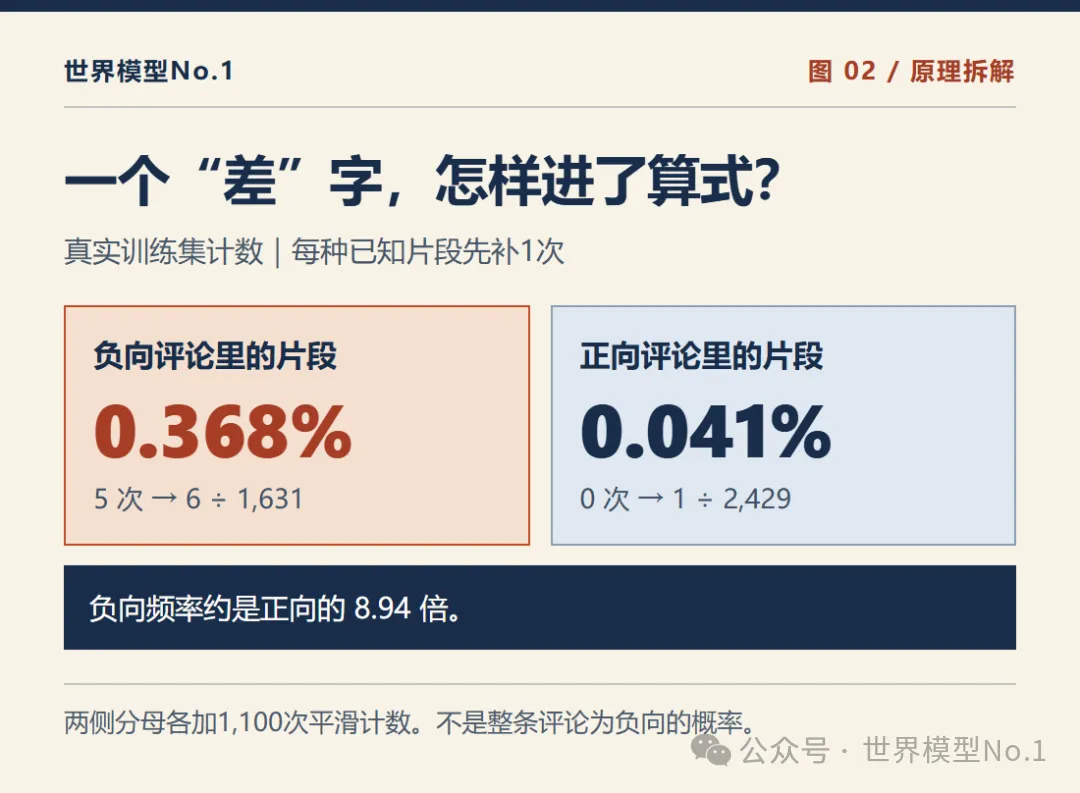
为什么分母不能直接写成“好评多少条”?因为现在问的是“在这一类里随手抽一个片段,它是某个片段的机会有多大”。抽的是片段,不是整条评论。类别里一条长评会贡献更多片段,这也是这套表示法会偏向某些写法的原因。 这个办法还有个小麻烦:训练集只有少量句子,一个词在某一类碰巧没出现,直接相乘时会出现零。做法是给词表里的每个片段先垫一点计数,再一起归一化。它叫平滑。想想比赛刚开场时的投篮记录:只投过一球,进了,纸面命中率是100%,你不会据此断言下一球也必进。垫一点计数,是提醒程序别把“还没见过”当成“绝不可能”。 判断一句新评论时,程序把它拆出的一串已知片段分别拿去查表,算它更支持哪一边。为了便于计算,程序用对数把连乘改成连加。没学过对数也可以先看结论:有的片段把分数往好评推,有的往差评推;最后比较两边的总分。 前面算出的8.94倍,只是一个字对这次计算的影响;它不等于整条评论有8.94倍概率是差评。其他片段、训练样本中两类本来的比例,还会一起进账。 有趣的是,同一批训练评论里,“不”反而轻轻把分数往正向推:平滑后,在负向片段中占12 ÷ 1,631,在正向片段中占27 ÷ 2,429,后者略高。“不”可以出现在“不满意”里,也可以出现在“不错”里。程序只拿到了这32条评论,不能替它把这个字的语义解释得比它学到的更多。 这也解释了它容易错在哪里。近邻片段往往不独立,“不”和“不好”可能在表达同一件事;模型却还是分别给它们加分。它也不具备专门识别“但是”之后才是真正重点的机制。朴素贝叶斯的“朴素”,就体现在这种简化假设。我们会在原理课把假设、公式和结论分开写:在什么条件下可以这么乘,条件不成立时,为什么它有时仍然能用,什么时候又会出问题。 这一课不需要从矩阵开场。先从计数、分数、比值和变量开始;等问题推到“怎样表达顺序和上下文”,再去学向量怎样表示文字、模型怎样组合信息。知道小模型忘掉了什么,再学复杂模型,才知道新结构在补哪块缺口。 训练跑通之后,很容易做一件省事的事:挑几条它答对的,把输出贴在文章里,说模型懂了。 这次把样本分开:训练集只负责学习,验证集负责挑策略,最后才在没拿来挑策略的公开测试集上计分。题目已经公开,不等于我们可以边看答案边调门槛。真要改方法,下一轮应当另外留一批没有用于选择的样本。 本次在 Python 里直接训练。训练集32条,验证集32条,测试用项目公开的610条,正负标签各305条。按统一文本规则检查,三个集合之间没有完全重复的评论;这并不能排除近义改写、同商品或相近模板。 同一批610条,先跑三个不看答案的做法: 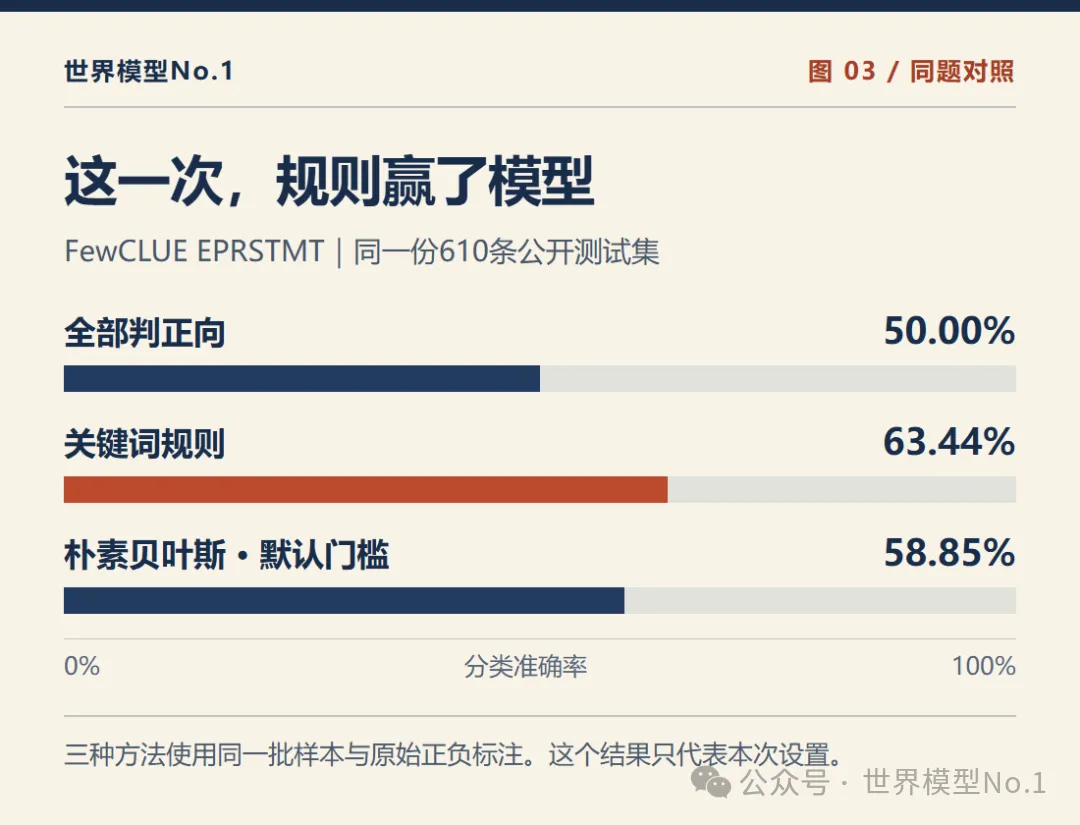
模型输给了规则,而且多错了28条。看得再细一点,默认模型比关键词规则多错送了27条正向评论,也少找出1条负向评论。这个对照只对这一份数据划分、这一版关键词表和这一个小模型成立;它足以说明本次没有理由靠“用上了模型”就把旧方法换掉。 不过,两种方法各漏掉了超过200条负向评论。假设任务要求的是“尽量让负向评论被人看到”,那就不能只问谁的准确率高。下一步试的,是把模型从二选一的判卷器改成一份人工复核名单的生成器。 把“送人工复核”加入流程,分数的含义就变了。过线的送复核,其余留在普通队列。进了人工名单,不等于判成负向;留在普通队列,也不等于真的安全。这一轮单独看捕获了多少负向、还有多少漏掉、名单需要人看多少条。 先不看610条测试数据。在32条验证里,有19条标成负向。目标是找出至少90%,所以至少要捞到18条。程序把验证集的负向记录从高分排到低分,取第18条的分数 −13.5738(此处四舍五入)作为新门槛,达到或超过就送审。验证时,28条进入名单,其中18条为负向。门槛固定后,再跑测试集。 结果来了:305条负向进了277条,召回率90.82%;仍漏掉28条。 总共转人工526条,其中249条原标注为正向。没进名单的只剩84条,里面仍有28条负向。这就是开头那笔账。 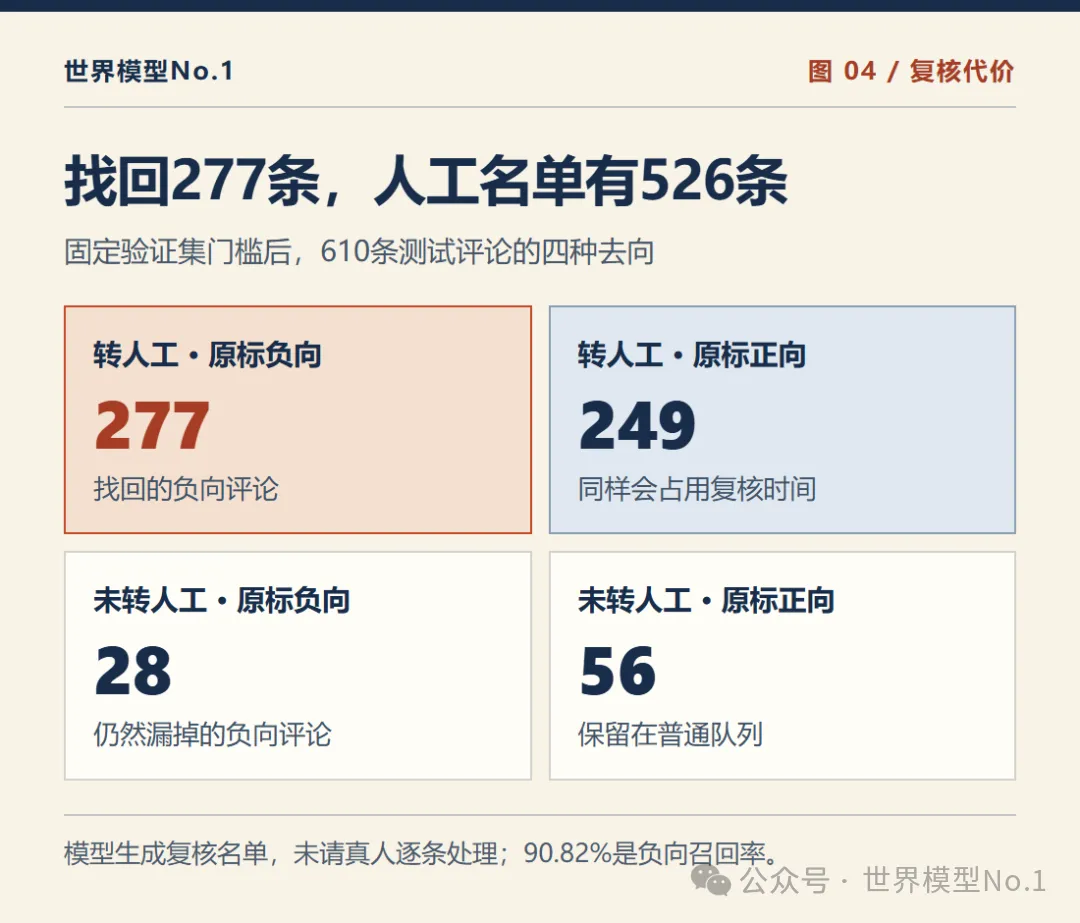
和同一个模型的默认门槛相比,这个策略多送审398条,多找回186条负向。平均每额外找回一条负向,要多看约2.14条。再和全量复核相比,这份名单仍覆盖了86.23%的评论;省下的84条里还有28条负向。这里数的是评论条数,没测复核耗时,也没验证人能否审对。 如果同一批610条最多只允许复核100条,这份清单不能原样用;如果漏掉一条代价很高,团队也可能愿意多看一些。代价是什么、容量是多少,要在验收题里写出来。 我用保存的逐条分数又做了一次事后对照:两种做法各取分数最高的100条,同分时按样本编号的固定散列顺序挑,选名单时不看标签。关键词这次找出90条负向,小模型找出74条。在同样的复核容量下,关键词在这批数据上仍占优。这个100条预算是为了演示怎样比较而追加的,仍是同一批测试评论;要决定真实业务该用哪套,得先定预算,再去一批新样本上试。 结果表还留下了两个没那么好看的例子。测试编号174,意思是耳机夹头、声音不清,用户觉得不值这个价;原标注是负向,但模型分差约−15.51,连降低后的复核门槛都没过。我们拆开几项计数,看到“不是”把它往负向推,“的”和“不”的多次出现则在这次模型里往反方向推。这只是分数的一部分,但足以看见一个问题:模型可能被表达习惯牵着走,没有抓住主要抱怨。 编号59则相反:大意是东西还可以,打算再用一阵。它是原标注正向,模型分差约−6.96,默认不会被标出,降门槛后却进了名单。策略换了,模型没有变;新增的工作量就来自这批被门槛拦进来的人和事。 32条验证数据很少,换一批就可能选出不同门槛。分差是这个模型里的相对分数,也不能读成现实中的正确概率。团队拿到这份报告,最实用的下一步是用自己的样本再跑一轮,另外记一项:在同样的人力下,能否比旧做法更早看见真正需要处理的问题? 如果下一次改用大模型,很多部件会换:文本的表示方式、训练目标、生成方式都不一样。但有几件事不该丢:训练样本和验收样本分开,版本和运行条件能查,错误有原始记录;工具执行到哪一步,要去看工具的输出或最终状态。 在实验室,我会把模型内部和外围系统分别做给你看。内部的题是“输入怎样变成数字、参数怎样得到更新、推理时输出怎样出现”;外部的题是“谁把文本送进去、谁取资料、谁记录结果、什么时候交给人”。这次跑的是前者的一个简单可解释例子,以及后者的一段分流逻辑。它既没有训练大语言模型,也没有比较任何 Arena 领跑模型。 再想一步:假设模型把“快递晚了一天,但商品很好”分成正向,可能并没有背离情感标签。但客服主管想找的是晚到订单,这条仍然该进入物流队列。模型答对了旧题,流程却答错了新题。 处理这种错,先重新定义要预测的标签,通常比再加一层“你是一名资深客服”的提示词更直接。 一个能分好评、差评的脚本,能让一项工作变轻多少?没有业务记录,就还答不上来。 先找实际有人使用的入口。把它的公开功能、我们亲手核对到的输出、客户自己公布的成果分别放好。三份材料常常不在一个地方:一个官方入口能证明服务确实存在,一次可复跑的查询能证明某个动作可核验,公开客户故事则告诉我们当事方如何描述用途。少一份,就别拿另一份补上。 这次核查的是马来西亚统计局 DOSM 的公共农业统计服务 TaniStats。马来西亚政府服务目录有这个服务的条目;官方会议演示第10页列出了 AgroBot 和语言模型相关的处理流程;Chatbase 的具名客户案例则是供应商对合作的叙述。三份材料能用来确认服务、功能和公开说法,不能替代独立成效记录。 本次没有跑通 AgroBot 的交互。 能亲自核对的是同一统计局发布的分州作物种植面积与产量表。我用公开预览里的小份快照写了一个离线查数程序,检验一个问答系统就算把话说得很顺,最后也不能含糊的东西:它引用的到底是哪一行、哪个字段、什么单位? 第一条实际运行的输入是:马来西亚全国短周期经济作物,2024年,产量? 这句话遵循脚本的固定模板;本次没有测任意问法的理解能力。 程序取的是全国、2024年、cash_crops 这一行。同一行里,产量是 187,323公吨,种植面积是 16,185.9公顷。原表日期字段写作2024-01-01,这里只用来标记统计年度。两个数都来自官方表,选错一个字段,带着同一张表的引用也照样错。 再问一句:和2023年相比,是涨了还是跌了? 这道题如果没有说“什么涨跌”,直接回答就有风险。程序按固定口径分别比较2023年与2024年的产量和种植面积:产量从188,811.7公吨降到187,323公吨,下降约0.79%;种植面积从15,158.3公顷升到16,185.9公顷,上升约6.78%。两个方向相反。仅凭这两列数据,还不能回答变化由什么造成。 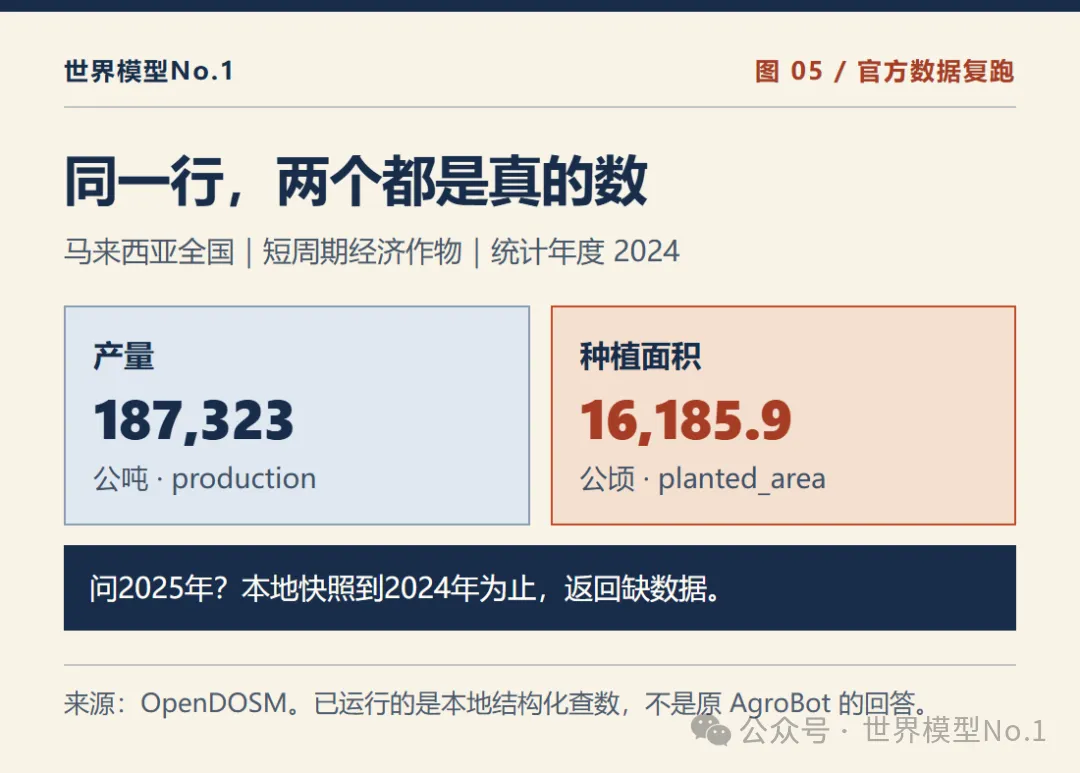
最后,故意追问快照之外的2025年产量。程序返回“超出快照范围”,没有产量数字;问“去年种了多少”,又缺统计年份和具体指标,程序也不给数。这里验证的是固定快照上的末端查数和拒答规则,不是 AgroBot 的问答能力。9条预先选定的核对项通过,说明这套小程序在这些检查上表现符合预期,不能换算成服务的总体准确率。 这段复跑给了一个很现实的产品判断:客户把统计表交给你,交付范围也许不是“让大家能聊天”,而是“少走几步,拿到能回表复核的数”。重要的功能未必很炫:保留行键,显式说明单位,缺参数时停下来。当资料范围扩大时,要留一批原来没有覆盖过的问题,再看这套规则有没有用。 如果把这种能力移到有付费客户的场景,我会先挑一件可以验收的小任务。例如“从一张给定表回答问题,每次留下行键、单位和时间;碰到表里没有的内容就说缺数据”。比起“做一个什么都能答的客服”,它更容易报价,也容易发现是在修数据、修检索,还是修回答。这个收费场景是设计思路,不是 DOSM 的采购或收益记录。 怎么验收?先留几条已知答案的正常问题,再留几个故意会让系统犯错的请求:同名指标不同年份、单位一个是吨一个是千克、用户要求读出没有的字段。还要定清楚碰到未授权动作谁负责、什么时候转人工。如果交付是“减少重复查表”,可以记录每个问题从提出到拿到可用答案的时间;如果是“减少错漏”,就记错漏怎么定义、由谁复核。先用现行人工做一遍,才有对照。 我会把生意账拆到能被质疑的程度。净省下的工作时间,是旧流程的时间减去新流程里人工复查、处理失败和维护的时间。模型调用费只是新流程的一部分;整理资料、改字段、培训、返工,都会占钱。能不能挣钱,最后还要看有人是否愿意为这一段结果付费、交付成本能不能被覆盖。一次漂亮演示、一份采购记录和持续盈利,是三种不同的证据。 这就是AI小摊要写的东西:项目怎么被发现,问题怎么被切小,能力怎么被复跑,结果拿什么验收。 找得到原始项目,就给地址;跑不动完整服务,就把实际跑过的一段标出来;没有公开经营数据,就不写收入。做砸的样本也留着,下一个人不必从头掉进同一个坑。 写到这里,三个合集可以用同一条线串起来:要学的是怎么算,做的是怎么跑,最后问的是谁用、怎么验收。你可以从任何一条进来。 AI原理课|先亲手算出一步 大模型实验室|留一份别人能复跑的记录 AI小摊|拿真实工作做一小段交付 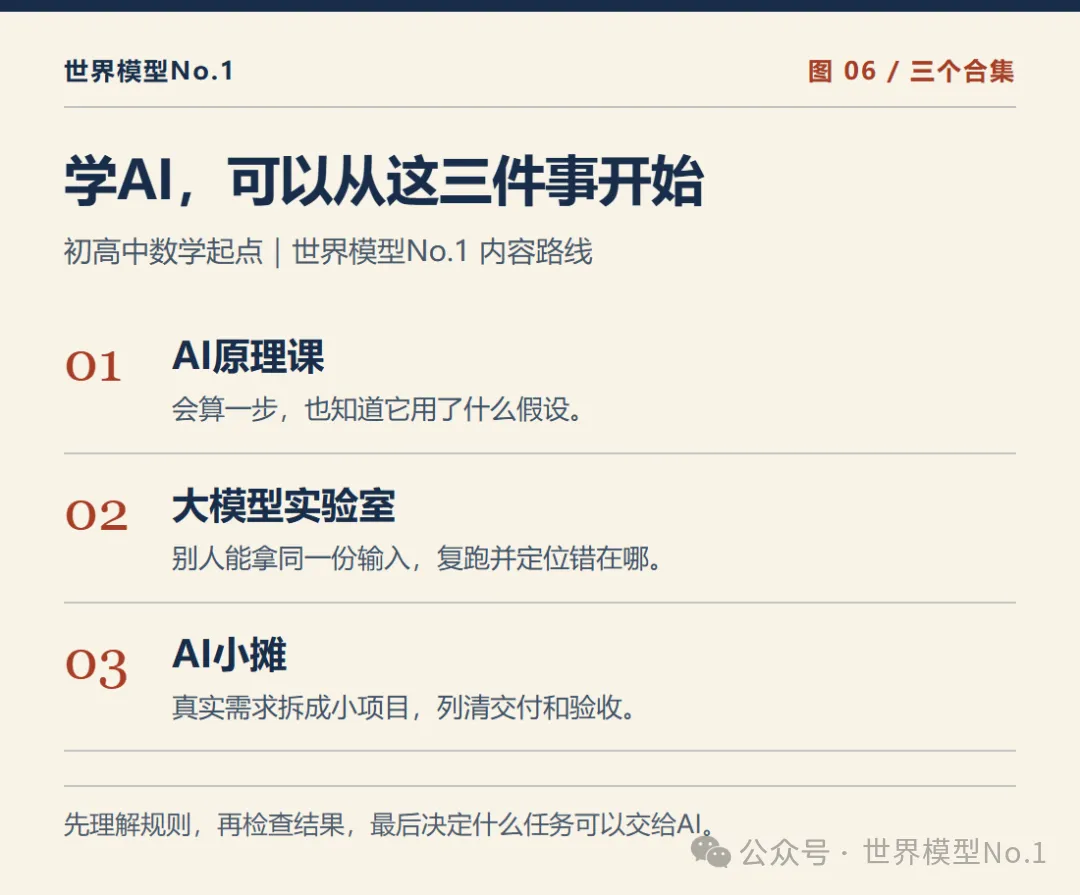
现在不用装环境,也不用挑模型。只写一件你下周可能真的要做的工作,比如“把这张表里指定年份的数和来源找出来”,或者“把留言按需要回复、只需记录和无法判断分开”。范围越小,越容易发现榜单替你回答了什么、还没回答什么。 任务:我需要交出的结果是什么? 样本:我用哪几份普通输入、哪几份容易出错的输入? 通过:哪些字段或动作必须正确,哪种错误一次都不能有? 兜底:遇到没见过的情况,停下来、问人,还是回去查资料? 套到上面那张统计表,四行可以这样填:任务是查全国短周期经济作物数据;样本是2024年同一行里的产量和面积,再加一个2025年请求;通过是两个字段不串、单位不混、结果能回到原表;兜底是在快照外不给数、缺口径就停。若上线版还要自动追问用户,那是下一轮需要单独测试的功能。 先拿你现在的做法跑一遍;再把两个候选模型放到同一份题上,不给它们看答案。到这时,一个排名才真正参与了你的选择:它帮你决定从谁开始试,手里的样本帮你决定把什么工作交出去。 如果你在留言里留一道题,欢迎把“什么算做错了”也写上。之后的文章,就从这样一条能核对的题往下做。
01 榜单写着第一,先问它赢的是什么
02 AI原理课:电脑拿到一句中文,究竟拿什么算?
03 大模型实验室:成绩单上最好看的一栏,未必是最该看的
·全部判正向:沿用训练集里较多的类别,答对305条,准确率50.00%。它一条负向也不会优先标出来。
·关键词规则:数正向词和负向词的命中,净负向时标出。答对387条,准确率63.44%;负向标签中找出92条。
·朴素贝叶斯默认判法:用训练频数给句子打分,负向分差超过零就标出。答对359条,准确率58.85%;负向标签中找出91条。
04 AI小摊:有真实产品,还得有一张能签字的验收单
05 接下来三个合集,分别要交什么作业?
首批从初高中能接住的计数、函数、比值和误差开始。比如给一个短句,先只看一个片段在两类中出现的比例;再加上第二个片段,观察结果为什么可能改方向。往后才接向量、梯度和注意力。每次补数学,都从当时卡住的问题引出。
验收:给你另一组数字,能独立算出哪一边的分更高,并说清用了什么假设。涉及证明,条件和不能推广的范围一起写。
先做文本分类、读取材料和结构化输出,再把小模型的具体观察接到大模型内部和应用链路。每次附输入、参数、输出与至少一种失效方式,比较不同策略时说清哪些条件保持一样。
验收:换一组输入,能看到对应输出;结果不符预期时,能把问题定位到样本、模型、工具或验收规则中的一环。
从已经有公开入口或具名来源的项目开始,拆它为谁省了哪一步。挑出能复刻的关键能力,留下范围、工具、工时和失败;如果试用条件只允许核查公开层,就不把文章写成完整复刻。
验收:知道客户可以拿什么判断任务完成、哪些要求还没验证,以及下一轮试用最该补什么数据。
06 下次打开榜单时,先给自己留一道题
实测说明。 本文的榜单是注明日期的公开页面快照;投票复算、评论分类及公开服务核查采用各自的记录口径。本文列出的实验不是当前通用大模型排名,也不是生产服务指标。配图中的数值取自本次记录;概念封面不作为证据。