ARTICLE · 1311740
AI 自动科研(下)|文档建成技能库并执行演化
机器发现 · 日报 2026-11-04
⑤ AI 自动科研本身(下)
ScienceCUA:把软件文档建成技能库,用执行反馈演化
ScienceCUA: Resource-to-Skill Construction and Execution-Guided Skill Evolution for Scientific Computer Use Agents|arXiv|预印本,未经同行评审|2026-11-02|DeepAutonomy Technology Co., Ltd. 等
要点:作者构建 ScienceCUA 两阶段框架:先从软件文档生成可复用的技能与参考条目,再用执行反馈更新技能库,并在共 276 个任务的 ScienceBoard-VE 上评测。
研究动机:科学软件的操作往往需要应用专属的工作流、命令、语法和参数约束,agent 须靠软件专属知识挑选操作并组织成流程。现有基准多覆盖通用网页、办公和桌面任务,科学软件得到的关注较少。ScienceBoard 的六个应用都提供手册或教程,但手册把操作说明与概念解释混在一起,单个任务通常只用一小部分。作者把原始资源直接放进模型上下文,任务成功率提升有限而执行时间明显增加,因此要从这些面向人的资源中取出任务相关信息,整理成模型能用的结构化知识。
实验设计:作者审计 ScienceBoard 的 169 个任务,留下 168 个修订后的测试任务,另加 108 个不重叠任务专做技能演化。文档建成 Skills、References 两类条目;演化时对照同一任务失败与成功的轨迹,修订或新增条目,在真实环境中反复验证后才写入技能库。评测含 4 个模型 API 设置和 2 个原生 agent,指标取 6 个应用成功率的未加权平均。
结果:作者在模型 API 设置下评测,初始 Skills 与 References 相对基线的平均任务成功率最多提升 7.23 个百分点,四个模型上的平均成功率都高于直接注入文档、RAG、VisualSkill 和 SkillFoundry。经执行引导的技能自演化并冻结技能库后,相对基线的总增益最多提高到 17.12 个百分点。对 Grok-4.6,平均成功率从初始库的 44.70% 升到 54.59%;演化只用与测试集不重叠的任务。
结论:作者认为,人写的软件资源可以转成可执行、可验证的操作知识,并随环境反馈持续改进,提升通用 agent 使用科学软件的能力。
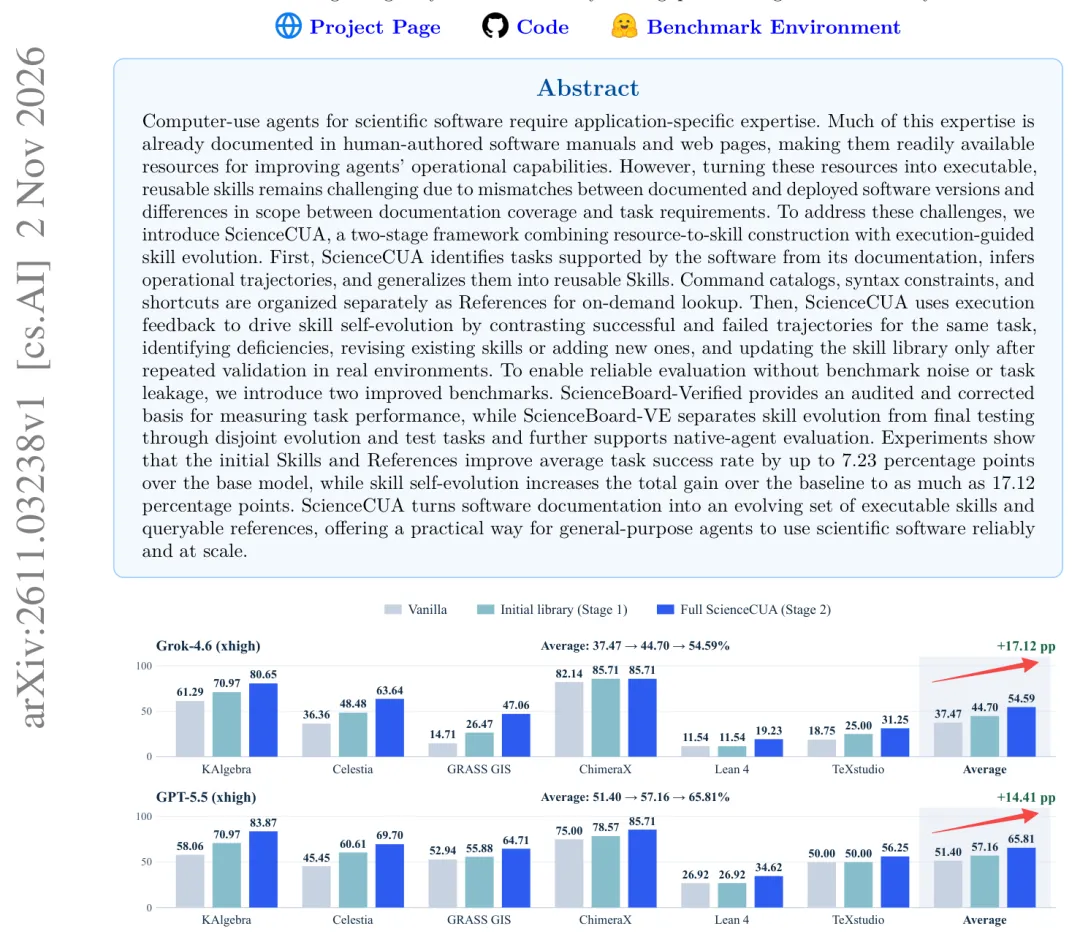
图 1|ScienceBoard-Verified 上 Vanilla、初始技能库与完整 ScienceCUA 的成功率。图源:原文 Fig. 1
意义与启示:作者指出,把 Skills 与 References 放在模型参数之外,agent 不必重新训练就能适应科学软件环境和任务需求的变化。
arXiv: 2611.03238
https://arxiv.org/abs/2611.03238
选择 LLM 生成假设:在 NAS-Bench-201 与 HPOBench 上测量超出 LLM 面板预期的真实数
Selecting LLM-Generated Hypotheses Raises Truth Beyond What an LLM Panel Expects: A Pre-registered Study on NAS-Bench-201 and HPOBench|arXiv|预印本,未经同行评审|2026-10-31|独立研究者(美国);Santa Clara University
要点: 作者在 NAS-Bench-201 和 HPOBench 上构造可逐条对表核实的条件交互命题,用其他 LLM 的盲先验校准出超出预期的真实数;一次选择步骤让 Sonnet 在 NAS-Bench-201 上的 R 提高 1.77/次。
研究动机: 自动研究系统已能提出想法、跑实验和写论文,一条改进路径是优化模型周围的提示、agent 工作流和整套 harness;有可执行分数时,这类优化有效。研究构思没有可执行分数:想法是否为真要等测试后才知道,是否令人意外取决于领域已有信念。构思系统于是用 LLM judge 的新颖性和质量评分来选,或用与后续论文的相似度来选。论文的引言写道,这两种依据都值得怀疑:judge 评的新颖性与想法事后表现负相关,judge 奖励风格而非实质,优化代理奖励会被利用。实验设计: 作者用测试台(图 2)把假设限定为两个全表格化基准上的条件交互命题,逐条对表核实。盲先验面板由其他模型给每个可能命题打分,按生成器校准,算超出面板预期的真实数。测量臂先设计 100 个探针、读结果,再提假设。预注册比较用 24 次运行和置换检验判定;选择步骤先起草 30 个候选,再另起调用保留 10 个。结果: 在 Sonnet 与 NAS-Bench-201 的运行中,选择步骤让 R 比新的直接运行高 1.95,比保留最可能为真的消融高 1.96,三项预注册检验均显著;精度从 .79 升到 .83。三项检验共享同一组 harness 运行,只换比较臂。选择步骤还高于同池的随机选择和类型过滤。GPT 读到有信息的探针结果后,比读打乱值或扣留值时表现更好;为 judge 优化的 harness 提高了 judge 评分,却把精度压低。结论: 作者认为,选择步骤让生成器在面板预期之外找到更多为真的命题,但这一增益依赖少数反复出现的命题,且在生成器自身盲先验下不显著。
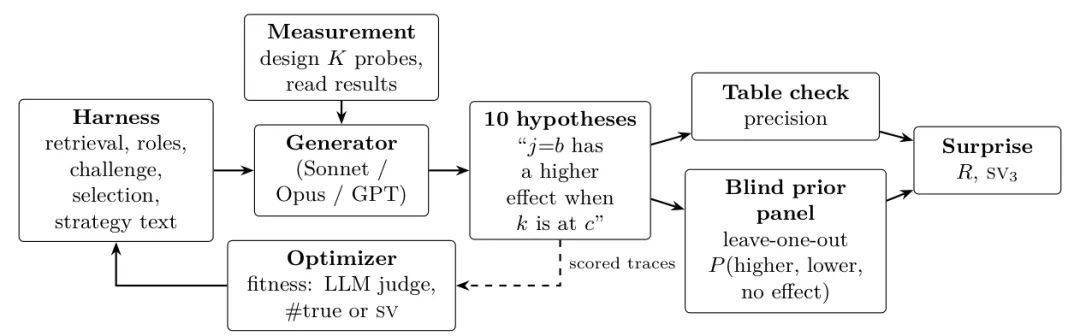
图 2|测试台:每个假设对全表格化基准逐条核实,意外性由其他模型组成的盲面板评分。图源:原文 Fig. 1
意义与启示: 论文讨论称,选择步骤把目标写进一次单独的挑选调用,运行时不依赖外部反馈;替换掉这一步,增益就消失。
arXiv: 2611.00643
https://arxiv.org/abs/2611.00643
科学智能演化:从碎片化证据到分布式实验循环
Evolving Scientific Intelligence: From Fragmented Evidence to Distributed Experimental Loops|arXiv|预印本,未经同行评审|2026-10-31|香港科技大学
要点: 论文提出 Evolving Scientific Intelligence(ESI)架构,把科学发现分为三层:L1 执行实验,L2 生成假设并联合选择候选与评估方法,L3 更慢地重新评估研究目标。共享科学内存保存实验记录,供信息碰撞重组为假设。
研究动机: 科学知识分散在各学科,以叙事文字或互不兼容的表示记录,AI 系统难以综合,自动化实验室之间也难以协调实验。论文无法承载训练模型和指导实验室所需的全部实验证据:研究人员常把负面结果、探索性试验和未解释的观察排除在发表记录之外,作者称这一缺口为「科学内存墙」。LLM 已能提出新实验,但多数实验循环仍局限于单个实验室系统,碎片化表示和接口限制证据整合与跨系统协调。持续学习还需要实验反馈,而许多设计管线依赖结构预测器,预测误差会在设计过程中传播。
实验设计: 论文提出 ESI 架构,把发现流程分为三层:L1 负责本地感知与执行,L2 生成假设、联合选择候选与评估方法并协调跨节点实验,L3 作为更慢的元控制层重新评估研究目标与决策标准。共享科学内存保存实验记录,供跨域信息碰撞重组为可检验假设;物理实验和跨节点比较用于验证。
结果: 支撑架构的证据包括:在包含失败实验的历史反应记录上训练的模型,在水热材料合成中推荐的条件达到 89% 成功率,人类专家为 78%;约 776,000 次蛋白质折叠稳定性测量展示了高通量数据生产的规模。论文还引用膨胀显微镜的例子:利用可膨胀聚合物网络实现约 70 nm 的有效横向分辨率。
结论: 作者认为,ESI 旨在让一项调查中产生的信息引发其他调查的实验,而不仅是逐个自动化实验室。
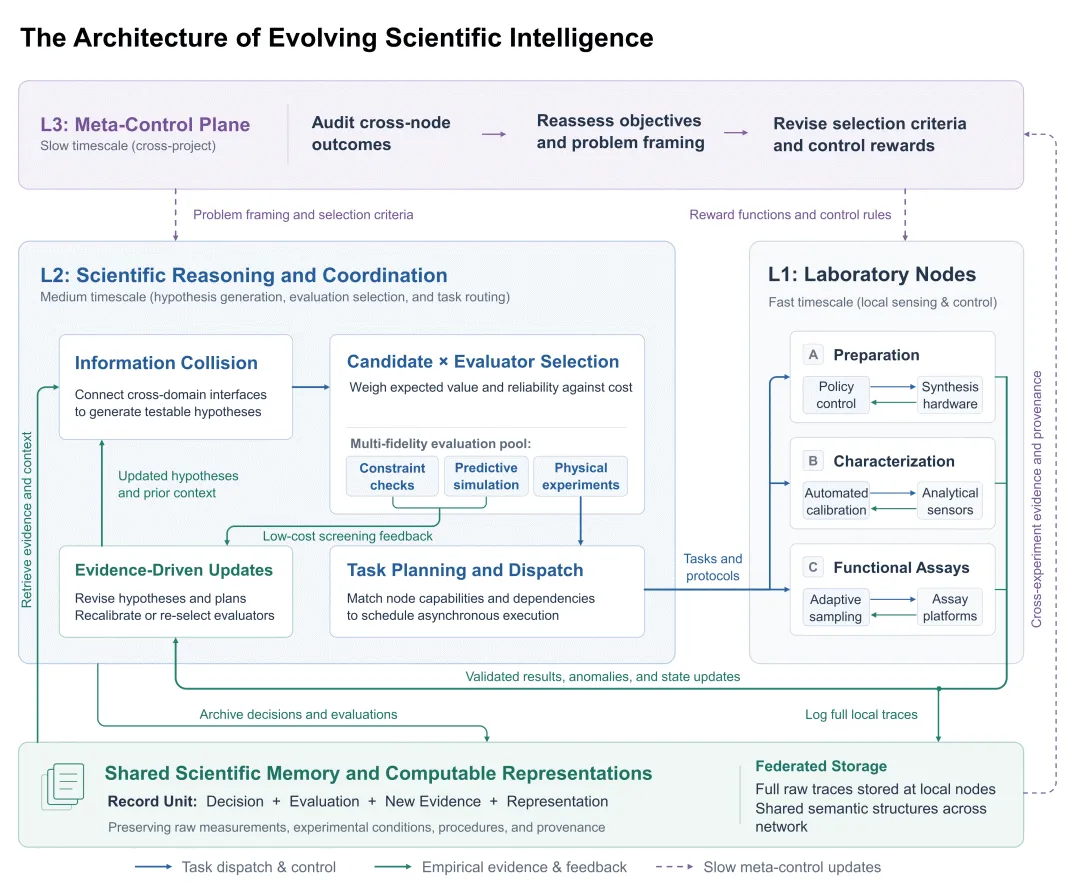
图 3|ESI 的三层架构与信息流。图源:原文 Fig. 1
意义与启示: 作者呼吁建设共享科学内存和分布式实验验证的基础设施,组织跨实验室、跨学科的集体努力。
arXiv: 2611.00580
https://arxiv.org/abs/2611.00580
把法规检索与电力系统计算接进一套 agent
An Agentic Framework for Automated Power System Studies and Grid Connection Assessment|arXiv|预印本,未经同行评审|2026-11-02|Grid Agents
要点: Grid Agents 把法规检索与电力系统计算接在一套 agent 上:Grid Ontology 负责带引用地检索法规,Grid Studio 调用既有求解器跑电力系统研究,全套在 519 项任务上评测。
研究动机: 并网而非发电,如今限制着能源转型:2023 年全球至少 3,000 GW 可再生能源项目在排队等待接入。每个申请要做两类专家工作:对照数千页、随改革变动的法规与电网标准审查申请,用潮流、N-1 和短路计算决定接入点与加固方案;两类工作都慢,都缺人。基于 LLM 的 agent 能规划并调用工具,适合这两类任务,但会写出没有来源支撑的文字,在大电网方程的算术上不可信。答案正确也不说明背后工作正确:同一个数字可能来自正确计算、记忆或错误电网状态下的计算,多数基准只判数字。
实验设计: 作者把八个已发表的电力系统基准族合成一套任务,网络从 4 到 9,241 个节点。评分用严格通过:答案落在基准容差内,且记录的工作显示所需计算跑在所需电网状态上;端到端分数把数值接近度、答案正确率和严格通过率加权。监管侧在 GB 法规集和 LegalBench-RAG 上按引用的证据打分,另比两个公开榜单。
结果: Grid Studio 在八个基准族上的平均端到端分数为 99.9%,每任务 agent 工作耗时中位数 13.9 s,两项领先都在统计上显著(图 4)。Grid Ontology 在 GB 法规集上引用正确证据的 recall 为 0.967,在 LegalBench-RAG 上高于所有基线,并在两个公开榜单的已发表条目中分数最高。接入优化器后,Grid Studio 的加固方案平均便宜 33–67%。
结论: 作者认为,Grid Agents 把答案依托所引证据、数字出自既有求解器、决策留给工程师三条原则落到一套系统上,在电力系统任务上分数最高、耗时最少。
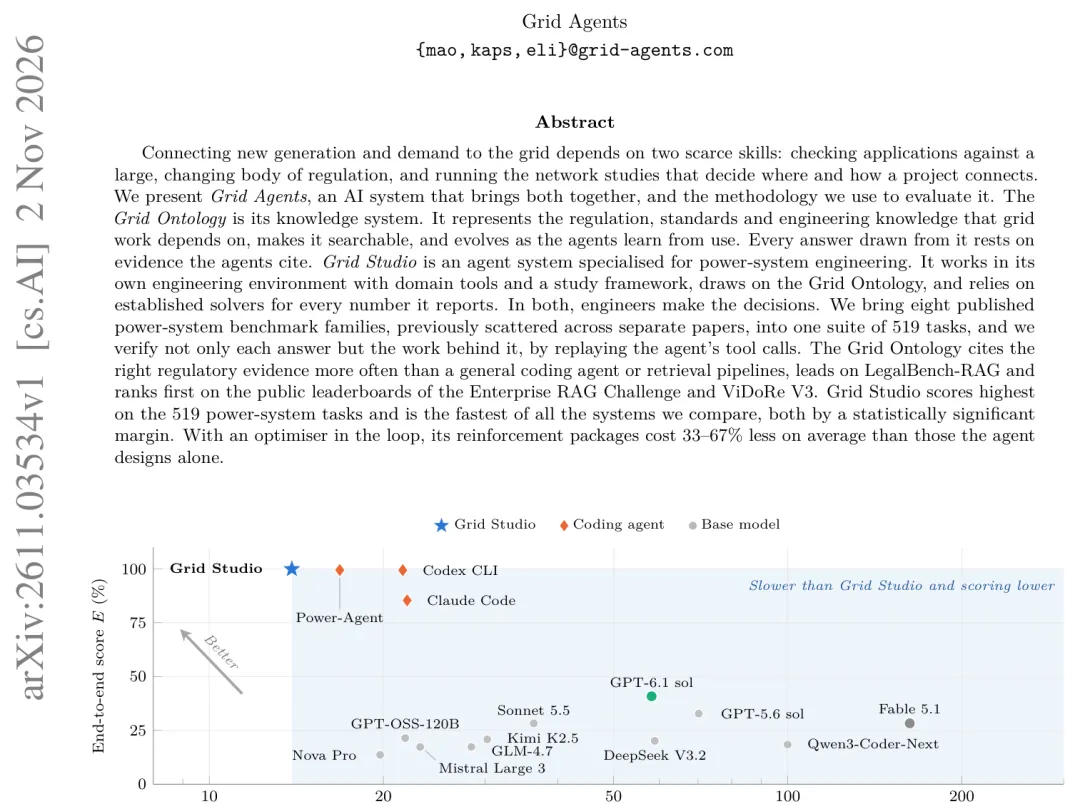
图 4|端到端分数与每任务 agent 工作耗时的关系,横轴为对数刻度,每点为一个系统。图源:原文 Fig. 1
意义与启示: 作者指出,真实的规划研究网络可达数万节点,一条接入研究串联多项计算;Grid Studio 从既有求解器而非逐任务代码取数、每步可查,更适合这类研究。
arXiv: 2611.03534
https://arxiv.org/abs/2611.03534
以验证引导的 agent 流水线,从问题描述生成拓扑优化设计
Agent4FreeFem: A Verification-Guided Framework for Autonomous Topology Optimization|arXiv|预印本,未经同行评审|2026-10-31|华东师范大学数学科学学院;上海交通大学巴黎卓越工程师学院
要点: 作者构建 Agent4FreeFem 流水线,把自然语言描述转成经过验证的拓扑优化设计,在 34 个算例上检验,全部求解通过运行时验证。
研究动机: 把一个新的拓扑优化问题从描述做到优化结果,仍然慢、依赖专家,而且容易出错。流程横跨数学建模、网格生成、弱形式推导、求解器配置和优化循环调参,每个环节各用一种工具,跨环节交接占去大量时间。每个新问题都要有同时懂物理和数值计算的专家手写并调试求解器代码;这些代码常常能编译,却在运行时失败或收敛到错误解,定位错误也很费力。已有的 LLM 工作只覆盖预处理,或只在专家写好的求解器内部工作;LLM 生成的有限元代码在基准中通过率同样低。
实验设计: 作者用水平集方法检验 6 类问题:线性与非线性弹性、线性与非线性热传导、Stokes 流和热弹性耦合。每个算例先生成一个程序模板,再在 64 组参数组合下各跑一份副本。每次运行须通过运行时验证;失败由确定性检查、语义复核或执行证据定位,修复后重跑,预算为 1 次生成加至多 10 次修复。
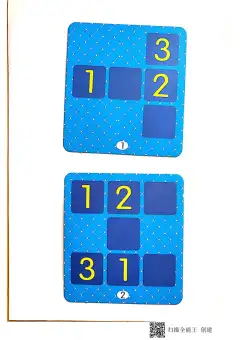
结果: 32 个算例在 64 组参数组合下共完成 2,048 次参数扫描运行,全部通过运行时验证,没有算例耗尽修复预算。弹性与热传导算例共用棋盘格初始设计(图 5)。单个算例从描述到扫描完成的平均端到端耗时为 85 分钟 2 秒。人为注入的 48 个缺陷全部在预算内修复,并通过生成阶段的检查。消融实验中,去掉手册知识后,压力容器端盖算例耗尽修复预算。
结论: 作者认为,结果说明这条流水线减少了求解器代码开发所需的专业知识,是让拓扑优化更易被使用的一步。
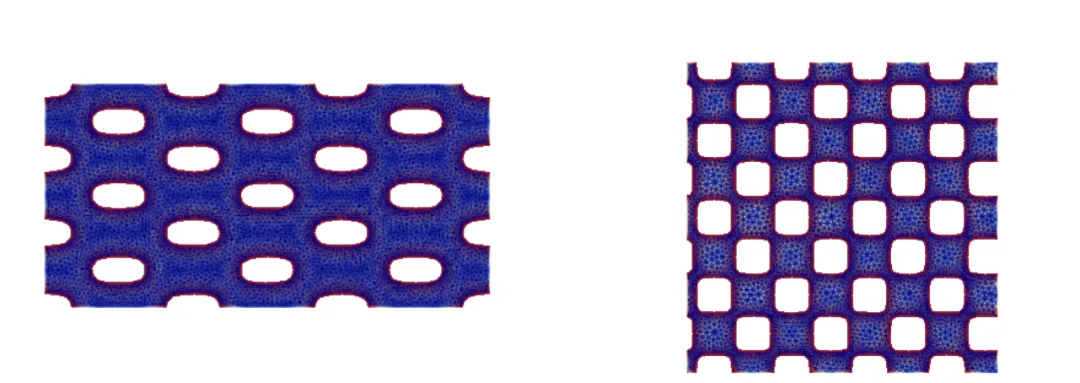
图 5|全部弹性算例与全部热扩散算例共用的棋盘格初始设计,画在代表性网格上。图源:原文 Fig. 5
意义与启示: 作者还指出,评估覆盖单物理场与耦合多物理场问题,每个算例都成功。
arXiv: 2611.00803
https://arxiv.org/abs/2611.00803
Circuit Oracle:用自然语言查询自动分析归因图
Circuit Oracle: Automating Attribution Graph Analysis via Natural-Language Queries|arXiv|预印本,已被 ICML 2026 MechInterp and CompLearn 研讨会接收(非存档,未经期刊同行评审)|2026-10-30|Independent Researcher;University of California, Los Angeles;The University of Maryland, College Park
要点: Circuit Oracle 让现成 LLM 在多 agent 框架和任务 skill 下通过工具调用读取归因图,回答自然语言问题。在虚假特征检测的探针电路上,其五次运行的平均准确率为 78.2% ± 2.4。
研究动机: 归因图可以当作模型内部计算的“轨迹”,把跨层特征与因果边组织成有向图,节点是 transcoder 特征,边是局部直接因果效应,但从中提取与安全相关的洞见仍是瓶颈。一个短提示的图就可能包含跨数十层的数百个活跃特征,邻接矩阵里有数千条非零边。判断哪些特征携带虚假相关、隐藏秘密或编码抑制机制,目前需要专业知识和人工投入,而这些判断还要在路径中定位少数相关特征。如何评价一张归因图的质量也尚不清楚;此前工作多依赖忠实性或干预检查,看电路能否复现目标模型的行为。
实验设计: 作者把现成的前沿 LLM 放进多 agent 框架,配上遍历归因图的工具和按任务编写的 skill;orchestrator 按需派 subagent 沿因果边上溯,再把发现汇总成剪枝电路和自然语言分析。验证分三项:80 张探针归因图上的虚假特征检测、20 个 taboo 模型各 6 条提示的秘密知识诱导,以及 50 条拒绝提示上的特征级干预。
结果: Circuit Oracle 的虚假特征检测总体准确率高于 Trans-cos 的 72.5%(图 6)。秘密知识诱导的闭集总体为 75.0%,低于 Activation Oracle;两个投影基线都低于 Circuit Oracle。拒绝抑制上,单次提交干预的 pooled 分数为 0.804,低于 diff-in-mean 的 0.825;只在允许取多次尝试最佳时超过基线。结果在重复运行和不同 orchestrator 选择下稳定。
结论: 作者认为,在三项代理任务上,Circuit Oracle 总体优于不读取跨层信息的基线,但落后于使用训练好的激活读取适配器的 Activation Oracle 等基线。
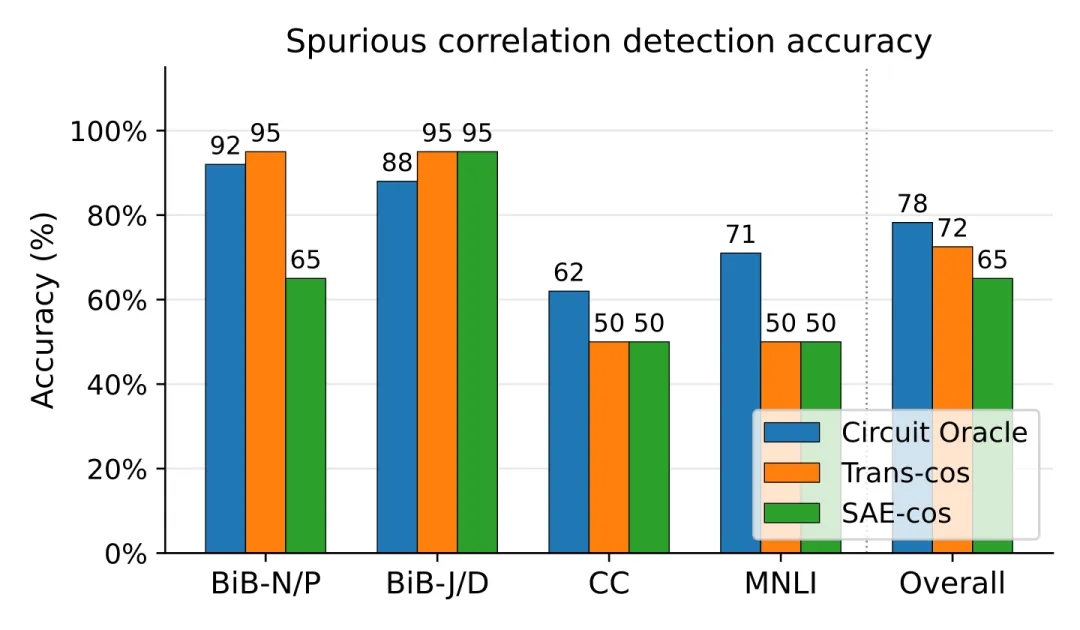
图 6|Circuit Oracle 与两个基线的虚假特征检测准确率(按数据集与总体)。图源:原文 Fig. 2
意义与启示: 作者还认为,用现成 LLM 读取预先计算的归因图具有广泛竞争力,这一 skill 与工具的模式可作为任务专用方法的通用替代,并面向下游 AI 安全。
arXiv: 2611.00420
https://arxiv.org/abs/2611.00420