ARTICLE · 1312532
电脑24G显存,本地部署Qwen3.8-Flash-Next还是Qwen3.8-27B?(附部署教程)
以下文章来源于微信公众号:刘聪NLP
作者:刘聪NLP
链接:https://mp.weixin.qq.com/s/qnkpYJ5VaAd0ZHoGLEX9XQ
本文仅用于学术分享,如有侵权,请联系后台作删文处理

前两天写了一篇关于Qwen3.8-27B模型本地部署的文章,说了一些使用心得,也给大家对比了现有一下量化方法和框架之间的区别,
评论区有一堆人都在说,本地部署的Qwen3.8-Flash-Next效果更好,
我也在网上刷到很多人说,Qwen3.8-Flash-Next无敌,我们今天来看看跟Qwen3.8-27B相比到底效果如何?
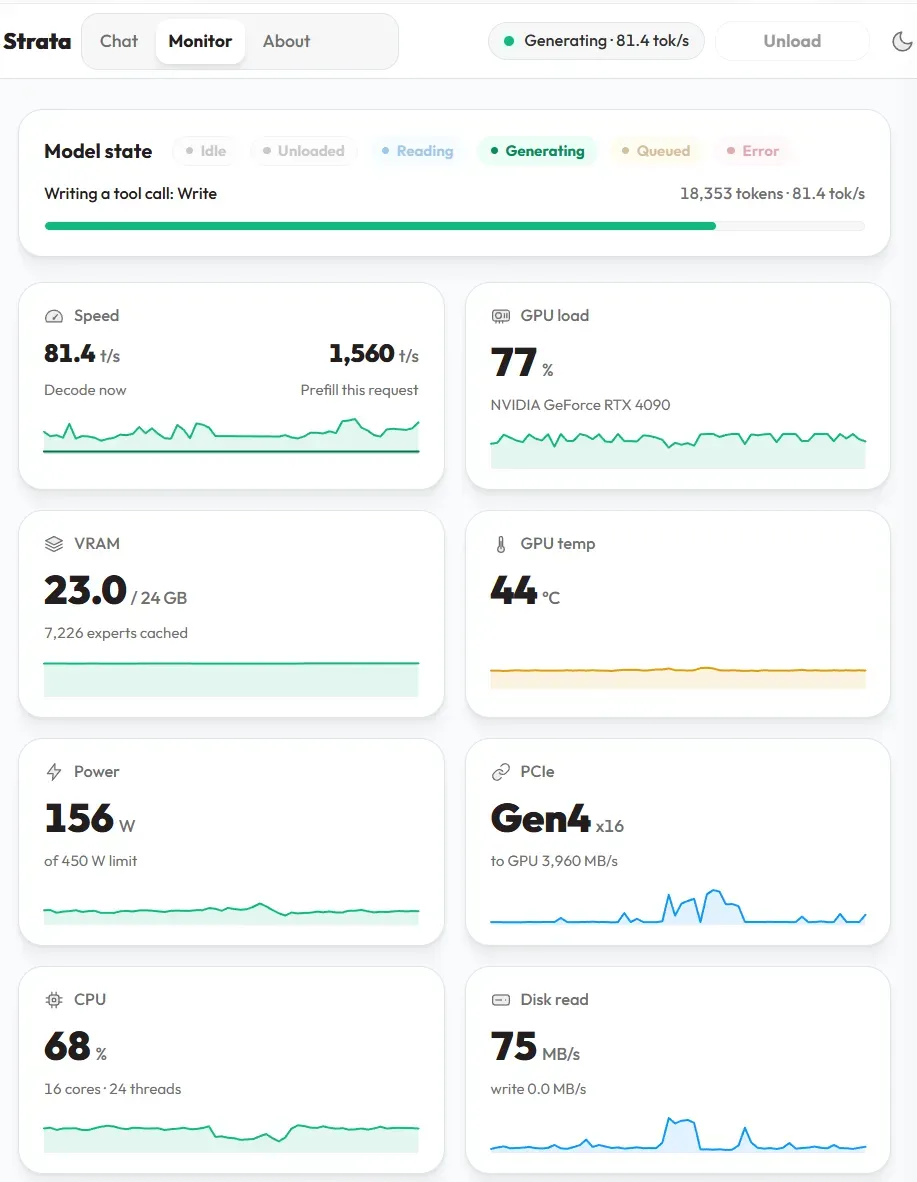
先说一下,Qwen3.8-Flash-Next可以在24G显卡上部署,得益于Strata这个项目,现在也是快38K star了
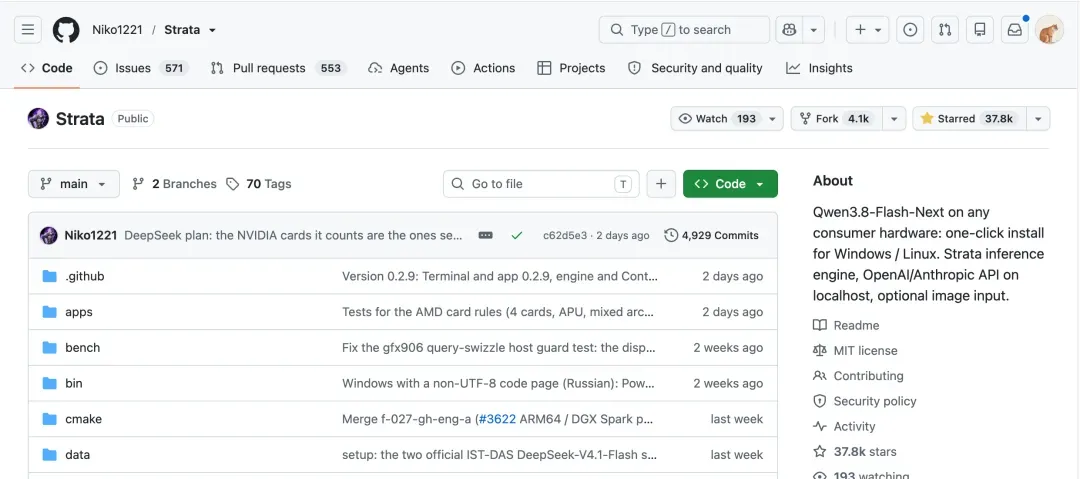
核心原理,是把高频访问热门专家放进显存,其他的专家放在内存,大容量 n-gram 表放在SSD;同时通过 MTP 推测解码、长提示词批处理、会话状态缓存等办法,尽量降低每生成一个 token 的成本。
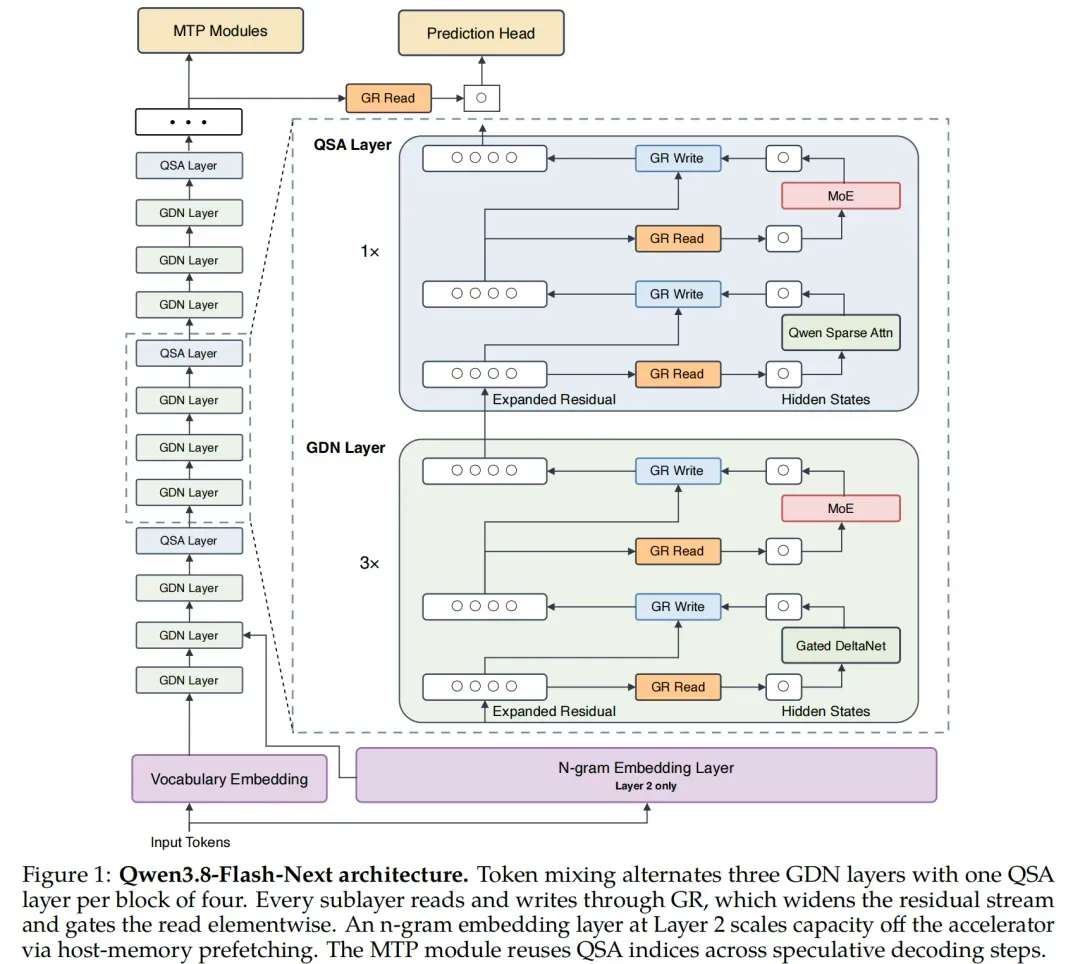
PS:Qwen3.8-Flash-Next的架构是Qwen4的架构,我分享过可见:框架解读
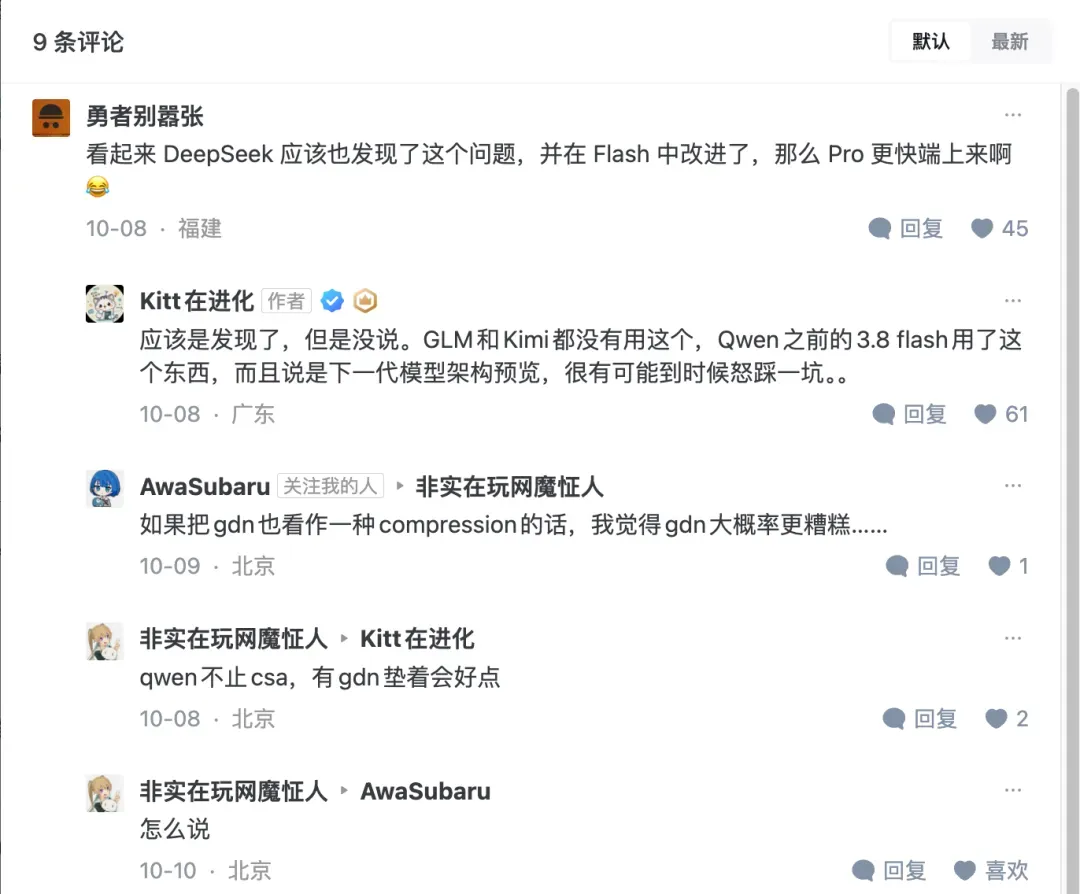
插播一句,前段时间有一篇字节Seed团队的论文Periodic Weak Spots发现,以DeepSeek V4系列为代表的模型,使用压缩稀疏注意力,会导致长上下文时发生性能漂移。
我发现一个评论很有意思,好奇Qwen4架构到底有这个问题没有。。。
回归整体,咱们今天,主要就是对比,
同样是24G的显存,分别部署Qwen3.8-Flash-Next和Qwen3.8-27B的量化模型,效果优劣情况如何。
我可能跟网上大部分人的观点不一样,
我觉得Qwen3.8-Flash-Next是训练不充分的,总参数有125B,但感觉整体知识容量并没有27B的高,
日常的work类的内容,比如发票整理、OCR处理日常一下文字这些,一些本地场景目标检测27B也更稳,
但写代码这一块Flash-Next我感觉要更强一些,
当然,这些都是在受到量化的影响下,24G显存部署下的感受。
PS:提醒大家一下,官方Qwen3.8-Flash和开源的Qwen3.8-Flash-Next是两个模型哟。
这次的机器是RTX 4090 24GB、48GB内存和i7-13700KF,7B用Unsloth的UD-Q4_K_XL,负责推理的是llama.cpp;Flash Next用Strata,权重是IQ3_XXS。本级运行Flash-Next期间,内存吃了48G。
下来来看实际场景的测试,
先看视觉解析能力对比,来识别发票和名牌内容,用于一些业务场景,
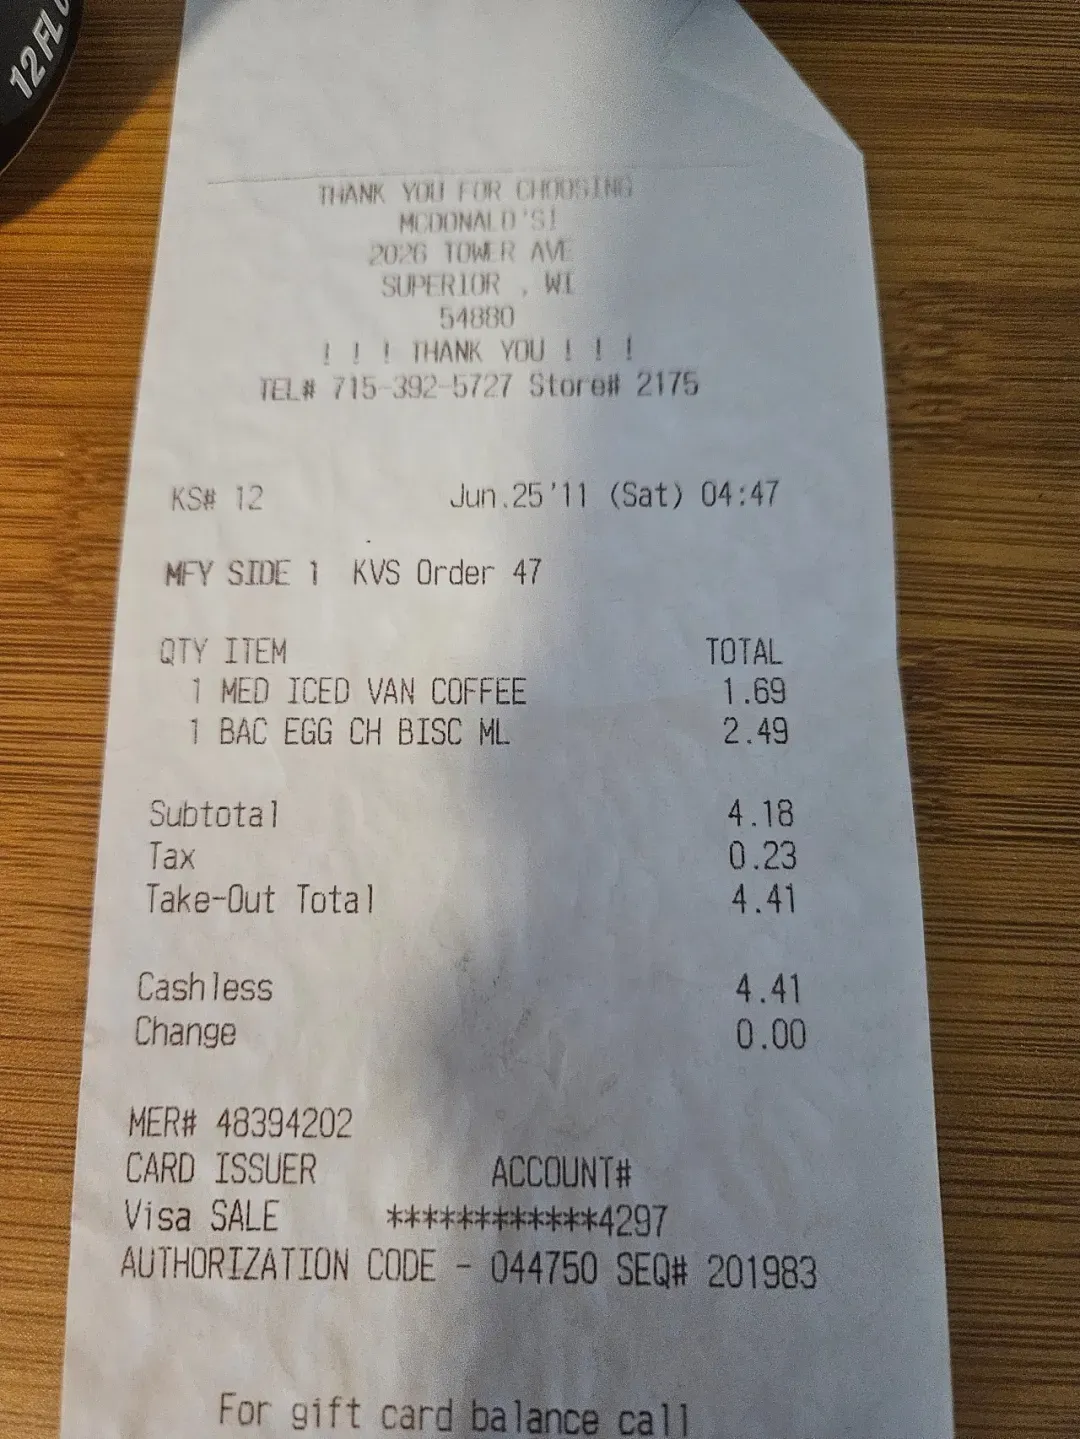
Flash-Next结果,
{"merchant":"MCDONALD'S","date_text":"Jun.25'11 (Sat) 04:47","items":[{"name":"MED ICED VAN COFFEE","quantity":1,"amount":"1.69"},{"name":"BAC EGG CH BISC ML","quantity":1,"amount":"2.49"}],"subtotal":"4.18","tax":"0.23","total_paid":"4.41","payment_method":"Cashless","payment_amount":"4.41","change":"0.00","uncertain":[]}27B效果,
{"merchant": "MCDONALD'S","date_text": "Jun.25'11 (Sat) 04:47","items": [ {"name": "MED ICED VAN COFFEE","quantity": 1,"amount": "1.69" }, {"name": "BAC EGG CH BISC ML","quantity": 1,"amount": "2.49" } ],"subtotal": "4.18","tax": "0.23","total_paid": "4.41","payment_method": "Cashless","payment_amount": "4.41","change": "0.00","uncertain": []}内容都正确,没有具体的差别,Flash-Next耗时约9.96s,27B是6.84秒。
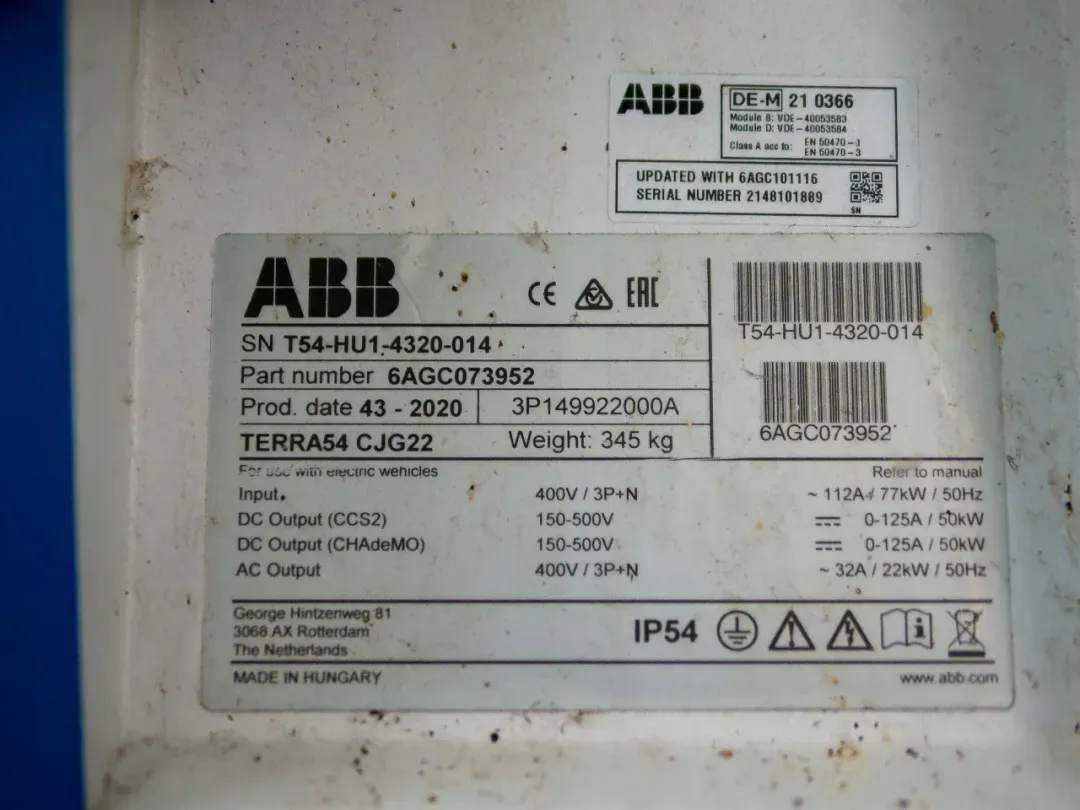
Flash-Next结果,
{"brand": "ABB","model": "TERRA54 CJG22","serial_number": "T54-HU1-4320-014","part_number": "6AGC073952","production_date": "43 - 2020","weight": "345 kg","protection_rating": "IP54","made_in": "HUNGARY","input_voltage": "400V / 3P+N","input_frequency": "50Hz","ccs2_voltage_range": "150-500V","ccs2_current_range": "0-125A","ccs2_power": "50kW","update_part_number": "6AGC101116","update_serial_number": "2148101889"}27B结果,
{"brand": "ABB","model": "TERRA54 CJG22","serial_number": "T54-HU1-4320-014","part_number": "6AGC073952","production_date": "43 - 2020","weight": "345 kg","protection_rating": "IP54","made_in": "HUNGARY","input_voltage": "400V","input_frequency": "50Hz","ccs2_voltage_range": "150-500V","ccs2_current_range": "0-125A","ccs2_power": "50kW","update_part_number": "6AGC101116","update_serial_number": "2148101889"}铭牌的型号、两个零件号和电气数值两个模型都读对了,并且主铭牌SN也没有和上面的更新贴纸串在一起,但Flash-Next把同一行的“/ 3P+N”一起放进了电压里,27B则只取400V,个人来看27B更胜一筹。
如果短票、铭牌的信息还比较稀疏,换成密密麻麻的整版图文,细字和版面就更考验模型了。
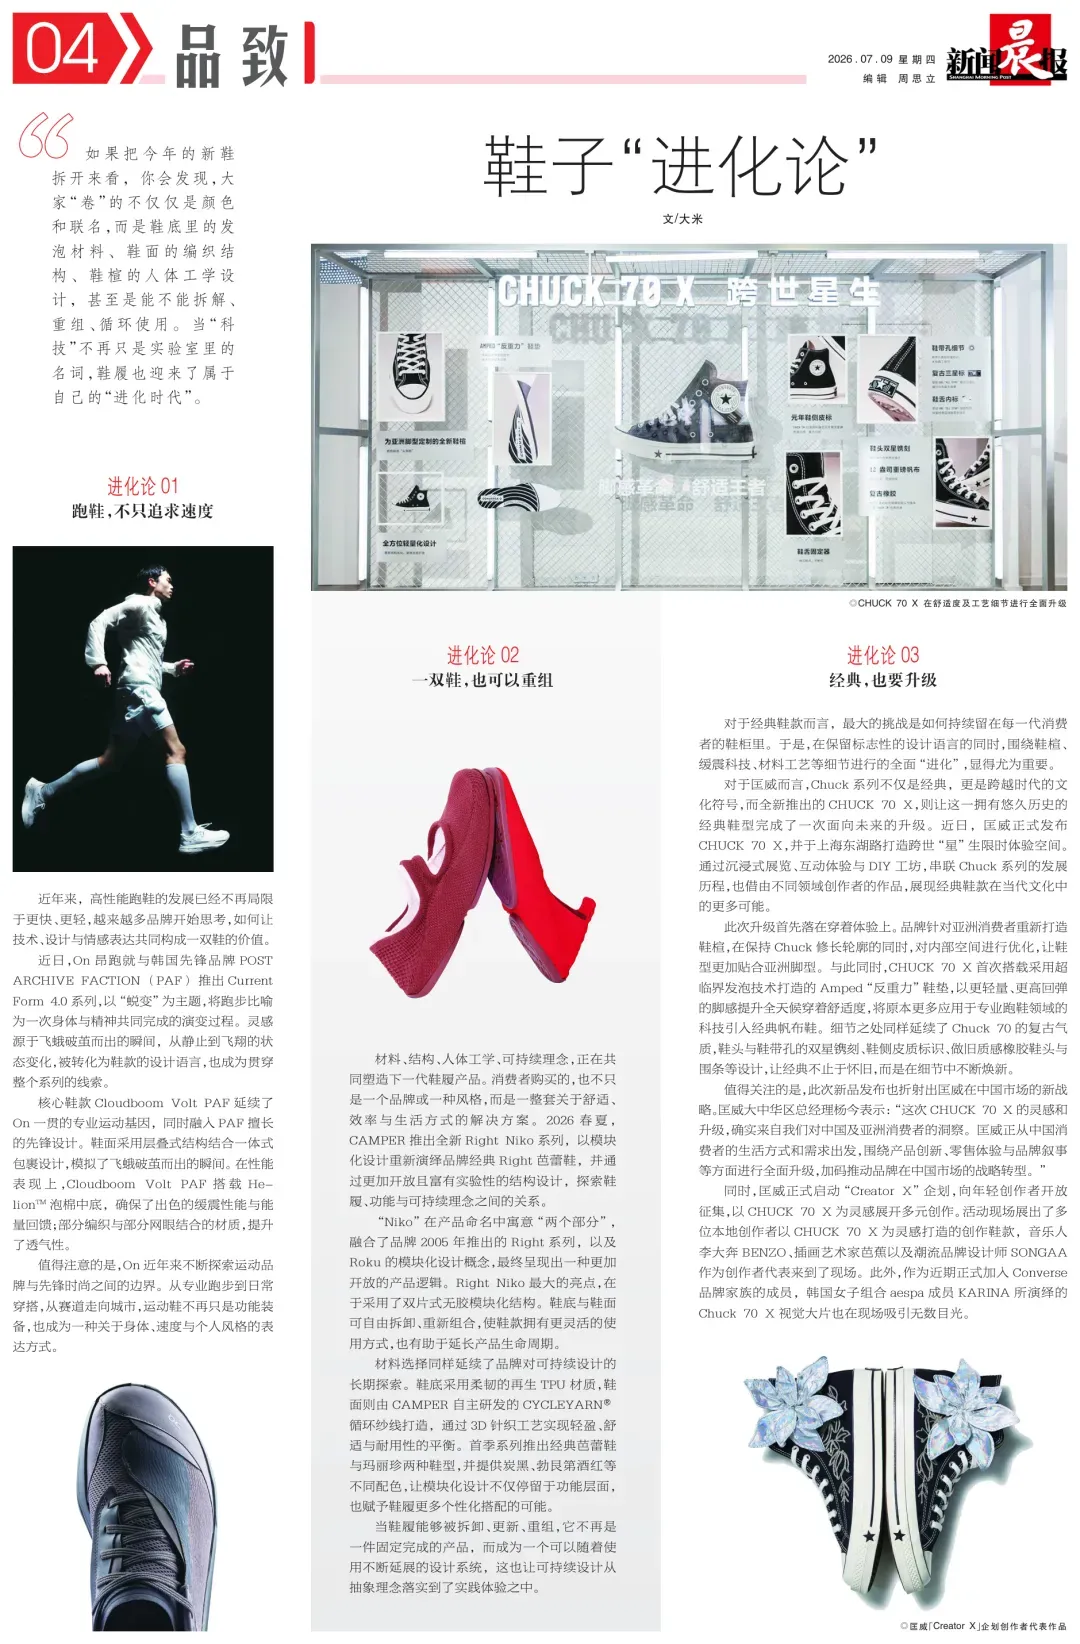
这种有点复杂了,两个模型都出现了不同的错误,
Flash-Next把“鞋楦”多处写成“鞋柜”,BENZO、SONGAA成了BENZNO、SONGYA,图内小标签也有重复和漏读。
27B把报头“新闻晨报”认成了“新快报”,Right Niko写成Right Nika,“李大奔”成了“李宇春”。
再看看日常文本处理的场景,比如翻译、信息抽取等,
提示词如下,
请将以下技术说明翻译成适合开发者阅读的简体中文。英文原文:The local assistant retrieves up to five chunks before generating an answer. Retrieval is not training: adding a file changes the searchable collection, but does not update the model's weights. By default, cached answers may be reused only when the document version matches. If cache_only=true, the server must not contact the retriever; it should return an empty answer when no matching cache entry exists.Reducing the context limit from 16,384 to 8,192 tokens can lower memory use, but does not guarantee faster responses. In our v2.4 test, the first token arrived 120 ms earlier on one machine. This result is not a general speed claim. Keep citations even when a retrieved chunk disagrees with the answer, and mark the conflict rather than silently rewriting the source.Flash Next结果,
本地助手在生成答案之前最多检索五个文本块。检索并非训练:添加文件会改变可搜索的集合,但不会更新模型的权重。默认情况下,仅当文档版本匹配时,缓存答案才可被复用。如果 cache_only=true,服务器不得联系检索器;当不存在匹配的缓存条目时,它应返回空答案。将上下文限制从 16,384 降至 8,192 token 可以降低内存使用,但并不保证响应速度更快。在我们的 v2.4 测试中,在一台机器上首个 token 提前了 120 ms 到达。这一结果并非普遍的速度主张。即使检索到的文本块与答案不一致,也要保留引用,并标记冲突,**而不是静默地重写源内容。**27B结果,
本地助手在生成答案前最多检索五个文本块。检索并非训练:添加文件会改变可搜索的集合,但不会更新模型的权重。默认情况下,仅当文档版本匹配时,才允许复用缓存答案。如果 cache_only=true,服务器必须不联系检索器;当不存在匹配的缓存条目时,它应返回空答案。将上下文限制从 16,384 降低到 8,192 token 可以降低内存使用,但不保证响应速度更快。在我们的 v2.4 测试中,在一台机器上,首个 token 提前 120 ms 到达。这一结果并非普遍的速度声明。即使检索到的文本块与答案不一致,也要保留引用,并标记冲突,**而不是悄悄重写源内容**。翻译结果都大差不差,都能用,但速度上,Flash-Next是56.2 token/s,27B是75.4 token/s。
有时我们需要从一大堆文本中抽取一些想要的信息内容,用于填表等场景,
这里以采购资料为例,模型要提取17项信息,同时提出固定的要求,
提示词如下,
只根据下方采购资料,提取一份严格JSON对象,不联网、不调用工具,不输出推理过程。只输出对象本身:不得使用Markdown代码围栏、注释、前后说明或多份候选答案。生效的明确更正替代对应旧值;已撤回的便笺无效。没有提供的字段、明确留空的字段、仅有掩码而无法得到完整值的字段,一律用JSON的null,不能用空字符串、“未知”或猜测值代替。明确给出的0与false必须保留,不能改成null。“含税”不代表已知具体税率。对象必须且只能包含以下17个键;键顺序不限:request_id(字符串);requester(字符串);department(字符串);item(字符串);quantity(整数);unit_price_cny(数字);goods_total_cny(数字,等于正式数量乘正式含税单价);shipping_fee_cny(数字或null);tax_rate(数字或null,若已知则用小数比例);approved_at(字符串,ISO 8601且显式包含北京时间时区+08:00);delivery_date(字符串,YYYY-MM-DD);delivery_time(字符串或null);contact_phone(完整号码字符串或null);invoice_title(字符串或null);vendor_name(字符串或null);status(只允许字符串approved、pending、cancelled之一);is_delivered(布尔值)。金额以元为单位,使用JSON数字,不加货币符号、不加千位逗号、不用字符串包裹;小数尾零是否保留不影响正确性。以下是全部资料:【采购资料包|截至2026年10月29日18:00|北京时间】N01(10月27日草稿):申请编号PR-261028-07;申请人周可;部门用户运营;物品27英寸显示器。草拟数量18台、单价1100元、预计10月30日送达,均未获批准。N02(10月28日10:20审批通过):正式批准数量改为12台,含税单价改为1215.50元。申请编号、申请人、部门和物品名称沿用N01。该审批明确替代N01的数量与单价;本订单状态为approved。价格虽然标注含税,但资料没有给出税率。商品金额按正式数量乘正式单价计算。N03(10月28日11:05已确认的配送条款):运费为0元,属于明确免运费,不是缺失值。供应商法定名称未填写;联系人仅留下掩码手机号138****6521,没有完整号码。不得根据品牌、联系人或掩码补出名称及号码。N04(10月29日09:10双方确认的送货更正):送达日期改为2026年11月2日,替代草稿中的10月30日;送达时段仍待双方商定。没有约定上午、下午或具体时刻。N05(10月29日15:00撤回的便笺):申请人曾写“改成15台”,随后于15:10明确撤回,采购审批未变更;这张便笺不生效。N06(10月29日17:40状态复核):采购已经获批,但尚未送达,因此is_delivered为false。发票抬头仍为空,不能用部门、申请人或项目名称代填。除以上材料外,无补充信息。Flash Next结果,
{"request_id": "PR-261028-07","requester": "周可","department": "用户运营","item": "27英寸显示器","quantity": 12,"unit_price_cny": 1215.50,"goods_total_cny": 14586,"shipping_fee_cny": 0,"tax_rate": null,"approved_at": "2026-10-28T10:20:00+08:00","delivery_date": "2026-11-02","delivery_time": null,"contact_phone": null,"invoice_title": null,"vendor_name": null,"status": "approved","is_delivered": false}27B结果,
{"request_id": "PR-261028-07","requester": "周可","department": "用户运营","item": "27英寸显示器","quantity": 12,"unit_price_cny": 1215.50,"goods_total_cny": 14586.00,"shipping_fee_cny": 0,"tax_rate": null,"approved_at": "2026-10-28T10:20:00+08:00","delivery_date": "2026-11-02","delivery_time": null,"contact_phone": null,"invoice_title": null,"vendor_name": null,"status": "approved","is_delivered": false}Flash-Next和27B都把17项信息都对上了,也保留了0、false和缺失字段的null。
再让模型做一下目标检测的任务,只让模型找人物和汽车,原图中有11个人、4辆车。
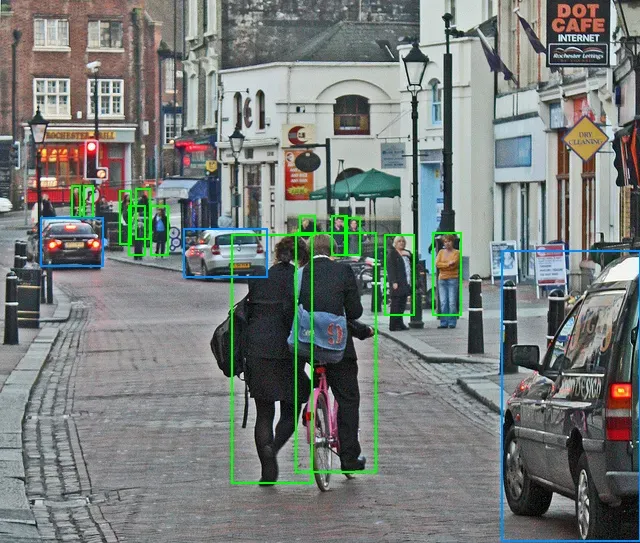
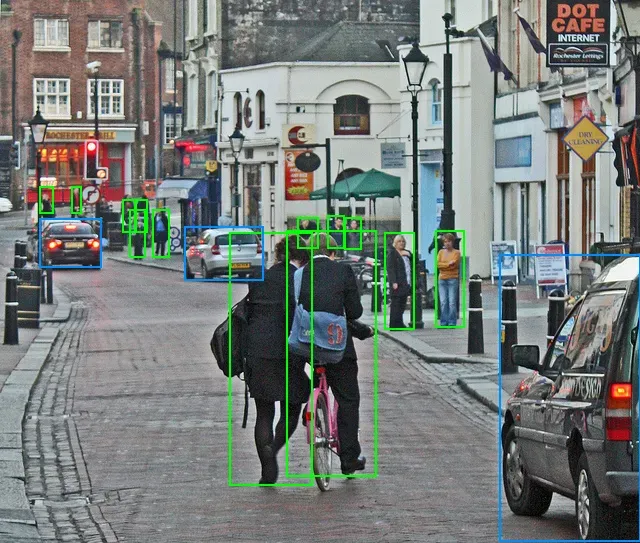
从整体结果上来看,27B效果更优。
看一下3D建模如何,创建一个机械蝴蝶,要四片翼、翼脉和齿轮,还得能转着看、暂停和继续。
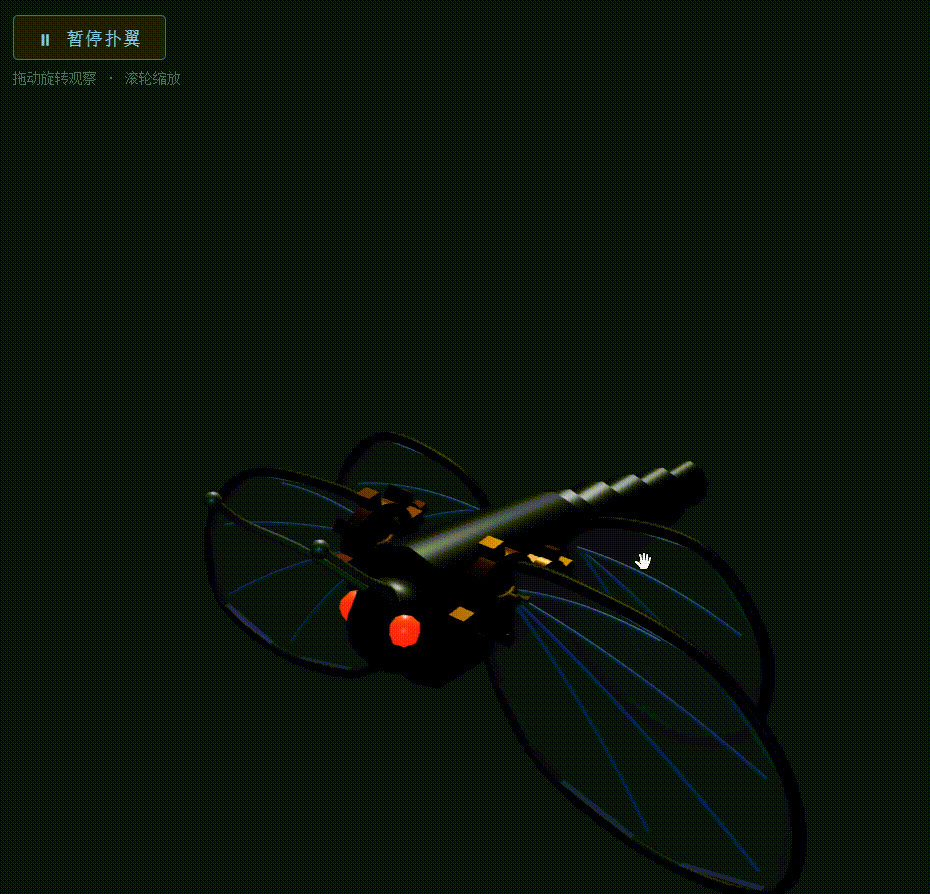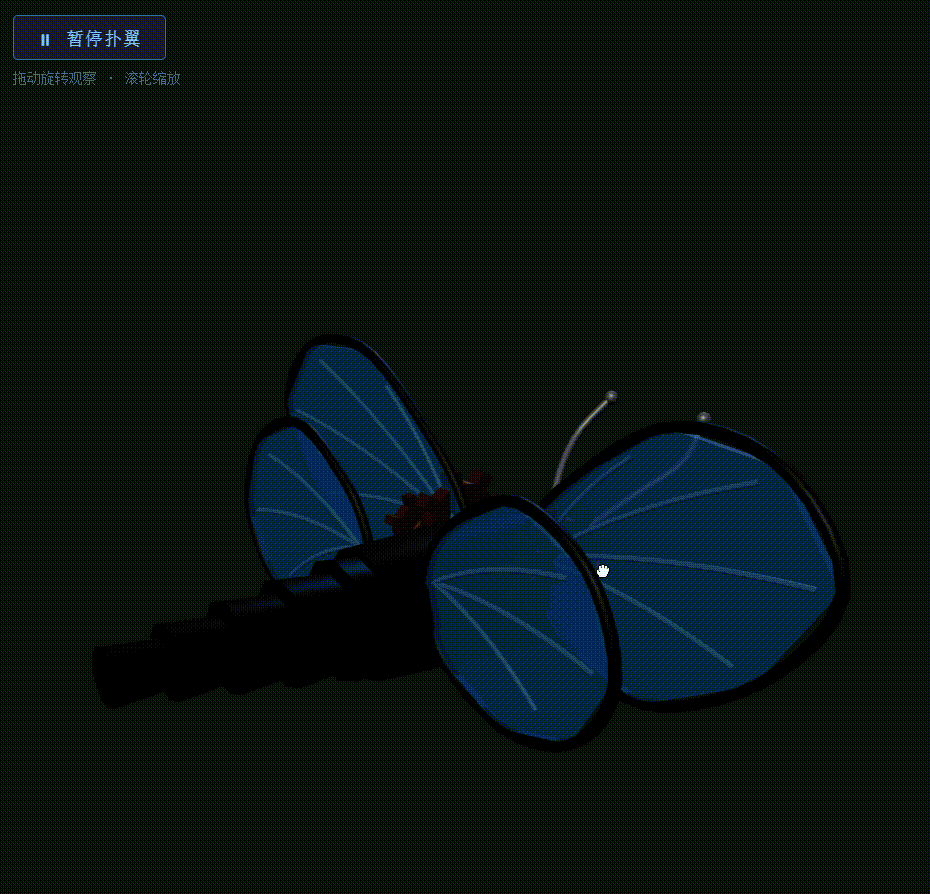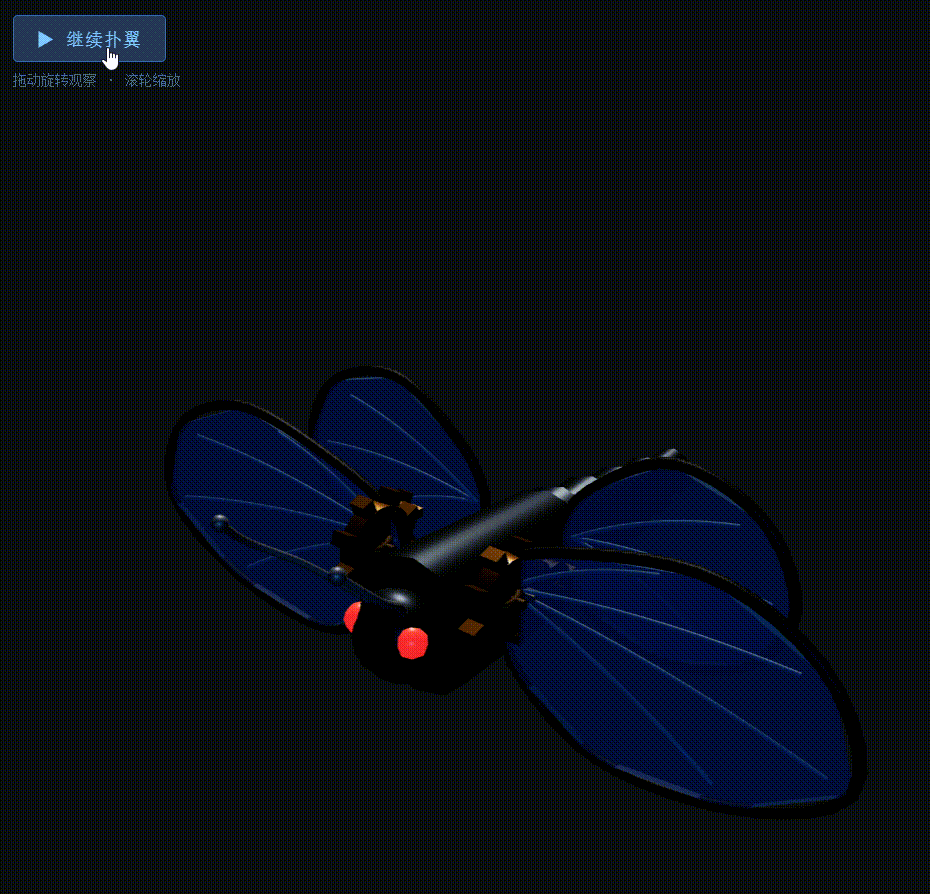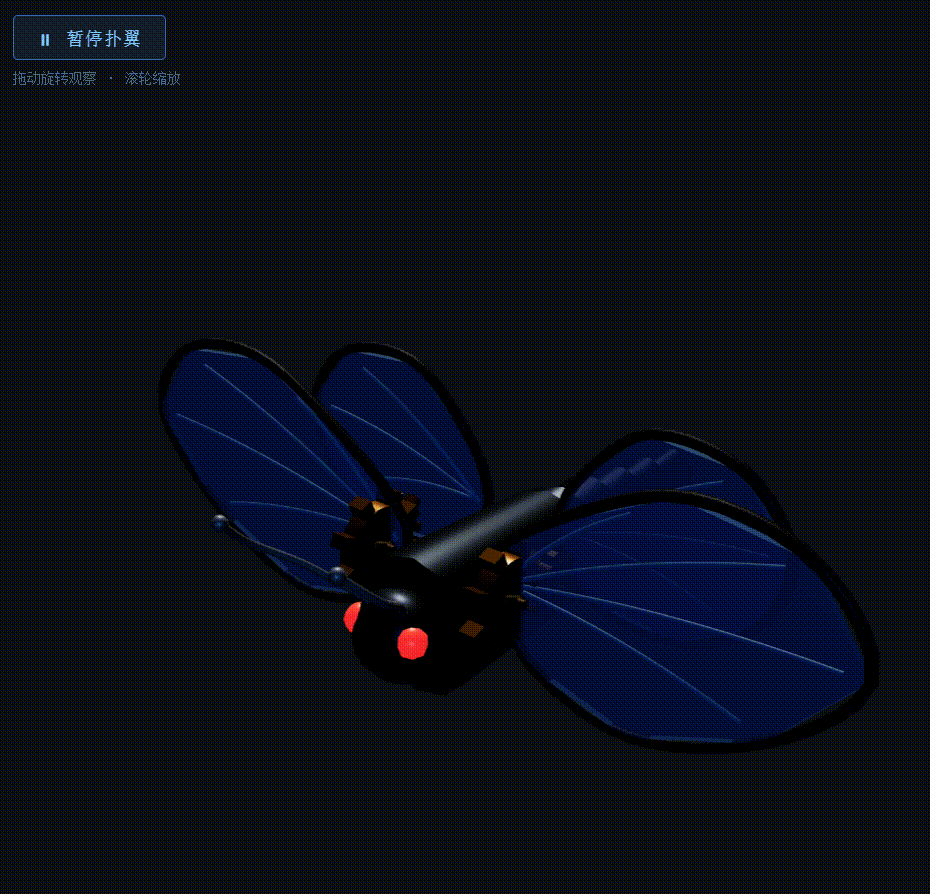
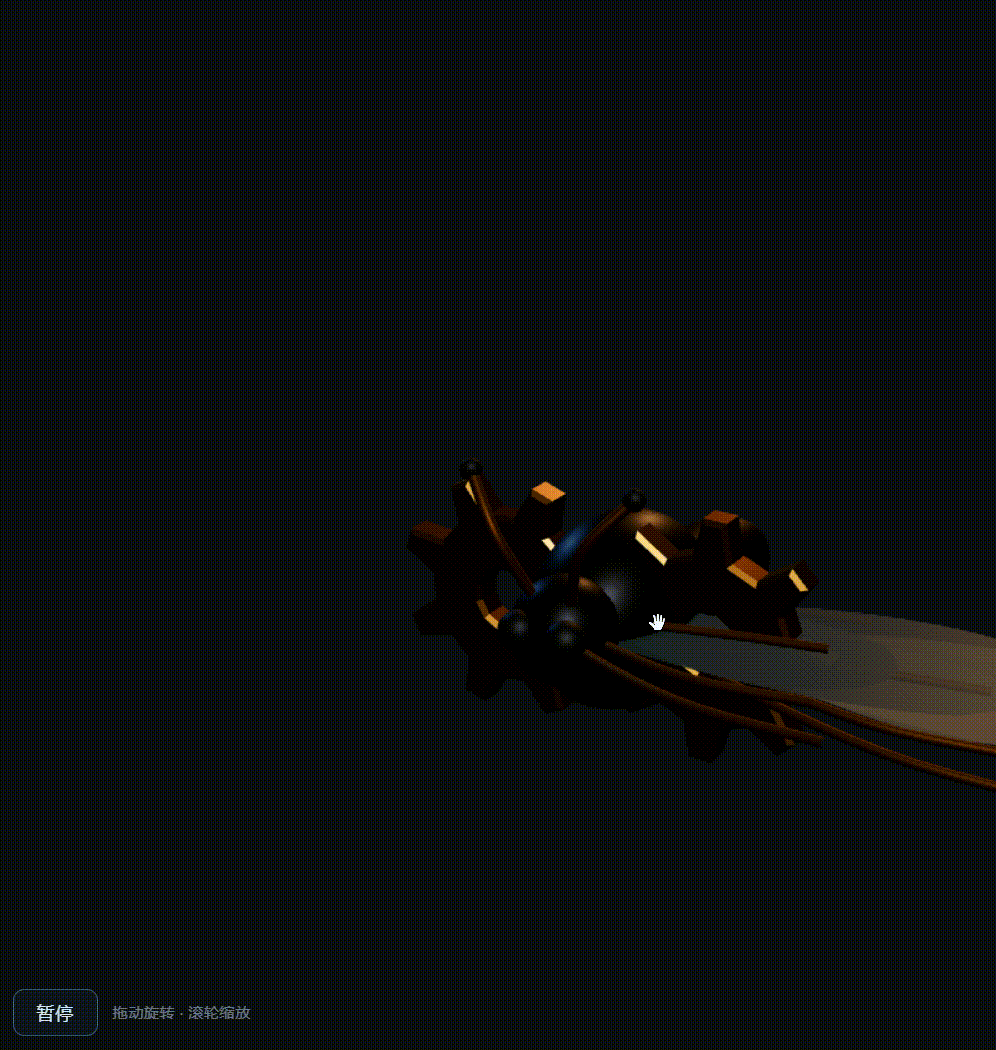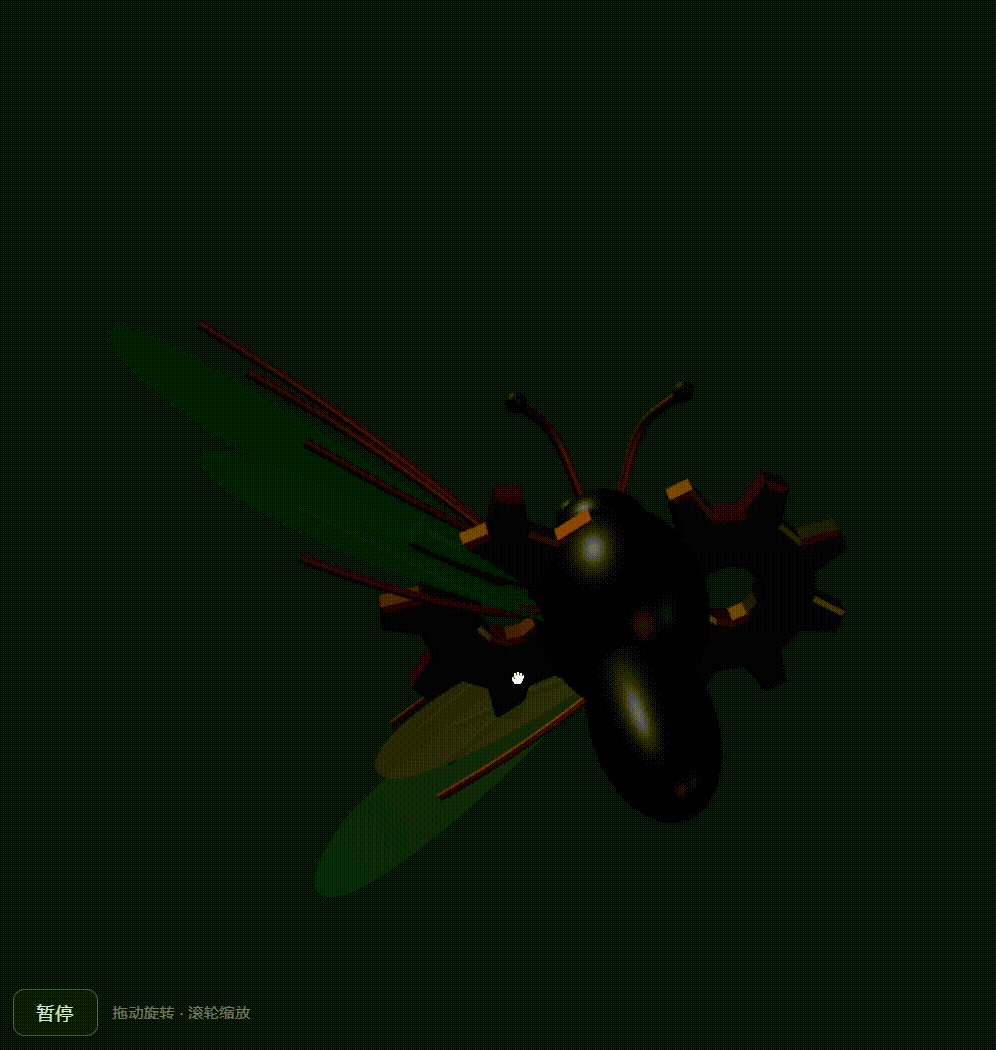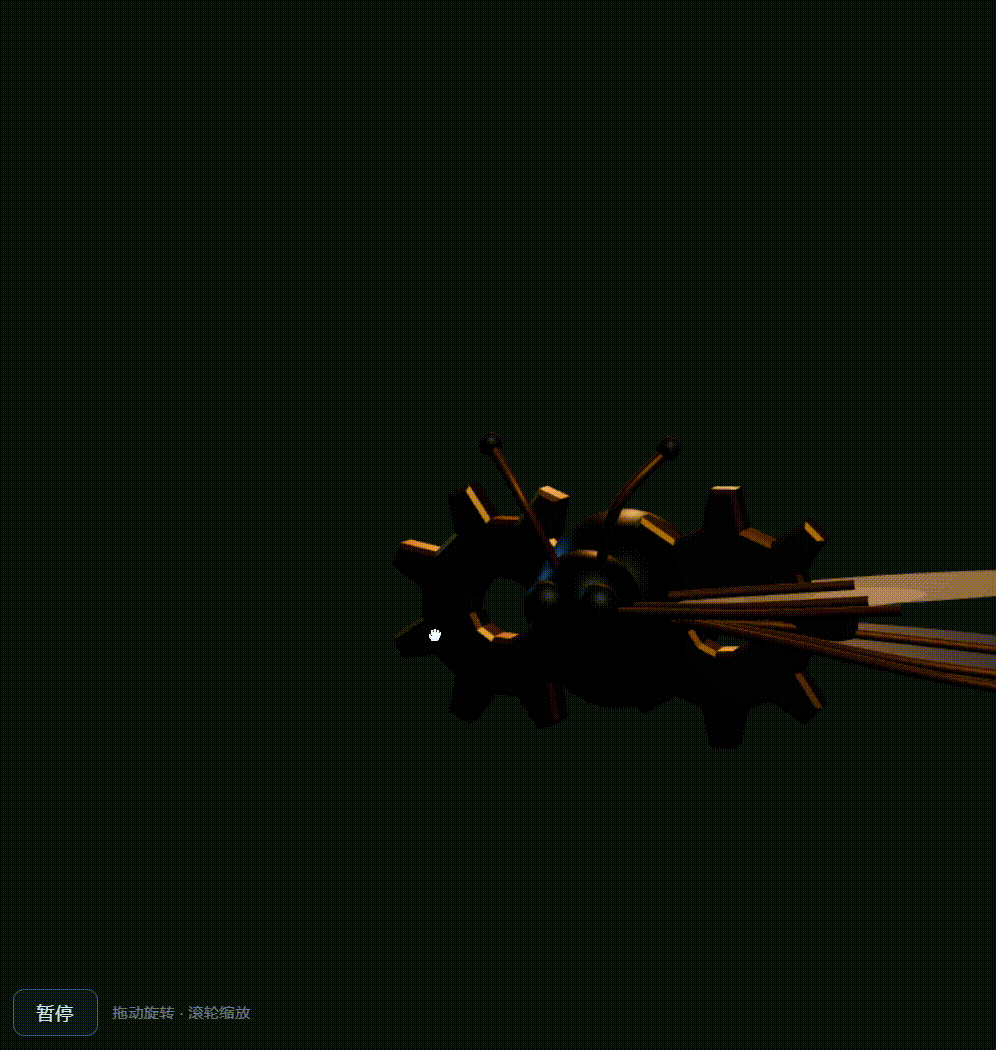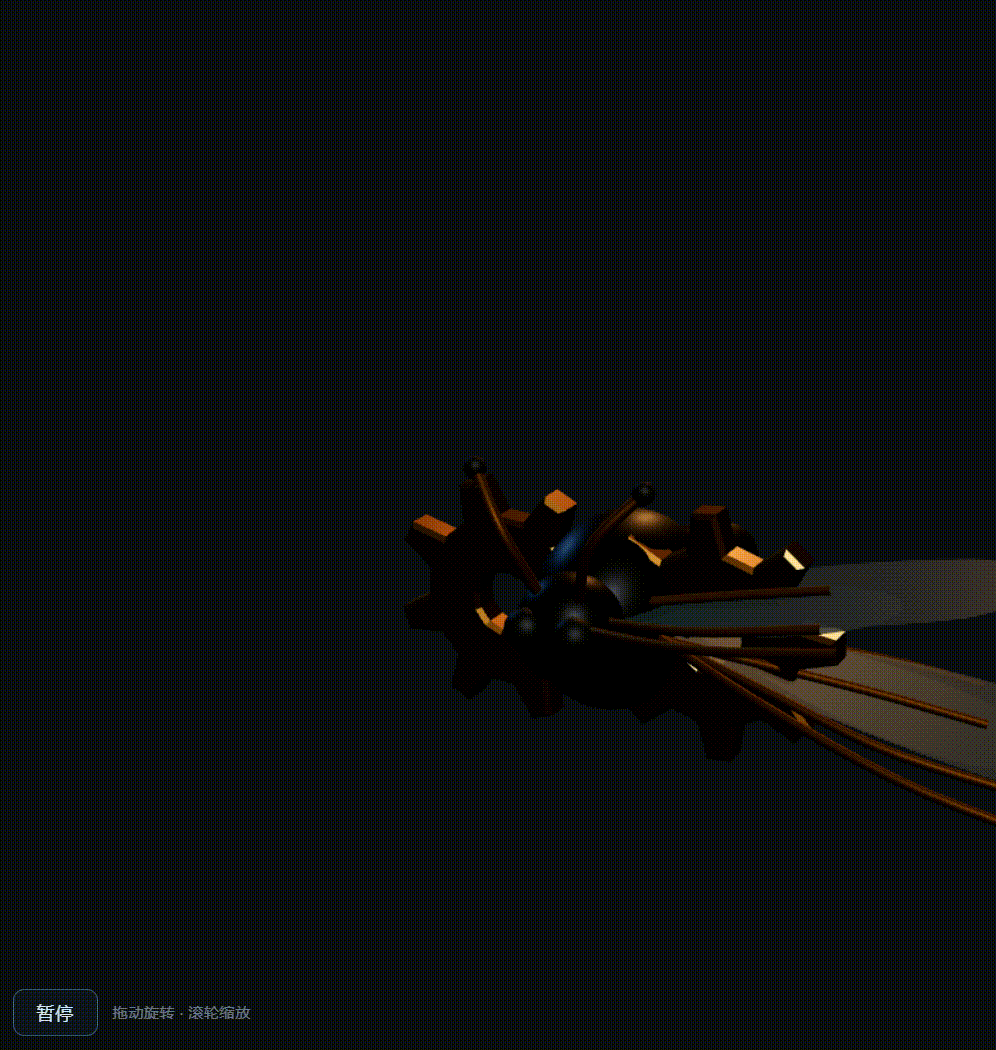
Flash-Next的效果要更好,四翼扑动、暂停后拖动、继续都能用,竖屏也保持完整,但速度要更慢一些68.3 token/s,27B有96.8 tokens/s
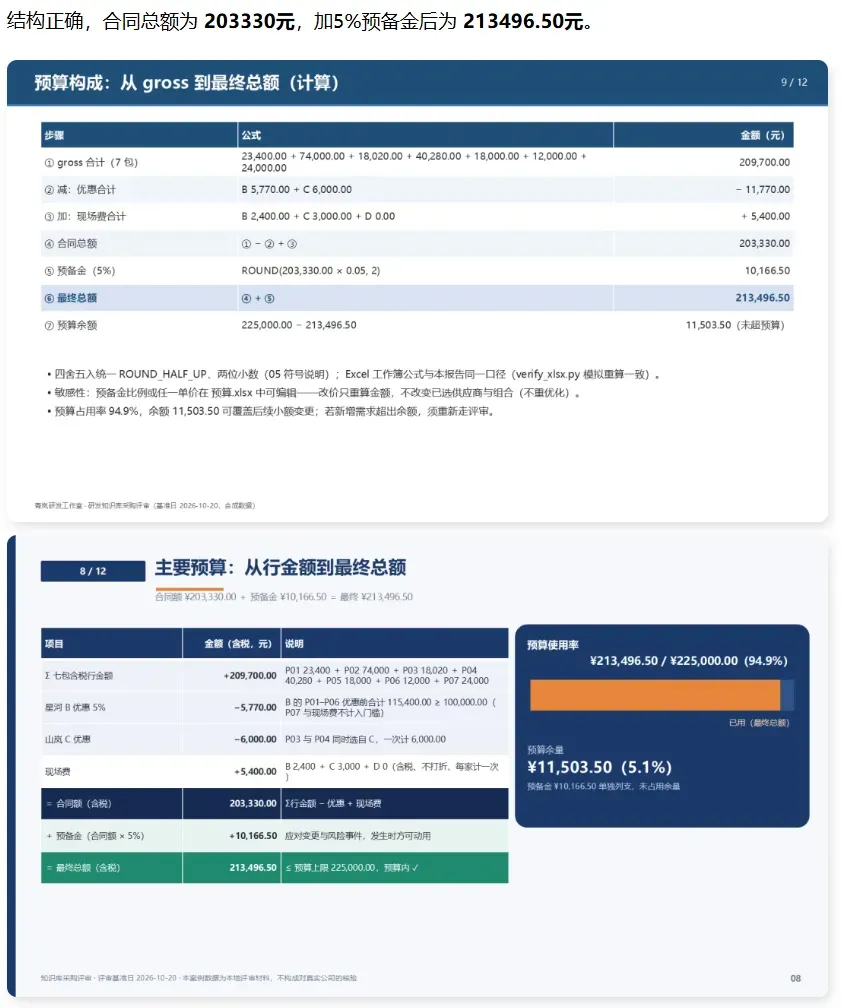
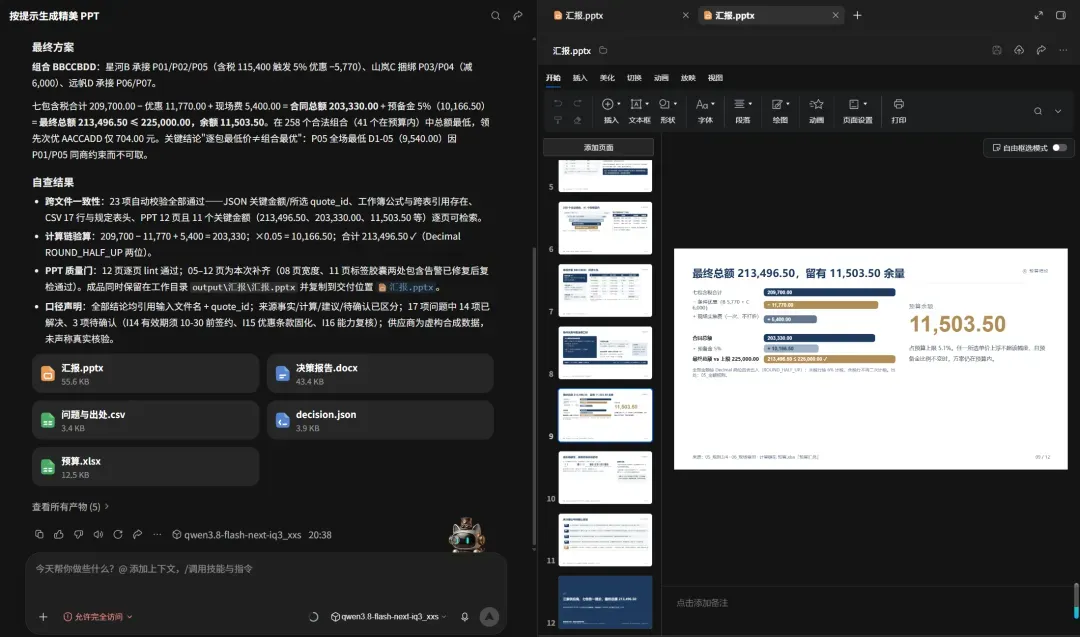
接进WorkBuddy,跟上一篇测试一样,做一次采购汇报
拿过17份模拟采购材料,让模型处理需求变更、报价更正和组合优惠,再交付预算、报告和PPT。
27B效果如下,
Flash Next效果如下,PPT也是12页数据没问题,但是PPT的整体效果感觉没有27B的好。
这里补充一下Strata部署Flash-Next的教程,想尝试的同学可以试一下,(以window系统为例)
先拉仓库,再准备模型
首次部署,在PowerShell里进入准备存放项目的目录:
Set-Location E:\AgentProjectgit clone https://github.com/Niko1221/Strata.gitSet-Location E:\AgentProject\StrataWindows的源码入口是START-HERE.bat。直接运行会进入向导,检测硬件,再选择模型、目录和上下文,
想明确指定,也可以把设置写进命令,我是4090、48GB内存,保留128K和视觉的需求,可以这样准备:
.\START-HERE.bat --setup ` --family qwen --model IQ3_XXS ` --source modelscope ` --data-dir E:\AgentProject\Strata-data ` --context 131072 --kv int8 ` --vision gpu --vision-tokens 1024 ` --mtp on --draft-vocab cjk ` --parallel 1 --kv-streaming off ` --vram-reserve-mib 2048 ` --host 127.0.0.1 --port 8080 ` --no-start这一步会准备依赖、引擎、模型分片及配套文件;no-start表示准备完成后暂不启动推理。source modelscope选择魔搭下载源。已有完整GGUF分片时,可以用gguf-dir指定目录复用。
检查配置,启动服务
源码安装会在仓库目录生成strata-iq3_xxs.json和run-iq3_xxs.bat,运行,
.\run-iq3_xxs.bat启动完成后,另开一个PowerShell窗口检查服务,
Invoke-RestMethod http://127.0.0.1:8080/health服务起来后,可以直接打开本地页面,也可以把OpenAI兼容接口接到自己的客户端。
聊天页面:http://127.0.0.1:8080Base URL:http://127.0.0.1:8080/v1模型名称:以 /v1/models 返回值为准API Key:开启认证时填写实际密钥适合自己的参数,去哪里找
可以看官方MODELS里的模型和内存要求,再看本机生成的配置与启动日志。日志里会有实际留了多少专家在内存、GPU缓存有多大。专家缓存先保留auto,再根据日常使用时剩下的资源调整。
源码入口可以用下面的命令查可用选项:
.\START-HERE.bat --help如果装的是官方Terminal,则用strata launch --help查参数,strata launch --plan先看准备采用的方案。
最后,
我个人现在还是推荐27B模型,作为本地部署的首选,
Flash-Next虽然可以部署,但是还是太吃内存了,同时低精度量化,对模型本身效果也有影响,并且由于参数卸载等因素整体速度也不如27B快。
但本地Qwen3.8-Flash-Next就是架构上的尝试,Qwen4的先行版本,
所以,
还是期待一手Qwen4-27B和Qwen4-Flash的,
据我的内部消息,不远了...
江大白,安生股份(无锡)联合创始人。
深耕企业安全管理+AI领域,通过“技术+商业+内容”的融合视角,深度参与AI产业化落地。
全网20W+粉丝AI知识博主,人工智能技术文章超1000W+阅读,《30天入门人工智能》课程,全网2000+名学员。
主导构建的AI知识平台www.jiangdabai.com累计访问已超800万次;
思想阵地(深度洞察):知乎、CSDN @江大白
内容阵地(视频解读):抖音、快手、小红书 @江大白讲AI
实战阵地(产品纪实):抖音、快手、小红书 @安生江大白 | 记录“1年10个AI产品100个项目应用”的极限挑战
大家一起加油!