ARTICLE · 1313699
全网1.3亿播放的AI神曲《过来人》——我把它的生产线完整拆开了
全网1.3亿播放的AI神曲《过来人》——我把它的生产线完整拆开了AI爆火拆解 · 第1期 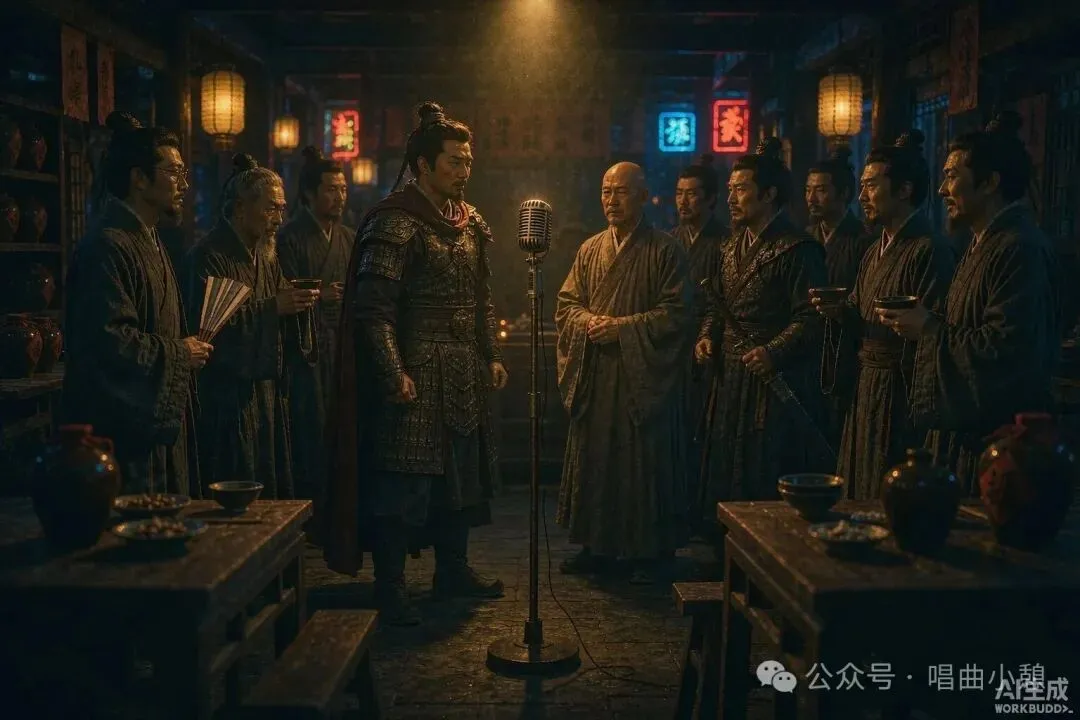
▲ 小酒馆场景示意(AI生成)热度快照先看几个数字: 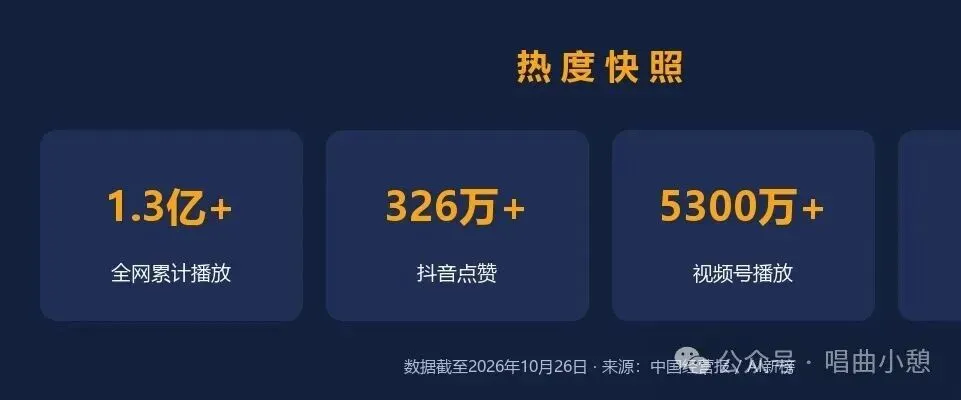
而这条刷屏的作品,制作只花了三四天,团队规模:1个人。它就是10月13日刷屏全网的AI说唱MV《过来人》——昏暗的小酒馆里,杜甫、苏轼、刘邦、项羽、李白、曹操、诸葛亮、司马懿、勾践、孙悟空十位古人轮番拿起麦克风,把自己的一生唱成当代打工人的处境。杜甫为租房奔波,苏轼讲中年被优化,孙悟空头上的紧箍,被网友解读成了房贷和KPI。这一期,我们把《过来人》拆开看:它用了什么工具,提示词怎么写,参数怎么调,在哪翻的车,哪些能直接抄。案例背景:先认识一下拆解对象创作者王琨喆,全网账号"喆FILM",影像行业从业十余年——做过电视新闻,拍过宣传片和商业广告。但注意两点:第一,他不是音乐专业出身。整支MV的说唱部分由AI完成编曲和演唱。第二,《过来人》不是他的第一条AI视频。在此之前,他的"古人开麦"系列已经更新了七期——李白对杜甫、李清照对苏轼、诸葛亮对司马懿,让历史人物两两说唱对战。这个系列没爆,但它默默完成了一件比流量更重要的事:攒下了十个角色的"数字资产"。《过来人》本质上是把前七期的角色拉到同一个舞台,做了一次总集结。这个背景很关键——它直接决定了《过来人》制作流程的第一性原理:角色一致性。十个古人要在几十个镜头里保持同一张脸、同一身衣服、同一种气质,这是AI视频最容易翻车的地方,也是这条生产线最值得学的地方。流程全拆:五个步骤,完整还原第1步:内容策划——人先定骨架,AI再长肉很多AI创作翻车,翻在第一步就搞反了顺序:丢给AI一句"帮我写一首古人说唱",然后碰运气。王琨喆的做法是反过来的。三件事由人敲定:1. 人物出场顺序。杜甫必须开篇——"一辈子都在搬家"的杜甫,直接对上当下年轻人租房安家的痛感,第一段就要建立"古人在唱我"的代入;2. 核心歌词。每个角色的关键句是人写的,很多来自他自己熬夜改片、被甲方拖欠项目款的真实经历——"歌词里藏着我自己的生活";3. 整体叙事框架。十个角色不是各说各话,而是完成一个递进:先各自倾诉失意,最后齐唱"我是过来人,一千年前揣着和你一样的心"——情绪在结尾合流。AI只负责两件事:押韵和扩写。 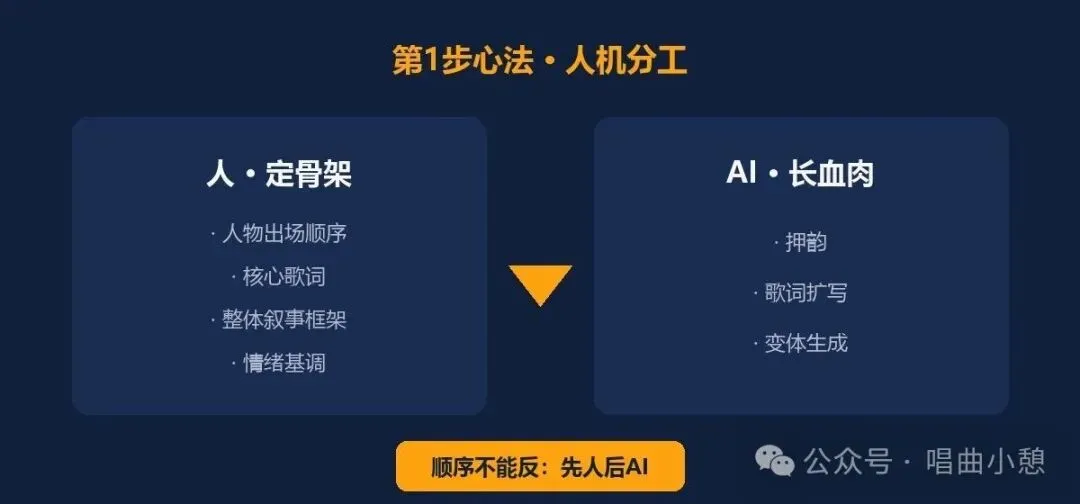
▶ 可复用要点:AI创作的正确分工是"人定骨架(选题、结构、情绪、金句),AI长血肉(押韵、扩写、变体)"。反过来做,产出物就是没有灵魂的流水线产品。第2步:角色资产先行——给古人"定妆"这是整个案例技术含量最高的一步。十个古人不是每次生成时临时捏的。王琨喆使用LibTV平台内置的图像模型(LibImage 2.5),为每个角色单独生成一张"人物资产图"——你可以理解为角色的定妆照存档:杜甫的潦倒感、苏轼的释然、刘邦的草根气,都在这张图上被一次性锚定。 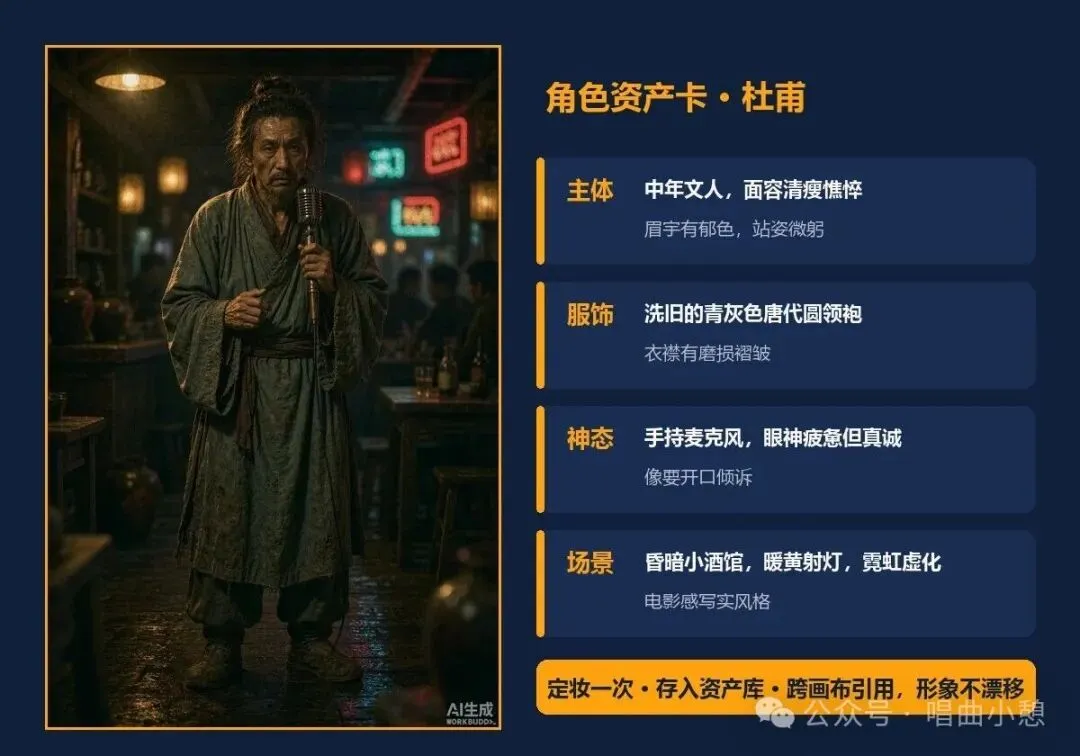
▲ 角色资产卡示意(人物立绘为AI生成)提示词怎么写?创作者在访谈中透露了核心经验:"把提示词写清楚之后,很多时候一两轮就能得到满意的人物资产图,无需大量抽卡。"所谓"写清楚",就是把四个信息层一次说全(以下为根据公开访谈还原的提示词框架示例,供参照改写): 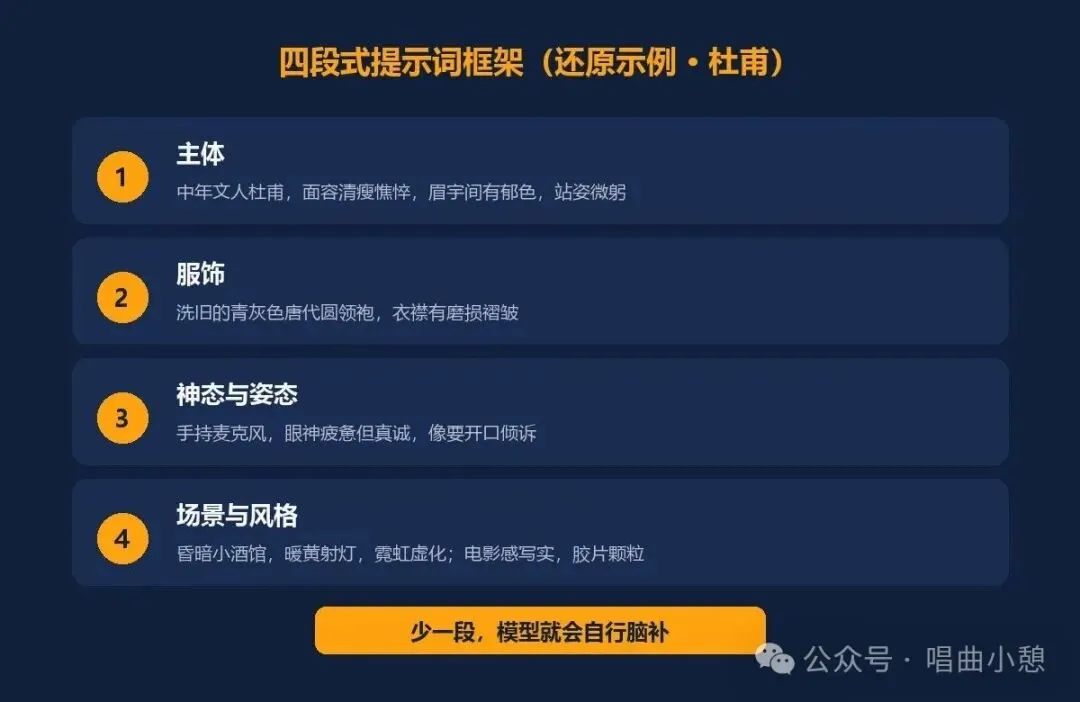
资产图怎么用?生成满意后,存入平台的资产库,后续所有画布直接引用。王琨喆的原话是:"我把前七期的人物资产图定好,保存到资产管理,在下一个画布直接引用就可以了。"不同画布引用同一份资产,角色的脸、服装、气质就不会在镜头间漂移——不用钻研任何复杂技术,"近乎无感"。▶ 可复用要点:角色一致性不靠运气,靠"资产先行 + 引用复用"。主角形象定妆一次、存档一次,之后每个镜头都从同一份资产出发。这是AI内容从"每镜翻车"到"稳定产出"的分水岭。第3步:分镜即指令——图生视频的正确打开方式有了角色资产,接下来把每个镜头"动起来"。王琨喆在LibTV的画布上工作:人物资产图通过节点关系连接到每个镜头的生成任务,图片、声音、镜头素材沿节点组织——他用的甚至只是平台"最基础的画布功能"。这一步的核心心法是:分镜表就是给模型的指令集。每个镜头的提示词包含五个要素: 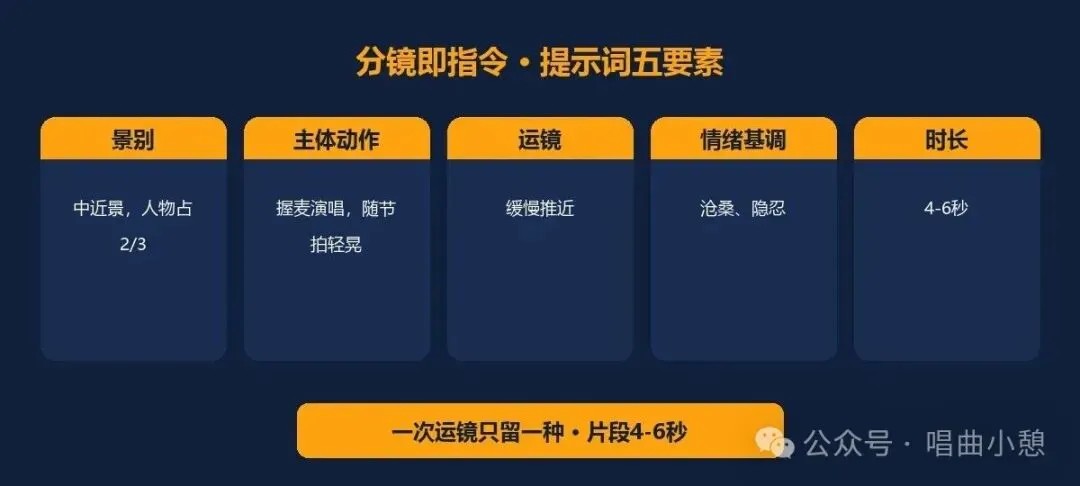
两个实操细节值得划重点:· 短片段策略。一致性会随时长衰减,长镜头是畸变和穿模的重灾区。全片按4-6秒的短镜头生成,最后在剪辑台拼合。· 局部重拍,不推倒重来。某个镜头大部分内容对了、只有一处错了,可以用平台的重拍功能只重做问题片段,"与重新生成整条视频相比,可以节省算力积分"。同一条提示词多跑几版挑最好的,是这个行当默认的交付流程。第4步:音乐与声音——AI解决了九成,剩下一成靠剪辑说唱编曲、每个角色专属的声线定制,由AI完成。但这里必须如实记录一个翻车点:人物演唱时的口型与歌声同步,至今没有完全解决。王琨喆在访谈中承认,部分素材"最终仍需要依靠后期剪辑进行衔接"。换句话说,这条1.3亿播放的视频,也没有魔法。它的做法是:挑选口型问题不明显的生成版本 + 用剪辑节奏把瑕疵镜头剪碎、藏进快速切换的段落里。充沛的情绪叙事掩盖了技术缺陷——这也是全片"镜头剪辑干净简洁"的技术原因之一。 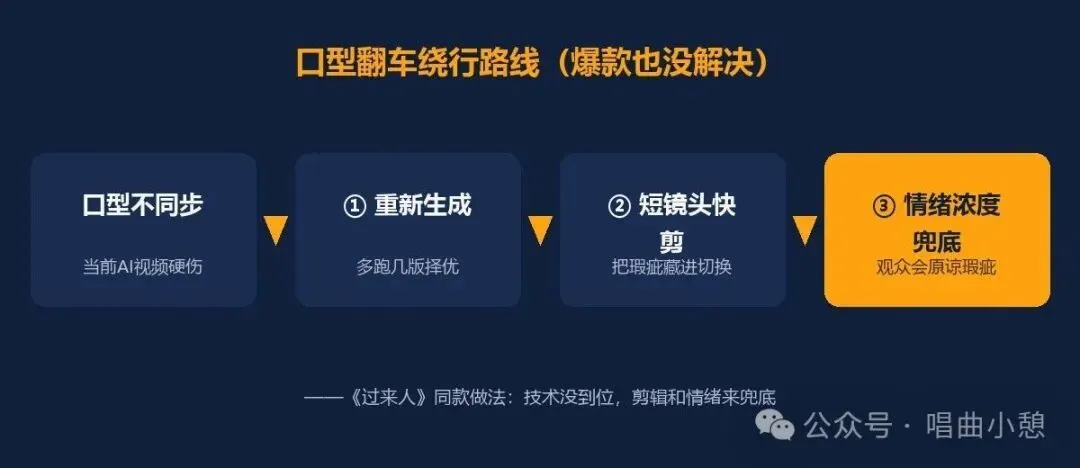
▶ 可复用要点:口型同步是当前AI视频最大的坑。成熟绕行方案:能重生成则重生成 → 修不了就用短镜头快剪掩盖 → 情绪足够充沛时,观众会主动原谅瑕疵。第5步:成片逻辑——每个片段都能单独活下来最后看一眼成片设计:镜头剪辑干净简洁,每一段都设计成可以被单独截取、单独传播的完整情绪单元——杜甫的租房段能单独发,苏轼的失意段也能单独发。这不是审美偏好,是算法适配:短视频平台的分发逻辑偏爱可切片、可二次传播的内容结构。一条1.3亿播放的视频,正是由无数个"百万级切片"累积出来的。流量归因:它为什么能火?技术只解释一半拆完流程,必须回答另一个问题:同样的技术,为什么大量模仿者复刻"古人+说唱"的形式,却几乎全部哑火?1. 古今互文的选题公式。所有角色的唱词都在做同一件事:把古人的人生际遇翻译成当代人的生存困境。杜甫=租房,苏轼=中年被优化,孙悟空的紧箍=房贷和KPI。观众不是在看历史,是在照镜子。2. 平视,不说教。创作者刻意避开居高临下的视角,全片的情绪落点是"我不是来教你,我是来陪你走这一程"。评论区因此变成了树洞——无数网友留言讲述自己的困境,UGC情绪反过来又延长了作品的生命周期。3. 国民级IP零教育成本。十个角色全部来自课本和电视剧,观众不需要任何背景铺垫就能进入情境——注意力稀缺的时代,省下的每一秒解释都是留存。4. 可切片的结构。如前所述,成片天然适配算法分发。一句话总结这个归因模型:技术决定了你能不能把它做出来,选题和情绪决定了有没有人看。这也是模仿者们只抄走形式、抄不走内核的原因——符号可以复制,共情无法照搬。可复用技巧:6条,抄作业专用01 先定骨架再生成|选题、结构、情绪、金句由人敲定,AI只做押韵和扩写——顺序反了,产出即流水线产品。02 角色资产先行|主角形象定妆一次、存入资产库,所有镜头从同一份资产引用。提示词用"主体→服饰→神态→场景"四段式写全,争取一两轮出图。03 分镜即指令|每个镜头的提示词五要素齐全——景别、主体动作、运镜、情绪、时长;一次运镜只留一种。04 短片段拼长片|按4-6秒生成,同提示词跑3-5版择优;能局部重拍就不推倒重来,算力积分和工期都省在细节里。05 给技术缺陷留后路|口型不同步等硬伤,用短镜头快剪和情绪浓度掩盖,不必等工具完美才动手。06 为切片而设计|成片时让每个段落都能独立传播,主动适配算法分发逻辑。一张图总结建议收藏本文的朋友直接保存下面这张图: 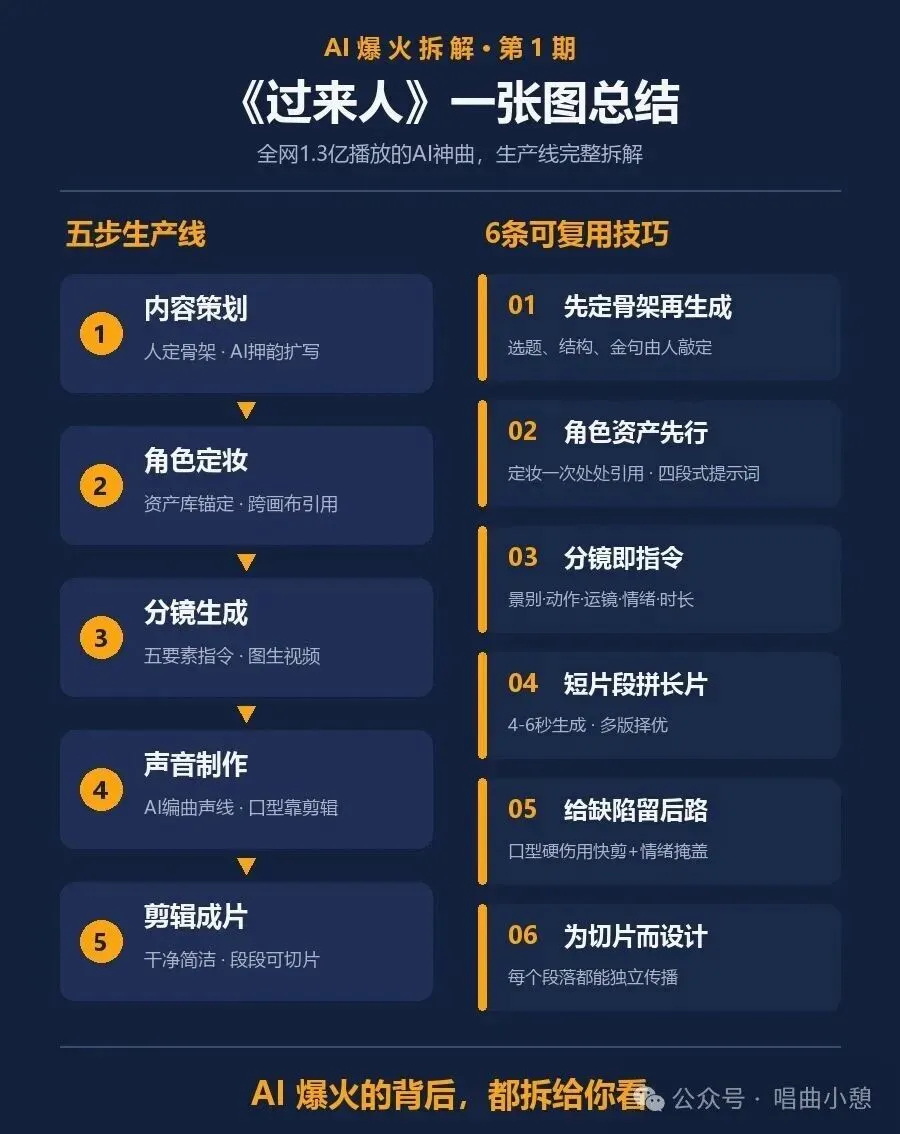
▲长按保存,转发备用下期点菜《过来人》爆火后,出现了大量模仿作,还有女子版的《怕什么》让武则天、李清照、花木兰同台说唱,在小红书获赞超1.3万。但AI爆火的内容远不止这一条:会演情景喜剧的AI猫狗、组团跳《Uptown Funk》的象牙山男团、从选题到运营全由AI包办的B站UP主"DeepSeek鲸鱼娘"……下期拆谁,评论区点菜。— END —数据与制作流程细节来源:中国经营报《AI视频生产进入工作流竞争》、文汇报、AI新榜等公开报道,以及创作者王琨喆的公开访谈;文中提示词为根据访谈还原的框架示例;本文配图部分由AI生成。数据截至2026年11月初。AI爆火的背后,都拆给你看。关注不迷路。