ARTICLE · 1320264
研发文档智能助手落地:当接口文档、运维手册和代码片段学会“互相指路”
研发文档智能助手落地:当接口文档、运维手册和代码片段学会“互相指路”联合检索, RAG, 研发文档治理, 版本差异查询, 交叉验证, 权限管控, 向量数据库, 故障排查,迪飞特科技 
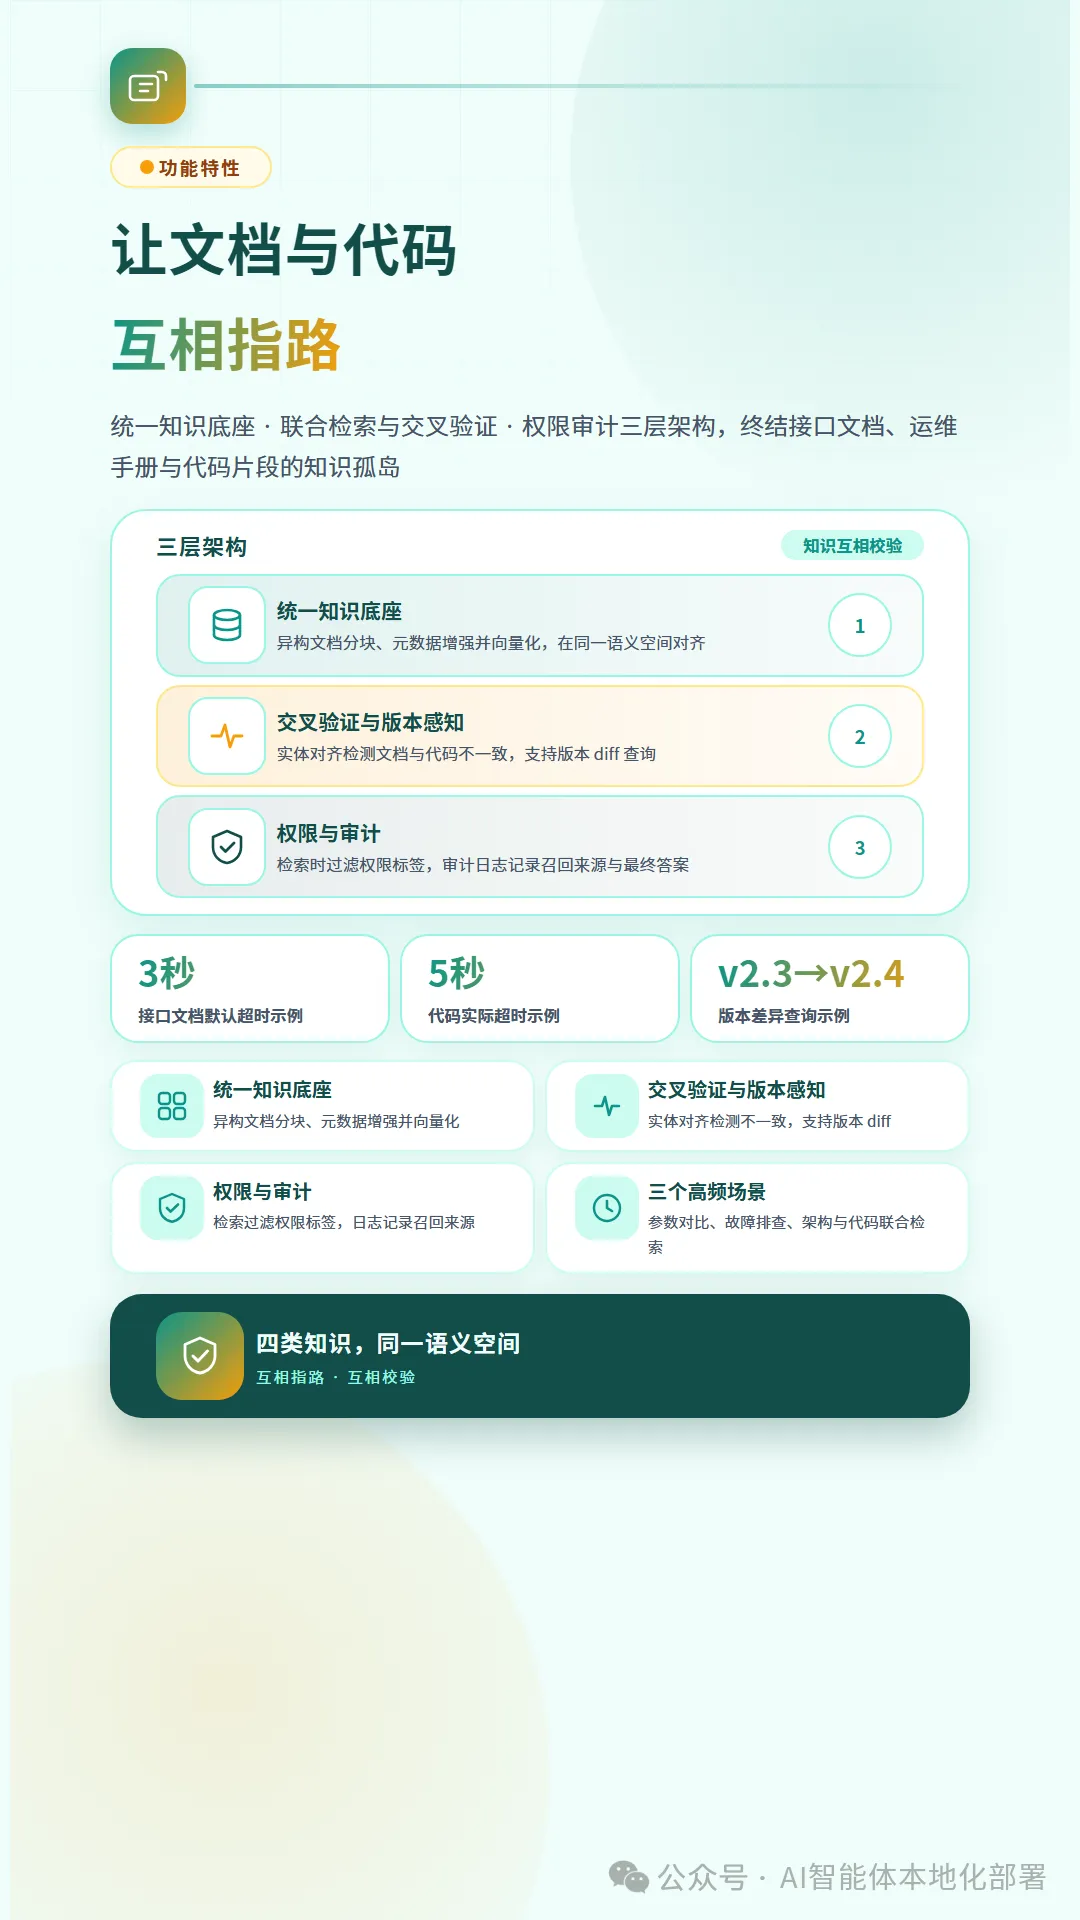
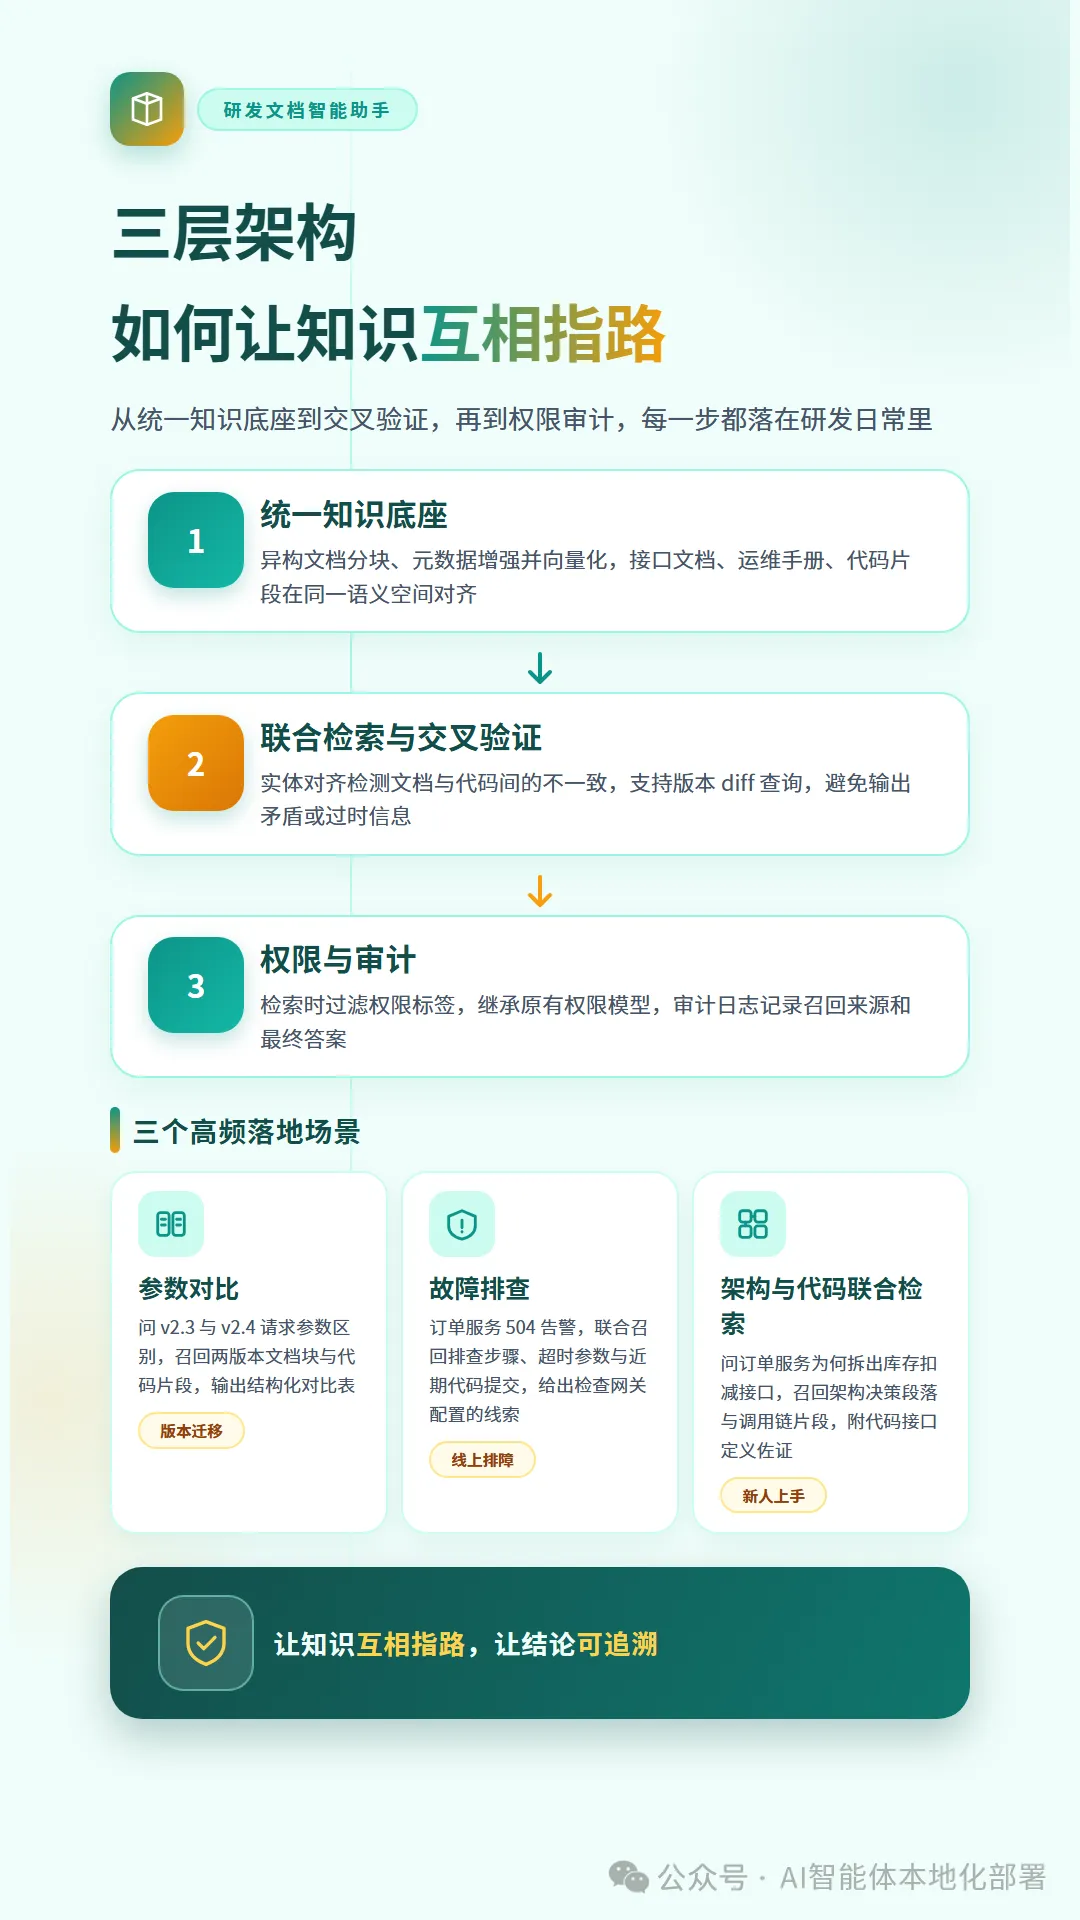
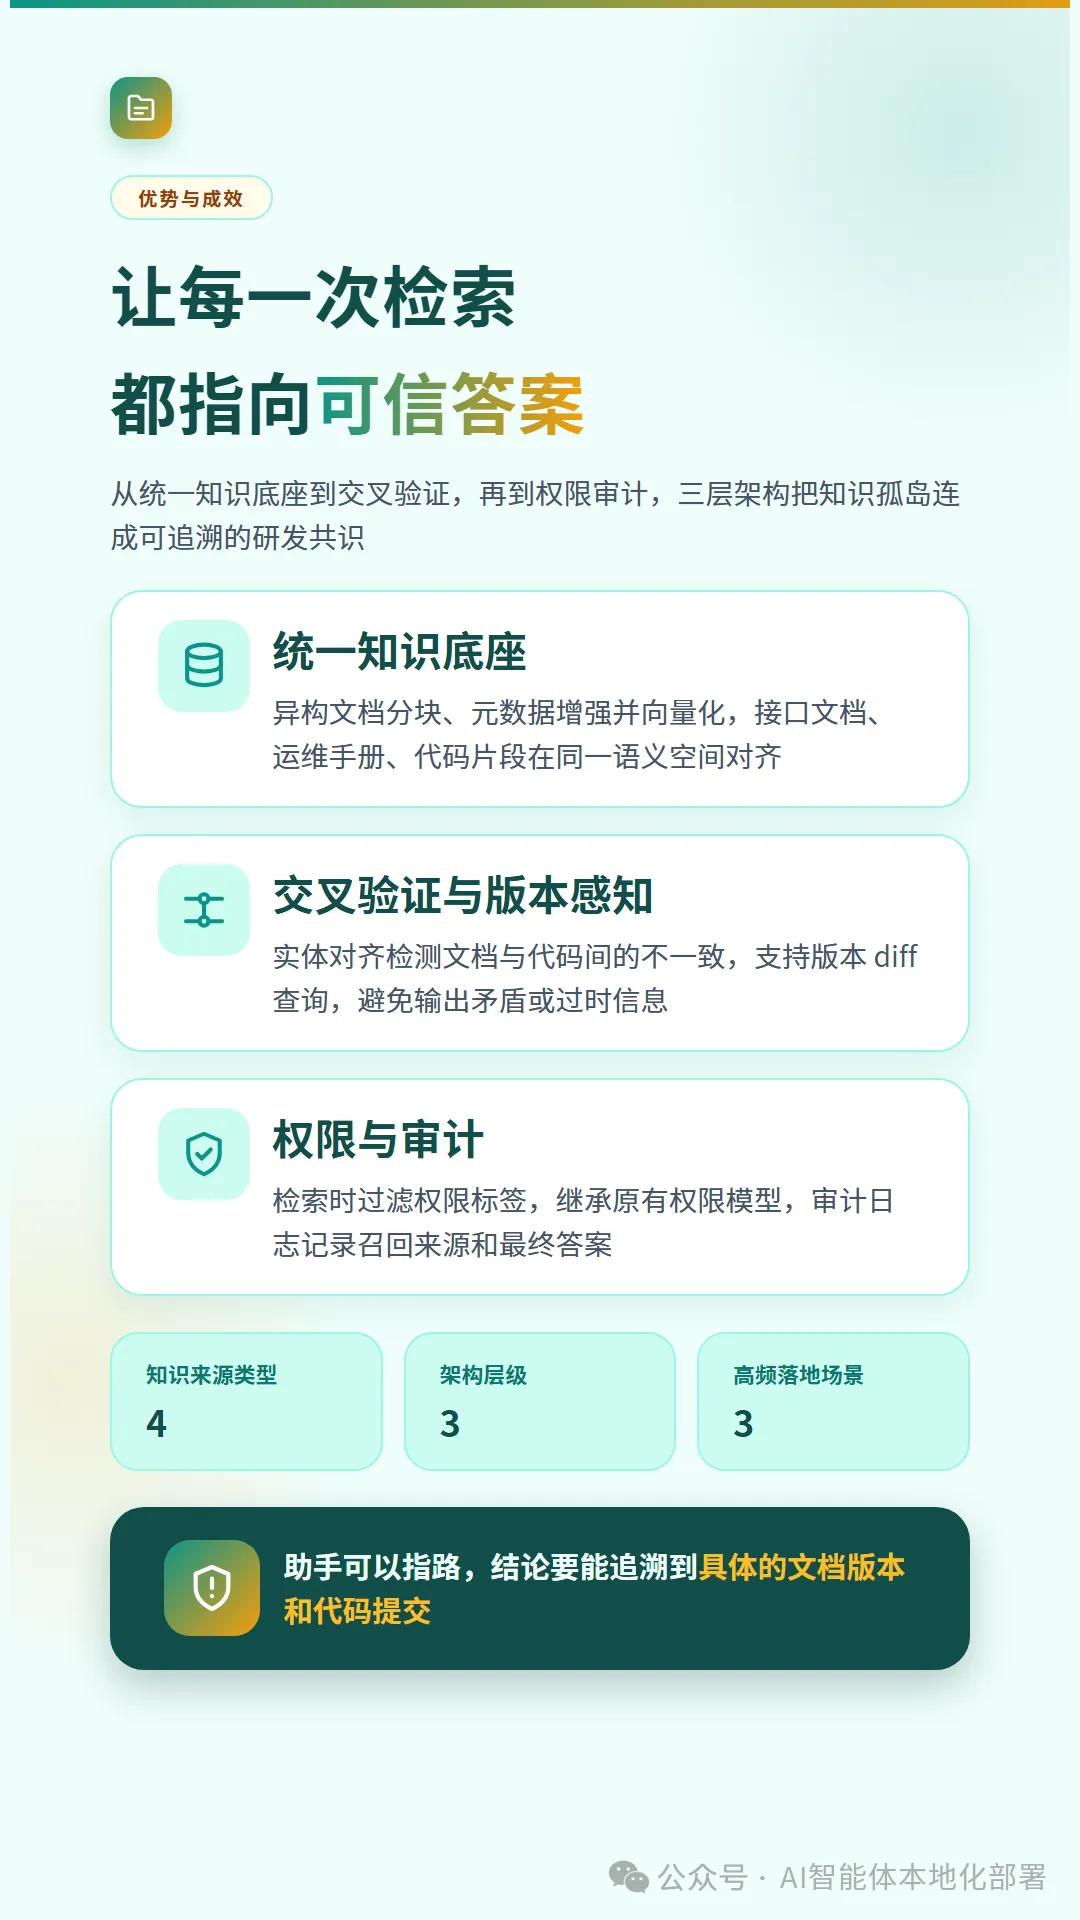
如果你问一个后端工程师“用户登录接口的限流阈值是多少”,他大概率会打开三个地方:API 文档平台搜接口名、运维知识库查网关配置、再翻一下代码仓库里的注解或配置文件。这三者之间没有任何链接,全靠人脑做“联合检索”。 这就是研发团队最典型的知识管理现状:**文档是分层的,但检索是割裂的**。接口文档描述“怎么调”,运维手册描述“怎么部署和排障”,架构文档描述“为什么这么设计”,而代码片段则是“最终事实”。当一次线上故障发生时,运维需要同时理解接口语义、部署参数和代码逻辑,才能定位根因——而这三类知识散落在三个系统里,格式不同、更新节奏不同、权限模型也不同。 传统关键词搜索在这里几乎失效。你搜“超时”,接口文档里叫 `timeout`,运维手册里叫“连接超时阈值”,代码里可能是 `CONN_TIMEOUT_MS`。更麻烦的是,研发文档天然带有**版本属性**:v2.3 的接口参数和 v2.4 不一样,运维手册里的回滚步骤也随版本变化。如果检索系统不感知版本,它给出的答案可能是“正确的废话”——内容本身没错,但对应的是旧版本。 于是问题收敛为:**如何构建一个能同时理解接口文档、运维手册、架构文档和代码片段,并支持参数对比、故障排查、版本差异查询的联合检索系统?** 这就是“研发文档智能助手”要解决的核心命题。 联合检索的前提是“可比较”。接口文档是结构化表格,运维手册是步骤化文本,代码片段是语法树,它们必须先被归一化到同一个表示空间。 工程上的做法是**分块 + 元数据增强 + 向量化**。分块不是简单按字数切,而是按语义边界切:接口文档按“接口名 + 请求参数 + 响应示例”切,运维手册按“故障现象 + 排查步骤 + 回滚方案”切,代码片段按“函数/类 + 注释块”切。每个块附带一组元数据:文档类型、所属服务、版本号、最后更新时间、权限标签。 向量化之后,语义相近的块在向量空间里距离更近。这样搜“连接超时”时,接口文档里的 `timeout` 参数块、运维手册里的“超时排查”步骤块、代码里的 `CONN_TIMEOUT_MS` 常量块会被同时召回——**关键词不同,但语义对齐了**。 这里有一个容易被忽略的细节:代码片段的向量化不能只靠文本。函数名和注释能提供语义,但参数类型、调用关系这些结构信息会丢失。所以成熟方案会做**混合索引**:向量索引负责语义召回,倒排索引负责精确匹配(比如搜具体参数名 `retry_count`),两者融合排序。 单靠向量召回还不够。研发场景里最危险的不是“搜不到”,而是“搜到了但内容矛盾”。比如接口文档写着默认超时 3 秒,代码里实际是 5 秒——这种不一致如果被检索系统原样输出,比不输出更糟。 因此第二层要做**交叉验证**。系统在召回多个来源的块之后,会做一次一致性检查:如果接口文档的参数默认值与代码片段中的常量定义冲突,系统不会直接给答案,而是把两边的内容并列展示,并标注“检测到潜在不一致,建议核对版本”。 这背后的技术是**实体对齐**:把文档里的“参数名”、代码里的“变量名”、运维手册里的“配置项名”映射到同一个实体 ID。对齐之后,系统才能回答“这个参数在三个地方分别怎么描述的”这类联合查询。 版本差异查询也依赖这一层。每个知识块携带版本元数据,检索时可以按版本过滤,也可以做**版本 diff**:把 v2.3 和 v2.4 的接口参数块分别召回,逐字段对比,输出“新增了 `retry_policy` 参数,默认值从 3 改为 5”。这比人工翻两个版本的文档高效得多。 研发文档天然分级:架构文档可能涉及核心设计,运维手册包含敏感配置,代码片段更是权限重灾区。联合检索系统必须继承原有的权限模型,而不是造一个“超级搜索”把权限打穿。 工程上通常采用**检索时过滤**:向量召回阶段就带上权限标签,只召回当前用户有权限查看的块。这比“先召回再过滤”更安全,因为后者可能在排序阶段泄露敏感块的存在性。审计日志则记录每次查询的召回来源和最终答案,满足“可追溯”要求——当有人质疑“为什么助手给出了这个回滚步骤”时,能查到它引用了哪份文档的哪个版本。 **场景一:参数对比。** 前端工程师问“这个接口在 v2.3 和 v2.4 的请求参数有什么区别”,助手召回两个版本的接口文档块和对应代码片段,输出结构化对比表,并标注哪些差异在代码中已生效、哪些文档尚未更新。落地效果是版本迁移的沟通成本显著下降;局限在于,如果代码仓库没有打版本 tag,代码侧的版本对齐会不准。 **场景二:故障排查。** 运维收到“订单服务 504”告警,问助手“最近哪个变更可能影响订单服务超时”。助手联合召回运维手册的排查步骤、接口文档的超时参数、以及近期代码提交中涉及超时配置的片段,给出“检查网关 `upstream_timeout` 是否被 v2.4 的配置变更覆盖”的线索。效果是把跨系统翻找变成一次查询;局限是它只能“指路”,最终确认仍需人工执行命令。 **场景三:架构文档与代码的联合检索。** 新成员问“为什么订单服务要拆出独立的库存扣减接口”,助手召回架构文档的设计决策段落和相关代码的调用链片段,给出“为了隔离库存热点、支持独立扩缩容”的解释,并附上代码中的接口定义作为佐证。这解决了“架构文档说了但不知道对应哪段代码”的常见困惑。 研发文档智能助手的本质,不是“更聪明的搜索框”,而是**把接口、运维、架构、代码四类知识放进同一个语义空间,让它们互相指路、互相校验**。它的技术底座是统一分块与向量化,核心价值在交叉验证和版本感知,底线是权限与审计。 落地时最大的坑往往不在模型,而在数据治理:文档版本元数据缺失、代码仓库 tag 不规范、权限标签不统一,都会让联合检索退化成“看起来什么都能搜、实际什么都不敢信”。所以务实的选择是先治理元数据,再上检索。 展望下一步,联合检索会向“可执行的排查”演进——不仅告诉你“查这个配置”,还能在授权范围内直接拉取当前配置值与文档默认值做对比。但无论走多远,那条底线不会变:**助手可以指路,但结论要能追溯到具体的文档版本和代码提交**。