ARTICLE · 1325922
AI Agent 时代,如何保持批判性思维?
AI Agent 时代,如何保持批判性思维?最近读了一篇博客,主题是:AI Agent 越来越能干的今天,人该如何保持批判性思维。读完我最大的感受是,这几乎就是我们日常工作的真实写照。 博客里有个观点特别戳我。过去讲批判性思维,是教人面对新信息时保持好奇,也保持健康的怀疑,多换几个视角,最后形成自己的判断。这个定义当然没有过时,但放在 Agent 工作流里,已经不够用了。今天的问题不是信息太少、需要辨别,而是模型越来越强,给出的答案来得太快、太顺、太像真的。我们越来越相信、越来越信任模型的答案,渐渐放松了警惕,也慢慢失去了自己的判断。 作者说得很直接:他并不反对 Agent,他自己就是 Agent 的重度用户。他写这篇文章,是想提醒那些已经把大量工作交给 Agent 的人:判断力的流失往往悄无声息,我们要主动、刻意地留意这个过程,在日常工作中时刻保持警惕和审视。这句话我读了好几遍。结合自己这段时间的工作体验,下面我想围绕三个问题展开:我们为什么会在 AI 面前慢慢放弃批判性思维?这种放弃是怎么一步步发生的?我们又能做些什么? 先说一个我最近遇到的场景。 我们的系统依赖另一个系统,业务提了一个接口兼容的诉求。对方让 AI 生成了一份方案,直接丢过来让我们照着改。我打开一看,字段定义没写清楚,有哪些枚举值、每个值代表什么,都没有。我去问,对方自己也没看过,只知道“这是 AI 生成的”,就转发了过来。 这不是个例。有一次评审需求,产品给了一个比较理想化的目标,AI 生成了一堆功能点和技术点,看起来挺完整。仔细一看,却完全没有业务逻辑可言:它要求检查某个事项,可这个信息从哪来?怎么检查?规则是什么?一概没有,基本是天马行空。 更常见的是:业务问技术一个问题,技术觉得可以让 AI 处理,于是把 AI 的回答或方案直接转给另一位同事跟进。可他自己理解了多少?看过里面的字段、枚举和边界条件吗?不一定。 这些事让我很不舒服,甚至有点烦。你会发现,AI 把“产出”变得极其便宜,但“理解”并没有跟着变便宜。产出可以转发,理解、责任却不能。可现实中,很多人已经把“转发 AI 的产出”当成了“完成工作”。 博客把这种现象拆成了三个层次,我觉得非常准确。 作者把人和 AI 的关系看成一个光谱,从上到下分三层。 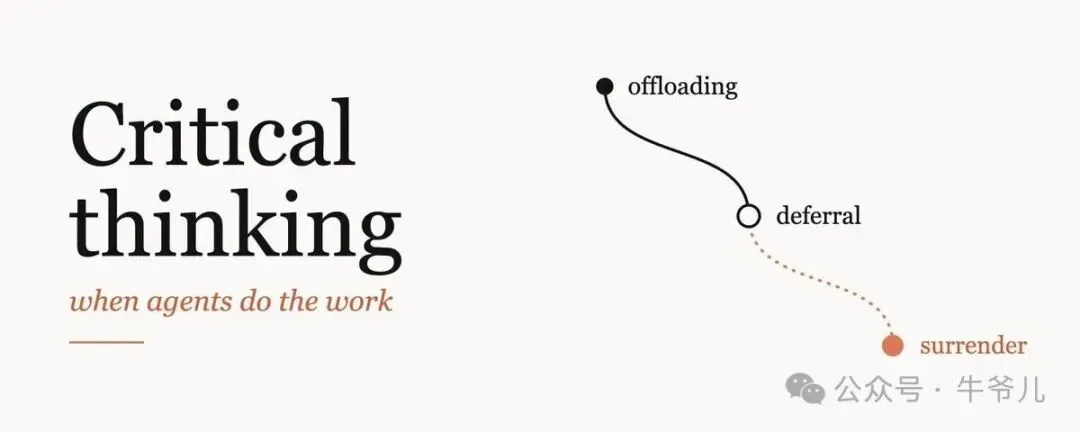
最上面一层叫认知卸载。你把任务委托给 AI,但保留对结果的所有权:它干一部分活,你知道它在干什么,你会看、会判断、会负责。作者说他整天都这么干,也应该这么干。这是健康的协作。 中间一层叫认知依赖。AI 的输出成了你的新输入,你把它当作下一步思考的起点。注意,这时它已经不再是一个“假设”,而是你思考的材料。你会想“它说得应该差不多”,然后顺着往下走。 最下面一层叫认知投降。AI 的输出直接变成你的输出,你觉得没必要检查,也不再区分“它说的”和“我判断过的”。作者认为“投降”这个词非常贴切。信任越来越多,或者人越来越懒,就会慢慢往下滑。 最要命的是,这个下滑很难察觉。每一步都很渐进,看起来都很合理:上一个回答你认真读了,下一个就只扫一眼;再下一个只看骨架;再往后,连骨架都不看,只看它说“完成了”。直到有一天,有人问你某一行是什么意思,你答不上来,哪怕有 Agent 帮你,也答不上来。 到这一步,所有权已经交出去了。 作者说,认知投降就是认知债务积累的方式。平时完全看不见:代码库看起来很干净,测试也都通过了。直到你要改这个系统,才发现没有人真正理解它。这就像只读了一本书或一份规格说明的目录,就在上面签了字。当下没什么问题,但总有一天,债务会到期。 这个比喻太真实了。AI 时代最大的风险,不是 AI 做错了什么,而是它做对了太多,以至于我们不再练习“看懂”这件事。 博客里提到:过去,大量的思考和判断发生在“提出问题”和“得到答案”之间的那段空间里。现在,这段空间被压缩到了几秒钟:你问,它答。Agent 用得越多,这段空间就越小。模型越强,明显的错误越少,很多输出看起来既完整又正确,根本不会让你想再看第二眼。 这段话我深有体会。 一年多前,我们还能在 AI 写的代码里挑出不少问题,甚至是实现逻辑上的问题。现在模型越来越强,只要把需求描述清楚,它基本都能完成开发。问题变成了另一种:它的技术方案有时会特别复杂。你只想改一条数据,一行脚本就够了,它却可能给你整出一套架构。这时候,你当然得想办法检查它的结果。 可很多时候,它一口气写了几千、几万行,或者你同时推进好几个项目,根本没有精力逐项 review。最多只能在交代任务时,把技术选型和架构上的倾向告诉它。等它做完,想完整看懂它的代码逻辑,信息量已经远远超出了人日常能处理的范围。 于是出现一种很微妙的状态:你本想盯着 Agent 的输出,结果看着看着就放弃了。模型越强,你越放松警惕,越来越少地 review 和把控代码。毕竟它写出来的东西,很多时候正是你想要的,甚至比你自己写得还好。你慢慢不再质疑,不再评价,放任 AI,最后完全信任它的结果,或者至少 90%、99% 地信任。 这种现象,在我们的日常工作中已经出现了。 作者也强调,他并不是在要求不可能的事。对一个大型代码库始终保持完整的心智模型,本来就做不到。据说 Claude Code 团队就是按需重建理解的:需要理解某一部分时,就让 Claude 解释那一部分,而不是记住所有细节和逻辑。作者认为,理解其实比大多数工程师想象的更容易“恢复”。你不需要时时刻刻掌握全貌,只要能在需要时局部重建它,并且知道自己随时可以做到。 这个观点很重要。它不是让我们回到每一行都亲手写的时代,而是说:你可以不一直懂,但不能失去“随时能懂”的能力。两者差别很大:前者是分工,后者是投降。 比代码 review 更让我担心的,是需求传递过程中的理解真空。 没有 AI 的时候,业务流程再复杂,产品、技术、测试也会坐下来一起聊。聊完之后,开发对业务逻辑的理解是非常清晰的。有时候回过头来,产品自己都说不清某个逻辑了,开发还能答上来。 现在呢?需求可能是 AI 写的。里面要什么,人未必完全把控过,甚至没有完整看过一遍,也不确定跟业务真正想要的是否一致。AI 可能把一个需求写得过于简单;业务人员直接让 AI 生成需求文档,甚至直接生成技术方案,然后这份东西就一路往下传。 我见过一个比较极端的例子。有人负责一个电商财务结算相关的项目,说“我一天就搞定了”。真的一天就搞定了吗?他本身并不理解业务逻辑,他却自以为比业务人员还懂业务。可你真去问他,完全不是那么回事:他跟你聊的是这个怎么实现、那个字段是什么、表长什么样、接口该叫什么。这些是技术层面的问题,不是业务层面的。最后前前后后折腾了快两个月,才算真正搞定。 所谓“一天”,在我看来只是把 Demo 写出来了。你真的理解业务吗?做出来的东西符合业务要求吗?上线之后怎么运营,考虑过吗?很多人只管上线,后续运营完全没人管。现在已经有不少项目,变得完全无法维护。 这背后还有一个更深的问题:如果开发也“投降”了,业务逻辑就真的没人说得清了。产品答不上来,技术也没法直接给出答案,只能让 AI 去代码里找逻辑,再把 AI 的输出贴给对方。可 AI 找出来的一定准确吗?不一定。你不认真核对,它很可能一本正经地胡说。有些模型(特别是豆包)事后会说“抱歉,我弄错了”,但错误已经发生了。Codex 这类工具也有类似的问题:它对项目的全局理解有限,你给的提示词和上下文也未必完整,它可能会胡编,而你根本分辨不出真假。 这是我认为最值得警惕的地方:当 AI 成为业务逻辑的“解释器”,而人又不再验证这个解释器,组织就会失去对系统的真实理解。代码还在跑,测试也还是绿的,但没有人能真正回答“为什么是这样”。 作者说,Agent 工作流是令人愉悦的,而且越来越快、越来越顺。忙碌的一天里,得到一个大体正确的答案,是很提神的。可也正因为如此,我们才容易放松警惕。卸载、依赖、投降,是一条非常顺滑的坡。 还有一个因素:人天生乐观。布鲁克斯在《人月神话》里就说过,程序员往往会过于乐观地估计一件事。到了 AI 时代,这种乐观被无限放大。很多人,尤其是过于信赖 AI 的人,会觉得任何需求两三天就能搞定。真是这样吗?做出来的东西符合业务要求吗?上线后怎么运营,想过吗?往往没有。 更深一层是:AI 的输出越来越“像样”。格式漂亮,语气自信,结构完整。作者说,现在产出的东西个个格式规整、信心满满,“精致”本身已经不再是有用的信号。以前看到一份排版工整、逻辑清晰的文档,你会觉得对方下了功夫;现在,它可能只是 AI 三秒钟的产物。精致不等于正确,完整不等于理解。 所以,问题不在于我们突然变懒了,而在于环境变了。以前信息稀缺,你必须学会辨别;现在答案过剩,你必须抵抗“顺着走”的引力。批判性思维,从一种面对信息的姿态,变成了一种需要主动强加给自己的纪律。 作者说,每当他不确定自己到底怎么想时,就会回到一张基本问题清单:我怎么知道自己在做正确的事?怎么知道解决方式是对的?有没有证据支持我的结论?怎么判断什么时候算完成?说到底,就是 who、what、where、why、when、how。写下来看着有点幼稚,但它会逼你去思考那些本来会忽略的方面。而现在,人们太容易跳过这一步,直接问 Agent:“你觉得我该怎么做?” 在此基础上,他给出了一组 Agent 时代的新问题,我觉得每一条都值得抄下来。 第一,在提问之前,我有没有先形成自己的假设?在任何不简单的任务上用 Agent 之前,先写下你认为答案可能是什么,哪怕只是在脑子里想一想。猜错了没关系,有了新信息随时可以改。但一旦先读了 AI 的回答,你就很难再想象别的可能了。这一点我特别认同:先有一个假设,哪怕很粗糙,你在 AI 的输出面前也有了一个参照物。 第二,如果完全没有头绪,就主动问自己的盲区。有研究者把这种做法叫作“盲点通行证”:把你已知的信息交给模型,让它帮你找出那些“不知道自己不知道”的东西。不是问“给我一个方案”,而是问“基于这些信息,我可能忽略了什么?” 第三,我是在让 AI 帮我思考,还是在让它替我思考?两者都可以,但你得清楚自己在做哪一种。帮我想,是我保留判断;替我想,是我交出判断。很多人嘴上说的是“帮我想”,实际做的却是“替我想”。 第四,什么情况下这个结论会是错的?想清楚之后,去验证它。模型自己说“我很有把握”,远不如你实际跑一个测试有价值。所以,给它一个测试。 第五,我有没有认真听过反方的论证?当你在一个开放问题上立场很坚定时,让不止一个模型去论证你的反面,再看它们的输出,形成自己的观点。这会多花些时间,但你对这个问题的理解会深入得多。这个做法很聪明:不是让 AI 证明你是对的,而是让它来攻击你,看你的观点扛不扛得住。 第六,我敢不敢当着要维护它的人的面,为它打包票?这一条适用于代码,也适用于任何交付物。作者把这叫作“可回答性”标准:你交付的东西,要能站在维护者面前说清楚,它为什么是这样、边界在哪、可能在哪里出问题。如果你不敢,就说明还没准备好交付。 博客里关于验证的讨论,是我觉得全文最实用的部分。 作者说,他最近写了很多关于验证的内容,因为他相信,工作的重心已经从“写代码”转向了“确保你是对的”。给 Agent 提供验证手段,比如端到端测试、单元测试、与真实应用的交互,它就能围绕关键测试自己改、自己看、自己再跑。也有人认为,让 Agent 能够验证自己的工作,是取得好结果最关键的因素之一。与其逐行阅读,不如把这些证据建立起来,然后 review 证据。 但验证也可能是“投降式”的。“有没有证据支持我的结论”,被悄悄换成了“测试是不是绿了”。Agent 让写测试变得非常便宜,于是你看到满屏的绿色。可一个通过的测试,可能和它要验证的功能犯了同一个错误:测试本身就是按错误的理解写的,当然能通过。而且一个绿勾只能证明一个属性,我们却很容易以为它证明了全部。 所以,当一项检查变绿时,要问两个问题:它确认了什么?它没有验证什么?而且要在事前就定义清楚,因为到了事后,你会接受任何结果。 作者说,Agent 工作的终点应该是具体的东西:测试结果、截图、日志、调用链追踪。这样,“做完了吗”就是一个事实问题,而不是“看起来好像做完了”。收到一份完成的设计时,先别看总结,先看它执行了哪些命令、得到了什么输出。这一点我很有共鸣。现在我看 AI 的输出,除了看结论,也会花更多精力看模型的思考过程,因为有些偏差,只藏在思考过程里。 还有一条:让模型自我批判,作为一次 sanity check,值得固定进流程,每次都做,而不是想起来才做。作者说,他最后总会问一句:“我是不是漏了什么?”听起来很傻,但经常有效。用前沿模型做复杂功能时,这么一问,它往往还能再补充两三点。所以他每次都问。 这让我想到,还可以让模型根据自己的输出出题,考它自己,也考我们。博客里提到一个习惯:让 Claude 写完报告后在末尾附一份测验,规则是“只有我全部答对,才 merge”。这个做法很好。让 AI 出题考你,是检验自己是否真正理解的一种低成本方式。 博客里有一段讲代码 review,读来非常扎心。 作者说,Agent 交给你一个 600 行的 PR,你大概看看结构,不会逐行读。变量名看着合理,测试也过了,于是你点了批准。可就在中间某处,藏着一个不起眼的改动:一次事务边界的调整,一个你从没想过的边缘情况,你没有看到。结果呢?你只 review 了你本来就知道的东西。 写代码和 review 代码是两种不同的技能,关注点也不同。而我们正在把 review 变成盖橡皮图章。所以,要像这段代码不是 AI 写的那样去读 diff,然后越过 diff,看 Agent 都替你决定了什么。在一段很长的会话里,它会替你做许多小决定:默认值怎么取、哪些不在范围内、两个需求冲突时选了哪一个。这些都不会出现在“一切顺利”的总结里。所以,让它把做过的决定和假设都列出来,然后考考自己:随便挑几行,问问“这一行是干什么的?那一行呢?”如果是文档,就合上它,试着凭记忆写出主要观点。 这个建议非常具体。我们平时看 AI 的输出,最容易看的就是总结。可总结是 AI 写给你的总结,它会把很多判断藏起来。真正的 review,是看清它替你做了哪些决定,然后问自己:我同意吗? 作者把写出好的 prompt 视为一种批判性思维能力。我一开始有点意外,仔细一想,非常对。 他说,过去你提出一个含糊的请求,对方会追问你,你才意识到:等等,我其实没想清楚。可 Agent 通常不会拦住你。它会自己把你留下的空白补上,交回一个看起来已经完成的东西,尽管背后的想法依然模糊。他把这叫作“意图的缺失”:那些隐含的目标、约束和理由,往往只存在于你没写下来的地方。和其他信息不同,这一部分没有人能替你补上。意图,必须来自你自己。 你的 prompt,反映的是你对问题的理解。如果你没法把它说清楚,很可能是因为你脑子里也没想清楚,写明白了才能说明你理解了。所以,在求助之前,先用自己的话写一份简要说明:给谁用、哪些不在范围内、怎样才算完成。如果追问了两轮还是不到位,就别再追问了,回去重写你的 prompt。 他还引用了 Andy Clark 的一个区分:把工作委托给 AI,和与 AI协作。协作是一个相互促进的良性循环:你的 prompt 让输出更精准,输出让你下一个 prompt 更精准,而你自己的心智模型也随之变得更清晰。一次会话结束时,如果你对问题的理解比开始时更清楚了,那就是成功的标志。 此外还要留心输入的来源。Agent 很容易把上一个 Agent 的总结直接放进自己的上下文,几轮下来,已经没有哪个 Agent 读过原始文档了。你需要对输出保持自己的立场。 这让我想到,很多人把 AI 当成许愿池:扔进去一个模糊的想法,期待捞出一个完整的答案。但真正高质量的协作,是你先把自己的意图想清楚,把约束讲明白,把“什么叫完成”定义好。写清楚 prompt 的过程,就是逼自己把问题想清楚的过程。这本身,就是批判性思维。 作者并不主张事事亲力亲为。有些事情出错的代价很低,完全可以交给 AI。比如他最近录课程,要从三家差不多的酒店里选一家做录制地点,没时间逐条看评论,就把这个决定交给了 AI。结果不错,下次他还会这么做。但涉及怎么投资、如何给孩子职业建议、工作上该做什么、哪些改动会影响哪些用户、一次发布是否安全,这些事他不会交出去。 他的原则是:在出错代价低的地方放手;在别人要为后果买单的地方,保留判断。 这个原则很清晰。不是所有事都值得你花时间 review,但你必须清楚,哪些事不能完全交出去。关键系统的决策,你仍然要把控,至少要能理解。而这依靠的,是你原本设计方案的能力:你要能看懂 AI 给出的方案,以及它的实现。 他还提到一个概念,叫“编排税”:Agent 生成的东西,和你愿意放心署上自己名字的东西,两者之间的差距。如果产出的速度超过了你消化的速度,再多开几个会话也没用,先把这个差距补上:收紧检查,让需要你亲自过目的东西少一些。当你产出的东西超过了你能背书的范围,你就不是在 review,而是在祈祷质量自己出现。人的心智模型依然存在,只是不在中间,而在两端:前端是任务描述和上下文,后端是对输出的 review。这也正是好的输入对输出质量如此重要的原因。 博客最后给了一些日常练习,不必全做,挑适合自己工作流的就好。 比如,每周不用 Agent 写一点代码,或者亲手做一件“要是忘了怎么做就糟了”的实际工作,他称之为“校准练习”。每个月,写下那些你已经不再亲自做的事,再想想其中哪些是你真正愿意放手的。他早年一篇博客里的问题,今天依然适用:如果 AI 不存在,你会有多迷茫? 这一点对我触动很大。核心的编程能力、系统设计能力,还是要定期做一些“古法编程”“古法设计”。这是保留判断力的方式:想要有判断力,就必须做这些事。遇到超出自己理解的东西,就去学会它。作者举例说,写作时碰到一个陌生的概念,他本可以搜一句解释直接贴进去,但他更愿意花点时间研究,真正弄懂它,知道它应该放在哪里。认真检查机器的产出,本身就是实实在在的工作;假装它不是,团队最终就不会去做。检查不是免费的,所以要把它排进日程,才会真正落实。 你不再练习的技能会消退,而且可能比你想象的更快。保留那些你不愿放手的能力。 作者说,对任何一项任务,要在多大程度上信任 Agent,本身就是一个判断。你需要不断校准,也要算清 review 的成本。Anthropic 自己的研究也提到一个悖论:过度依赖 AI 可能会侵蚀编码能力。而对你最重要的一些问题,再好的模型也替你回答不了:你在构建什么?为什么值得做?它会影响谁?你愿意为此放弃什么?Agent 可以陪你把这些问题过一遍,但答案终究是你的。 你可以委派工作,甚至委派很多检查,但不能“逃避”责任。 这句话是整篇博客的题眼。 我们当然要继续用 AI,而且要用得更深。Agent 让验证变得便宜,让产出变得便宜,也让大量重复劳动变得便宜。但便宜不等于无主。最后把东西交出去的人,仍然要能说:我理解它,我验证过它,我愿意为它负责。 所以,AI Agent 时代的批判性思维,不是拒绝工具,也不是回到手写每一行代码,而是有意识地协作:知道自己处在光谱的哪一层;保留“随时能懂”的能力;在低风险处放手,在高风险处守住判断;先看证据,再看总结;在让 AI 替你思考之前,先问问自己:我到底怎么想? 工具越强,判断力越珍贵。而判断力,只能靠我们自己练。
一、一个越来越常见的场景
二、卸载(offload)、依赖(deferral)、投降(surrender):判断力是怎么一点点交出去的