ARTICLE · 1331092
别急着让 AI 总结:长 PDF 最容易漏掉的是中间
你手里有一份 100 页的 PDF。
可能是保险合同,可能是招标文件,也可能是一份你根本不想逐字看完的政策汇编。
你把它拖进 AI,打了一行字:“帮我总结一下重点。”
三十秒后,它给你一份结构整齐、条理清楚的摘要。你松了口气,觉得这活儿干完了。
先别急。
我不是说它一定错。我是说:这类活有 5 个坑,没人提前告诉你。踩中任何一个,你拿到的都不是摘要,是一份“看起来很对的误解”。
我做了 15 年开发,跟文档、格式、数据打过不少交道。这篇不教你怎么挑工具,只讲你在按下“上传”之前,该知道的 5 件事。
先说一句总纲:AI 读 PDF,难的不是“读”,是“读得对”。
把 100 页压成 500 字,它很擅长。难的是:这 500 字里,哪一句是原文说的,哪一句是它自己补的。
下面这 5 件事,都是围绕这一个问题。
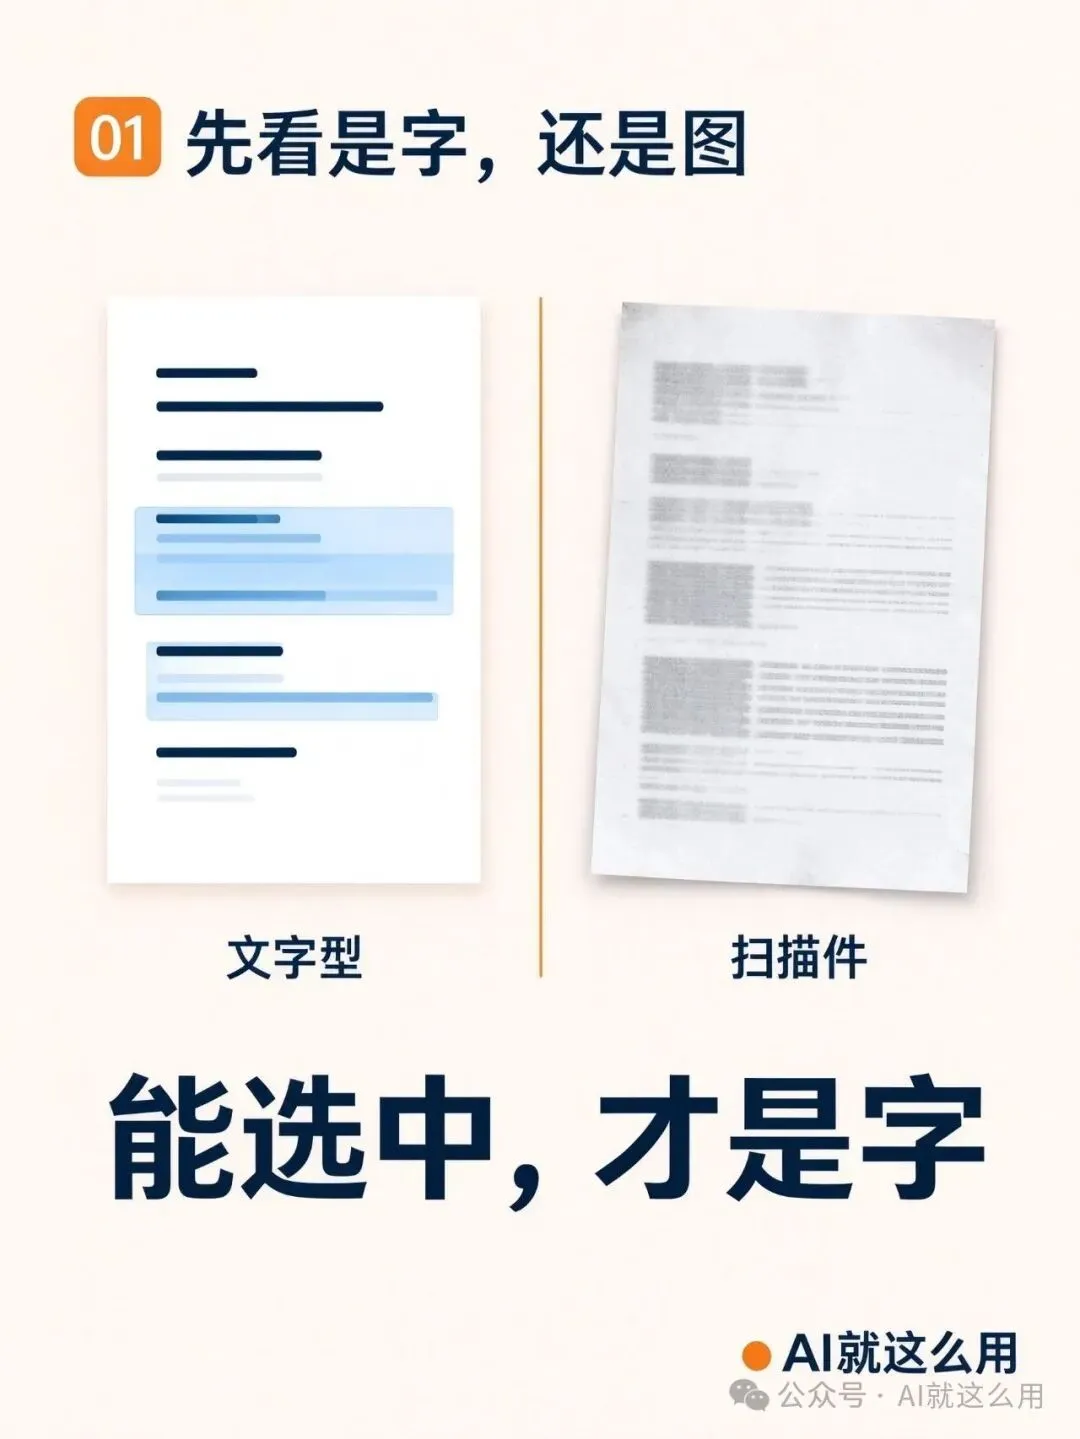
01 先确认:这份 PDF 是“有字”,还是“有图”
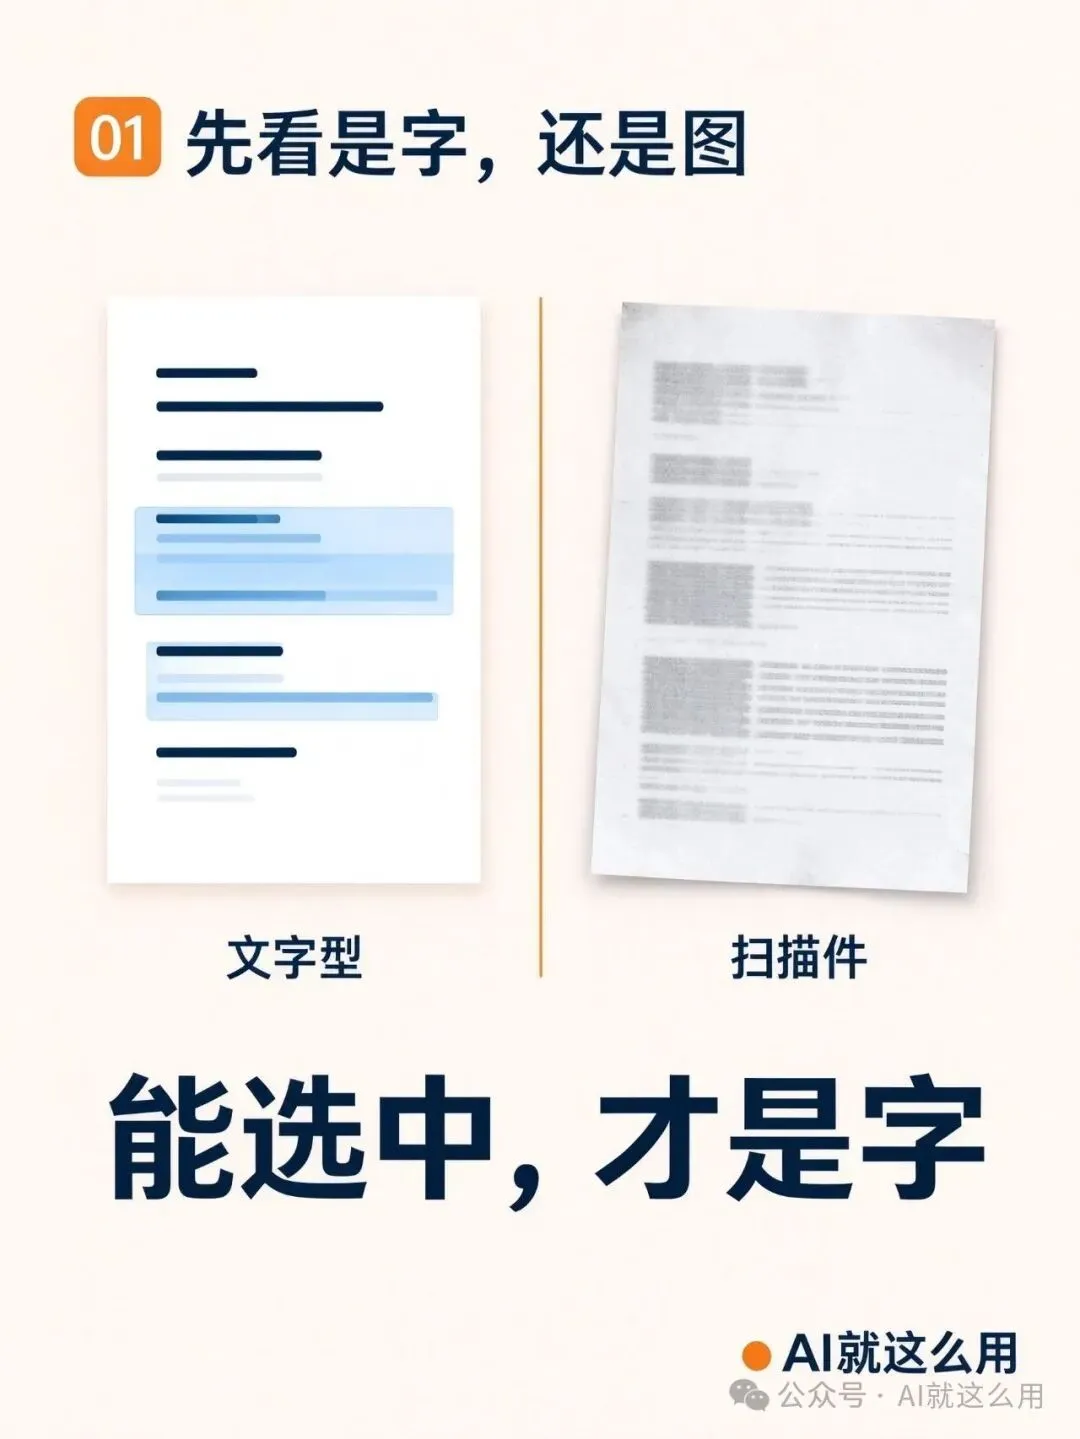
左边能选中,右边只是一张图——这一步就决定了后面所有结论。
PDF 看起来是一个格式,其实更像一个纸盒子。盒子里装的可能是文字,也可能只是每页拍了一张照片。
前一种,你能选中、能复制、能搜索;后一种,你看着有字,其实那只是一张图——文字层是空的。
区分方法很简单:打开 PDF,Ctrl+A 全选。能选中大段文字,就是文字型;只能选到一片空白,或者干脆框不出来,多半是扫描件。也可以直接搜索一个你确定文中出现的词,搜不到就要警惕。
如果是图片型,得先做 OCR(文字识别),把它变成文字,再交给 AI。
但 OCR 不是万能的。印刷体一般还行;手写、印章、表格线、低分辨率扫描,错误率会明显上升——尤其是数字,小数点错一位,后面全错。
一句话:AI 读不了“照片里的字”。先把它变成字,才谈得上读得对。
02 别一次全喂:100 页会“读头读尾,漏中间”
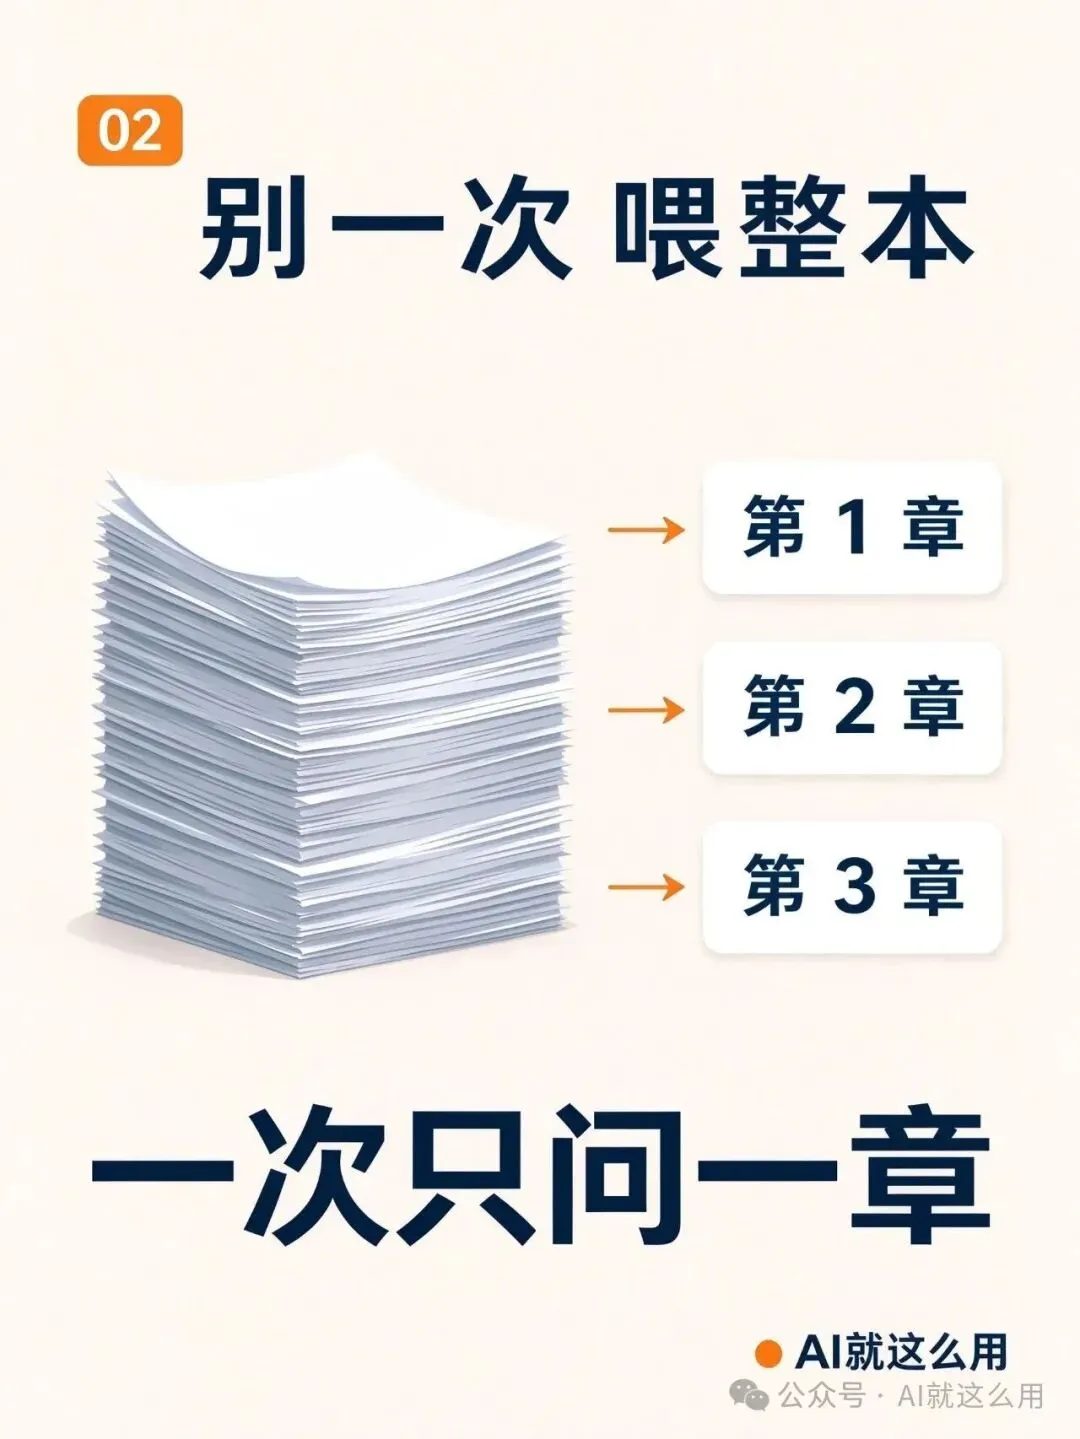
厚的是同一份文件,拆开之后才问得清。
模型一次能处理的长度有上限。这个上限各家不一样,也会变,你不用记具体数字,只要知道:它一次看不完 100 页。
看不完怎么办?两种处理:截断,或者切块。
截断就是后面的内容它根本没看到。切块是把文档切成很多段,按你的问题去检索最相关的几段——这就像你只翻了书里几个章节,段落之间的关系、前后文的限定条件,很容易丢。
实践中,最容易被漏掉的是中间。开头有目录、有摘要,结尾有结论,这两头它抓得最准;真正藏在中间的那些条件、例外、适用前提,反而最容易消失。
比较稳的做法是四步:
先让它读目录,把章节列出来。这一步很便宜,也最能暴露它到底读没读到。
一次只给它 10 到 20 页,或者一次一章。
一次只问一个问题。别把“总结重点、对比差异、给建议”塞进同一句话。
真要跨章节对比,先让它逐章做小摘要,再拿摘要做对比,而不是让它一口气读全本。
一句话:不是“喂整本”,是“按章节查”。
03 表格和多栏排版,是提取的重灾区
PDF 里的表格,没有真正的“行列结构”,只有一堆文字和它们的位置坐标。
提取的时候,程序是按阅读顺序把文字拼起来的。于是常见这几种错:
数字串行:这一行的金额,跑到下一行去了;
列错位:数量列的数字,被读成金额列;
合并单元格丢失:本来跨三行的类别,只剩第一行有;
双栏排版被拼成一句:左边一栏的最后一行,接上了右边一栏的第一行。
图表更麻烦。柱状图多高、折线在哪拐弯,这些信息在文字层里根本不存在。视觉模型能“看”图,但让它读具体数值,可靠性要打个问号。
所以:
表格别让它从 PDF 里“读”,单独截图,或者从原始 Excel 导出;
关键数字,一律回原表核对;
图表只让它描述趋势,具体数值自己看。
一句话:文字能读,表格要盯,图表别指望。
04 它会非常自信地编页码、编条款
它给的页码像真的,但真的假的,只能回原文里找。
这是 5 条里最危险的一条。
模型并不“知道”第几页。页码是它根据上下文生成出来的,而且格式往往特别像真的:“第 37 页第 2 款”“详见附件三第 4 条”。
在合同、法规、政策、论文这类材料里,编错一条的代价,可能是钱,是合规,是一个站不住的结论。
我办失业金那回,北京、长春、哈尔滨三地的政策文件加起来几十页,光是“哪一条适用于我”就够绕。这种活 AI 能帮上忙,但它给出的“第几条”,我一定回原文核——因为各地口径本来就不一样。
可以这么做:
要求它每条结论后面附“原文原句 + 页码或章节标题”,缺一个都不算;
明确告诉它:“找不到原文就写找不到,不要推测。”这句话很管用;
自己抽 3 条,用 PDF 搜索原文,逐字对一遍。
一句话:没有原文出处的结论,不算结论。
05 上传之前,先问一句:这份文件能不能“出门”
上传,意味着文件离开了你的电脑,进了第三方服务器。
它会不会被留存、留多久、会不会用于改进模型,各家政策不一样,而且会变。你签过的用户协议,未必是你以为的那份。
先看看手里的文件属于哪一类:
身份证、护照、银行卡、户口本;
体检报告、病历、检查单;
工资单、劳动合同、个税材料;
客户名单、供应商报价、未公开的财报;
源代码、投标文件、公司内部制度。
这些不只是“隐私”问题,还有“义务”问题:公司文件可能签过保密协议,个人信息处理也有法律要求。传出去容易,收回来难。
比较稳的做法:
先分级:这份文件能不能公开?不能,就别直接传;
必须用,就脱敏:删姓名、证件号、金额、联系方式;
只截相关的那几页,别整本上传;
用公司允许的工具,或者有企业版、本地部署方案的;
拿不准的时候,宁可不传。
一句话:先想“这份文件泄露了会怎样”,再决定传不传。
06 把这 5 件事排成一个顺序
这 5 条不是并列的,是有先后的。顺序反了,后面的功夫全白费。
第 1 步,看文字层。能选中吗?不能,先 OCR。
第 2 步,看页数。超过 20 页就拆:先目录,再分章。
第 3 步,看结构。有表格、图表吗?单独处理,关键数字回原表。
第 4 步,看用途。要引用、要签字、要担责吗?每条要原文出处,抽查 3 条。
第 5 步,看敏感级。能不能公开?不能就脱敏、截页,或者换工具。
很多人是一上来就问“帮我总结”。问题在于,第 1 步就没过,后面的总结再漂亮,也是建在沙子上。
写在最后
回到开头那份 100 页的 PDF。
AI 能不能帮上忙?能。它能把“找重点”从三小时压到十分钟,这一点不用怀疑。
但它给你的是“候选答案”,不是“标准答案”。最后那一步——回到原文,确认这句话真的在那一页——只能你来。
这也是这个号一直在说的事:AI 可以替你干得快,不能替你担责任。
四篇写下来,地基差不多打好了:为什么做这个号、先想清楚让 AI 做什么、哪些用法值得留、怎么把一份长文件读对。
下一篇,我想换个方向:不讲“该怎么用”,讲“我踩过的坑”。
有用,就留下;没用,就直说。
快,是工具给的;对不对,是你担的。