ARTICLE · 1349411
从文档到模型:SysML v2 与系统工程知识载体的范式迁移
从文档到模型:SysML v2 与系统工程知识载体的范式迁移
序章 工程知识由什么承载
一切复杂系统的悲剧,往往不是从设计错误开始的,而是从知识无法被准确承载开始的。人类建造飞机、航天器、核潜艇、新一代作战系统,本质上是在一条漫长而脆弱的知识链上作业:需求从用户流向系统工程师,架构从系统工程师流向分系统设计师,详细设计流向制造与验证,最终所有的承诺、假设、权衡与限制,都必须以某种形式固定下来,供数千人在数十年间读取、解释、修改与兑现。固定的形式是什么,决定了这条链上的每一次交接会损失多少信息,也决定了错误的传播速度与变更的边际成本。
工程史上,知识曾经由三种载体接力承载。第一种是图纸。在绘图板时代,几何就是设计的最终真理,图纸既是法律也是语言,公差、配合、材料都靠它传递;但图纸只能表达"是什么",几乎无法表达"为什么"与"将会怎样"。第二种是文档。二十世纪中叶以后,随着系统工程的兴起,规范(specification)、接口控制文件、试验大纲、评审报告取代图纸成为权威事实的载体,自然语言加上示意图,构成了一部可以无限膨胀的"系统宪法"。第三种是模型。模型不是文档的电子化,而是一种全新的知识编码:结构、行为、需求、约束被组织成可查询、可计算、可验证的数据结构,机器可以解释它,人可以理解它,工具可以消费它。
这三种载体并非简单地依次取代,而是在很长时期内并存、纠缠。直到今天,绝大多数工程组织的事实源头(authoritative source of truth)仍然是文档,模型只是文档的插图。真正的问题由此产生:当系统复杂度越过某个临界点,文档这种载体的信息容量、一致性保持能力和变更响应速度,都会触及物理性的天花板。文档不是写得不够好,而是作为一种知识编码方式,它已经走到了结构的极限。
这本书所记录的对象,是系统工程知识载体从文档向模型迁移的过程中,最关键的一次技术事件——系统建模语言(Systems Modeling Language, SysML)第二版的诞生。它由对象管理组织(Object Management Group, OMG)主导,历经近八年(2017—2025)的起草、评审、试点与定稿,于2025年7月获得最终采纳,同年9月以正式规范出版。表面上,这只是一次建模语言的大版本升级;实质上,它是系统工程界对"工程知识应当如何编码"这一根本问题的一次集体回答。
要理解这次回答为什么必须以"推倒重建"的方式给出,必须回溯四十年:看文档范式如何成就了现代工业,又如何在复杂度面前暴露出结构性的裂痕;看第一代系统建模语言如何以妥协的姿态诞生,又如何把它的妥协写进了债务;看一群工程师与学者如何用八年的时间,把一门语言从"画图工具"重铸为"知识基础设施"。叙事将沿着一条清晰的线索展开:先认识旧载体,再认识第一次模型化尝试,然后认识它的成就与天花板,接着认识重写的决策与内核,最后认识这一技术事件如何被嵌入全球工业的数字工程转型之中,以及它预示的、关于工程本身认知方式的深层变化。
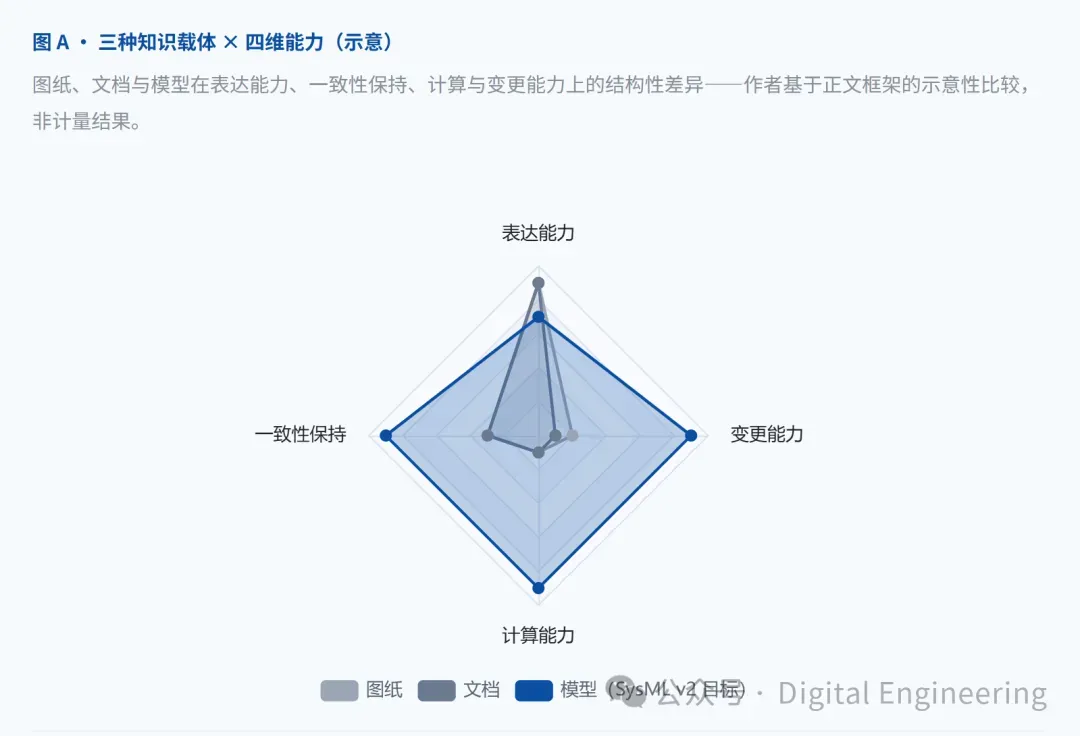
这里需要先建立一个分析工具,即"知识编码"的视角。任何工程知识载体,都可以从四个维度评估:表达能力——它能表达哪些类型的事实;一致性保持能力——它在规模扩张时维持内部自洽的能力;计算能力——机器能否直接消费它完成推理、仿真与验证;变更能力——知识发生变化时,更新的成本与波及范围。图纸在几何维度上表达力极强,但一致性、计算与变更能力都很弱;文档在表达力上近乎无限,但一致性靠人工、计算为零、变更是灾难;模型在四个维度上理论上都有优势,前提是它的语法与语义足够精确、交换与集成的通道足够标准。SysML v2 的全部努力,可以归结为让"模型"这个载体在四个维度上同时达到工业级水准。而一门建模语言的标准化,之所以是一项值得动用全行业力量的事业,是因为语言是一种公共基础设施:它的价值不取决于某个组织的使用水平,而取决于整个生态的采纳广度与互操作深度。这正是理解后续所有技术细节的前提——我们不是在谈论一款软件产品的升级,而是在谈论一种知识载体的公共标准的确立。
为了不在这部纪程中迷失于技术细节,这里先交代它的三层叙事结构。第一层是技术层,回答"语言如何被设计":从元模型、语义、文本化到 API,每一处设计决策都对应着前一章所述的具体负债。第二层是制度层,回答"标准如何被制定、被采纳、被迁移":OMG 的 RFP 机制、SST 的开源式协作、工业界的双模过渡,都是知识载体迁移中的制度创新。第三层是认识层,回答"这改变了什么":当模型成为权威事实源,工程组织的权力结构、知识管理方式乃至工程师的思维方式都会随之改变。三层叙事相互支撑:不理解技术层,就看不懂制度层的选择;不理解制度层,就误判认识层的进程。这部纪程的目标,不是提供一份 SysML v2 的使用手册,而是让读者对"系统工程知识载体正在发生的历史性迁移"形成完整、可检验的理解。
第一章 文档范式:黄金时代与结构性极限
一、一部由文档驱动的工程史
在模型成为工程话语的中心词之前,现代工业的工程质量是由一套极其精致的文档制度保证的。以美国国家航空航天局(NASA)为例,其项目评审体系将系统的生命周期切成若干里程碑节点——系统需求评审(SRR)、初步设计评审(PDR)、关键设计评审(CDR)、飞行就绪评审(FRR)等——每一次评审的输入与输出,都是一组以自然语言写就的文档:需求基线、设计说明书、接口文档、验证矩阵、风险清单。评审委员会依据的是一份份签字的"事实",而"签字"意味着某个人对某份文档所描述的状态承担了个人责任。制度上,这形成了知识权威性与可追溯性的双保险;操作上,它把工程的"当前真相"定义为一组文档的当前版本。
这套制度并非偶然。它的深层逻辑是:工程知识必须被形式化为某种"可审查的对象",而文档是历史上第一种能够同时满足人类可读、可存档、可签署、可追溯、可分发这五项要求的知识载体。图纸做不到可追溯,数据库做不到可签署,只有文档做到了。正因如此,文档范式与二十世纪下半叶的工程组织制度(配置管理、基线管理、独立评审)深度耦合,构成了现代大型工程的运行底座。直到今天,航天领域的大量手册与程序文件——例如NASA各中心的项目审查手册——仍然以文档为唯一权威载体,其中的评审门径、成熟度矩阵、签审流程,本质上都是文档范式的制度结晶。
以NASA的评审制度为例,可以清晰地看到文档范式的运转方式。NASA的《NASA项目与计划管理要求》(NPR 7120.5)把项目生命周期划分为若干阶段,每个阶段之间设置形式化的评审关口:系统需求评审(System Requirements Review, SRR)、初步设计评审(Preliminary Design Review, PDR)、关键设计评审(Critical Design Review, CDR)、飞行就绪评审(Flight Readiness Review, FRR)等。每一次评审,由独立于项目组的常设审查委员会(Standing Review Board, SRB)主持,委员会依据一套成熟度矩阵(涵盖技术、进度、成本、风险等维度)逐项核对文档证据——需求是否齐备、设计是否闭合、验证是否覆盖、风险是否受控。在评审文化中,"事实"的含义就是"文档所记录并经过签署的内容";签字的权威性来自程序,而非内容本身。这套制度保证了大型项目在几十年的生命周期里不失控,其历史功绩不应被低估;但它也把"工程真相"与"文档状态"焊死在一起——模型的地位再高,只要评审程序还要求文档证据,文档就仍然是事实源。这一制度惯性,是后续一切范式迁移都必须正面处理的结构性阻力。
然而,文档范式的黄金时代同时也是它结构性极限的孕育期。这个极限有三个层次。
二、一致性的熵
第一个层次是一致性问题。一个大型系统项目会产出一批体量惊人的文档:需求文档可能上千页,接口文档按系统数量倍增,验证矩阵覆盖数万条条目。这些文档在逻辑上必须相互一致——需求文档中的一条指标,必须在设计文档中有所落实,在接口文档中有对应定义,在验证矩阵中有对应条目。但自然语言没有能力保证这种一致性:同一个概念在不同文档里可能使用不同的措辞,同一个数值可能在不同章节里发生漂移,一次需求变更可能只修改了源头文档而遗漏了下游文档。工程界对这种现象有一个无奈的经验法则:文档的一致性依赖人工维护,而人工维护在大规模下必然失效。
更深刻的问题在于,文档是"原子化"的。信息的粒度是"一份文档"乃至"一段文字",而不是"一条需求""一个接口""一个状态"。当工程师需要回答"这个接口的变更会影响哪些系统状态"时,他必须人肉扫描若干份文档,在自然语言中检索关联。这种检索的成本随文档规模线性乃至超线性增长,而复杂系统的接口数量、状态数量、约束数量是按指数增长的。于是出现了一个奇特的悖论:系统的物理复杂度在增长,而人类能够有效驾驭的文档复杂度却在下降。这正是"文档爆炸"的实质——不是页数变多了,而是页数与理解力之间的缺口在扩大。
三、从描述到执行的鸿沟
第二个层次是描述与执行的鸿沟。文档是描述性的:它描述系统应该是什么样,却无法让系统"运行"起来。工程师用自然语言写下"当温度超过阈值时,系统进入降级模式",这句话无法被任何机器直接解释,无法被仿真器执行,无法被形式化验证工具检查,也无法自动与试验数据比对。所有后续的工程活动——仿真、分析、验证、试验——都必须由人把文档中的描述重新解释成另一种形式(仿真模型、分析脚本、试验工况),每一次重新解释都是一次信息损耗与错误注入的机会。
这个鸿沟在传统工程中是可以忍受的,因为系统迭代慢、变更少、物理原型昂贵但可控。但在数字时代,系统迭代速度加快,软件与机电系统深度耦合,物理试验成本高企,工程界越来越需要一种"可以先在数字空间里完整运行一遍"的知识载体。文档恰恰无法承担这个角色:它生来是给眼睛看的,不是给机器执行的。
四、系统级精度缺失:数字工程报告揭示的峡谷
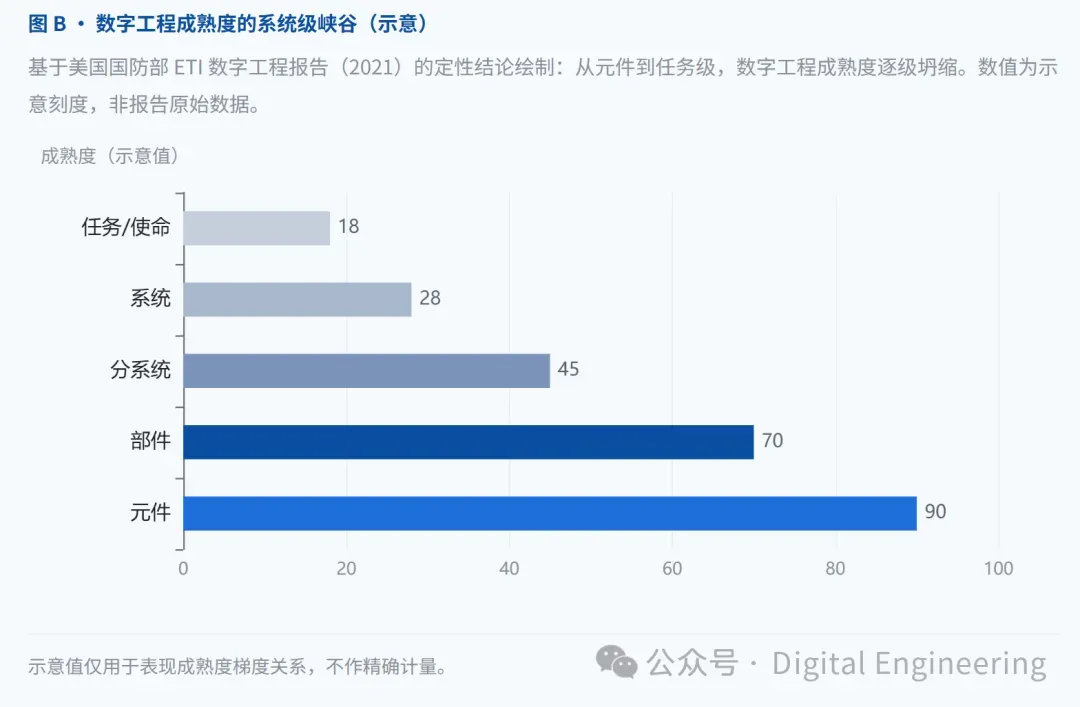
第三个层次,也是最具战略性的层次,是系统级的精度缺失。2021年,美国国防部委托的"工程创新工具"(Engineering Tools for Innovation, ETI)团队发布了一份面向国防部的数字工程(Digital Engineering, DE)报告,给出了一个发人深省的判断:数字工程成熟度在电子元件层级已经相当高——芯片设计有完整的EDA工具链,部件级仿真、验证、数据管理均已成熟;但在系统与任务层级,数字工程成熟度急剧下降,几乎停留在人工文档作业的水平。报告用一张"数字工程成熟度曲线"直观地展示了这种断层:从元件到分系统再到系统,最后到任务级,成熟度逐级坍缩,仿佛工程能力在一道看不见的峡谷面前被拦腰截断。
这个峡谷的成因,正在于系统层级的工程知识没有统一的数字载体。元件级有成熟的领域工具(电路仿真、结构分析、热分析),但系统级缺乏把这些领域模型组织起来的"主干"。文档无法成为主干,因为它不可计算;零散的仿真模型也无法成为主干,因为彼此没有一致的语义。系统工程界需要的是一个能被所有领域工具共同消费、又能在语义上统一它们的核心表示——这正是后来SysML v2要填补的位置。
文档范式的极限,本质上不是写作能力的极限,而是知识编码方式的极限。当系统复杂到一定程度,把知识编码成自然语言段落,就像用散文来记录数据库事务:每一个句子都可能是正确的,但整体的一致性、可查询性、可执行性荡然无存。工程界需要一个转折点,而这个转折点的思想准备,早在系统工程学科诞生之初就已埋下。
五、规模的实证:文档爆炸的数字
文档范式的极限不是理论推演,而是有实证数据支撑的。现代大型工程项目的文档规模早已超出任何人的阅读能力:一架先进民航客机的系统级需求以数千条计,加上派生需求与验证条目可达数万条;一个大型国防项目全生命周期的文档总页数以百万计。INCOSE 曾反复引用一个发人深省的对比:系统工程师用于"理解系统"的时间,正在被"维护文档一致性"的时间大量挤占;而在需求-设计-验证链条上,最昂贵的返工恰恰发生在"文档之间的不一致被发现"的时刻——往往要等到集成、试验甚至交付阶段。波音公司在787项目上的经验、空客在A380项目上的教训,都在不同层面上印证了同一规律:系统的物理集成成本,最终要由知识的集成成本买单。当知识的载体无法支撑集成时,集成错误就以工程灾难的形式显现。文档范式在"承载知识"上的成功,与它在"集成知识"上的失败,是一枚硬币的两面——这正是系统建模运动兴起的历史逻辑。
六、文档范式的合理内核:它为何不会消失
指出文档范式的结构性极限,并不意味着文档一无是处。恰恰相反,文档范式延续至今,是因为它拥有模型范式尚未完全接管的合理内核。其一,文档是合同的载体:在采办与供应链关系中,"需求基线"和"接口控制文档"具有法律效力,签字即承诺;这种法律责任无法被"模型文件"直接承担,需要制度设计把模型与合同义务衔接起来。其二,文档是责任的可追溯记录:评审委员会对"某人在某时刻对某状态负责"的记录,构成了工程组织的问责基础;模型的变更历史若要替代签审记录,必须有同等的不可抵赖性。其三,文档是低门槛的共识媒介:自然语言可以被任何利益相关方(包括非技术管理者、用户、监管方)直接阅读,而模型要求阅读者具备建模素养;在知识普及之前,文档承担着"人人可读的公共界面"功能。
因此,范式迁移的正确表述不是"用模型消灭文档",而是"用模型作为事实源,文档退化为模型的派生视图"。当文档可以由模型按需生成、随模型自动更新时,文档的合理内核(合同、问责、可读)得以保留,而它的结构性缺陷(一致性漂移、变更失效、不可计算)被模型消除。这一定位——模型为源、文档为视图——是理解 SysML v2 全部设计(尤其是视图与视点机制)的一把钥匙:v2 不是要废除文档文化,而是要给文档文化一个可以自动保鲜的源头。
第二章 模型化的黎明:从系统工程学到 SysML v1
一、系统工程学科与"模型"概念的苏醒
系统工程(Systems Engineering)作为一门学科,兴起于二十世纪五十至六十年代的大型国防与航天项目。它的核心命题是:面对由多个分系统、多个专业领域(机械、电子、软件、热、电磁)共同构成的整体,如何保证整体功能与性能目标的实现。传统上,系统工程的方法是过程性的:通过需求分析、功能分解、架构综合、验证确认等阶段性的活动,辅以文档化的输出,把"整体"分解为"可管理的部分"。
但过程性的方法有一个致命弱点:它依赖人的记忆与文档的漂移来维持整体的一致性。早在1960年代,就有工程师指出,系统工程的本质不是管理过程,而是管理"关于系统的知识"。1969年,国际系统工程学会(INCOSE)的前身组织成立,1990年INCOSE正式组建,系统工程的学科化由此加速。进入九十年代,两个思想潮流开始汇合:一是面向对象分析与设计(Object-Oriented Analysis and Design)在软件领域成熟,统一建模语言(Unified Modeling Language, UML)于1997年被OMG采纳为国际标准,软件工程第一次有了标准的建模符号体系;二是系统工程界开始意识到,软件工程那种"以模型为核心、以工具为支撑"的做法,同样适用于硬件与系统的整体。
这里需要澄清一个关键概念。所谓模型(Model),在工程语境下不是指物理样机或数学公式,而是指对系统某方面特性的、形式化的、可被计算机处理的表示。建模语言(Modeling Language)则规定了这种表示的语法与语义:语法决定"能画出什么形状、写出什么符号",语义决定"这些形状与符号意味着什么"。UML之所以成功,是因为它把软件系统的结构(类、对象、接口)与行为(状态、活动、交互)形式化为一套标准的图形符号与元模型(Metamodel)——即"关于模型的模型",它定义了模型元素(如类、状态)的种类及其相互关系。
二、从 UML 到 SysML:一次有意识的减法
系统工程师们很快发现,UML 的很多概念是软件专用的(如类、继承、组件、部署节点),而系统工程真正需要的很多概念(需求、参数、物理连接、接口、约束)在 UML 中并不存在。2001年前后,以洛克希德·马丁(Lockheed Martin)为代表的工业界开始游说 OMG 与 INCOSE,希望在 UML 的基础上扩展出一门"面向系统工程的建模语言"。经过数年的论证,2003年,OMG 与 INCOSE 联合发布了"UML 用于系统工程"(UML4SE)的提案征求书(Request for Proposal, RFP)——RFP 是 OMG 制定标准的法定程序,它向业界公开征集满足特定需求的规范草案。2006年,SysML 1.0 的草案提交,2007年9月,OMG 正式采纳 SysML 1.0。
SysML v1 的诞生本身就是一个组织与产业协作的样本。主导其制定的是以洛克希德·马丁为首的一批工业界与工具厂商组成的提交团队——弗里登塔尔当时正是洛克希德·马丁的系统工程专家,后来被称为"SysML 之父";IBM、Eclipse 等工具生态紧随其后提供实现。语言发布后,最早的工业级试点几乎同步展开:NASA 的"猎户座"(Orion)载人飞船项目在2005至2007年间就尝试以 SysML 模型支撑系统需求与架构定义,洛克希德·马丁在多个国防项目中建立了企业级建模规范。SysML 1.0 之后,语言本身以约两年一个版本的速度迭代——1.1、1.2、1.3、1.4、1.5、1.6——并于2017年以 ISO 19514:2017 的身份成为国际标准,最终版本 1.7 于2024年6月被 OMG 采纳。这种"先有标准、再有生态、后有制度"的路径,是系统工程语言第一次完整走通的标准化闭环。
SysML v1 的设计哲学可以概括为一个著名的公式:UML 的"加加减减"(UML 加系统概念、减软件概念)。它在 UML 的基础上删去了软件味浓重的构造(如组件、部署、内嵌类),保留了通用结构建模能力,并新增了四个系统工程特有的建模维度:需求(Requirements)——把需求作为一等公民显式建模,支持需求之间的派生、满足、验证追溯;参数(Parametrics)——用约束方程表达性能参数之间的关系,支持权衡分析与设计空间探索;以及将行为(Behavior)与结构(Structure)统一在块(Block)的概念之下。SysML v1 最终形成了九种标准图:块定义图(BDD)、内部块图(IBD)、参数图、需求图、活动图、序列图、状态机图、用例图与包图。其中前三种是系统工程独有的,后六种从 UML 继承改造。
围绕这九种图,INCOSE 从2007年起发起了"MBSE 计划"(MBSE Initiative),以工作组的形式推动方法、工具、本体与度量的成熟。此后十余年间,业界积累了若干以 SysML v1 为载体的系统工程方法学:诸如以状态机为核心的 Harmony/SE、以架构框架为纲的 SYSMOD、以四层结构组织模型的 MagicGrid 等,都是"用 SysML 做系统工程"的方法论结晶。工具生态同步成形:No Magic(后并入达索)、IBM、Sparx 等厂商的 SysML 工具进入工程主流,并逐步加入仿真、代码生成、需求联动等能力。可以说,SysML v1 不仅提供了一门语言,还催生了围绕这门语言的整个"知识生产方式"——方法、工具、培训、社区。这种生态的建立,既是第一代语言的成就,也是第二代语言必须继承并超越的遗产。
SysML v1 的意义怎么强调都不过分。它是系统工程界第一次拥有了一门"共同语言":无论身处哪个国家、哪个行业,工程师都可以用同一套符号描述系统架构、需求结构与参数关系。它把系统工程从"文档写作"推进到了"模型构建",并直接催生了"基于模型的系统工程"(Model-Based Systems Engineering, MBSE)这一范式——INCOSE 在2007年的《系统工程愿景2020》中给出了MBSE的经典定义:"以系统模型为权威事实源(authoritative source of truth),支持需求、设计、分析、验证等全生命周期活动的正规化应用"。从2007年起,MBSE成为航空航天、国防、汽车、能源等行业的战略关键词,SysML v1也顺势成为这门范式的事实标准语言。
三、愿景的诱惑与现实的落差
INCOSE 的《系统工程愿景2020》与后续的《愿景2025》为这场变革描绘了清晰的路线图:到2025年,"形式化的系统建模成为标准实践",系统模型成为需求、设计、分析、验证之间的主干。《愿景2025》的表述值得完整引用:到2025年,"基于模型的系统工程,包括形式化系统建模,将成为标准实践",系统工程师"通过模型、而非文档,来沟通系统的需求、设计、分析与验证"。这是系统工程界第一次以学会文件的形式,把"模型取代文档"写成了目标条款。美国国防部、欧洲航天局(ESA)、空中客车(Airbus)、波音(Boeing)等重量级组织先后启动MBSE试点与推广,SysML v1 模型在军工项目、卫星研制、航空发动机、汽车电子等领域被大规模构建。
然而,愿景与现实的落差,恰恰是理解 SysML v2 为何诞生的钥匙。第一代语言打开了门,却没能把门后的路修完。当工业界真正把 SysML v1 用于大型项目时,它暴露出的问题不是细节性的,而是结构性的——这些问题,构成了下一章的主题。
在进入下一章之前,有一个时间点值得记住。2015年8月,INCOSE 的旗舰期刊《INSIGHT》发表了一篇题为《演进 SysML 与系统建模环境以支持 MBSE》的文章,两位作者——桑迪·弗里登塔尔(Sanford Friedenthal)与罗杰·伯克哈特(Roger Burkhart)——以近乎宣示的方式,列出了系统工程界对下一代建模语言的十一项需求陈述。这十一项陈述,后来成为 SysML v2 需求征求书(RFP)的直接源头。它标志着:第一代语言的黄金年代尚未结束,重建的决定已经作出。
第三章 SysML v1 的黄金年代与隐性负债
一、成就:一门语言所改变的东西
SysML v1 在其十余年的生命周期里取得了真实的、可衡量的成就。它让"系统模型"从研究概念变成了工程实践:在航空领域,波音、空客等主机厂建立了企业级的系统建模规范,用 SysML v1 表达飞机级架构、功能分配与接口定义;在国防领域,美欧的导弹、雷达、指控系统项目把 SysML v1 模型作为需求与设计的桥梁;在汽车领域,SysML v1 被用于电子电气架构、自动驾驶功能设计与网络安全分析;在航天领域,NASA 喷气推进实验室(JPL)等组织把 SysML v1 用于任务概念设计。2020年,一项对2005至2017年间以 SysML 为主题的文献的系统映射研究(采用国际软件工程界通行的系统映射方法,从多个大型文献数据库检索并分类)表明:SysML 的学术关注度逐年增长,研究高度集中在系统设计与验证阶段,且大量研究并非直接使用标准语言,而是以子集、扩展或定制剖面(profile)的方式使用 SysML——这一发现既说明语言已深深嵌入工程方法的学术与产业脉络,也预示了后续语言重建的必要性。
SysML v1 还完成了一项更隐蔽的功绩:它把"建模"这件事制度化了。组织开始设置系统建模师岗位,建立模型评审流程,把模型作为投标与交付的组成部分;工具厂商围绕它形成了完整产业(No Magic 的 MagicDraw/Cameo、IBM 的 Rhapsody、Sparx 的 Enterprise Architect、达索的 CATIA Magic 等);INCOSE 的 MBSE 工作组与建模工具互操作工作组持续运转。一门语言的价值,最终要看它撬动了多大的生态,SysML v1 撬动了整整一个行业。
二、第一笔负债:语义精度
但繁荣掩盖不了结构问题。第一笔负债是语义精度(semantic precision)。SysML v1 建立在 UML 的元模型之上,而 UML 的语义是出了名的宽松:它用自然语言条款与半形式化的约束描述模型元素的意义,不同工具对同一元素的解释可以不同,同一模型在不同工具中的含义可能不一致。这种宽松在软件建模时尚可容忍(因为软件有编译器兜底),但在系统工程中却成为隐患——系统模型是跨学科沟通的媒介,一个"状态"在一个工具里意味着"系统的运行阶段",在另一个工具里可能被解释为"布尔条件",而模型交换时这种歧义会被原样放大。
更具体地说,SysML v1 的活动图语义长期存在争议:并发、分支、令牌(token)流的确切行为,UML 规范本身没有给出唯一的、可执行的解释;行为与状态之间的语义衔接(状态机中的状态与活动图上的动作如何对应)也是公认的模糊地带。对追求精确的工程学科而言,这种"可解释但不唯一"的语言,本质上是一种隐性的债务:它把一致性风险从建模语言转移给了建模者与工具实现者。
三、第二笔负债:表达力的缺口
第二笔负债是表达力的缺口——即有些工程上至关重要的事实,SysML v1 表达不出来,或表达起来异常笨拙。
最典型的缺口是"出现"(occurrence)建模。系统工程中,大量日常概念涉及"同一个定义的多次出现":一架飞机上有四个相同的液压泵,一个卫星星座里有多颗相同的卫星,一次试飞中同一个部件在不同时刻处于不同状态。SysML v1 对这类问题支持得很差:块(Block)既是定义又是实例,定义与出现混为一谈,导致"复用同一个部件多次"这种最朴素的工程建模需求反而极其困难。波音在其系统工程研讨会上明确提出:现有语言无法自然表达"可重用组件在装配中的多次出现",不得不用冗余的建模手法绕行,并为此不得不重度依赖工具自定义扩展(stereotype/profile)。另一个典型缺口是变更管理:SysML v1 没有内建机制表达"版本""基线""变更集",模型的配置管理完全依赖外部工具与人工约定。还有变体(variant)建模——产品线工程(Product Line Engineering, PLE)中"同一平台、多个构型"的表达——在 SysML v1 中几乎没有标准方案,工业界不得不各搞一套扩展。
此外还有参数化的局限:SysML v1 的参数图只能表达静态约束方程,无法表达随时间演化的动力学关系;时间本身没有被建模为一等公民,"系统的过去、现在、将来"在语言中没有位置。参数化与仿真工具的集成也停留在"导出方程、手工对接"的水平——把 SysML 参数模型翻译成 Modelica 或 MATLAB/Simulink 仿真模型,往往需要人工重建,模型与仿真之间的追溯关系在工具链中丢失。对于需要表达任务剖面、序列状态、四维时空关系的航空航天领域,这些缺口的代价是巨大的——工程师要么放弃表达,要么绕过语言,而每次绕过都在侵蚀模型的权威性。
四、第三笔负债:互操作的失败
第三笔负债,也是最具讽刺意味的,是互操作性的失败。SysML v1 的规范中规定了基于 XMI(XML Metadata Interchange,XML元数据交换)的文件交换格式——XMI 是 OMG 定义的、用于在不同建模工具间交换模型的标准文件格式。理论上,A 工具导出的模型文件应能被 B 工具导入;实践上,由于各工具对 XMI 的实现差异、对 SysML 扩展的私有序列化,以及规范中"工具特定扩展可自由定义"的开放条款,跨工具交换几乎总是以失败告终。工程界流传的经验是:SysML v1 模型的交换,往往需要手工修复与重新建模。这直接导致了一个后果——SysML v1 模型被牢牢锁定在创建它的工具里,模型仓库成了工具孤岛。
更致命的是,SysML v1 时代没有任何标准的"应用程序接口"(API):模型数据只能以文件为单位整体导出导入,无法以元素为单位被外部程序查询、读取、修改。这意味着,仿真工具、PLM(产品生命周期管理)系统、需求管理工具想要消费系统模型,只能与每家建模工具做点对点集成——每一次集成都是一次定制工程。OMG 曾在2009至2010年间发起过一次关于系统建模与互操作需求的信息征集(RFI),业界反馈高度一致:文件交换不够,需要标准的服务接口。但这份反馈在 SysML v1 的框架内始终没有兑现为规范,AP233(ISO 10303 系列中用于系统工程的 STEP 标准)与 SysML 的映射也始终停留在草案阶段。互操作的失败,本质上是把"模型作为知识主干"的愿景架空——一条无法被其他工具消费的主干,不是主干,只是另一份文档。
五、第四笔负债:工具的包袱与学习的陡坡
第四笔负债在于工具与可用性。SysML v1 工具大多是桌面应用,模型以私有文件存储,协作与版本管理笨重;工具的图形界面以"画图"为心智模型,用户必须先学会画图技巧,才能开始表达工程语义。同时,由于语言继承了大量 UML 概念,学习曲线陡峭:系统工程师必须理解"块""端口""流""分配"等抽象概念的细微差别,理解"合成与聚合""依赖与实现"等关系类型的适用场景。欧洲航天界有工程师直言,SysML v1 的建模工具"软件味太重",系统工程师需要先经过软件建模思维的再教育,才能驾驭它。
与工具负担相伴的,还有一个模型实践层面的反模式,可称为"模型即大图"(model-as-big-picture)。在 SysML v1 的实践中,许多团队把模型当作"把所有信息画在一张大图上"的尝试:巨型块定义图、巨型内部块图、数千个元素的单包结构。这种实践恰恰误用了建模——建模的价值在于按需组织与投影,而不是穷举;一张什么都画的大图,其可读性与维护成本不亚于一本无人能读完的文档。SysML v1 缺乏视图与视点的标准化机制(视图往往只是"把图画好看"的人工产物),无法从模型中按关注点自动派生视图,于是"大图"成了模型退化为文档的通道。这一反模式的普遍存在,说明工具可用性问题的背后还有语言机制的问题:语言没有为"按需投影"提供标准手段,使用者就只能用"一图打天下"的笨办法。
六、什么没有发生:接受度的另一面
要公正地评估 SysML v1,还必须回答一个问题:它承诺了什么,却没有发生什么?答案是三件事。
第一,模型没有成为"可执行的知识"。SysML v1 的行为模型(活动图、状态机图)缺乏标准化的执行语义,无法被仿真器直接运行;参数模型与仿真工具的集成停留在手工翻译层面。因此,即使组织建立了完整的系统模型,"在数字空间里运行系统"仍然遥不可及——模型是静态的蓝图,不是动态的知识体。第二,模型没有取代文档成为事实源。绝大多数组织的评审、合同与交付仍然以文档为准,模型只是"文档的插图";MBSE 推广的经典失败模式,是组织建立了漂亮的模型,却从未让模型进入决策与评审的主流程。第三,模型没有实现跨组织、跨工具的流通。XMI 交换的失败使"模型共享"停留在同一工具的内部,供应链协同、跨专业集成仍然靠文档与会议。系统映射研究对十余年文献的梳理显示,绝大多数研究与项目都使用 SysML 的子集或定制扩展,且集中在前端设计阶段——这从侧面印证了:语言的能力边界、工具的支撑水平与方法的成熟度,共同构成了"接受度的玻璃天花板"。认识到这些"没有发生"的事,才能真正理解为什么 2015 年之后,工业界不再满足于修补,而是要求重建。
这四笔负债叠加在一起,构成了一个耐人寻味的局面:SysML v1 被广泛采用,同时被广泛抱怨;它被视为 MBSE 的基石,同时被认定为 MBSE 规模化推广的瓶颈。2015年那篇《INSIGHT》文章的作者们在总结中写道:下一代语言需要在精确性、表达能力、互操作性与可用性上实现质的飞跃,而不是量的修补。这句话的分量,要到多年后 SysML v2 正式发布时,才被完整地理解。
第四章 重写的决策:为什么修订不再够用
一、从十一项需求陈述到两份 RFP
2015年8月《INSIGHT》文章提出的十一项需求陈述,是这场重建的立法起点。这些陈述覆盖了语言层与环境层:语言需要更强的表达能力(出现、时间、变体、接口)、更精确的语义、更简单的学习曲线;环境需要标准的交换机制、可扩展的模型库、与仿真及 PLM 的深度集成。值得注意的是,这些需求并非第一次被提出:早在2009年,OMG 就发起过一次针对系统建模语言与互操作需求的信息征集(Request for Information, RFI),2010年2月发布的反馈报告已经集中暴露了精确语义缺失、文件交换不可靠、缺少标准服务接口、工具锁定等系统性问题。但那份报告在 SysML v1 的框架内始终没有转化为可交付的规范——需求与供给之间横亘着"修补"与"重建"的路线分歧。此后两年间,OMG 的系统工程领域特别兴趣组(Systems Engineering Domain Special Interest Group, SEDSIG)与 INCOSE 联合,把这些陈述细化为正式的需求文本。2017年12月,OMG 正式发布《SysML v2 语言 RFP》,包含141项强制性需求与31项非强制性需求;2018年6月,又发布了《SysML v2 API 与服务 RFP》,包含19项强制性需求与25项非强制性需求。两份 RFP 共同界定了 SysML v2 的双重任务:重建语言,重建语言与世界的接口。
需要强调的是,RFP 本身不是技术方案,而是需求清单——它不规定"怎么造",只规定"造出来的东西必须满足什么"。这正是 OMG 标准制定机制的妙处:把技术方案的选择权交给市场化的提交团队,由竞争与评议保证质量。而这一次,RFP 的需求清单里隐含了一个足以改变方向的信号:141项强制性需求中,多项需求直接要求"语言的语义必须被形式化定义""语言必须支持出现与快照""语言必须支持文本表示""语言必须支持标准化的访问接口"。这些要求叠加在一起,等于宣告:修补 UML 基座已经不可能满足需求,必须另起炉灶。
二、为什么不是 SysML 1.8
对于外行人,最自然的问题或许是:既然 v1 有这么多问题,为什么不修修补补出一个 1.8、1.9,而非要推倒重来?这个问题的答案,藏在三个层面。
第一个层面是成本结构。SysML v1 的缺陷大多源自 UML 元模型基座:语义的模糊、概念的冗余、元模型的复杂度,都是继承而非创新的结果。要修掉这些缺陷,等于在继承的地基上重建承重墙——改动的范围会波及整个 UML 兼容层,而收益仅是"修好了一个个孤立的点"。相比之下,从零设计一门以内核语言(Kernel Modeling Language, KerML)为底座的系统语言,可以用现代的、克制的元模型一次解决语义、表达与扩展问题。工业界有句老话:修复一个错误的成本,往往超过重新设计正确概念的成本;在语言设计上,这句话是字面成立的。
第二个层面是"语言限制思维"。语言学家与软件方法论学者反复论证过一个观点:语言不仅表达思想,还塑造思想。当一门建模语言无法表达"出现"时,工程师就会停止思考"出现";当语言没有时间概念时,系统的动态性就会被简化成静态快照。柏林洪堡大学与 RWTH 亚琛大学的软件工程学者在评论 SysML v2 时指出:一门建模语言的精确语法与语义,决定了它能否支撑严谨的工程推理;模糊的语言会系统性地诱导模糊的模型。推倒重来,是为了让语言本身不再成为思维的天花板。
第三个层面是生态的路径依赖。SysML v1 的互操作失败,根源之一是其工具生态建立在"专有文件格式+点对点集成"之上,标准化的 API 会打破既得利益格局。在 v1 框架内加一个 API 标准,会遇到现有工具厂商的抵制与冷处理;而借由一次全新的语言版本,API 可以成为"新世界的地基"而非"旧世界的补丁"。OMG 的决定是把语言重建与接口标准化打包成同一个版本事件,用版本的不可逆性倒逼生态的重新洗牌。这是标准组织少有的、主动的产业重构行为。
三、SysML 提交团队:一场八年的分布式协作
2017年12月,OMG 宣布组建 SysML v2 提交团队(SysML v2 Submission Team, SST),由弗里登塔尔与埃德·塞德维茨(Ed Seidewitz)共同领导。SST 的组成方式本身就是一次制度创新:它不是一个厂商的提案组,而是一个开放式协作体——最初有六十余家组织参与,到2022年已发展到约两百一十五名成员、来自八十六个组织,涵盖美国国防工业(洛克希德·马丁、诺斯罗普·格鲁曼、雷神)、欧洲航空工业(空客、泰雷兹)、工具厂商(达索、PTC、IBM、安世、西门子)、研究机构(NASA、ESA、各大学)与开源社区。同年,由 PTC 领衔的另一个提交团队 SUT(SysML v2 Unified Team)也提交了草案;2018年底,SST 与 SUT 合并,统一为一个提交团队,把竞争转化为合力。
SST 的工作方式与传统标准制定截然不同。它采用了敏捷迭代:每四周一个冲刺,每月在 GitHub 上发布一版语言草案与参考实现,需求与模型并行演进;语言设计、需求验证、API 开发、试点应用被组织成并行的工作流——规范定义、需求跟踪与验证、元模型与语义、API 与服务、试点实施(pilot)、v1 到 v2 转换,各有专门团队负责,通过持续的例会与公开问题清单协同。公开的仓库、持续集成的测试、可下载的参考工具,使标准草案在正式定稿前就已具备可执行性——任何组织都可以在草案阶段就试建模型、反馈问题。这种"以开源方式制定标准"的实践,极大地压缩了标准的成熟周期,也把标准文本与实现验证绑定在了一起。更值得称道的是,SST 在定稿前组织了多轮工业试点:以真实的航天、航空、国防场景(如"天行者"任务模型、"手电筒"入门模型)检验语言与 API 的完备性,试点中发现的问题直接回流为规范修订——标准不是在会议室里写完的,而是在真实模型上"跑"出来的。
四、里程碑:从初始提交到正式发布
SysML v2 的时间线本身,就是一部浓缩的标准工程史。2020年8月17日,SST 提交初始规范草案(含 KerML、SysML v2 语言与 API 服务三部分);2021年2月,OMG 组织主要利益相关方评议,收集了上千条意见;2021年8月30日提交第一次修订版;2022年9月15日提交第二次修订版;2022年11月与2023年2月,KerML、API 与 SysML v2 语言分别提交最终稿;2023年6月,OMG 批准三份规范的 Beta 版本——这标志着语言冻结、进入最终定稿阶段;2025年7月21日,OMG 正式批准 SysML v2.0、KerML 1.0 与系统建模 API 与服务 1.0 的最终采纳;同年9月,三份规范以正式(formal)状态出版。此后,工具厂商的商业实现陆续发布,行业进入大规模的迁移窗口。
这段跨越近八年的历程,比任何人最初的预期都要长。它说明了一个残酷的现实:一门要承载工程知识主干的语言,其定稿速度不能以普通软件标准来衡量——每一个语法构造、每一条语义规则,都要在工业试点中经受真实的检验。而正是这种缓慢,保证了最终交付物的质量。SST 也因此于2026年初获得了美国航空航天学会(AIAA)的奖项——一个标准团队获得 AIAA 的认可,本身就是一个值得注意的信号:语言重建,已经被航天工程界视为与型号工程同等重要的事件。
五、治理机制:公共标准的共识机器
SysML v2 的制定过程,还体现了一套成熟的标准治理机制的价值。OMG 的标准生命周期是一条制度化流水线:RFP 征集需求、提交团队竞争方案、利益相关方评议、修订迭代、Beta 冻结、最终采纳、正式出版;全程以"非断言"(Non-Assert)的知识产权模式运行——即任何采用者都不会因实现规范而被主张专利侵权。这条流水线的每一次节点,都是一次开放的共识检验:评议不是走过场,上千条反馈意见被逐条处理;Beta 版本的目的,就是让工具厂商与工业用户以真实项目检验规范,把发现的问题在定稿前消化掉。SysML v2 还通过与 INCOSE 的长期联合,把系统工程学科的需求输入制度化——语言不是为了讨好工具厂商而设计,而是为了服务工程学科而设计,这是它与许多商业标准最根本的区别。
治理机制的另一个价值在于版本政治的稳定。一个公共标准一旦发布,其向后兼容责任、演进节奏、与 ISO 等国际标准化组织的对接,都影响整个产业的投资决策。SysML v1 曾以 ISO 19514 的身份成为国际标准,SysML v2 的定稿同样预留了国际标准化的通道。对工业界而言,这意味着他们的模型资产与培训投资获得了长期保障——语言的背后有制度,制度是公共标准最可靠的信用背书。
第五章 技术内核的重建:KerML、用法建模与文本化
一、内核语言:KerML 与三层架构
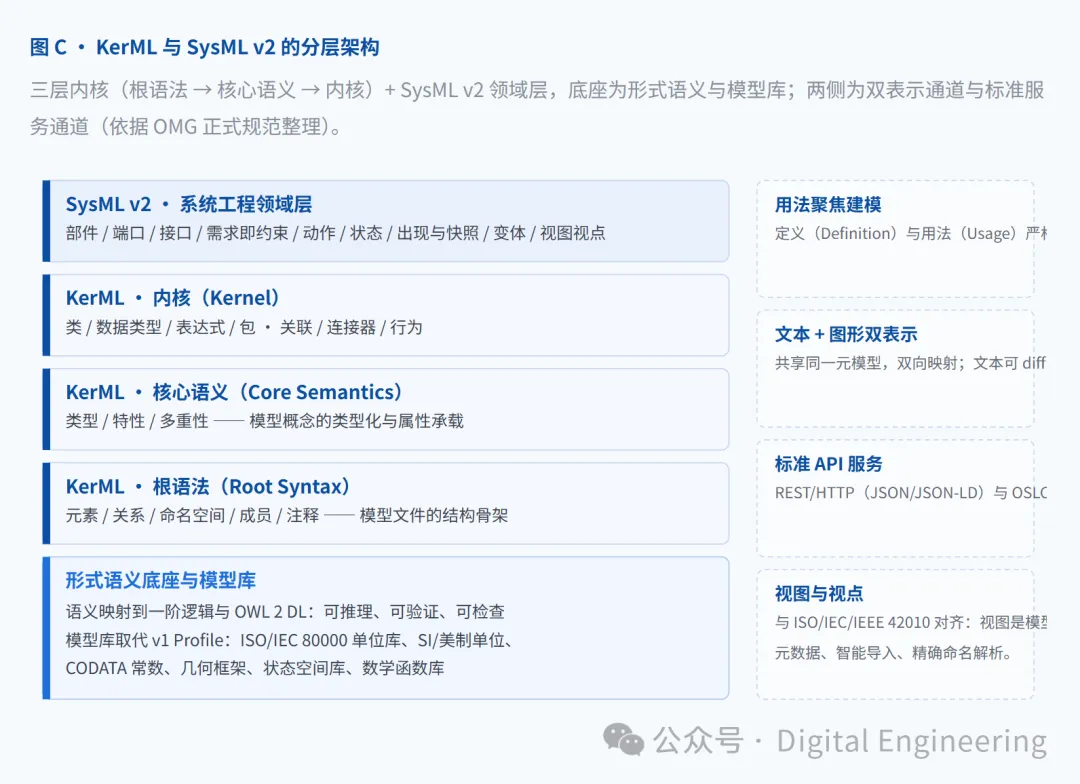
SysML v2 在技术上的第一项根本决定,是放弃 UML 基座,另行设计一门内核建模语言(Kernel Modeling Language, KerML)。KerML 是一门与领域无关的通用建模语言,承担 SysML v2 的语法与语义地基;SysML v2 则是建立在 KerML 之上的系统工程专用层。这个分层关系,可以类比为编程语言中"通用语言核心"与"标准库"的关系:核心保持小、纯、严谨,领域语义通过可扩展的库与构造引入,而不是把领域概念硬塞进元模型。
KerML 的架构分为三层。最外层是"根语法"(Root Syntax),定义建模语言最基本的结构骨架:元素(Element)、关系(Relationship)、命名空间(Namespace)、成员(Membership)与注释(Annotation)——这一层不携带领域语义,只回答"一个模型文件由什么组成"。中间层是"核心语义"(Core Semantics),引入类型(Type)、特性(Feature)与多重性(Multiplicity)等通用概念,回答"一个模型中的概念如何被类型化、如何携带属性"。最内层是"内核"(Kernel),提供类(Class)、数据类型(Datatype)、表达式(Expression)、包(Package)、关联(Association)、连接器(Connector)与行为(Behavior)等可实例化的构造。三层之上,是系统建模的语义库(semantic library),用 KerML 本身写成的库模块,为系统建模提供时间、空间、单位、数量等基础概念。
这个架构的巧妙之处在于:语义不再散落在规范的自然语言条款中,而是由 KerML 的元模型与语义库直接给出——模型的语义定义本身也是一个模型。SysML v2 规范用一阶逻辑与描述逻辑的框架对语言语义进行形式化,并提供了与 W3C 的 OWL 2 DL 本体语言(Web Ontology Language 2 Description Logic)的映射。这意味着,SysML v2 模型在原理上可以被自动推理机、约束求解器、形式化验证工具直接处理——这是 SysML v1 无法想象的。需要说明的是,这里的"形式语义"并非要求工程师在建模时写出逻辑公式,而是指语言本身有一个无歧义的解释基准:任何两个工具、任何两个工程师对同一模型的理解,原则上应该收敛到同一语义。
把形式语义的实践含义说透,有三层。第一层是工具一致性:SysML v1 时代,"同一模型在不同工具中含义不同"的问题没有裁决机制,而 v2 的语义基准为工具实现提供了一致性判据——两套工具是否忠实于规范,可以用语义测试来判定,而不只是语法测试。第二层是自动推理:当模型语义可映射到逻辑系统,模型中的一致性检查(类型是否匹配、多重性是否满足、约束是否可满足、引用是否完整)就可以交给求解器自动完成,模型"自检"从人工审查变为机器证明。第三层是分析工具的接入:仿真、验证、优化工具不再需要为每种建模语言编写解析器,只需消费 v2 的语义输出即可——这正是"系统工程数据总线"得以成立的技术前提。当然,形式语义也有边界:它保证的是"模型内的推理"正确,而"模型是否如实反映了现实系统"(模型的有效性)永远是工程判断,不是逻辑推导能替代的。认识到这一点,才不会对形式语义寄予超出其能力的期望。
二、用法聚焦建模:定义与用法的分离
SysML v2 最深刻的建模范式变革,是"用法聚焦建模"(Usage-Focused Modeling),其核心是定义(Definition)与用法(Usage)的严格分离。定义描述"一类事物是什么"——例如"液压泵"这个部件类型的结构、行为与属性;用法描述"在某个上下文中如何使用某一事物"——例如"左主液压系统的增压泵"是对"液压泵"定义的一次具体使用。在 SysML v2 中,这种分离渗透到每一种建模元素:部件用法(part usage)、端口用法(port usage)、动作用法(action usage)、状态用法(state usage)、需求用法(requirement usage)……一切皆可用。
这项变革的价值怎么强调都不过分。它一举解决了 SysML v1 时代的两个顽疾。其一,它使"多次出现"成为语言的天然能力:同一个部件定义可以被实例化为任意多次出现,每一次出现可以重新定义(redefine)其属性、端口、约束,而无需复制定义——波音所抱怨的"冗余装配件复用"问题,由此成为语言的原生表达。其二,它使"重定义"成为组织建模的通用杠杆:在系统层级定义的能力,在分系统层级可以被细化、约束、重定义,系统模型因此可以自然地跨层级生长,而每一层都保持对上一层的可追溯性。有系统建模专家将这种范式概括为"没有 BDD 的接口块建模"——曾经需要繁琐的块图与接口图才能表达的东西,现在用一个部件用法加几个端口用法就能表达清楚。
用法聚焦建模的另一层意义在于与产品线工程的对接。SysML v2 引入了变体(variant)与变体绑定(variant binding)的概念,支持定义可变特性、约束变体组合、表达可选部件与可配置构型,并与 ISO/IEC 26550 产品线工程标准家族对齐。这意味着,型号的"基本型+改型"、平台化产品的"系列化配置",第一次可以在系统模型中作为一等概念表达,而不再依赖外部 PLE 工具与专有扩展。
三、文本化:模型也是可读的文本
SysML v2 的第二项根本变革,是文本表示(Textual Notation)的引入。SysML v2 的语言规范同时定义了图形表示与文本表示,两种表示共享同一套元模型与语义,可以双向映射:一个模型可以用文本写出,自动渲染为图形;也可以画成图形,自动生成为文本。文本语法(包含表达式语言)是一种独立的、精确定义的形式语言,支持注释、模块化组织、可读性优化。
这件事在工程技术上带来的连锁反应是巨大的。首先,模型第一次可以被版本管理系统(如 Git)以行级差异(diff)的方式管理——文本可以逐行比较、合并、审查,而私有二进制文件不能;这直接解决了 SysML v1 时代"模型如何协作"的痛点。其次,文本让模型可以嵌入文档、脚本、CI/CD(持续集成持续交付)流水线:系统模型不再是工具界面里的一幅图,而是与代码一样可以被机器读取、生成、检查的制品。再次,文本为自动化打开了通道——自动生成的模型、参数化生成的模型、由工具脚本批量修改的模型,都因为文本表示而变得可行。一位参与 SysML v2 设计的软件工程学者曾评论:SysML v2 把系统模型从"画布"变成了"程序文本",这一转变对工程自动化的意义,类似于源代码对软件工程的解放。
文本与图形共享语义的设计,也蕴含着一个对工具厂商的约束:任何声称支持 SysML v2 的工具,都必须同时支持两种表示及其一致性——"图形优先"或"文本优先"只是工作流偏好,不再是实现自由的借口。这一点,是语义精度思想在界面层的延伸。
四、行为建模与可执行性的路线图
SysML v2 在行为建模上的设计,同样值得单列一节。动作(Action)与状态(State)在用法聚焦范式下成为可实例化的元素:动作用法(action usage)可以嵌套、并发、带参数,状态用法(state usage)可以表达状态层次与状态间的转换;行为模型与结构模型通过"谁执行什么动作"(subject 与 action 的绑定)建立联系。与 v1 相比,v2 的行为语义更为严格——动作的输入输出、状态的进入与退出、并发的汇合与分支,都定义了明确的语义规则,为行为模型的可执行性奠定了基础。
但必须诚实指出:SysML v2 的可执行性路线图仍在推进之中。语言规范定义了行为模型的结构与静态语义,而"模型如何被仿真执行"(执行语义)由 OMG 的执行语义工作组与数学语义组持续制定——它与仿真工具的深度集成,是语言正式发布之后仍在进行的工作。这一状态反映了工程现实的复杂性:行为模型的可执行性涉及离散事件、连续时间、混合信号等不同计算范式的统一,任何急于求成的冻结都会损害语言的长远质量。从工程使用的角度看,v2 已经把"通向可执行模型"的语法与语义地基铺好:文本表示让行为模型可以像程序一样被解析与变换,API 让仿真工具可以标准地读取与回写行为模型,形式语义让"模型的可执行解释"有了一致性判据。可以预期,行为模型的可执行性将在未来数年内随工具成熟而逐步兑现,而这正是"模型即知识体"从静态走向动态的关键一跃。
五、时间、个体与数字孪生的语言地基
SysML v2 在语义上的另一项突破,是把时间与个体引入语言内核。SysML v1 的世界是"静态的":模型描述系统在某一个抽象时刻的结构与行为,动态性只能靠活动图、状态机图勉强表达,而"同一系统在不同时刻"无法被建模。SysML v2 引入了"出现"(Occurrence)与"快照"(Snapshot)的语义框架:一个出现是系统在时空中的一段存在,快照是出现在其生命周期中某一时刻的状态切片。系统、部件、事件、状态、动作,都是出现;系统的"过去、现在、将来"由此成为可建模的对象——任务剖面、寿命周期、序列状态,都可以用统一的出现-快照语义表达。规范还引入了基于区间的时间逻辑(以艾伦区间代数为基础的时间关系系统),使"先于""交叠""包含"等时间关系获得严格定义。
在出现语义之上,SysML v2 定义了"个体"(Individual)的概念。个体是"具有唯一身份、可被追踪的出现"——一台具体的发动机、一颗具体的卫星、一次具体的试飞。个体与类型分离的建模方式,使"设计意图"(类型)与"实物状态"(个体)可以被分别建模并相互关联。这正是数字孪生(Digital Twin)概念所需要的语言地基:数字孪生本质上是"运行中系统的个体化模型",它需要表达"这个特定序列号的产品现在处于什么状态、经历了什么事件、下一时刻会如何"。SysML v2 还支持分析用例(analysis case)与验证用例(verification case):前者把"对系统进行某种分析"建模为可配置、可执行、可追溯的活动,后者把"验证某条需求是否被满足"建模为可复现的过程。这一设计把"仿真""试验""验证"从模型之外的活动,变成了模型之内的对象——系统模型由此可以覆盖从设计到运行、从仿真到试验的完整闭环。
六、需求即约束、视图即窗口、库即扩展
在需求建模上,SysML v2 完成了一次语义升级:需求(Requirement)在语言中成为一类约束(constraint)——一条需求是一个"必须被满足的声明",可以被形式化地关联到约束表达式、验证用例与实现元素,需求的"满足"不再是画家笔下的追溯箭头,而是可以被检查、被证明、被反驳的命题。需求在用法聚焦范式下同样成为可实例化的元素:需求用法可以被细化、被重定义、被约束,需求树与需求族由此获得一致的建模语法。
在视图(View)与视点(Viewpoint)上,SysML v2 与 ISO/IEC/IEEE 42010(架构描述标准)全面对齐:视点规定"从什么利益相关方关注点出发、选择模型的哪些元素、以什么形式呈现",视图则是该视点在特定模型上的具体投影。视图被建模为一种可计算的查询与投影——"导出某视图"成为对模型的一次确定性操作,而不是人工重新画图。这意味着,SysML v2 模型可以按需生成任意关注点的视图,文档在模型面前第一次真正成为"派生制品"。
在可扩展性上,SysML v2 用"模型库"(Model Library)取代了 SysML v1 的"扩展档案"(Profile)机制。SysML v1 的扩展依赖 UML 的 profile 机制,属于元模型层的扩展(M2 层),复杂、易错、与工具耦合;SysML v2 的模型库则是用语言本身写成的模型(M1 层),扩展者只需要写普通的 SysML v2 文本即可定义新的领域构造。规范自带的标准模型库包括:基于 ISO/IEC 80000 的国际量制与 SI 单位库、美国惯用单位库(依据 NIST 标准)、物理常数库(依据 CODATA)、坐标框架与几何形状库、状态空间库、数学函数库等。领域组织可以像发布软件库一样发布自己的 SysML v2 库——这种扩展机制的简化,是语言可用性革命中容易被低估的一环。
与模型库机制配套的,还有三项经常被忽略但工程意义重大的语言设计。其一是元数据(Metadata)机制:SysML v1 时代"给模型元素打标签"需要依赖工具特定的剖面与注释约定,SysML v2 把元数据作为语言内建的一等概念——任何模型元素都可以携带结构化的元数据(如安全分级、作者、批准状态、涉密标记),元数据本身又是可类型化的模型元素。这一机制直接服务于工程治理:模型元素的安全分类标记、配置管理状态、审查结论,都可以规范地挂在模型上,而不是散落在工具外部。其二是"智能导入"(Smart Import):SysML v2 的包导入支持声明式的成员选择(例如导入某库中所有符合某条件的元素),并能正确处理循环导入——这使得大型模型库与跨团队模型的组合在机制上可控,而不是依赖工程师手工维护导入关系。其三是命名解析的精确化:SysML v2 规范对命名空间与名称解析规则给出了严格的语义定义(包括对未定义行为的情形做出明确处理),消除了 SysML v1 时代不同工具对同名元素解析不一致的隐患——这看似是语言细节,实则是跨工具互操作与自动推理的前提:只有名称解析无歧义,机器才能确定地理解"模型在说什么"。
七、小结:一次完整的语言重设计
把第五章的内容收拢来看,SysML v2 的语言设计不是对 SysML v1 的局部改进,而是一次覆盖元模型、语义、表示、扩展机制与建模范式的完整重设计:KerML 提供严谨内核,用法聚焦提供统一范式,文本化提供工程可操作性,出现-个体-快照提供时间与孪生地基,需求-约束与视图-投影提供推理与派生能力,模型库提供生态扩展通道。用一句话概括:SysML v1 是一门"画系统的语言",SysML v2 是一门"计算系统的语言"。前者把系统模型当作沟通工具,后者把系统模型当作可推理的知识体——正是这一定位之差,决定了后面所有关于生态、迁移与范式的问题。
第六章 API 与生态革命:从文件交换到标准服务
一、为什么文件交换注定失败
理解 SysML v2 的 API 规范,首先要理解 SysML v1 时代互操作失败的真正原因。XMI 文件交换的失败,常常被归咎于工具实现不认真,但深层的病根在别处:文件交换把"互操作"建在了一个脆弱的假设上——交换双方对模型文件的语义理解一致。事实上,模型文件在导出时已经经过工具的解释与私有序列化,导入时又要经过另一套解释;规范没有提供"导出即导出、导入即导入"的权威语义基准,每一次交换都是一次语义重编码。更糟的是,文件是整体快照:交换一个大型模型的成本与交换整个模型的成本相同,无法按元素、按版本、按增量交换。在分布式、多组织、持续演化的工程环境里,这种交换模式从制度上就不成立。
理解 SysML v2 的回答,需要先建立一个三层互操作的框架。工程工具之间的互操作可以分为三个层次:语法层——数据能否被对方解析(格式兼容);语义层——解析后的数据是否含义一致(概念兼容);服务层——对方能否按需、增量、受控地获取与修改数据(行为兼容)。SysML v1 时代的 XMI 交换只触及语法层,且连语法层都未真正统一;语义层依赖各工具对规范的自我解释,服务层完全缺失。SysML v2 的 API 规范同时攻占了后两个层次:语义层由形式语义与 JSON-LD 的链接数据输出保证,服务层由标准化的服务契约(创建、查询、导航、版本化、外部关系)保证。值得强调的是,SysML v2 规范中的"语义映射到 OWL 2 DL"与 JSON-LD 的链接数据表示,使系统模型可以直接接入语义网(Semantic Web)技术栈——模型元素可以被全球唯一的 URI 标识、被关联数据查询语言(SPARQL)检索、被本体推理机处理。这已经不是"交换文件"的旧世界,而是"消费数据"的新世界:模型成为可编程、可查询、可推理的知识服务。
SysML v2 的回答是:把"交换"从文件层面提升到服务层面。规范定义了系统建模 API 与服务(Systems Modeling API and Services),其核心思想是:模型驻留在标准化的模型仓库(repository)中,外部程序通过标准接口以元素为单位读取与修改模型——不需要知道模型文件是什么格式,不需要知道仓库是哪个厂商实现的。
二、PIM 与 PSM:一次面向未来的接口设计
API 规范沿用了 MDA(模型驱动架构)的经典方法:先定义平台无关模型(Platform Independent Model, PIM),再定义平台特定模型(Platform Specific Model, PSM)。PIM 用 UML 描述接口的抽象语义:模型仓库支持哪些服务(创建、读取、更新、删除元素)、如何导航元素关系、如何查询、如何版本化;PSM 则给出具体平台的绑定——规范提供了两套完整的 PSM:REST/HTTP(基于 OpenAPI 3.1 描述,数据交换采用 JSON 与 JSON-LD 两种表示)与 OSLC 3.0(面向生命周期工具集成的开放标准,基于链接数据)。两套 PSM 共享同一个 PIM 语义,因此无论工具厂商选择哪条实现路径,外部消费者面对的语义是一致的。
API 服务集的设计直接回应了 SysML v1 时代的痛点。元素导航服务(Element Navigation)允许程序沿着模型的成员、关系、继承网络逐层遍历——这取代了"打开整份文件再人肉搜索"。查询服务(Query)提供对模型的声明式查询能力——"找出所有未验证的软硬件接口需求",这类问题在 v1 时代需要人工翻模型,在 v2 时代是一条 API 调用。项目数据版本化服务(Project Data Versioning)引入了类似 Git 的版本模型:提交(commit)、分支(branch)、标签(tag),模型仓库可以像代码仓库一样支持分支开发、合并与基线管理。外部关系服务(External Relationship)允许模型元素与其他系统中的对象(PLM 条目、问题单、测试用例)建立标准化的链接,为跨工具追溯提供了标准通道。规范还附带了完整的一致性测试套件(Conformance Test Suite),定义了各类服务必须通过的行为测试用例——一致性从此有了可执行的判据,而不是纸面上的承诺。
三、生态效应:从工具孤岛到开放数字工程环境
API 的价值只有在生态中才能兑现。SysML v2 发布前后,工业界的实践已经展示了它的威力。美国国防部与相关承包商推动的"开放数字工程环境"(Open Digital Engineering Environment)项目,直接采用 SysML v2 API 作为系统模型与其他工程工具之间的标准总线:模型仓库对外提供 JSON-LD 数据,仿真工具(如 AFSIM,美国空军标准任务分析工具)通过 gRPC 服务与模型仓库互通,Python 脚本通过 API 把 JSON-LD 响应转换为可分析的对象,安全授权(Authority to Operate)流程通过从模型自动生成系统安全计划(SSP)来加速。这个环境把"系统模型"从某个厂商桌面工具里的私有文件,变成了云上可访问、可编程、可审计的数字资产——这正是数字工程(Digital Engineering)理念对"模型是工程主线"的全部要求。
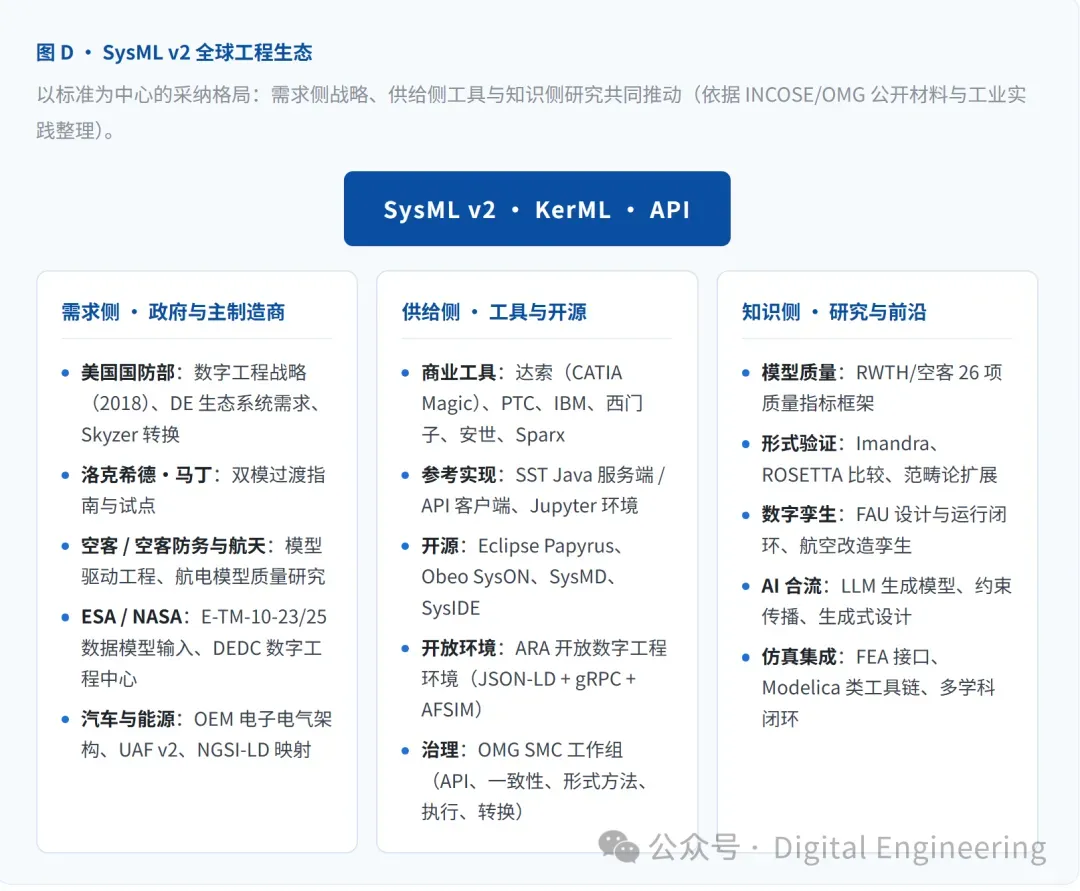
在工具生态层面,SysML v2 的 API 与文本表示共同瓦解了"锁定"的商业逻辑。厂商可以继续提供差异化的图形体验与专业集成,但模型本身是开放的、可迁移的。开源社区同步跟进:SST 发布了参考实现(Java 实现的服务端与 API 客户端、基于 Jupyter 的建模环境),Eclipse 的 Papyrus 与 Obeo 的 SysON 等项目提供开源的 SysML v2 工具,凯泽斯劳滕大学的 SysMD 项目提供基于文本的系统建模与分析工具,SysIDE 提供文本编辑与分析环境。商业工具方面,达索(收购 No Magic 后以 CATIA Magic 承载 Cameo 生态)、PTC、IBM、西门子、安世(Ansys)、Sparx 等均宣布了各自的 SysML v2 支持路线。一个由标准 API、开源实现、商业工具共同构成的生态,正在取代单一厂商垄断的旧格局——这与 SysML v1 时代的产业形态形成了鲜明对照。
API 对产业格局的更深层影响,在于它与产品生命周期管理(PLM)与软件生命周期管理(ALM)的融合通道。SysML v1 时代的系统模型游离于 PLM 之外:PLM 管几何与物料(BOM),需求工具管需求,系统模型夹在中间,只能靠文档与人工传递。SysML v2 的 API 提供了标准化的、可版本化的模型访问服务,使系统模型第一次可以像 PLM 对象一样被纳入企业级的配置管理、审批流与供应链协同——模型分支、合并、基线、发布,都成为可以在企业集成平台上编排的流程。这正是"数字主线"(Digital Thread)概念所需要的制度基础:数字主线不是一条传输数据的管道,而是一套让模型在需求、设计、制造、运行之间流动并被治理的机制,API 是这套机制的血管。
第七章 全球工业的采纳与迁移实践
一、需求侧的推力:数字工程战略
SysML v2 并非在真空中成长。它的问世,恰逢全球工程界对"数字工程"的集体转向,其中最强劲的需求侧推力来自美国国防部。2018年6月,美国国防部发布《数字工程战略》,提出以数字模型与数字线索(Digital Thread)为核心重塑采办与工程流程,明确要求"把模型作为权威事实源"。2021年的 ETI 报告进一步指出,国防系统的数字工程成熟度在系统与任务层级严重不足,并建议围绕系统模型建设开放、可互操作的数字工程生态系统。国防部还发布了《数字工程生态系统通用需求基线》等文件,为各军种与承包商划定共同的数据与互操作要求。
这股推力直接转化为对建模语言的需求:国防项目需要一门语义精确、可交换、可集成、支持认证与安全标记的语言,而 SysML v2 几乎是按这些需求定制的。值得注意的是,SysML v2 的需求文本与 RFP 过程本身就有大量国防背景的参与者深度介入——洛克希德·马丁、诺斯罗普·格鲁曼、雷神、以及各军种的系统工程组织都是 SST 的活跃成员。标准与需求侧的共振,使 SysML v2 的"采纳"从一开始就不是厂商营销,而是工程制度的要求。
二、迁移的工程化:从模型转换到组织转型
语言升级只是第一步,真正的挑战是把已有的 SysML v1 模型与既有工程流程迁移到 v2。2024年,美国国防部数字工程共同体发布了《SysML v1 到 SysML v2 模型转换方法报告》,以"天行者"(Skyzer)任务模型为对象,给出了一个可复用的转换方法论。其流程分四步:预处理(清洗 v1 模型、去除工具私有扩展、解析循环依赖)、转换(按规范定义的 v1 到 v2 转换规则执行机械映射)、后处理(按 v2 的用法聚焦范式重构模型,以充分释放新语言能力)、验证(对比转换前后模型,确认工程意图无损)。
这份报告给出了几个重要的工程判断。其一,转换是单向的:v2 的能力(如出现、快照、变体)在 v1 中不存在,因此不存在标准的反向转换——这决定了迁移窗口期 v1 与 v2 模型必须共存,组织要为共存期的双轨运行做好准备。其二,增量优于整体:把模型按结构、行为、需求分域切分,逐块转换、逐块验证,远比一次性整体转换稳妥。其三,转换不是终态:机械转换出来的模型只是"合法",要充分发挥 v2 的能力,必须按用法聚焦范式重写关键部分——转换报告明确建议,对维护不良或范围不清的 v1 模型,从零重建 v2 模型往往更经济。其四,涉密模型的分类标记必须原样保留,v2 的元数据机制为此提供了标准通道。
比模型转换更复杂的,是组织转型。洛克希德·马丁在2024年初的国际系统工程学会冬季工作坊上发布了《SysML v2 过渡指南》,其要点颇具代表性:过渡不是一次切换,而是一个持续多年的双模(bimodal)过程——在新项目上采用 v2,在成熟型号上维持 v1,并建立过渡工作组(语言、工具、建模规范、培训四条线并行);先以试点项目验证语言与工具,再逐步扩大;把 v1 时代积累的建模规范、模式库、培训体系迁移到 v2 语境。报告特别强调:过渡的主要障碍不是技术而是人——工程师的建模习惯、组织的审查流程、合同的交付要求,都要同步更新。
从时间表与成本结构看,迁移是一个以三年到五年为尺度、以"人"为主要成本项的工程。语言与工具的学习曲线(从熟悉 v1 的工程师转型到 v2 的用法聚焦范式)、建模规范的改写(企业级建模规范、模式库、评审清单都要重写)、存量模型的处理(转换或重建的决策、增量转换的执行)、双模运行期的维护负担(两套语言、两套工具、两套交付格式),构成了迁移成本的四个主要来源。工业界的共识是:迁移的最佳时机是"新项目开始之前或重大升级之前",而非型号进行之中;迁移的收益(模型可交换、可查询、可集成、可自动验证)要在数个项目的尺度上才能充分兑现。因此,理性的迁移策略是战略性的渐进:从试点验证到项目推广,从局部采用到全线替换,把迁移本身当作一个系统工程来管理——这一判断,几乎出现在所有组织发布的过渡指南中。
三、欧洲的经验:空客与欧空局
欧洲的实践路径与美国略有不同,其特点是从"数据治理"与"工程方法"两端向 SysML v2 靠拢。空客(Airbus)是 SST 中最活跃的整机厂商之一,其系统工程负责人多次在国际会议上阐述空客的模型驱动工程图景:以系统模型为核心,把需求、架构、接口、验证组织成单一的数字主线。空客参与 SysML v2 的动机清单几乎复刻了 v1 的痛点:嵌套属性(part 中再嵌 part 的深层结构表达)、接口的精确建模、与仿真工具的深度集成、多学科数据的一致性。在航空电子领域,空客防务与航天公司(Airbus Defence and Space)与亚琛工业大学合作,用 SysML v2 重写了一个真实的航电系统模型,并从内部质量(单个模型制品质量)、外部质量(跨制品一致性)与表示质量(图形与文本表示质量)三个维度、26项指标评估了模型质量——这项研究证明,SysML v2 的精确语义与用法聚焦范式能够显著提升模型质量,但质量仍高度依赖建模方法论与组织纪律。
欧洲航天局(ESA)的路径同样有代表性。ESA 早在2015年就向 SysML v2 的需求过程输入了欧洲航天数据建模的经验:ECSS-E-TM-10-23(航天系统数据仓库)与 ECSS-E-TM-10-25(并行设计设施)标准定义了航天系统数据管理的概念模型,ESA 的"开放航天系统模型"(OSMoSE)项目与 Capella 建模方法(基于 ARCADE 方法论的开放工具链)积累了丰富的系统建模实践。ESA 的工程师把"系统数据仓库""并发设计数据""全生命周期数据管理"等概念带入 v2 的需求文本,而 v2 的出现反过来为这些实践提供了标准化的语言载体。ESA 的工程师汉斯-彼得·德·科宁(Hans-Peter de Koning)深度参与了需求工程,其主导的"航天系统核心数据建模概念"工作,成为 v2 需求的重要欧洲输入。
四、横向的行业渗透:汽车、能源与数字孪生
SysML v2 的接受度并不限于航空航天与国防。汽车行业是 MBSE 的重镇:主流车企与 Tier 1 供应商把 SysML v1 用于电子电气架构与功能安全,而 v2 的出现正逢汽车电子架构的复杂度爆炸——软件定义车辆、自动驾驶功能、网络安全要求,都需要一个能表达功能、逻辑、物理多层架构且能支持变体管理的系统模型。行业观察者把美国国防部的数字工程战略与汽车行业的"模型化开发"并列,指出两者面临同一批问题:系统级复杂度、多学科集成、跨组织协同。统一架构框架(Unified Architecture Framework, UAF)的官方演进方向也明确指向 SysML v2——UAF v2 标准模型库将直接建立在 SysML v2 之上,这意味着企业架构与系统建模正在走向同一种语言。
能源行业给出了一个有趣的跨领域映射案例:荷兰的电力系统研究者把 SysML v2 模型映射到 NGSI-LD(欧洲智慧城市与能源领域常用的链接数据标准),用于增强能源系统建模的互操作性——这一实践表明,SysML v2 的 JSON-LD 语义输出可以与领域数据标准对接,系统模型可以成为跨域数据生态的参与者而非孤岛。在数字孪生领域,德国埃尔朗根-纽伦堡大学的研究团队把 SysML v2 用于数字孪生的设计与运行闭环:利用个体(Individual)与快照(Snapshot)语义表达"某个特定设备在运行中的状态",把设计模型、运行数据与维护决策组织在同一条数字线索上。另一个研究团队(亚琛)将 SysML v2 用于航空设施改造的数字孪生,进一步验证了 v2 在"已服役系统的改造与延寿"场景中的价值——这恰恰是 SysML v1 最不擅长的场景之一。来自需求侧的证据同样值得注意:NASA 约翰逊航天中心牵头、多所大学与工业伙伴参与的数字工程设计中心(Digital Engineering Design Center, DEDC),以月面与火星原位资源利用(ISRU)系统为对象,为甲烷化反应器等关键分系统建立了高保真数字孪生(基于计算流体力学工具 Star-CCM+ 建模,以试验数据验证),其规划中的下一步,正是把这些分系统模型锚定到统一的系统模型之下,实现分系统之间需求联动与接口控制文件(ICD)的自动追溯——这恰好是 SysML v2 的 API、需求约束与视图机制所要支撑的工程形态:高保真的领域模型是"叶子",语义精确的系统模型是"主干",数字孪生的价值只有在主干与叶子的连接中才能兑现。
五、专业领域的延伸:仿真集成、形式化方法与认证
SysML v2 的开放接口还为专业领域打开了新的集成通道。在有限元分析(FEA)集成方面,Koneksys 等团队展示了通过 API 把系统模型与结构分析模型连接的方法——系统模型中的几何、材料、边界条件可以直接驱动 FEA 工具,分析结果回写模型,形成一个可追溯的设计-分析闭环;麻省理工学院林肯实验室的研究者则尝试用范畴论(Category Theory)扩展 SysML 的元模型,为结构化分析提供更强的数学框架。在形式化方法方面,SST 专门成立了形式方法小组,Imandra 等公司演示了在 SysML v2 模型上执行形式验证(证明模型满足关键性质)的能力——由于 v2 语义是形式化的,这类工具不再需要猜测模型含义。学术界与工业界也在开展 SysML v2 与既有形式化系统工程框架(如 ROSETTA,一种面向系统级设计的形式化建模与验证框架)的比较研究,以评估新语言在严谨性上的成色。在系统认证(Certification)方面,学术界与工业界正在探索如何让 SysML v2 模型直接支撑适航与安全认证的证据链——模型作为"证据"的可用性,取决于其语义的可解释性,而这正是 v2 相对 v1 的结构性优势。
这些实践共同勾勒出一幅图景:SysML v2 不是又一个孤立的标准,而是正在成为"系统工程数据总线"——一端连接需求与架构,另一端连接仿真、验证、制造、运行与监管。范式迁移的成功标志,不是有多少模型用 v2 画了出来,而是系统模型是否真正成为工程组织的权威事实源,被所有相关方以标准方式消费。
第八章 范式迁移的深层逻辑:当模型成为知识本体
一、从"记录"到"执行":知识活性的跃迁
回顾整条叙事线,可以把这场迁移的深层逻辑归结为一句话:工程知识的载体正在从"记录"跃迁为"执行"。文档是对知识的事后记录,它的活性取决于读者的解释;仿真模型是对知识的专门执行,但每种仿真只执行知识的一个侧面;而一个语义精确、接口标准的系统模型,第一次让"关于系统的整体知识"本身成为可查询、可计算、可验证、可演化的对象。
这个跃迁的工程后果是系统性的。一致性维护从"人工对照文档"变为"模型约束自动检查"——如果需求被建模为约束,那么"这条需求是否被满足"就是一个可以在模型上计算的问题。变更影响分析从"工程师凭经验猜测"变为"沿模型关系网络自动追踪"——一个接口的修改会影响哪些部件、哪些状态、哪些验证用例,可以从模型中查询出来。知识复用从"复制粘贴文档段落"变为"引用与重定义模型元素"——用法聚焦范式让"复用"成为建模的原生动作。换言之,SysML v2 没有发明任何新的工程活动,它只是让这些活动从"靠人"变成了"靠模型"。这恰恰是所有数字工程愿景的共同内核:把工程从人类记忆的负担中解放出来,让机器承担一致性与追溯性的劳动。
二、语言的边界:精确与欠规格化的辩证
但范式迁移的深层逻辑中,也包含一个需要清醒认识的辩证关系:精确的语言并不能替代模糊的意图。系统工程中有大量知识在本质上是"欠规格化"(underspecified)的——早期设计中"大致如此"的架构假设、专家头脑中"说不清但经验如此"的判断、利益相关方尚未明确的偏好。建模语言如果过度精确,可能反而诱导工程师过早锁定尚未成熟的决策。
SysML v2 的设计对这个问题给出了结构性的回应:精确的语法与语义,配合"用法可重定义""模型库可扩展""视图可按需派生"的机制,使模型可以在不同成熟度上保持自洽——早期模型可以用粗粒度的用法表达不确定的架构,随着设计推进逐层细化,而每一层细化都发生在同一套语义框架内。更根本的,精确语义的价值不在于消除模糊,而在于让模糊"可见":当语义无歧义时,工程师才能准确地知道"哪里还没有定义清楚"。模糊被语言规范地显式化,是严谨工程的前提,而非障碍。软件工程界对 SysML v2 的评论也指向同一结论:一门语言的价值,在于它能否支撑"精确推理",而精确推理要求语言本身把欠规格化的部分明确标出,而不是用模糊的语法把问题掩盖起来。
三、模型质量:可度量,才能可治理
范式迁移的另一个深层变化,是模型质量从"艺术"走向"度量"。当模型成为权威事实源,模型质量就与产品质量直接挂钩。亚琛工业大学与空客的研究团队提出的模型质量框架,把质量分为内部质量(单一制品内的结构正确性)、外部质量(制品之间的一致性)与表示质量(图形与文本表示的可读性),并给出26项可操作指标。这项工作的意义在于:它证明模型质量不是主观审美,而是可以被工具自动检查、被组织考核的工程属性。SysML v2 的精确语义使许多质量指标(类型一致性、多重性满足、约束可满足、引用完整性)从"人工审查"变为"机器可判",这是 v1 时代做不到的。可以预见,随着 v2 普及,"模型评审"将像"代码评审"一样成为组织级质量制度的常规组件。
四、AI 的合流:模型作为机器智能的燃料
范式迁移的下一个变量是人工智能。SysML v2 与 AI 的结合点在两个方向上同时展开。其一,模型作为 AI 的训练与推理对象:系统模型是结构化、语义明确的知识体,远比自然语言文档更适合作为大语言模型(LLM)的上下文——亚琛工业大学的研究团队已经演示了 LLM 直接生成与修改 SysML v2 模型、利用模型语义进行约束传播的流程,"以模型为媒介的智能系统工程"(AI4MBSE)正在成为活跃的研究前沿。其二,模型作为 AI 的验证对象:当 AI 生成设计建议时,需要一种无歧义的语言来承载建议、检查建议、追踪建议的工程影响,SysML v2 恰好提供了这种载体。有研究者乐观地断言:形式语义的建模语言与大语言模型的组合,可能带来"系统工程编译时代"——工程师以自然语言表达意图,AI 将其编译为可推理的模型,再由形式工具保证模型满足约束。这个愿景尚远,但语言的语义地基已经就位。
与此同时,生成式设计(Generative Design)正在把"模型驱动的设计空间探索"推向前沿:有工业软件团队展示了把目标驱动的生成式设计扩展到 SysML 的方法——用系统模型承载设计目标与约束,由生成算法探索满足约束的构型空间,再回填模型。这类实践指向的终极图景是:系统模型不再是"对已定设计的描述",而是"设计空间的形式化容器"。
五、组织与文化的最后一道坎
范式迁移最深的阻力,不在语言,不在工具,而在组织。工程组织的流程、合同、审查制度、职业体系,都是围绕文档范式建立的:评审看文档、交付交文档、签字签文档。即便模型成为权威事实源,这些制度仍会惯性运转——这解释了为什么"双模运行"被所有过渡指南反复强调,也解释了为什么 SysML v1 时代的 MBSE 推广中,最大的失败模式不是技术不成熟,而是组织把"建模型"当成"画图任务"外包给了少数建模师,模型没有进入主流工程决策流。
INCOSE 的《系统工程愿景2035》把这个问题表述得更为本质:未来十年,系统工程必须从"以文档为交付物"转向"以模型与数字制品为交付物",工程组织需要新的角色(模型架构师、模型评审员)、新的度量(模型质量、数字连续性)与新的协作模式(跨组织共享模型)。范式迁移的真正完成,以工程文化接受"模型即知识本体"为标志——到那时,系统模型不是图纸的替代品,而是需求、设计、验证、运行共用的唯一事实源,文档退化为模型的派生视图。这才是"从文档到模型"五个字的完整含义。
六、数据驱动的工程:模型与数据的汇合
范式迁移的最后一个深层面向,是模型与运行数据的汇合。传统上,"模型"属于设计域,"数据"属于运行域:设计时用模型预测,运行时用传感器记录,两者之间的反馈靠人工分析。数字主线(Digital Thread)概念的激进之处,在于把这两个域缝合起来——运行数据回流,校准与修正模型;模型前向传播,预测与指导运行。SysML v2 为这种缝合提供了语言与接口的双重基础:语言层面,个体(Individual)与快照(Snapshot)使"某个具体设备在某时刻的状态"可以被建模,模型由此获得描述"在役系统"的能力;接口层面,API 的查询与外部关系服务使运行数据系统(如 PHM 健康管理系统、维护记录系统)可以与系统模型建立标准化的链接。当模型可以被运行数据持续校准,它就不仅是"设计的蓝图",而是"系统的活的知识体"——这正是"模型即知识本体"在运行阶段的体现,也是数字孪生从演示走向规模化的前提。可以预见,未来十年"模型-数据闭环"将成为工程组织核心竞争力的来源,而 SysML v2 为这个闭环提供了第一个标准化的语言与接口底座。
结语 未竟之路
2025年7月21日,OMG 宣布最终采纳 SysML v2.0、KerML 1.0 与系统建模 API 与服务 1.0;同年9月,三份规范以正式状态出版。从2007年 SysML 1.0 问世,到2025年 SysML 2.0 正式发布,系统工程界用十八年时间完成了第一代语言的建立、应用、反思与重建。这条路走完了一程,但范式迁移本身远未完成。
摆在面前的是几个明确的未竟议题。第一,迁移的规模与节奏:v1 与 v2 将在未来数年内共存,存量模型的处理、增量项目的采用、跨组织供应链的协同迁移,都需要时间与制度安排。第二,执行语义的完善:SysML v2 的执行语义仍在演进,行为模型的可执行性、仿真工具与模型的深度绑定,仍是活跃的标准化工作。第三,一致性与认证工具的成熟:一致性测试套件需要覆盖更多工具,模型质量与认证证据链的自动化需要更多工业验证。第四,度量与证据:数字工程的投入产出如何度量,"模型驱动"究竟在多大程度上缩短了周期、降低了风险,需要十年尺度上的实证研究。第五,AI 时代的融合:大语言模型、生成式设计与系统建模的合流,既可能加速范式迁移,也可能带来新的滥用与失真,需要工程界保持清醒。
还有一层更宏大的视角值得点明:标准是一种特殊的公共基础设施,它的成败不取决于任何单一组织,而取决于整个生态的长期投入。SysML v2 的正式发布,不是这项事业的高潮,而是它的起点——此后是工具实现的质量竞争、模型库与模式库的社区积累、教育体系的语言迁移、审查与认证制度的数字化改造。回顾 UML 与 SysML v1 的历史可以知道,一门语言的影响力在发布后的第一个十年才真正显现:语言的设计决定其上限,而生态的建设决定其实际达到的高度。SysML v2 的上限已经由形式语义与标准接口设定,接下来的十年,将决定这个上限被兑现多少。
然而,方向已经不可逆转。当一门语言拥有了形式语义、标准接口与开放的生态,它就不再是某个厂商的工具,而成为工程共同体共享的知识基础设施。SysML v2 的真正遗产,不在于它修复了 SysML v1 的多少缺陷,而在于它把系统工程推向了一个新的认知水位:系统的知识可以编码、可以计算、可以被机器与人类共同解释。从图纸到文档,人类用了几百年;从文档到模型,人类用了五十年;而从模型到"可推理的知识体",SysML v2 是第一个把这条路铺完的技术事件。未来的工程史回望这个时刻,或许会把它视为与有限元方法、CAD 同等量级的转折——一次关于"工程知识如何存在"的转折。
点击阅读原文,了解更多!
广而告之:
达谛咨询:FMEA培训辅导案例软件
重塑FMEA本质、建构预体系!
感兴趣者扫码联系: