ARTICLE · 1351997
别信跑分,信你自己的文档:ACSAI“8选2”模型实测

企业选大模型时
最容易找到的是排行榜,最难回答的却是一个朴素问题:
把我们每天都在处理的文档交给它,能不能稳定做对?一次要等多久,又要花多少钱?
公开跑分当然有参考价值,但它测试的是统一题库。真正进入业务后,模型面对的是合同、报告、询盘、企业材料和并不整齐的数据。企业最终购买的,也不是一个漂亮分数,而是可重复交付的结果。
为此,ACSAI 模型评测组拿出6份真实业务文档,让8组模型配置完成同一项结构化抽取任务,并逐项记录质量、速度、Token消耗和成本。这不是一次泛泛的模型横评,而是一场目标明确的“8选2”。
这里的“2”,不是综合能力排行榜上的前两名,而是在当前样本、Prompt和验收标准下,更适合真实文档抽取任务的两组配置。
01
不用公开题库
用真实业务文档
[测试方法]
本次测试使用6份真实业务文档,每份截取约3000字正文。模型需要返回结构化JSON,包含四类信息:
摘要
提炼文档的核心内容
实体
识别文档中的关键对象
归属
判断文档
属于哪个预设类别
置信度
为后续自动执行
或人工复核提供参考
6份文档均已进行脱敏处理,并统一编号为样本A至样本F。评测组为每份文档标注了正确归属,其中两份样本需要结合前后句推理,专门用来区分模型是真的理解了上下文,还是只抓住了表面关键词。对外文章不披露原始机构、企业、项目或原始分类名称。
所有候选模型使用同一套Prompt和相同任务参数,最终测试统一设置为 max_tokens=2500。评测脚本逐次保存输入Token、输出Token、响应时间、归属结果和置信度,再按照人工真值核对。
这套设计有三个特点:
真实:
样本来自业务现场,不是模型可能见过的公开题库
可核:
关键字段有人工真值,结果不是凭感觉判断“写得不错”
可复现:
Prompt、参数、Token和延迟均有记录,可在相同环境下复跑。
同时也要说明边界:只有6份文档,任务仅为结构化抽取,结果不能外推为代码、数学、创作或综合智能排名。它回答的是“谁更适合这项任务”,不是“谁在所有任务里最强”。
02
质量、速度和
成本要放在一起看
[完整结果]
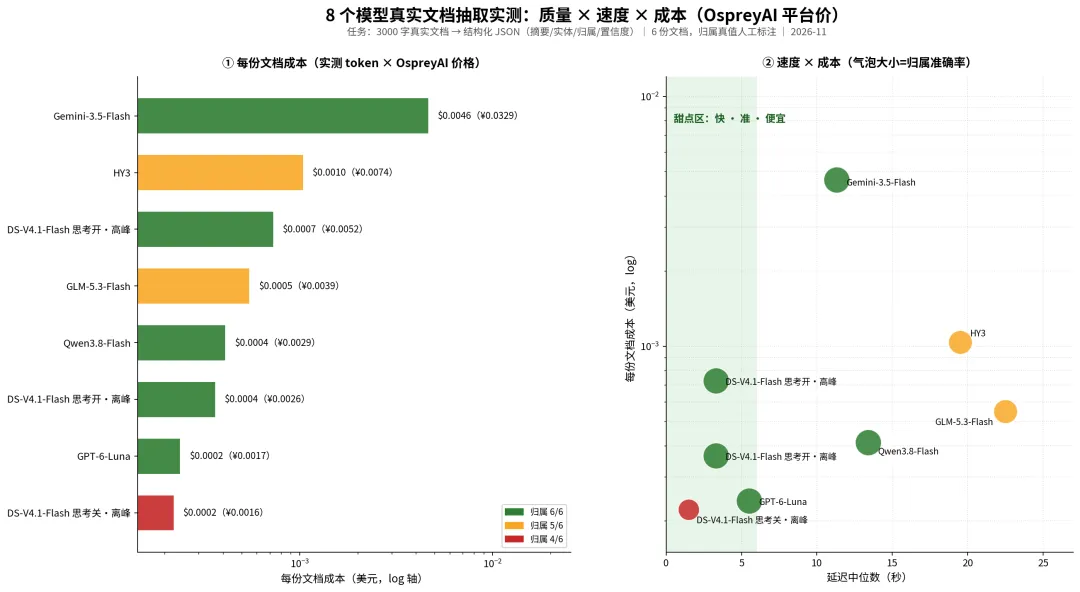
8组模型配置真实文档抽取实测。气泡大小表示归属准确率,成本按实测Token数与ACSAI平台价计算。
左图显示每份文档的实际处理成本;右图把延迟与成本放进同一个坐标系,气泡大小表示归属准确率。越靠近左下角,同时气泡越大,越接近“快、准、便宜”。
核心结论:8选2
把八组配置放到同一张成绩单上,真正同时越过三道门槛的,只有 GPT-6-Luna 和 DeepSeek-V4.1-Flash(思考开启):6份文档全部分对,响应保持在秒级,处理一份文档的成本也压在0.003元以内。
其他候选并非没有可取之处,只是没有同时守住准确率、时延和成本。有的响应时间被拉长到数倍,有的单份成本超过前两组10倍,还有的虽然标签判断正确,置信度却无法支撑自动分流。对企业而言,这些差异决定了模型能否真正进入批量工作流。
因此,“8选2”不是给模型排一个笼统的名次,而是在这项具体任务里,找出更接近生产要求的两组配置。
为了避免一张图承载过多信息,下面把原始记录拆成两张表。
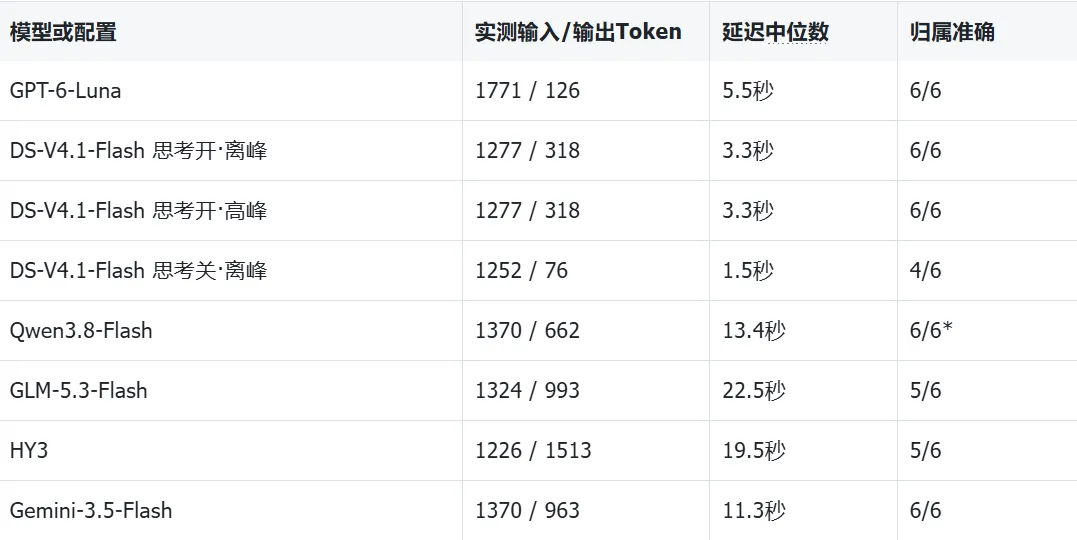
质量、Token与响应速度
Qwen3.8-Flash的归属为6/6,但置信度出现0.0与0.9混用、缺少区分度的情况,无法直接支撑“高置信自动执行、低置信转人工”的分档。
价格与单份文档成本
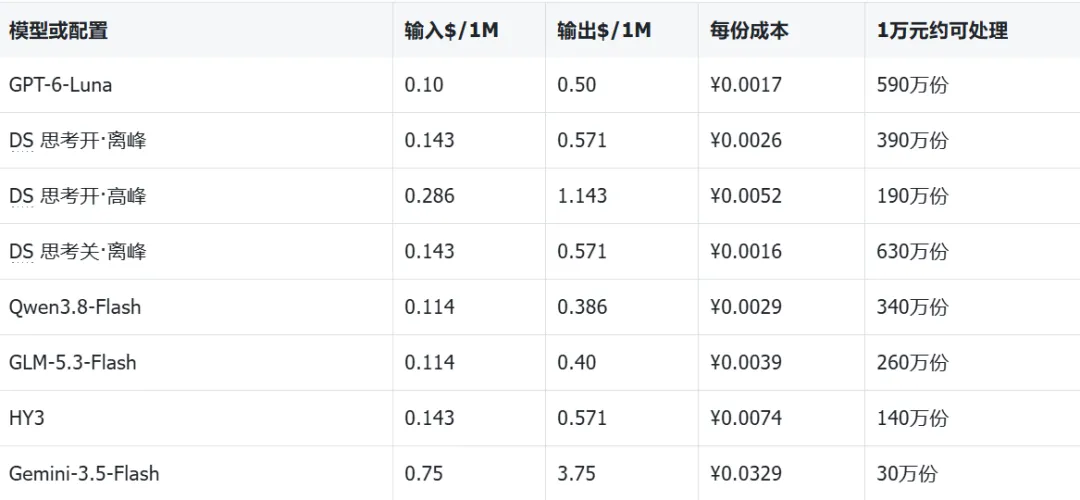
价格采用2026年11月13日ACSAI平台default组基准价;万元处理量为理论换算,不含OCR、检索、服务器、失败重试和人工复核。实际价格与可用线路以平台实时页面为准。
在这项任务里,GPT-6-Luna与DeepSeek-V4.1-Flash(思考开启)同时达到6/6归属准确、秒级响应,并把单份文档成本控制在3厘钱以内。
这并不代表它们在所有任务中都优于其他模型。它只说明:在3000字中文文档的结构化抽取上,这两组配置更接近本次测试设定的质量、速度与成本平衡点。
03
数据里藏着哪些取舍?
[逐项看]
3.1
GPT-6-Luna:
输出短,综合成本最低
GPT-6-Luna平均输入1771 Token、输出126 Token,延迟中位数5.5秒,6份归属全部正确。由于输出相对克制,单份文档成本约0.0017元,是本次6/6配置中最低的一组。
这组数据说明,单任务成本不只取决于标价,也取决于模型最终输出多少Token。结构化任务里,能按照要求简洁返回,本身就是成本优势。
3.2
DeepSeek思考开启:
速度更快,离峰更划算
DeepSeek-V4.1-Flash开启思考后,输入约1277 Token、输出约318 Token,延迟中位数3.3秒,归属准确率6/6。按照离峰价格计算,单份约0.0026元;进入高峰时段后约0.0052元。
本次价格口径中的高峰时段为工作日09:00至12:00、14:00至18:00(北京时间),其余工作日时段以及周末为离峰。对于不要求即时完成的批量任务,排队到离峰执行,可以直接降低模型费用。
3.3
关闭思考:
快了两秒,却错了两份
同一DeepSeek模型关闭思考后,延迟降到1.5秒,输出也从318 Token缩短到76 Token,单份成本约0.0016元。
代价是归属准确率从6/6下降到4/6。两个需要跨句推理的样本直接返回unknown。为了省下约2秒和极少的调用成本,后续却要增加人工处理,这在批量生产里往往是更差的交易。
3.4
Qwen:答案正确
不代表置信度可直接使用
Qwen3.8-Flash完成了6/6归属,但置信度缺少稳定区分。若系统只需要最终标签,它的结果可以参考;若要根据置信度决定是否自动执行,则必须先重新校准,不能直接照搬。
3.5
其他模型:问题
不在一个指标,而在组合
GLM-5.3-Flash在本次测试中为5/6,延迟22.5秒,单份约0.0039元;HY3为5/6,延迟19.5秒,单份约0.0074元。Gemini-3.5-Flash达到6/6,延迟11.3秒,但由于输入输出单价较高、输出达到963 Token,单份成本约0.0329元。
这些结果再次说明:模型名称中的“Flash”并不自动等于低延迟或低成本。企业选型时必须把结果质量、输出长度、线路价格和重试成本放在一起看。
04
真正影响选型的发现
[三个]
关闭思考,省下的
是小钱,丢掉的是准确率
DeepSeek-V4.1-Flash关闭思考后,单份成本从离峰时的约0.0026元降到0.0016元,延迟也从3.3秒缩短到1.5秒。账面上确实更快、更便宜,但代价是归属准确率从6/6掉到4/6,两个需要跨句推理的样本直接返回unknown。对批量任务来说,为这点成本差额增加人工复核,通常并不划算。
Gemini的真实成本
被长输出进一步放大
Gemini-3.5-Flash在6份文档上全部判断正确,但输入、输出单价分别达到0.75美元和3.75美元/百万Token,平均输出又有963 Token,最终单份成本约0.0329元,是GPT-6-Luna的约19倍,准确率却没有进一步提升。模型名称里的“Flash”,并不能直接等同于低成本。
离峰调度,是可以
直接兑现的成本杠杆
DeepSeek-V4.1-Flash开启思考后,高峰与离峰使用的是同一套模型配置,但单份成本可以从约0.0052元降到0.0026元。文档抽取、归档和批量审核本就适合排队执行,把非紧急任务安排在工作日高峰之外或周末,费用可以直接减半。若线路支持缓存,约1000 Token以上的固定Prompt模板还可利用缓存命中继续降低重复输入成本;本次材料记录的缓存价格为0.003美元/百万Token,具体以平台实时规则为准。
05
模型答对一次
还不等于能上线
[工程避坑]
先给推理和输出留足预算
第一轮测试把max_tokens设为600时,GLM-5.3-Flash出现空输出,Gemini-3.5-Flash还把英文推理内容带进了正文。最终测试将上限提高到2500后,才获得可比较的完整结果。
这不意味着所有任务都必须固定使用2500。更稳妥的做法是根据字段数量、文档长度和模型模式压测,观察截断率,再设置安全余量。对于本次思考型配置,输出上限低于1000时已经暴露出明显风险。
JSON解析必须容错
评测脚本会从返回内容中提取第一个完整JSON对象,避免模型在代码块之外附加说明。进入生产环境后,还应增加Schema校验、必填字段检查、枚举值校验,以及空输出、超时和解析失败后的重试或降级。
置信度必须经过业务校准
不要把模型随口给出的0.9当成真实概率。先在人工标注样本上观察不同置信度区间的准确率,再决定自动执行阈值;低于阈值的任务转人工复核。
最终上线时,建议至少同时监控四项指标:字段准确率、格式成功率、单任务总成本、人工介入比例。只盯着平均延迟或Token单价,很容易得到片面的结论。
06
企业如何复用这套
[方法]
不需要照搬这6份文档,也不需要先做复杂平台。更实际的做法是建立一套属于自己的小型验收集:
1
挑选真实样本
覆盖常见情况、边界情况和过去容易出错的难例,并完成授权与脱敏
2
建立人工真值
明确每个字段的正确答案与验收规则
3
固定测试条件
候选模型使用同一Prompt、参数和输出格式
4
完整记录
保存质量、延迟、输入输出Token、失败重试和人工介入
5
选择主模型与备选模型
根据业务优先级确定质量、速度和成本的权重,并准备异常降级方案。
样本规模可以从20至50份开始。随着业务增长,把新出现的错误样本持续加入验收集,模型切换和Prompt升级都先经过回归测试。
07
让多模型实测
和接入少走弯路
[ACSAI]
ACS OspreyAI是面向开发者和企业的一站式多模型API服务平台。一个API Key即可调用Claude、Gemini、GPT、GLM、Kimi、Qwen、DeepSeek、腾讯混元、MiniMax H3等国内外主流模型。
平台兼容OpenAI、Anthropic等主流API协议。对于基础对话和文本生成项目,通常只需修改Base URL、API Key和模型名即可开始迁移;工具调用、多模态、推理参数和返回字段存在模型差异,仍需结合接口文档和真实样本验证。
在模型选型阶段,团队可以保留同一套测试脚本,通过统一API切换候选模型,收集返回结果、延迟与usage数据。选定方案后,再沿用相同接口接入业务,减少分别申请和维护多套模型账户的工作。
统一充值、统一账单、用量查询和模型灵活切换,也便于团队按项目核算真实成本。当业务对时效和质量的要求发生变化时,可以重新运行验收集,再决定是否调整模型或线路。
登录 open.ospreyai.cn,通过统一API调用国内外主流模型,用你自己的任务完成一次可复现的选型测试。
这次测试最重要的结果
不是挑出了两个名字,而是验证了一件事:
榜单负责帮你缩小范围,真实业务文档才负责做最终选择。
同一个模型,思考开关不同,准确率可以从6/6降到4/6;同样叫Flash,单份成本也可能相差数十倍;同样归属正确,置信度是否可用,又会决定它能不能进入自动化流程。
模型选型不是一次采购动作,而是一套持续验证机制。把自己的样本、人工真值、成本记录和工程兜底建立起来,模型再多、价格再变,企业都能做出更稳妥的选择。
测试口径与数据来源
本文依据ACSAI 模型评测组于2026年11月13日完成的评测记录整理。样本为6份真实业务文档,每份约3000字;任务为摘要、实体、归属和置信度的结构化抽取;同一Prompt,最终测试max_tokens=2500。结果只适用于本次样本、任务、参数与线路环境,不构成模型综合能力排名。
成本按实测输入输出Token与测试当日ACSAI平台default组价格计算。各模型另有不同折扣分组,实际价格、线路和活动以 ACSAI价格页实时信息为准。万元处理量为理论换算,不包含OCR、检索、服务器、失败重试和人工复核。
枭毅-算力引擎
加入行业社群
结交志同道合的朋友
枭毅-算力引擎
SISI
商务合作丨欢迎加入