ARTICLE · 1352208
毕业设计:大数据项目黄河水质分析系统(源码)
目录
一、项目背景
二、技术介绍
三、功能介绍
四、代码设计
五、系统实现
一、项目背景
黄河是中华民族的母亲河,流域面积约75万平方公里,承载着全国约15%的耕地灌溉和12%的人口用水需求。然而,长期以来,黄河流域面临着水资源短缺、水污染加剧、生态退化等严峻挑战。随着工业化、城镇化的快速推进,流域内点源与面源污染交织,水质时空分布特征复杂,传统的人工监测与统计方法已难以满足精细化管理需求。
当前,黄河流域已建成一定规模的水质自动监测网络,积累了海量的历史监测数据,涵盖pH、溶解氧、高锰酸盐指数、氨氮、总磷等多项关键指标。然而,这些数据分散于不同部门和系统中,数据孤岛现象严重,缺乏有效的整合与深度挖掘手段,大量数据仅用于简单的达标判断,其蕴含的时空演变规律、污染来源解析和预警预测价值远未充分释放。
与此同时,大数据技术的快速发展为水环境管理提供了新的思路和方法。通过Hadoop、Spark等分布式计算框架对海量监测数据进行高效存储与处理,利用数据挖掘和机器学习算法识别水质变化的驱动因素,借助可视化技术实现监测结果的直观呈现,能够有效提升水环境管理的科学化、精细化水平。
基于上述背景,本项目旨在设计并实现一个黄河水质分析系统。系统将整合黄河流域多源水质监测数据,运用大数据技术构建数据存储与计算平台,实现水质状况的实时评价、时空演变分析、异常预警及趋势预测等功能。项目的实施有望为黄河流域水污染治理和生态保护提供数据支撑与决策辅助,助力流域高质量发展。
本项目选题紧密结合国家黄河流域生态保护和高质量发展重大战略需求,具有明确的问题导向和应用价值,同时也为大数据技术在水环境领域的落地应用提供了一个具体实践案例。
二、技术介绍
本系统采用前后端分离的架构设计,前端基于Vue3框架构建用户界面,利用其组合式API实现高效的组件化开发,配合Vue Router完成多页面路由管理,Vite作为构建工具提供极速的开发体验。数据可视化层面选用ECharts,支持丰富的图表类型以满足水质监测数据的多维度展示需求,包括折线图、柱状图、散点图及地理信息热力图等。
后端采用Java 8结合Spring Boot 2.7框架,借助其自动配置、依赖注入等特性快速构建RESTful API服务层,负责业务逻辑处理、数据接口封装及前端交互响应。大数据存储与计算层基于Hadoop 3.3.4分布式文件系统(HDFS)实现水质历史监测数据的高可靠存储,利用MapReduce并行计算框架对海量水质数据进行批量离线分析,包括各监测断面水质类别的统计、污染物浓度的时序变化趋势计算以及重点污染指标的排名聚合等任务。项目构建管理使用Maven管理后端Java依赖,npm管理前端JavaScript依赖,确保项目构建流程标准化与可重复性。
三、功能介绍
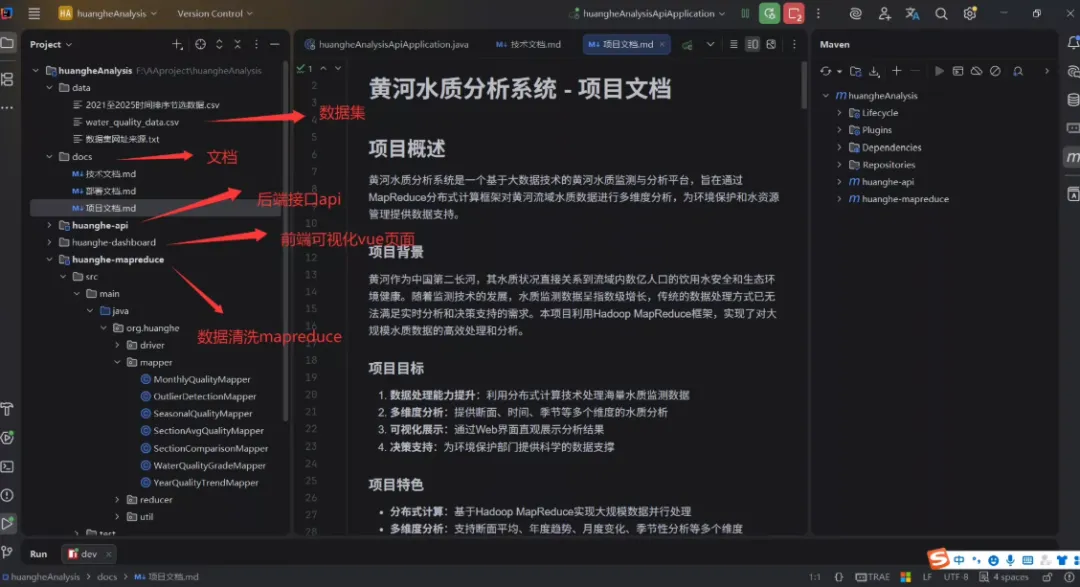
- 基于Hadoop MapReduce分布式计算,处理海量水质监测数据 - Vue3 + ECharts + Element Plus 现代化前端界面 - Spring Boot 后端REST API,完整的MVC架构 - 7大核心分析功能:断面平均、年度趋势、月度变化、季节性分析、水质等级分布、异常值检测、断面对比。
本系统基于Hadoop MapReduce分布式计算框架,对黄河流域海量水质监测数据进行高效批量处理。监测数据以结构化文本形式存储于HDFS分布式文件系统中,通过自定义MapReduce作业完成数据清洗、指标聚合与多维度统计分析,充分利用集群并行计算能力,显著提升大规模历史数据的处理效率。
前端界面采用Vue3 + ECharts + Element Plus构建,Vue3的组合式API确保页面逻辑清晰可控,Element Plus提供丰富的UI组件库支撑快速布局,ECharts实现监测结果的多形式可视化呈现,为用户提供直观、流畅的交互体验。后端基于Spring Boot构建RESTful API服务,遵循完整的MVC架构模式,Controller层负责请求接收与响应封装,Service层承载核心业务逻辑,DAO层通过JDBC完成关系型数据库的持久化操作,各层职责清晰、解耦良好。
系统围绕水质分析的实际业务需求,设计了七大核心分析功能:
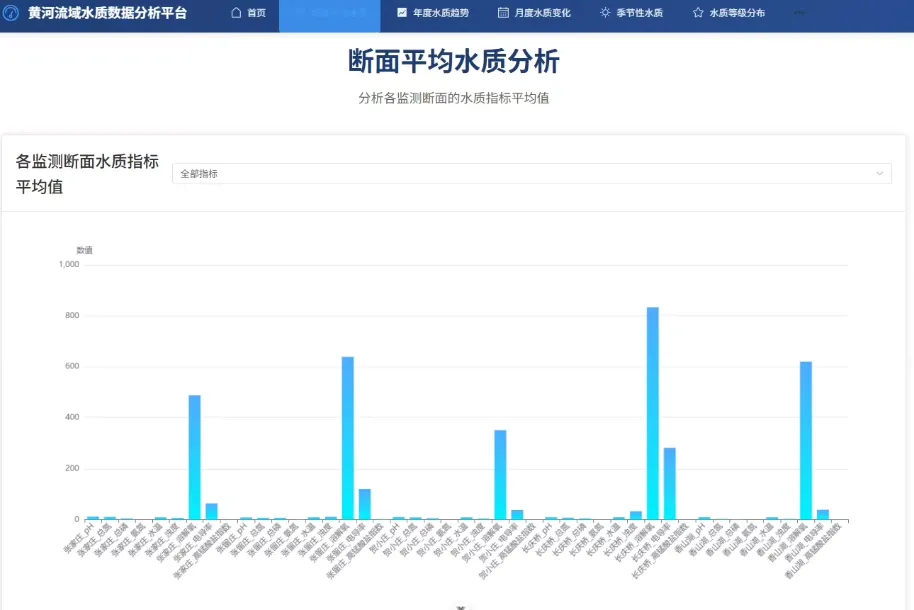
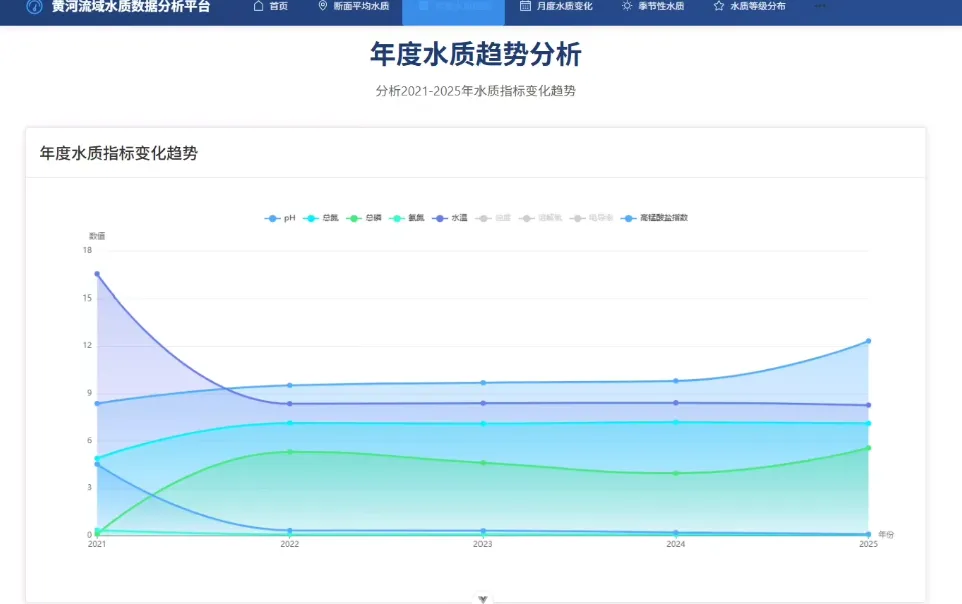
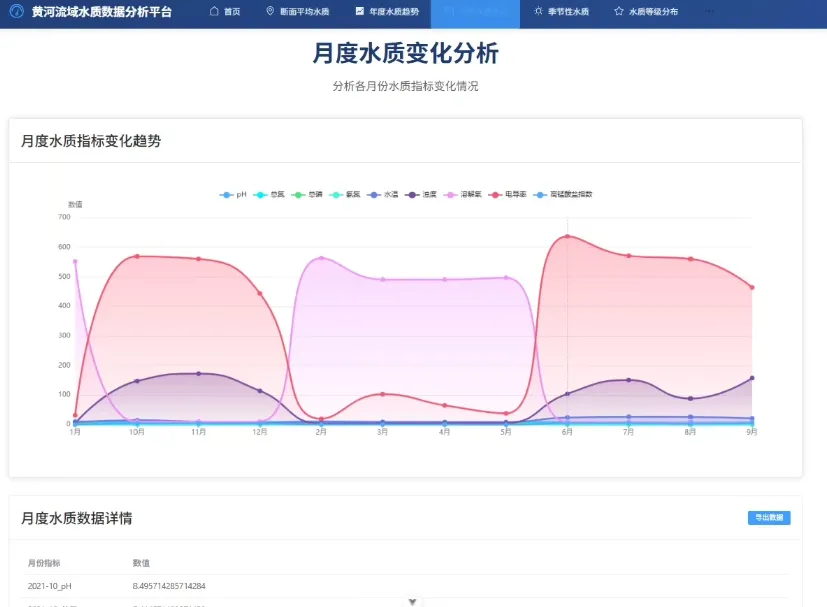
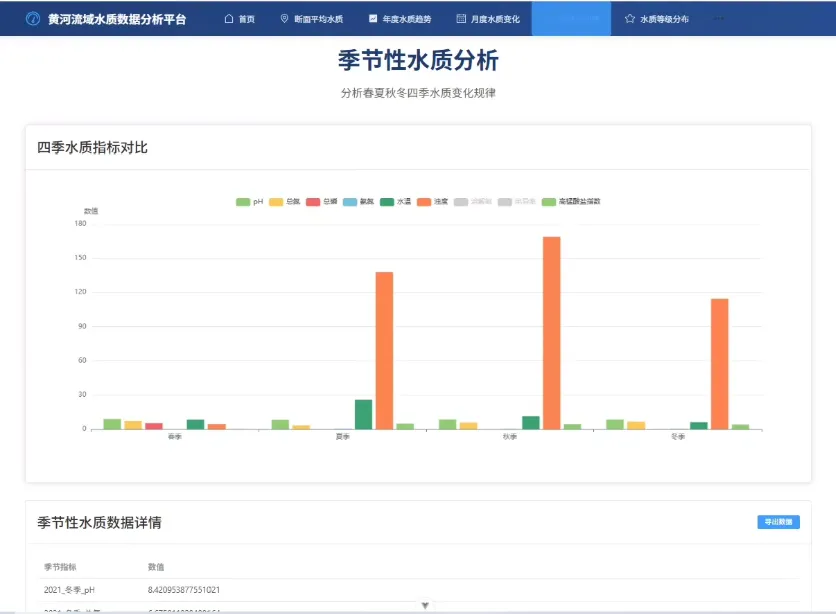
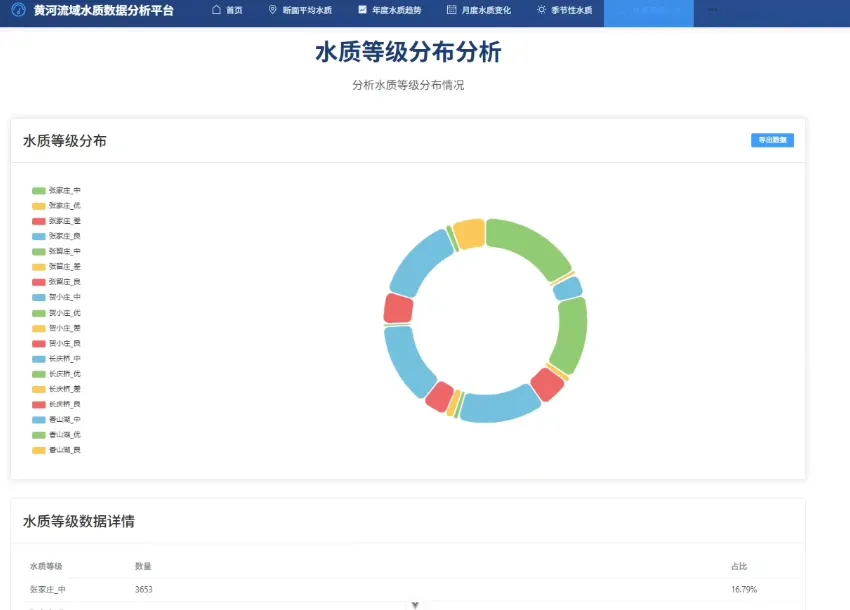
断面平均分析对各监测断面的主要水质指标进行均值计算与排序,辅助识别重点监控断面;年度趋势分析以年份为粒度呈现各指标的年际变化规律,评估污染治理成效;月度变化分析聚焦年内各月份指标波动情况,揭示季节性污染特征;季节性分析按春、夏、秋、冬划分时段,探究气候因素对水质的周期性影响;水质等级分布依据《地表水环境质量标准》对各断面进行Ⅰ~Ⅴ类分类统计,直观反映整体水质结构;异常值检测基于统计学方法识别监测数据中的离群点,为数据质量核查提供线索;断面对比分析支持多断面间同一指标的横向比较,辅助差异溯源与治理优先级判定。七大功能模块协同配合,形成从宏观趋势到微观异常的全方位水质分析能力。
四、代码设计
// Mapper: 解析监测记录,提取断面ID、年份及水质指标 public class WaterQualityMapper extends Mapper<LongWritable, Text, Text, WaterQualityWritable> { private Text outKey = new Text(); private WaterQualityWritable outValue = new WaterQualityWritable();
@Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String[] fields = value.toString().split(","); // 字段: 监测站ID, 断面名称, 日期, pH, 溶解氧, 高锰酸盐指数, 氨氮, 总磷 String stationId = fields[0]; String date = fields[2]; String year = date.substring(0, 4); double ph = Double.parseDouble(fields[3]); double doVal = Double.parseDouble(fields[4]); double permanganate = Double.parseDouble(fields[5]); double ammonia = Double.parseDouble(fields[6]); double totalP = Double.parseDouble(fields[7]);
outKey.set(stationId + "_" + year); outValue.set(ph, doVal, permanganate, ammonia, totalP, 1); context.write(outKey, outValue); } }
// Reducer: 计算各指标平均值 public class WaterQualityReducer extends Reducer<Text, WaterQualityWritable, Text, Text> { @Override protected void reduce(Text key, Iterable<WaterQualityWritable> values, Context context) throws IOException, InterruptedException { double sumPh = 0, sumDo = 0, sumPerm = 0, sumAmmonia = 0, sumTotalP = 0; int count = 0; for (WaterQualityWritable val : values) { sumPh += val.getPh(); sumDo += val.getDoVal(); sumPerm += val.getPermanganate(); sumAmmonia += val.getAmmonia(); sumTotalP += val.getTotalP(); count += val.getCount(); } String result = String.format("pH=%.2f, DO=%.2f, CODMn=%.2f, NH3-N=%.2f, TP=%.2f, 样本数=%d", sumPh / count, sumDo / count, sumPerm / count, sumAmmonia / count, sumTotalP / count, count); context.write(key, new Text(result)); } }
五、系统实现