ARTICLE · 1354961
把50款企业软件「穿透」这事,开源团队把智能体检索做绝了!
道心界报道
道心界报道

Token 消耗直降 90%,50 款企业数据源毫秒级穿透。
这是当下一个极具冲击力的真实反差:传统智能体每查一次企业文档,都要反复调用协议、烧掉惊人算力。
大模型掌握了全网公开知识,却对企业内部真正发生的事情一无所知,盲目堆叠协议往往引发算力灾难。
面对四分五裂的协作工具,一群工程师选择重构上下文底座,彻底改写智能体调用知识的方式。
他们不再依赖笨重的多轮协议往复搜寻,而是直接在底层构建跨应用的统一知识表征与权限拓扑。
这就是在 GitHub 斩获 3.3 万星的开源项目 Onyx:全域上下文与智能体混合检索底座。
要理解这套系统解决的问题,先看清传统方案需要突破的死结在哪里。
随着大模型进驻企业,协同软件从几十个平台不断膨胀,智能体检索上下游链路彻底割裂。
底层矛盾集中在三个致命维度,任何一处卡壳都会导致协同系统彻底崩塌:
Token 消耗高筑。 传统智能体依赖无索引的多轮协议反复探测,单次复杂问答就要空耗数万枚 Token。
权限隔离断裂。 异构软件的权限规则错综复杂,普通检索极易发生越权检索与敏感商业机密泄漏。
检索延迟冗长。 面对几十个独立接口线性轮询,一次深度调研耗时往往长达数十秒甚至直接超时。
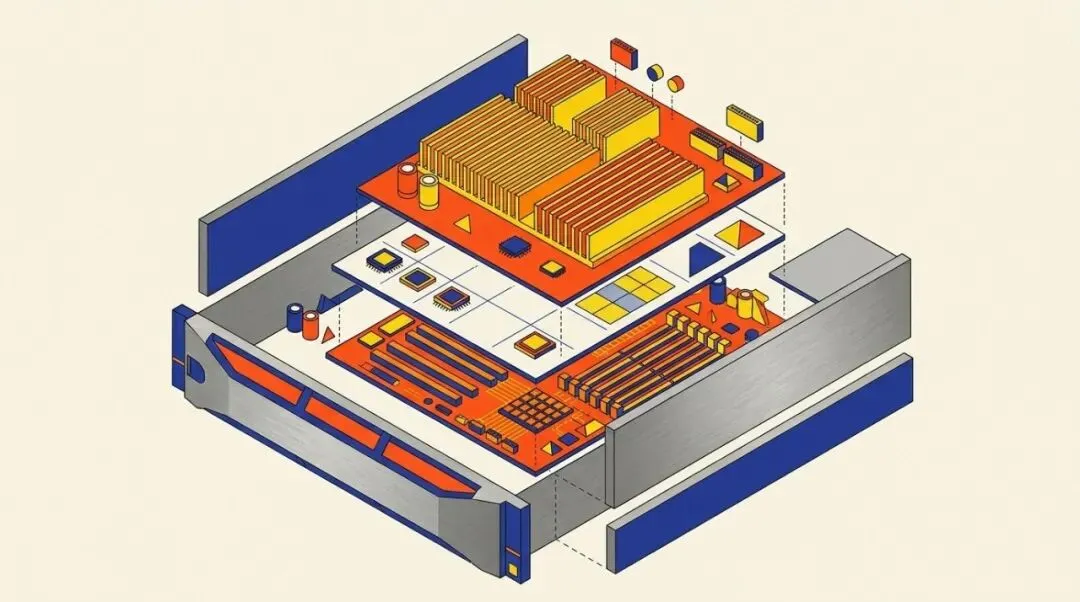
针对上述瓶颈,该项目给出的技术路径不是做一个简单的套壳工具,而是从底层重构了一套完整的闭环系统。
从底层数据吞吐到上层执行,整套技术栈自底向上清晰地划分为四个核心层级:
第一层:异构连接底座。 预置 50 余款主流办公软件连接器,自动同步文档、元数据与细粒度访问权限。
第二层:混合索引中枢。 摒弃粗暴的关键词匹配,采用自适应向量与稀疏检索融合架构,实现毫秒级事实抽取。
第三层:智能体协同生态。 统一调度深度研究流与自定义工作流,最关键的设计在于,核心能力可插拔、可由领域专家自主扩展。
第四层:安全隔离运行时。 针对严苛的企业生产环境,该运行时原生提供四项关键能力:
一是自托管气隙隔离。 全流程支持私有化部署,索引与向量模型均在受信任边界内闭环运转。
二是多引擎联网增强。 无缝对接多款主流实时搜索引擎,并将动态抓取与内网事实实时对齐。
三是隔离代码沙箱。 在安全受限环境中即时执行脚本,高效处理中间产物与复杂数据流。
四是全模态语音交互。 原生集成文本转语音与语音识别能力,让多端沉浸式指令输入零门槛落地。
简言之,就是让智能体无需在几十个软件接口间反复踩坑,一秒调取绝对可靠的团队事实。
架构跑通之后,真正的说服力最终取决于一个问题:这套方案在真实生产负载下,到底能不能兑现性能承诺?
传统检索是割裂线性的,而这套系统在底层构建了持续自演进的高效数据同步机制:
它在文档变动瞬间即时增量索引,并根据智能体交互反馈动态优化召回权重。
在公开披露的基准压测与真实案例中,对比数据非常直观:相比无索引轮询,上下文检索耗时缩短 80% 以上,Token 损耗直降 90%。
核心研发团队有一句话总结得非常到位:「我们想要的是一个真正懂团队业务的 AI 同事,而不是一个每天都要从头培训的实习生。」
快速体验与部署指令
curl -fsSL https://onyx.app/install_onyx.sh | bash
在纯粹的架构验证之外,全球开源社区与产业端的落地进展同样迅速而扎实。
在跨国团队与金融、研发密集型组织中,该系统已成为保障数据主权的核心基础设施。
这种开放、自托管且深度兼容任意主流大模型的工程范式,正在彻底取代黑盒式的臃肿中间件。
回看当下的智能体技术演进,能清晰感受到一种强烈而真实的分水岭。
当无数人还在追逐表面的概念噱头与跑分泡沫时,有一群工程师选了一条更硬核、更扎实的路——
用严密的索引与自托管底座,给每一家企业的核心资产筑起安全高效的上下文防线。
把高高在上的前沿算法,真正塞进每一台终端、每一条真实业务流水线。
摒弃虚浮的炒作,把算力沉淀为坚固的生产工具,这或许才是硬核技术最该去的地方。
编辑:道心界