ARTICLE · 1356472
把 PDF 涂黑以后,原文真的消失了吗?
发一份文件之前,把姓名、联系方式、金额等内容涂黑,是很常见的操作。黑框盖住文字,页面看起来已经处理干净,于是我们把文件发了出去。
但接收者打开文件后,有时仍然能搜索到被遮住的词,或者把整页文字复制到另一个窗口,看见原本应该消失的内容。
问题并不一定出在某种高明的“破解技术”。更直接的解释可能是:我们改变了页面显示的样子,却没有移除文件保存的文字。
上一篇关注数据去了哪里。这一次,我们看一份准备发送的 PDF:画面上看不见的内容,是否也已经从交付文件里消失?
01|一份看起来处理好的说明书
先看一个虚构案例。文中的文件、标记、账号与操作结果均用于解释机制,不对应真实个人或组织,也不是本文已经完成的实验。
某个团队要对外分享一份设备测试说明。对方只需要知道测试方法和公开参数,不应看到内部项目代号、报价以及评审批注。
维护者在 PDF 编辑器中找到相关段落,用黑色矩形盖住项目代号“雾蓝纸鹤-9R2”和虚构报价“63800 元”。他逐页检查,确认画面中已经看不见这两项信息,再另存了一份文件。
如果这些黑框只是覆盖在页面上的绘图对象,原来的文字对象又没有被移除,那么接收者使用的文本提取功能,就可能仍然读到原文。视觉检查通过,文本检查却不通过,这两件事并不矛盾。
这里不应直接推导出“所有黑框都无效”。有的工具在应用正式删改后,也会用黑色区域显示删改位置。外观看起来相似,内部处理却可能完全不同。
因此,不能只问“最后是不是一块黑色”。需要确认的是:这个操作增加了一个遮挡物,还是移除了应当删除的内容?保存后的文件又留下了什么?
假如团队还在评审批注里写了同一个报价,正文中的金额即使被正确删除,批注仍然可能构成另一条披露路径。只检查那一个矩形,覆盖不了整个文件。
02|PDF 不是一张只能用眼睛看的纸
为了理解这个问题,可以把检查对象分成三个方面:页面外观、可被读取的内容,以及其他附带信息。这是一种检查框架,不是说每份 PDF 都固定有三个独立图层。
页面外观是阅读器呈现给我们的画面。文字、图片、绘图对象等经过渲染,组成最终页面。某段文字被其他对象挡住,并不必然意味着它的底层表示已经被删除。
可被读取的内容包括文本对象,也可能包括扫描件经 OCR 识别后生成的文字。OCR 就是从图像中识别文字的过程。在某些可搜索扫描 PDF 中,页面保留扫描图像,同时存在用于搜索、选择或复制的文字表示。Adobe 对可搜索扫描 PDF 的说明
这意味着,对扫描图片作了处理,还需要确认与之相关的识别文本是否同步处理。反过来,如果文件本来只有图像,没有可提取文字,那么搜索不到一个词,也可能只是它从未被识别过。
其他信息则需要单独检查,例如批注、文档属性和嵌入附件。它们不一定出现在当前页面上,却可能随文件一起交给接收者。
这种差别,在 AI 读取文件时尤其容易被忽略。一个文档助手可能使用解析器提取文本,也可能先识别页面图像;不同输入路径,能够看到的内容并不相同。不能因为自己在预览窗口看不见,就认定所有读取方式都看不见。
当然,如果某次助手输出了被遮盖的词,也不能立刻认定它读穿了黑框。旧对话、重复文件、批注或其他资料,都可能提供同一信息。只有核对实际输入,才能判断来源。
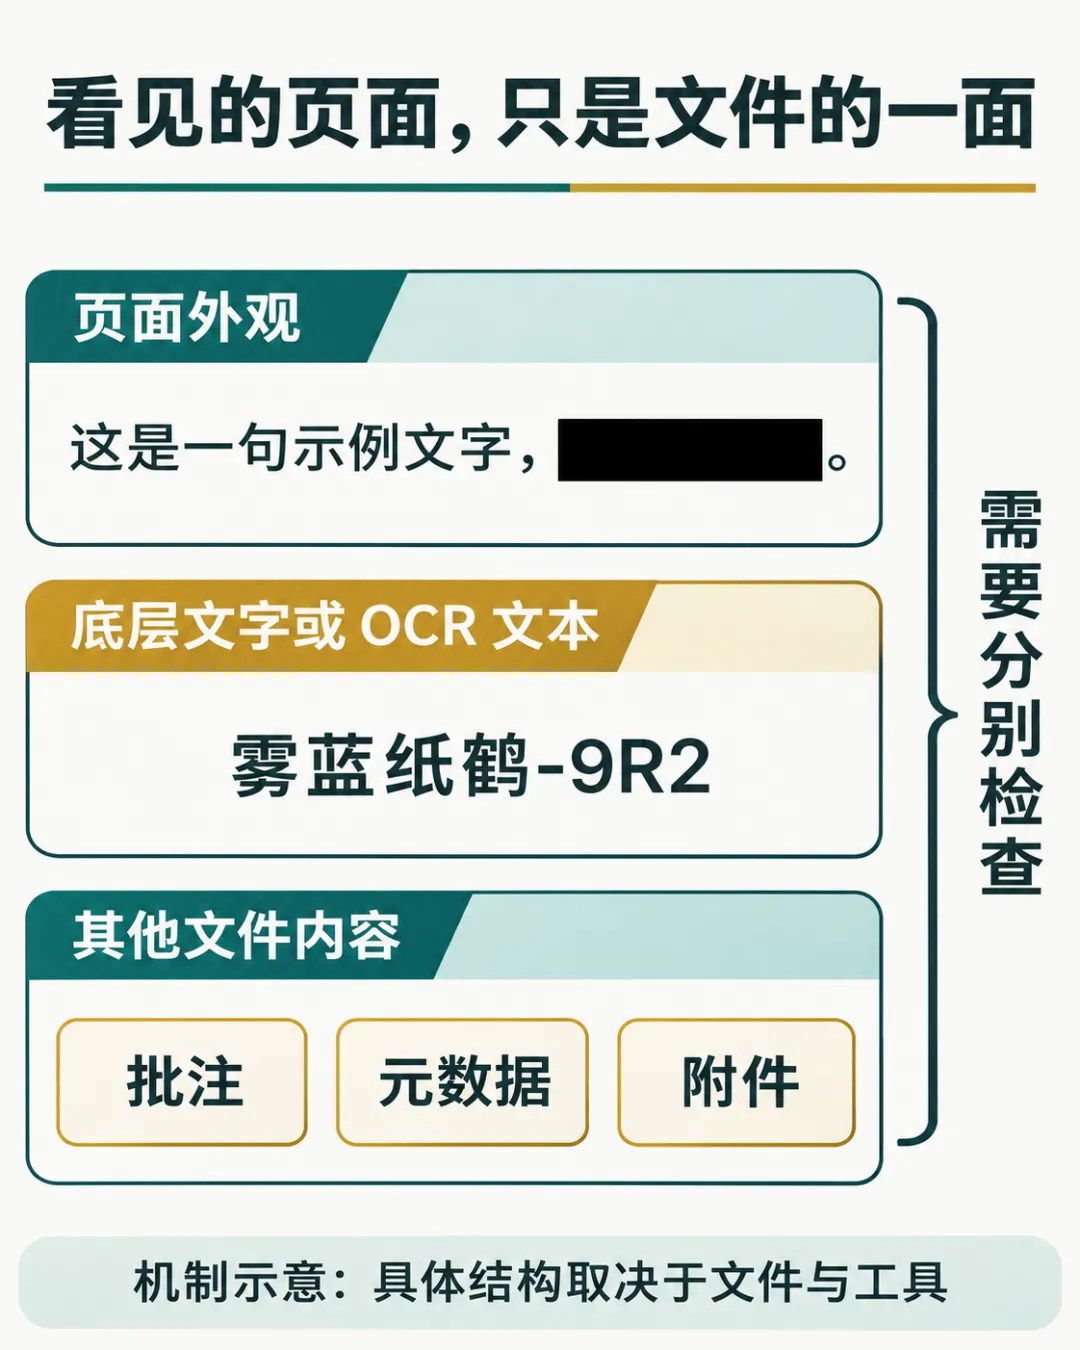
图 1|机制示意。并非所有 PDF 都有图中各类内容;OCR 文字与页面图像的组织方式取决于生成工具。图中的测试标记完全虚构。
03|画黑框、模糊、正式删改,分别做了什么?
画黑框,可能只是添加一个显示对象。只要原文还在文件里,文本读取或对象处理就可能绕开视觉上的遮挡。关键不在黑框的颜色,而在底层内容是否保留。
模糊和马赛克,通常是对图像外观作变换。它们可能保留部分形状、长度或上下文线索,保护程度取决于具体方法、参数和原图内容。不能把一种看起来很糊的效果,当成通用的隐私保证。
但也不能夸大为“所有打码都能恢复”。如果最终交付的纯图像中,目标区域的像素已经被不透明颜色实际替换,且没有原图、历史记录或其他副本,不能声称调亮图片就能从这些像素里读回原文。接收者仍可能结合语境猜测,但猜测不等于找回了原始内容。
正式删改,指使用工具专门提供的内容移除功能,选定需要处理的区域,并执行应用操作。Adobe Acrobat 的官方流程区分了标记删改与应用删改,还要求完成后保存;仅在页面上标记目标,并不等于已经完成处理。Adobe 正式删改流程
隐藏信息清理,处理的是另一组检查对象。Adobe 将文档清理作为单独功能,涉及元数据、批注等隐藏内容。Adobe 隐藏信息清理说明
正式删改主要回答“选中的内容是否被移除”,隐藏信息检查进一步回答“同样的信息或其他不应交付的信息,还在哪里”。两者需要配合,不能只完成一个就默认另一个也完成了。
产品菜单、语言和授权版本可能不同。实际使用时,应查清当前工具的功能说明,特别是处理对象、执行步骤与保存方式,不能只凭按钮上写了“打码”两个字作判断。
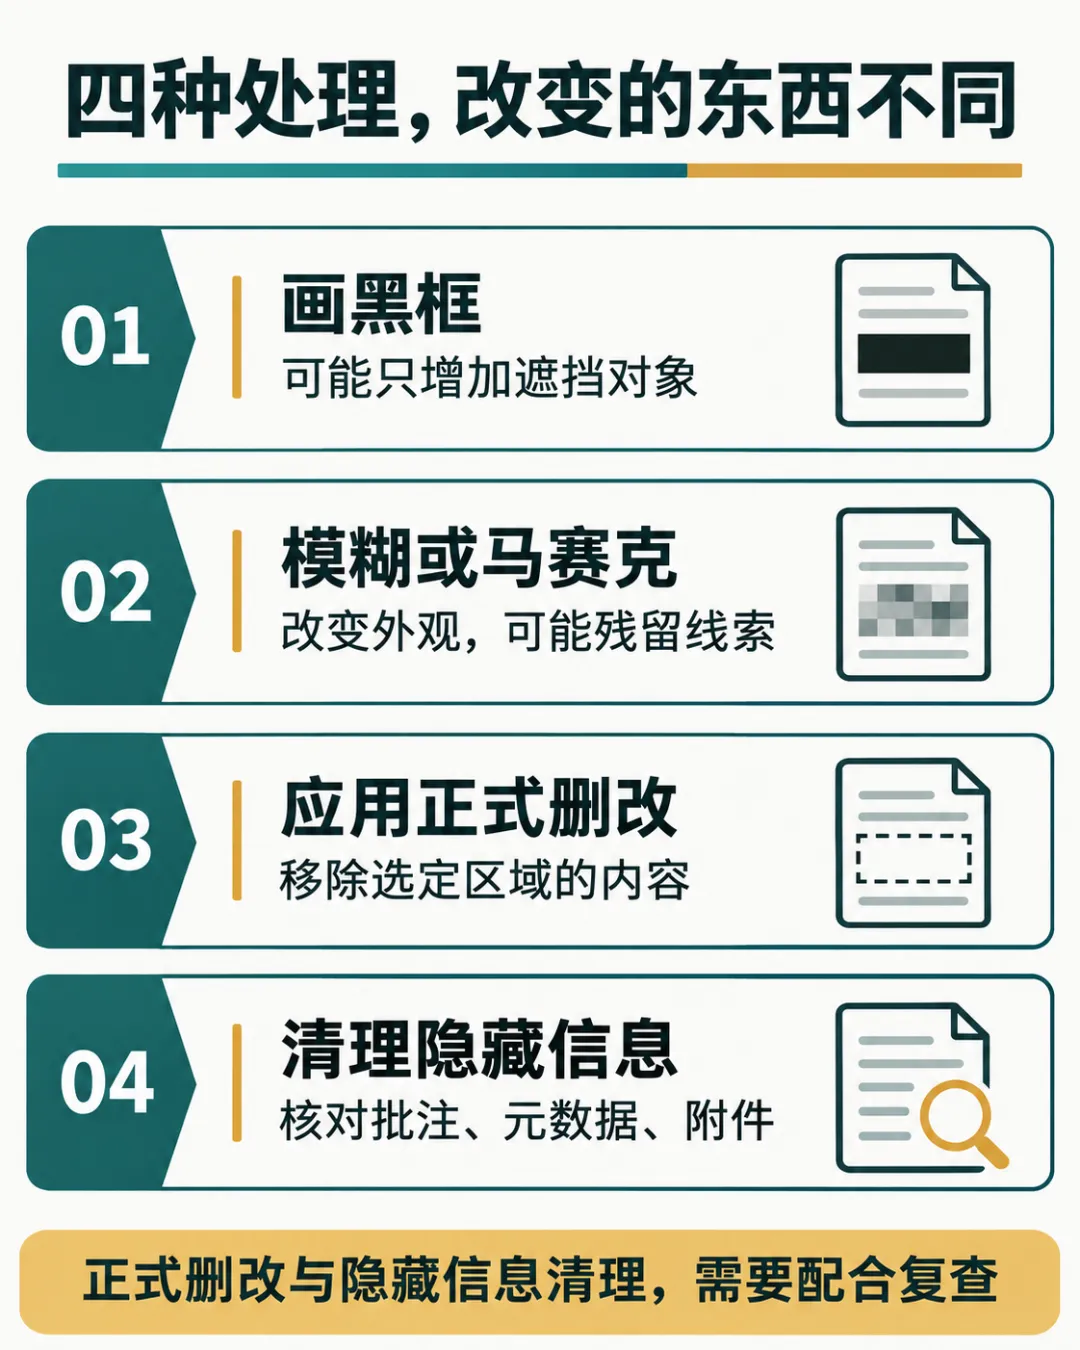
图 2|四种操作的作用不同,不是安全等级排名。具体工具对文字、图片和其他对象的处理能力,需要按实际版本核对。
04|转成图片,是不是就解决了?
把页面重新渲染为图像,再从处理后的图像建立一份新文件,能够改变内容的表示方式。对于确实只包含最终图像的新文件,它不再自动拥有旧 PDF 的那些文本对象。
但这里有几项前提:导出的确实是已处理画面;遮盖已写入图像像素;新文件没有重新夹带原文件、未处理页面或旧文字内容。
“另存为 PDF”“打印成 PDF”“压缩 PDF”这些操作的名称,本身不能说明它是否把页面完全变成了新图像,更不能说明所有附带信息都已清理。它们的输出结构取决于具体实现。
即使生成了纯图像,也仍要核对图像内容本身。边角的项目名、页眉里的内部编号、未遮完整的一行小字,都可能继续暴露信息。对这些可见线索运行 OCR,并不需要恢复被覆盖区域的像素。
另外,把整份长文转成图片会降低搜索、复制和无障碍阅读能力,还可能影响清晰度与文件大小。因此,不能为了省去检查,把所有文件一律变成低清截图。
更合适的选择是:按照交付需求使用明确的删改和清理流程;确实需要图像化时,把它当作一种经过验证的输出方案,并继续检查最终文件。对于必须保留的无障碍结构,也需要确认处理后仍满足接收者的阅读需要。
05|隐藏信息之外,还有语境泄露
假设团队已经正确删除项目代号和报价,清除了评审批注,文本提取也读不到目标内容。这能否说明接收者完全无法推断报价?
还需要看保留的内容。
换一个只允许公开总额、不允许公开单价的发布要求:如果说明中仍写着“设备共 20 台,总采购金额为 63800 元”,即使单价栏已被删除,读者仍可能根据总额和数量计算单价。这里的暴露来自公开保留的算术关系,不是黑框被移除了。若保护目标包含总价,那么保留这个金额本身就没有满足要求。
如果某个项目只有一次特定测试,文件又保留了精确日期、独特设备组合与公开活动名称,熟悉背景的读者也可能据此缩小项目范围。不过,缩小候选范围与确认真实身份之间,仍然需要额外证据。
所以,发布前不仅要列出“哪些字段要删除”,还要问“保留下来的信息组合,是否仍表达了不应披露的事实”。这种检查与前文讨论过的重新识别问题相通:单个字段看起来普通,组合后可能变得有辨识度。
也不要走向另一个极端,把所有信息都删掉。设备型号或关键测试条件一旦完全去除,说明书可能失去用途。可以优先保留完成公开任务所需的信息,将非必要的精确日期改成较宽范围,或者只公开方法描述与汇总结果。是否足够,需要结合接收者已知背景判断。
这不是要求每份文件都达到无法作出任何推断的程度,而是把保护目标写清楚:哪些事实不应被直接读出,哪些关联推断也需要降低,剩下的风险由谁确认。
06|怎样检查最终文件:六步做完再发送
下面是一套可以用自己有权处理的虚构材料实施的验证方法。它是方案,不是本文完成过的实验,也不能代替对某个软件的专门安全评估。
第一步:制作发布副本,写清处理目标。
保留原稿,在副本上操作。明确接收者需要什么、不应获得什么,以及最终通过附件还是共享链接交付。对于前面的案例,目标可以是:公开测试方法,移除内部代号、报价及讨论这两项内容的批注。
在虚构测试文件的正文、批注和文档属性中,分别放入不同的测试标记,例如“雾蓝纸鹤-9R2”“批注测试-4K”和“属性测试-6M”。标记分开,后续才容易识别遗漏的位置。另保留一句不需要删除的“公开对照:测试环境为室温”。
第二步:执行正式删改与适用的隐藏信息清理。
核对工具说明,选定区域,应用删改,再处理批注、属性和附件等需要排除的内容。对图像中的文字不要只依赖按词搜索;对同一信息的重复位置,也应逐一检查。
如果批注包含需要保留的正常说明,先决定哪些内容应当进入发布版,再清理相关对象。不要在不了解业务用途时机械删除整个文件的所有结构。
第三步:保存、关闭,再打开最终交付件。
给副本明确命名,关闭编辑窗口,从实际准备发送的路径重新打开。这样可以降低检查内存中的临时视图、发出去却是旧文件的风险。
如果需要经过压缩、转换、电子签章或其他处理,检查应放在这些操作之后。前一步合格,不能直接替后一步生成的新文件作保证。
第四步:交叉检查外观与文本读取。
先逐页查看删改区域和相邻内容,再搜索目标词,选择适当范围复制到纯文本窗口。条件允许时,再用另一种受控的解析工具提取文本,并核对结果。
这里必须保留正常对照。如果公开文字也全部提取不出来,那么目标标记没出现,可能只是工具没有读到任何文本。若输出存在编码错乱,也不能把字符串没匹配上直接判为通过。
对于扫描件,可在受控环境中对最终页面运行文字识别,检查未遮盖区域是否仍暴露相关信息。这一步读的是当前画面;它不能替代对文件原有文本内容和其他对象的检查。不要为验证隐私,把真实敏感原稿上传给不清楚处理范围的在线转换或识别服务。
第五步:检查附带信息与剩余语境。
查看批注列表、文档属性、附件等适用位置。不要只搜索正文标记,还要核对对应的批注和属性标记。链接文字与实际链接目标也要分别看,避免页面只显示“资料入口”,目标地址却包含内部编号。
然后从接收者角度通读一次:页眉页脚、目录、图片、文件名以及数字关系,是否继续透露原本要移除的事实?技术清理和语境复核承担不同任务,需要分别留下结果。
第六步:确认发送的是这个版本。
若发送附件,核对文件名和打开后的内容;若共享链接,确认链接指向发布副本,接收者权限符合预期,并检查其能否访问同目录中的原稿或历史版本。不要假设把页面文字改掉,就已经收回过去发出的副本。
检查结果可以写得很具体:“该副本在这些工具和检查路径下未发现三个测试标记,公开对照可读取;已核对批注、属性和附件。”这样的记录能被复查,也比一句“已经脱敏”更清楚。
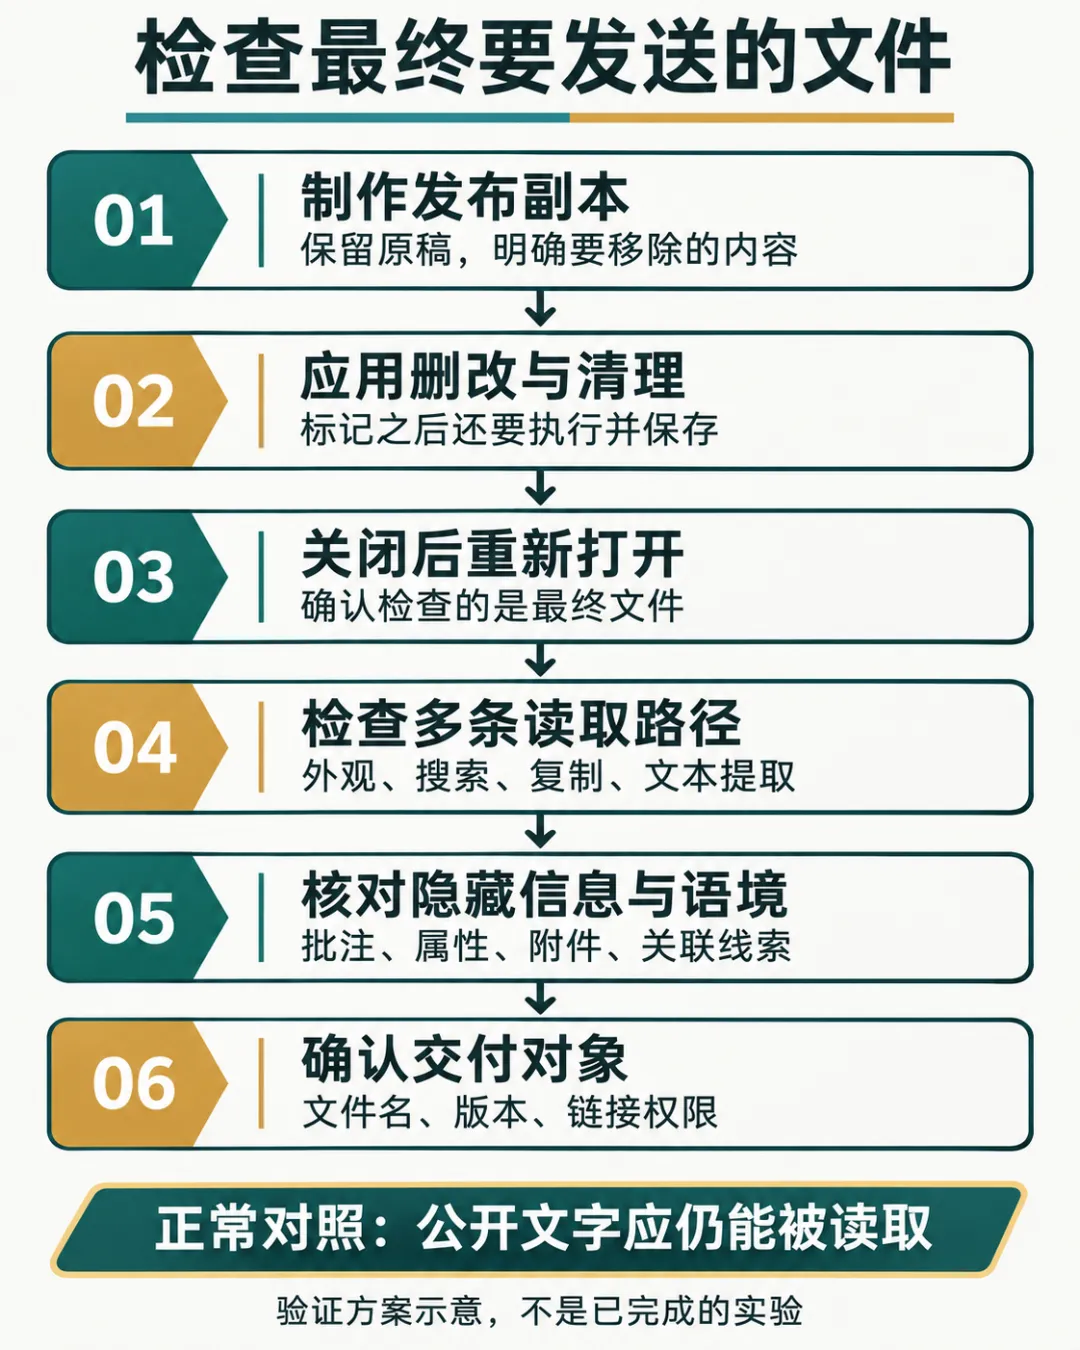
图 3|用虚构材料验证处理流程。图示不代表已完成实验;未发现目标文字,只支持已检查文件、工具和路径内的有限结论。
07|发现原文或没发现原文,分别能说明什么?
如果从最终文件中提取到了应该删除的独特标记,可以说明:这次检查路径仍能读到该标记,当前交付件没有满足预定目标。此时应回查它出现的对象和位置,而不是继续叠加更多黑框。
如果 AI 输出了标记,但直接检查文件没有找到,结论就弱一些。需要记录 AI 实际获得的文件、解析文本、历史对话和其他来源;不要只根据最终回答,判断 PDF 中必定存在某一层残留。
如果所有检查都没有发现标记,能够支持“在这组检查中未发现”,却不能证明不存在任何未覆盖的内容、任何工具都读不出信息,或此前发送的原稿已经消失。
同样,文件变小、重新导出成功、加了打开密码,都不是删改是否生效的直接证据。密码控制谁能打开文件;正式删改处理打开之后能获得什么。授权接收者已经能打开文件时,密码并不会自动删除其中的文字。
对于重复使用的发布流程,可以保留一套只含虚构内容的测试样本。升级编辑器、改变转换方式或新增 OCR 环节后,重新检查这套样本,并确认正常文字仍可使用。这能帮助发现流程变化带来的遗漏,但不代表每份真实文件都能免于人工复核。
08|如果只需要说明问题,是否有必要发送整份原文件?
有时,最有效的改进发生在开始打码之前。
接收者若只需要了解测试方法,可以重新整理一份不包含报价、内部讨论和原始属性的说明;若只需要对比两个参数,可以提供经过复核的简表,而不是整个工作文档。
重新整理也需要检查,不能因为文件是新建的,就默认复制进去的片段没有隐私信息。不过,减少不必要的原始内容,可以让保护目标更小、更清楚,也降低逐页找遗漏的负担。
如果必须分享可编辑的 Office 源文件,还应使用对应格式的检查能力。Microsoft 的文档检查器说明列出了批注、修订、属性和隐藏文字等检查项,也提示部分信息有能力限制,并建议在副本上操作。Microsoft 文档检查说明
这条来源描述的是 Office 文件,不能拿它当成任意 PDF 的完整检查清单。不同格式需要适用的工具,导出后的文件还要单独复核。
09|发送之前,留下三个确认
内容确认:不应交付的信息,是否在页面、文本、批注、属性和附件等相关位置得到处理?保留的语境是否仍表达了受限事实?
结果确认:检查对象是否为最终文件?公开文字能否正常读取?采用了哪些检查路径,还有哪些范围没有覆盖?
交付确认:发送的附件或链接,是否确实指向这个发布副本?接收权限和历史副本是否符合预期?
黑框是一种视觉结果。隐私保护是否生效,需要看最终交付件究竟允许接收者读到什么。
资料与说明
资料核查日期:2026 年 11 月 14 日。案例及测试标记均为虚构;本文提出验证方法,没有执行 PDF 删改实验。配图为机制示意,不是软件界面或实测结果。实际处理以当前工具版本及具体文件为准。
Adobe:Redact sensitive content in PDFs Adobe:Sanitize PDFs and remove hidden content Adobe:Hidden OCR Text Microsoft:Remove hidden data and personal information