ARTICLE · 1356550
DeepSeek 把 App 背后的能力全放出来了,做 AI 应用真的变简单了吗?
如果现在让你做一个自己的 AI 助手,要求它能读懂 PDF、能实时上网查资料,回答时还能把参考链接规规整整附在后面——你第一反应是需要折腾多久?
很多没碰过开发的朋友可能会觉得:现在大模型都这么厉害了,直接接个 API,传个提示词不就完事了吗?
但凡自己动手写过两行代码就会发现,模型其实只是整套拼图里的一小块。真正的麻烦全藏在细节里:文件得找解析器,网页得去抓取和清洗,搜出来一大堆广告和垃圾内容得过滤,最后还得把这些七零八碎的信息喂给模型,顺便把来源标注和防报错机制全写一遍。
一个看着普普通通的对话框,底下可能挂着三四个不同的第三方服务和一堆脆弱的胶水代码。
前两天,DeepSeek 发了个新公告:正式开放全家桶应用 API。
这次他们没发新架构,也没去刷榜,而是把 DeepSeek 官方 App 里的核心看家本领——联网搜索、文档解析、网页阅读、语音交互全套能力,打包开放给了开发者。官方甚至直截了当地说:大家现在用这套接口,基本就能自己攒出一个功能完整的 DeepSeek App。
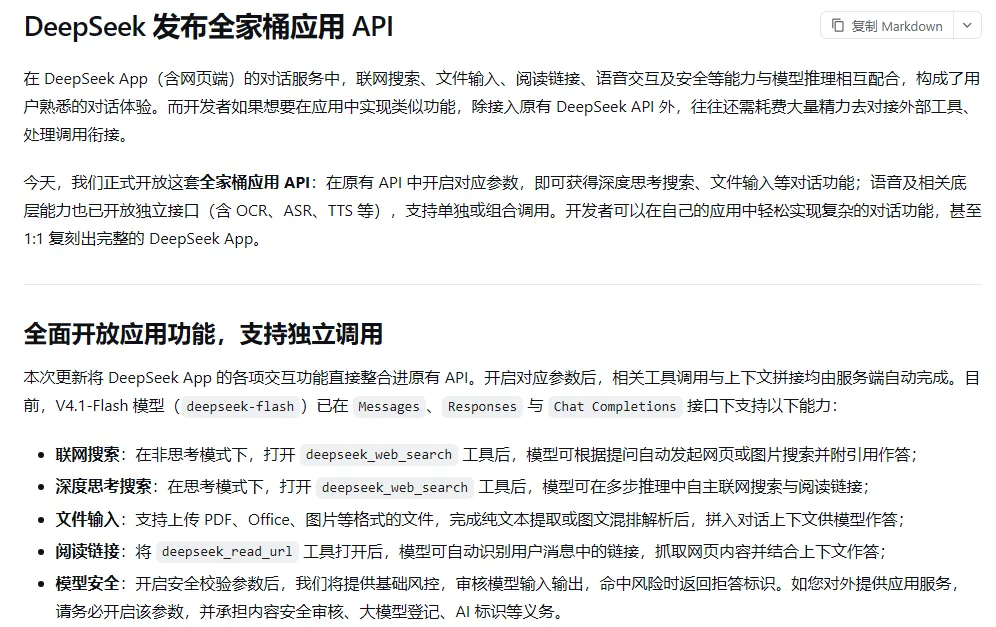
图 1|DeepSeek 全家桶应用 API 发布公告。
比起官方列出的那些功能列表,我其实更琢磨另外一件事:
当这些曾经很费劲的基础能力都能“开箱即用”时,开发一个 AI 应用真的变简单了吗?在这个过程中,我们到底省下了什么,又把哪些关键控制权交给了平台?
一、 这次更新,到底把哪些能力掏出来了?
先看底层支撑。这批应用接口主要跑在 DeepSeek V4.1-Flash 上(API 模型名是 deepseek-flash)。其实这个版本上个月就已经在用了,当时开放的还是独立的搜索和网页抓取接口。而这次更新的核心动作,是把这些零散工具直接无缝揉进了对话接口里。
简单归纳一下,开发者现在手头多了两张牌:
第一张牌:全自动模式。你在后台打开联网搜索(deepseek_web_search),模型自己会根据用户提问来掂量要不要去网上搜一圈。要是开了深度思考模式,它还能在推理过程中一步步搜、一步步读网页;用户要是丢过来一份 PDF、Word、PPT 甚至图片,模型自己先提取文字、做图文混排解析,再组织回答;给了链接,它也能自己用 deepseek_read_url 把网页扒拉下来。
第二张牌:手动积木模式。如果你不希望模型自己瞎折腾,他们依然保留了独立的 Search、Fetch、OCR、ASR 和 TTS 接口。你想什么时候搜、搜完怎么处理,全凭自己的代码逻辑说了算。
说得通俗点:一种是当“甩手掌柜”,让 DeepSeek 全包;另一种是把它们当独立工具箱,自己做总指挥。这两条路走得通,但适合的业务完全不是一回事。
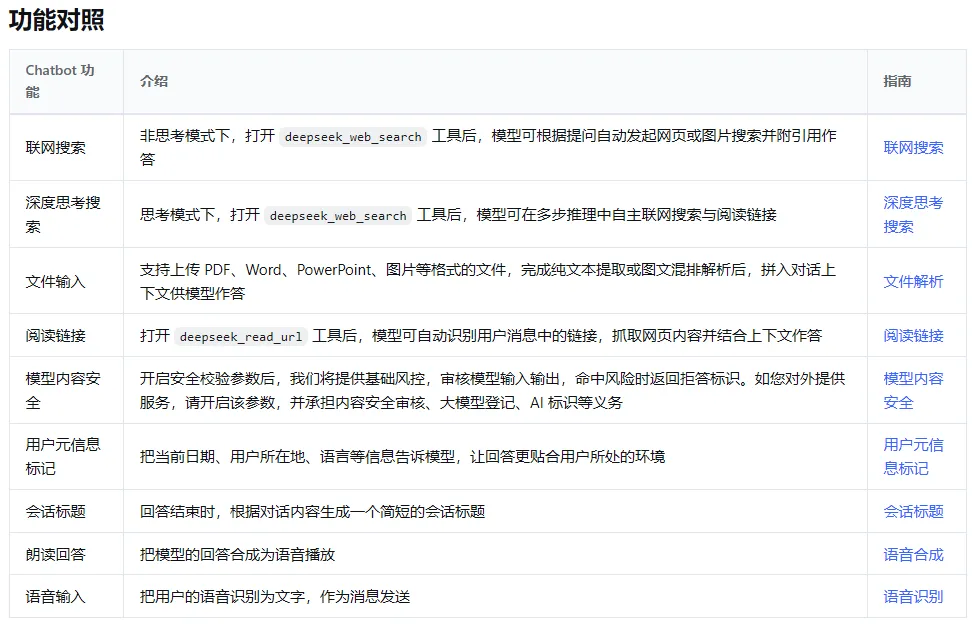
图 2|DeepSeek 应用 API 的功能对照。
二、 以前做 AI 开发,到底烦在哪里?
举个接地气的例子:假设你要给一家工厂做个“设备维修助手”。
一线工人上传了一份两百多页的设备说明书,接着问:“机子开机后一直闪红灯报错,大概是哪儿出毛病了?”
要让 AI 答好这句话,后台得跑完一整套连环工序:先翻开厚厚的手册、准确找到故障代码、查到对应的排查方案,如果手册里没写全,程序还得赶紧上网搜技术论坛和厂家补丁,把垃圾网页踢掉,最后再把这些有用的段落整整齐齐喂给模型。回答完了,你还得老老实实告诉工人:“这句话出自说明书第 45 页,那句话来自官方更新文档”。
这里面的每一步单拎出来都不难,但拼在一起简直是一场灾难:外部网页时不时 404,PDF 里的复杂表格经常解析成一团乱麻,搜出来的网页全是答非所问……任何一个前置环节掉了链子,最后模型就会一本正经地胡说八道。
以前这些苦活累活,全靠开发者硬着头皮写代码兜底。现在用 DeepSeek 的内置工具,这些脏活在云端就顺手给你办妥了,上下文也直接理好了。
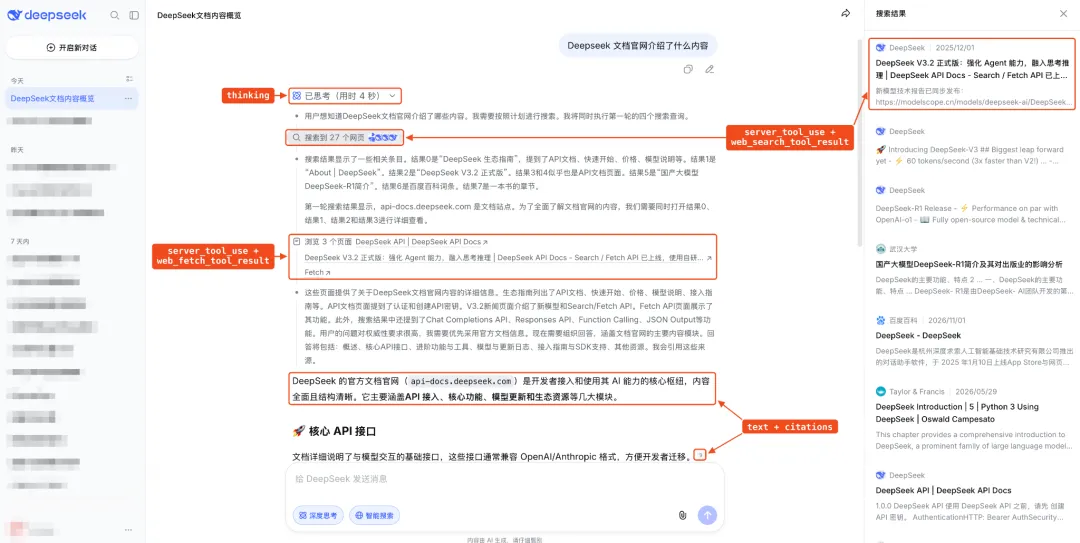
图 3|官方示例展示搜索、读取网页与回答引用的信息块。
我觉得这才是这次更新最实在的地方:它帮开发者省掉了大把重复造轮子的垃圾时间。特别是对于想快速验证原型的个人开发者或者小团队来说,确实是个福音。
但这并不意味着你的应用就稳了。因为即便 AI 完美读懂了说明书,它依然不知道现场传感器的实时油温是多少,也不知道这台设备上周刚换过哪个副厂零件。API 负责把轮子造好,而具体开往哪里、会不会翻车,永远是业务自己的事。
三、 方便是真方便,但控制权也交出去了
很多体验过的人可能还没注意到一个关键细节。
按照 DeepSeek 的官方接口规范,一旦你用了内置的联网工具,你只能“告诉模型可以用什么工具”,但不能通过 tool_choice 去硬性命令它“这一轮必须搜”。换句话说,查不查资料、什么时候查,基本全凭模型自己的“心情”。
更关键的是,当你开启这套托管能力后,像 temperature(多样性)、top_p 这些底层生成参数,服务端可能会直接接管,你传的参数根本不生效。
如果只是做个随便聊天的客服助手,这完全无所谓,甚至省得你自己调优。但如果你做的是严肃业务或者企业级系统,这事儿就没那么简单了。
还是以前面提到的设备排查为例:企业的标准 SOP 要求极其苛刻——必须先锁死指定版本的内部规程,再调取近 24 小时的运行日志,最后严格按照三级故障树逐步推导。每一步的先后顺序和数据来源都必须绝对可控,绝不能任由大模型自由发挥。
这种场景下,全包的内置工具就显得太“自作主张”了。反而是那些独立的 Search、Fetch 接口更实用:哪一步调什么、失败了怎么回滚、什么数据能送出公网、什么数据必须留在内网,开发者手里必须握着绝对的主动权。
所以大家千万别有一种误解,觉得所有做 AI 的都该追求让大模型“全自动接管”。模型擅长的是阅读理解和语言表达,而严格的执行链条、边界校验和最终拍板,必须老老实实掌握在人自己的系统手里。
四、 价格确实极便宜,但成本可不止 Token
不得不夸一句,DeepSeek 这次给出的工具定价,确实狠到了骨子里:
· 文本/图片搜索:5 元 / 1000 次
· 网页内容抓取:5 元 / 1000 次
· 文件解析与 OCR:1.5 元 / 1000 页
· 语音识别(ASR)约 0.39 元/小时,语音合成(TTS)约 1.5 元/万字(限时活动价)
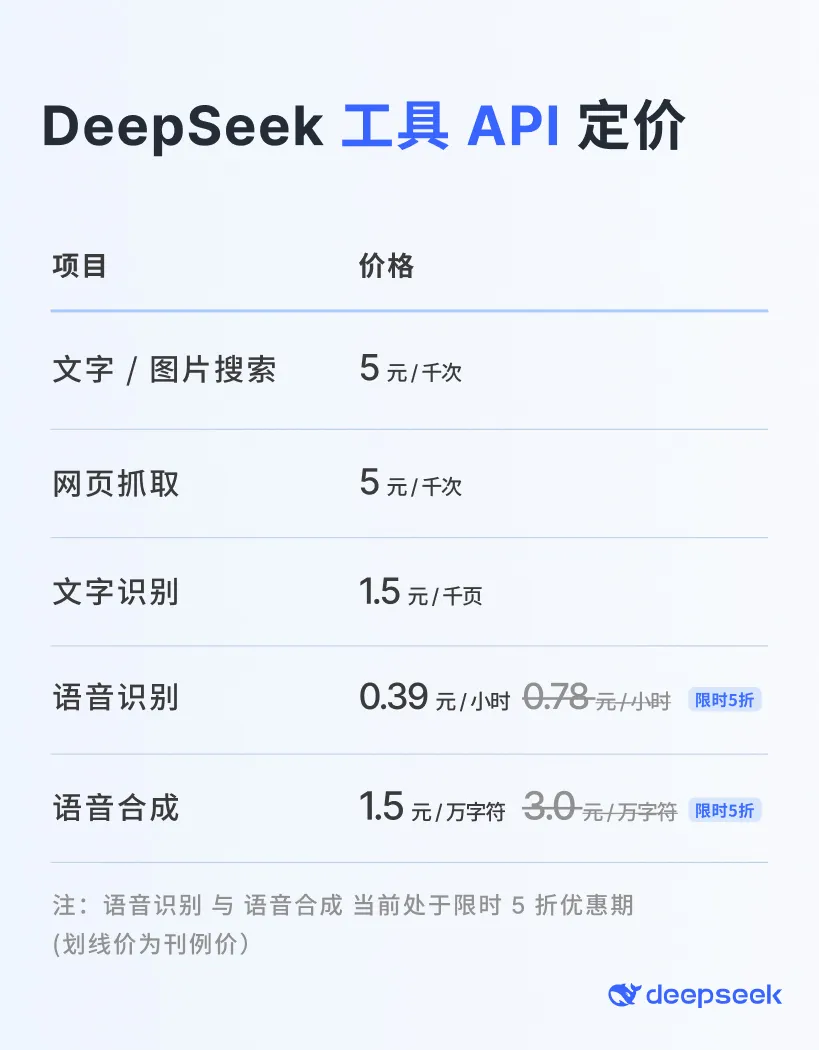
图 4|DeepSeek 工具 API 定价;语音价格包含阶段性优惠。
算下来调用一次只要几厘钱,试错门槛低到了尘埃里。但我经常跟做产品的朋友说:真要上线跑业务,千万别只看账面上的这点 API 单价。
首先是“连带消耗”。用户的提问如果复杂一点,后台可能会被拆解成好几个关键词,触发多次检索;思考模型在长链条推导时,反反复复调搜索和网页,调用量瞬间就翻番;更别说解析后的长文档塞进上下文窗口,消耗的依然是真金白银的 Token。
但比钱更贵的,其实是“结果成本”。如果搜索抓回来的参考网页本身就是营销号的错误信息,或者 OCR 把表格里的关键小数位看漏了,哪怕单次调用只收你一厘钱,做出来的也是个误导用户的残次品。
一个商业应用最终能不能活下来,看的是回答的稳定率、故障率和追责能力。为了省两分钱而把核心流程搞成了不可控的黑盒,最后交出的学费往往高得多。
五、 能“复刻”官方 App,就等于能做好产品吗?
公告出来后,最吸引眼球的莫过于那句“开发者可以借助新接口复刻出完整的 DeepSeek App”,官方甚至直接丢出了一套开源 Demo。
这确实让做 Demo 的速度提升了十倍。但我们得清醒地分清:“能复刻功能”和“能做出好产品”完全是两码事。
能上传文件,不等于能精准消化晦涩的业务资料;能连上外网,不代表能分辨信息的真伪与时效;能打通语音,不代表能应付嘈杂车间里的断续指令。真正的企业级系统,绕不开权限体系、数据安全合规、网络抖动应对、以及随时准备接管的人工审核。这些苦活,没有哪个 API 能替你凭空抹平。
但反过来说,这恰恰是整个行业变好的信号。过去大家把大把精力消耗在写爬虫、对接 OCR、切分文本这些低效的基础设施上;现在底座被大厂铺平了,大家终于可以把力气省下来,去拼真正拉开差距的东西了:
当大家手里拿的都是同样的底座模型、调用差不多的搜索解析接口时,谁能更懂现场的工艺诀窍、谁能把业务流程切分得更严谨、谁手里的私有垂直数据更扎实,谁才能活得最好。
六、 最后说两句心里话
梳理一下 DeepSeek 这半年的动作:从 V4.1 Flash 模型发布,到开放独立搜索抓取,再到这次的“全家桶一揽子开放”,思路非常清晰——他们不再甘心只当一个被调用的底层模型,而是想把 AI 落地所需的整套外围管线彻底做透。
这是一件好事,降低了整个行业的入场门槛。但我依然不太赞成把“给大模型接几个工具就等于搞定了 AI 转型”挂在嘴边。
大模型是极度聪明的帮手,但它不是全知全能的先知。它能读懂文字,但不一定懂得真实世界的利益博弈与安全红线;它能列出一大堆参考建议,但绝不能替关键业务承担后果。
所以,比起天天去数大厂又开放了哪些神仙接口,我更愿意静下心来琢磨:
当搜索、文件解析、语音交互通通变成唾手可得的基础设施之后,我们自己的专业壁垒到底立在哪里?
别被花哨的 API 迷了眼。一个应用到底牛不牛,不看它接了多少前沿技术,只看它在实际泥潭里,能不能稳稳当当地解决掉那个让人头疼的老问题。
— 完 —