ARTICLE · 1367530
让AI真正“读懂”企业文档:我公司自研RAG文档切分论文入选国际学术会议NLPCC 2026
知识库是企业AI应用的地基,文档能否被准确切分与检索,直接决定智能问答的质量上限。
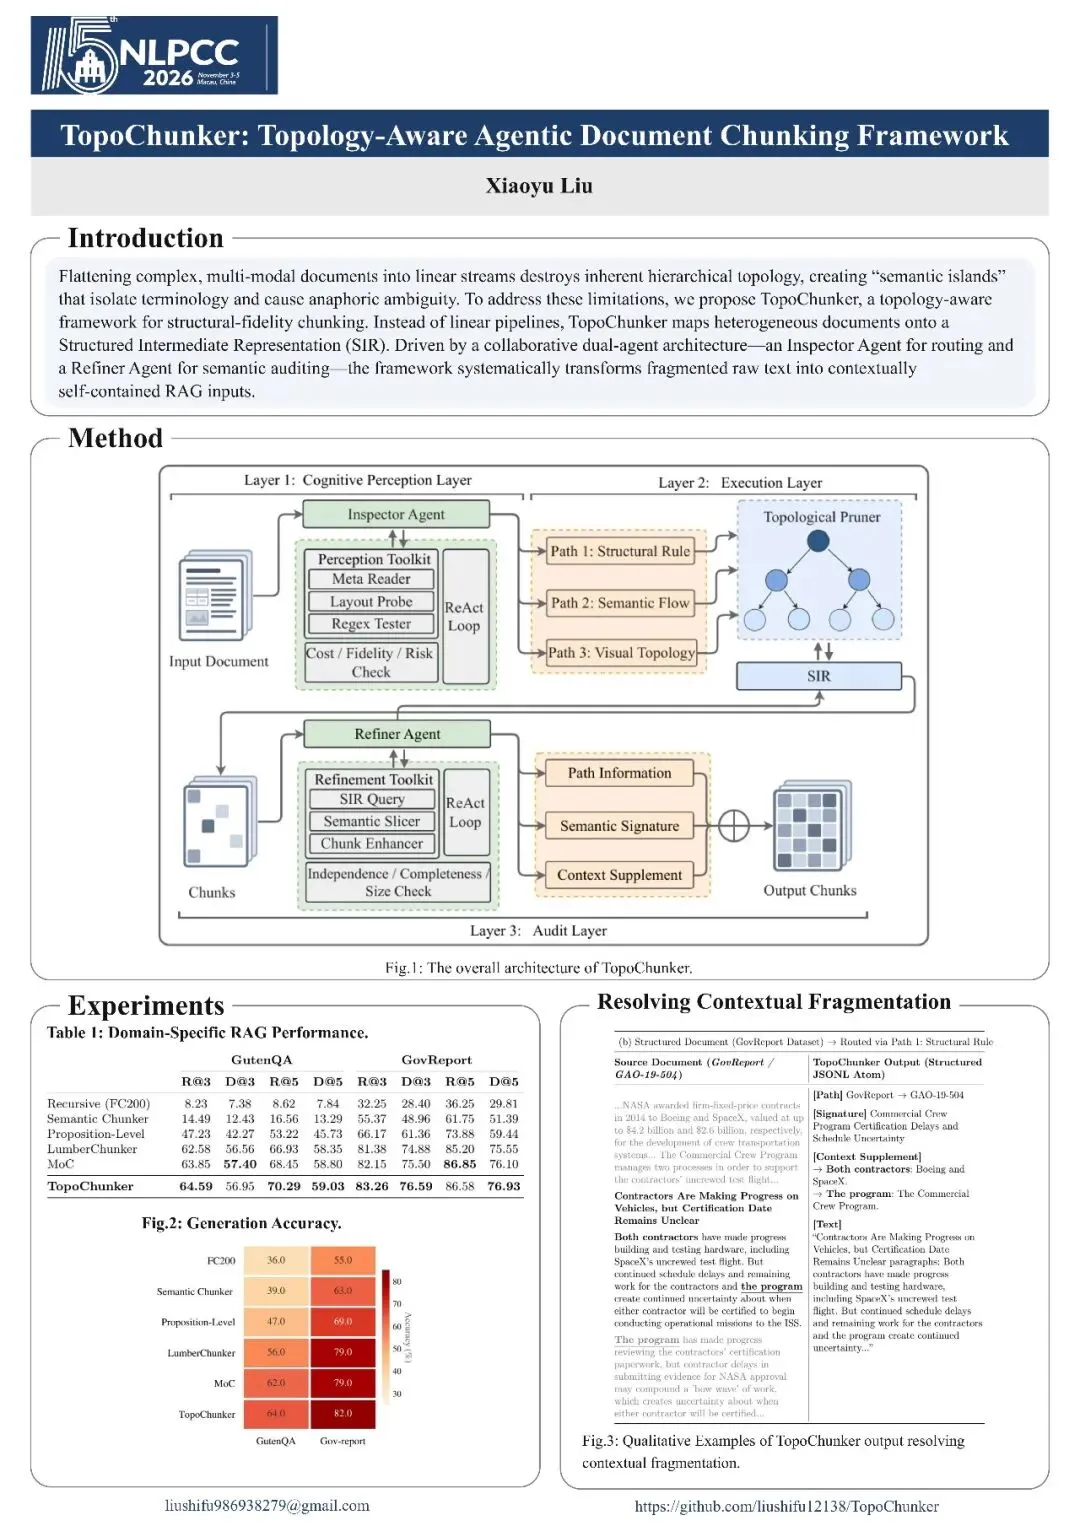
近日,我司在智能化核心技术领域取得新进展:自主研发的RAG文档切分论文《TopoChunker: Topology-Aware Agentic Document Chunking Framework》(以下简称TopoChunker)被第十五届CCF国际自然语言处理与中文计算会议(NLPCC 2026)正式录用。
这一成果表明,我司在RAG与智能文档理解方向的技术探索获得了国际学术界的同行认可,也为公司自研的“工控蜂·石化企业安全生产管理AI应用系统”打造“更懂企业文档”的差异化能力提供了关键技术支撑。
NLPCC由中国计算机学会(CCF)主办、CCF自然语言处理专委会承办,是中文信息处理与自然语言处理领域公认的旗舰会议之一,入选CCF推荐国际学术会议及高质量国际学术会议推广计划。论文集由Springer旗下LNAI系列正式出版,EI Compendex与ISTP双检索;评审采用国际通行的双盲评审机制,录用率常年低于30%,遴选极为严格。
TopoChunker聚焦检索增强生成(RAG)中的文档切分问题,围绕拓扑感知与智能文档理解开展研发。此次被NLPCC 2026正式录用,意味着该技术路线的新颖性、方法严谨性与实验有效性,通过了国际同行的双盲评审。
随着大语言模型的普及,检索增强生成(RAG)已成为企业AI应用的核心范式:通过从知识库中精准检索相关内容,为大模型的回答提供可靠依据,从而抑制“幻觉”。在整条RAG链路中,文档切分(Chunking)决定了检索质量的上限——切分不当,后续检索与生成环节再强,也难以获得可靠结果。
然而,企业文档(如安全规程、应急预案、设备档案、合规报告)普遍存在层级复杂、版式多样的特点。当前主流切分方法大多沿用“文本进、文本出”的线性范式,将文档转换为一维文本流,由此带来两类问题:
❎ 结构信息丢失:章节层级被破坏,产生大量“语义孤岛”——术语失去上下文、代词指代不明、表格与正文脱节,直接降低下游检索与问答的准确性。
❎ 算力分配粗放:部分基于大模型的切分方案对所有内容采用同等强度的推理,在结构简单的内容上同样消耗大量算力,成本居高不下。
TopoChunker针对上述问题,提出了一套拓扑感知的智能体文档切分框架,核心工作包括结构化中间表示、双智能体协作架构与成本感知的智能路由三个层面。
结构化中间表示(SIR)
TopoChunker设计了结构化中间表示(Structured Intermediate Representation, SIR),将异构文档统一映射为内存中的层级树,实现物理解析与语义推理的解耦。每个节点由三项属性刻画:
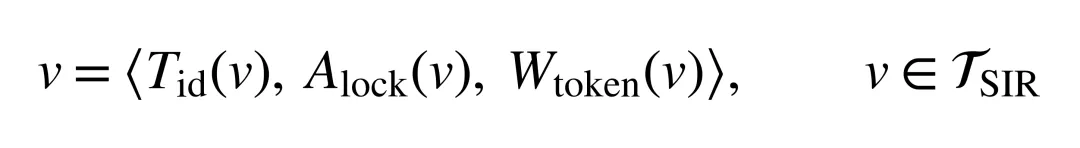
 拓扑谱系(Topological Lineage):为每个节点维护从根到当前节点的层级路径,文本块可沿该路径回溯所属章节及上层语境,实现上下文的显式继承;SIR_Query 即借助该谱系(配合父指针)完成确定性导航。
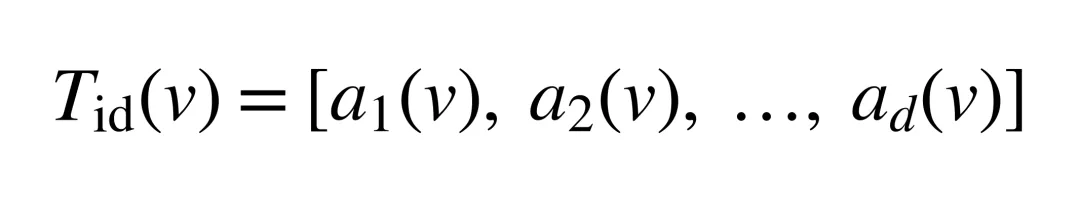
 原子性锁定(Atomicity Locking):将表格、图片等不可分割元素标记为布尔约束,锁定值为1时节点内部允许的切分边界集合为空,切分器不得在节点内部新增边界,避免完整单元被破坏;
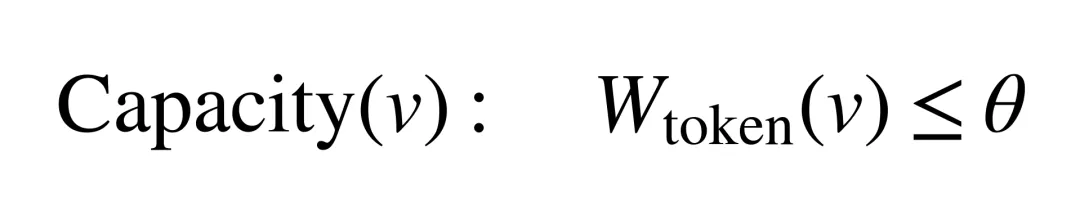
 Token审计(Token Audit):为节点预计算Token权重,下游智能体可直接读取该数值与容量阈值比较,单次容量比较在O(1)时间完成。
结合“树+兄弟链表”的混合数据结构与JSON可序列化特性,SIR无需依赖外部图数据库即可沿指针访问上下文,为确定性切分与语义审计提供结构依据。
双智能体协作架构
精炼智能体(Refiner Agent)基于ReAct范式调度三项工具:
✅ 容量审计对超出阈值的大节点实施确定性语义切分,并严格校验句ID以防止边界幻觉;
✅ 签名生成为每个文本块提炼3—8词的主题标题,提升词汇区分度;
✅ 上下文消歧审计文本块中的悬空指代,发现“语义孤岛”时沿SIR拓扑指针向上回溯,确定性地将“该方案”“这一计划”补全为具体实体,使每个文本块成为语义自包含、可独立检索的知识单元。
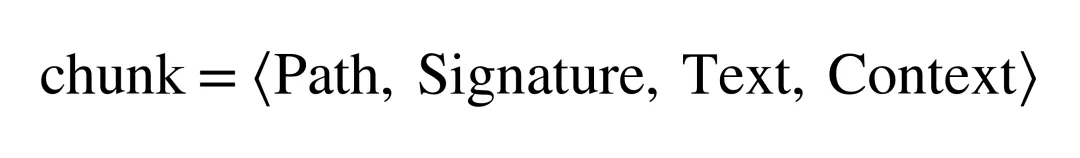
最终输出的文本块由章节路径、主题签名、正文与必要上下文四类字段组织。双智能体通过共享SIR,形成“诊断—执行—审计”的闭环流水线,在结构保真、检索精度与计算成本之间取得平衡。
成本感知的智能路由
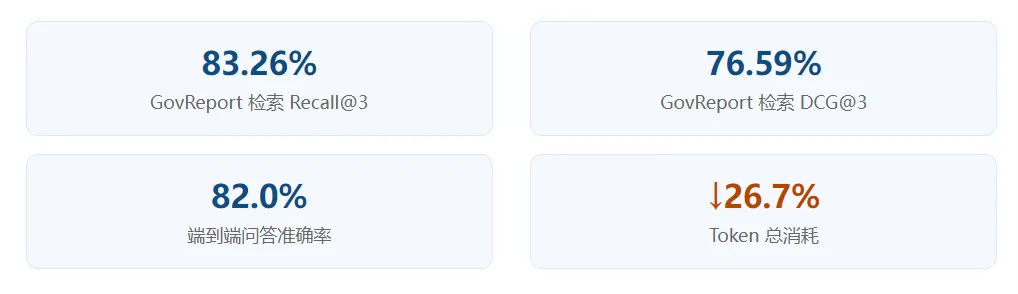
面对层级、版式差异较大的真实文档,TopoChunker依据“成本—保真度—风险”三维评估动态分流:结构化文档完全跳过大模型物理切分,推理链(CoT)Token开销从超22,000压缩至6,000,总消耗削减26.7%;在无结构文本上,通过句界预索引收窄大模型的搜索空间,并将节省的算力再投入到拓扑谱系构建与上下文消歧中。
实验在GutenQA(无结构叙事)与GovReport(复杂结构化报告)两个基准上开展。结果表明,TopoChunker在两项基准上均取得领先性能:在GovReport上检索Recall@3达到83.26%、DCG@3达到76.59%,端到端问答准确率达到82.0%,较先进的生成式与动态路由基线最高提升8.0个百分点。消融实验验证了架构设计的必要性:移除任一智能体均导致性能明显回退,其中Refiner缺失使Recall@3下降6.76%、问答准确率下降11.0%。
成本维度上,依托智能路由,结构化文档跳过大模型物理切分,推理链Token开销由超22,000压缩至6,000;无结构文本通过句界预索引收窄搜索空间,节省的算力被重新投入到拓扑谱系构建与上下文消歧环节,整体呈现较高的“语义投资回报率”。
论文所解决的问题,正是工控蜂在产品落地中每天都要面对的问题。


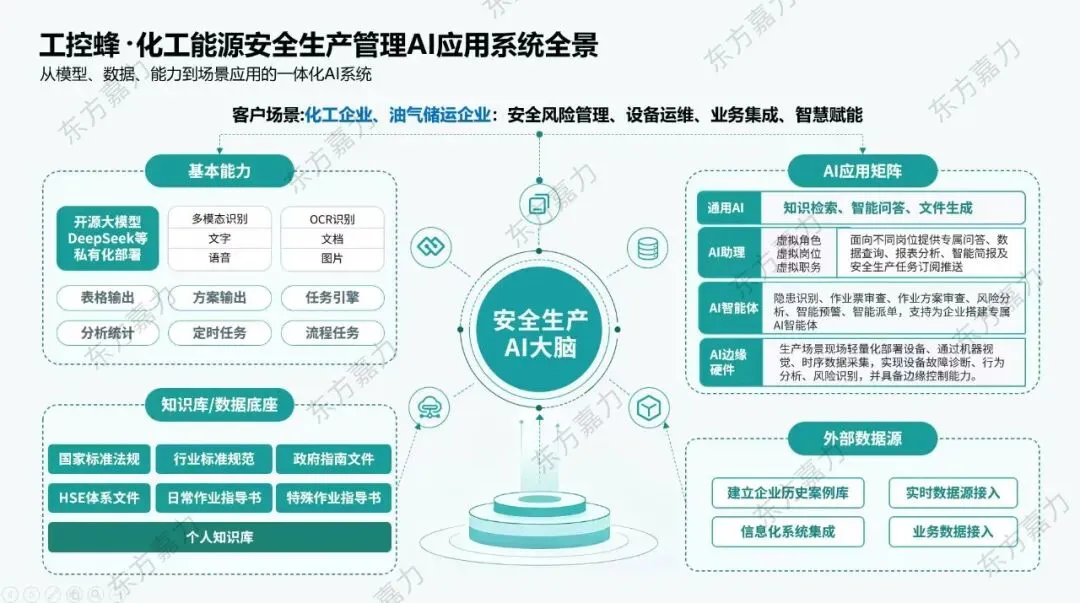
安全规程往往层级深、条款交叉引用多;操作卡与作业票模板版式复杂、表格密集;隐患台账条目短、上下文缺失。这些正是线性切分方法最容易失效的文档类型。
TopoChunker所代表的拓扑感知切分技术,使系统在处理此类工业文档时能够保留章节归属、锁定表格完整性、补全悬空指代,从而在检索环节更准、在回答环节更稳、在推理成本上更低——安全条款不再与上下文割裂,台账表格不再被切碎,一线人员的每一次提问都能得到有依据、可追溯的回答。
这一能力,构成了工控蜂“更懂企业文档”的差异化基础,也为公司构建面向高危行业的企业级知识智能底座夯实了技术根基。
如何体验
点击下方小程序卡片
注册即可参与测试
👉 如需了解更多或有合作需求
欢迎后台留言联系我们
↓↓↓
目前,东方嘉力正积极布局工业人工智能应用赛道,组建了专业的人工智能研发团队,围绕深度学习与大模型技术,开展AI智能体、关键设备AI预测性维护、边缘侧AI应用等智能产品研发,并提供AI应用集成服务,为化工、能源、油气储运等行业的信息化系统与工业控制系统赋能,助力企业数智转型与管理降本增效。
从国际学术前沿到工业现场应用,公司坚持以自主创新驱动产品进化,让AI能力真正落到安全生产的每一个环节。
END
往期推荐
点赞
分享
推荐