ARTICLE · 1371192
文档辅助工具对心脏磁共振成像报告中左心室显著性晚期钆增强特征纳入的影响
往期推荐:
可解释的胸部X线影像组学模型的建立与验证:用于识别非COPD人群中的PRISm
在成熟 CT 检测器之外评估显式解剖先验——基于外部队列的六类急腹症影像学研究
基于瘤内亚区(Habitat)的非增强MRI影像组学特征在可疑垂体微腺瘤诊断中的互补作用
喂给模型更“乱”的报告, 它写出来的反而更全
一篇把大语言模型同时当作“尺子”和“笔”, 去量心脏磁共振 LGE 报告漏写问题的研究
原文标题Impact of Documentation Aids on the Inclusion of Salient Left-Ventricular Late Gadolinium Enhancement Characteristics in Cardiac Magnetic Resonance Imaging Impressions
期 刊Journal of Imaging Informatics in Medicine(2026)
文 献DOI: 10.1007/s10278-026-02444-7
作 者Kailash Singh, Michelle Fang, Makiya Nakashima, Christopher Nguyen, W. H. Wilson Tang, Deborah Kwon, Po-Hao Chen, David Chen
单 位Cleveland Clinic(美国俄亥俄州克利夫兰)· 影像诊断研究所 / 心血管创新研究中心
研究类型原创研究(回顾性、单中心、横断面文档质量研究 + 大语言模型实验)
一、开篇:最值钱的那句话,往往正好被漏掉
心脏磁共振报告里最容易漏掉的一句话,往往恰恰是最值钱的那一句:不是“有没有延迟强化”,而是“强化了多少、在哪儿、什么形态”。Cleveland Clinic 的一组人把 1 228 份真实报告逐份标注后发现,即便在 2024–2025 年已经全面启用结构化模板的报告里,仍有近一半没有写 LGE 的分布、近六成没有写程度——而这两项恰恰是与植入式除颤器决策最相关的那部分信息。更反直觉的是后半段:他们没有去训练一个“更规范”的模型,而是拿 1 000 份格式混乱、风格各异的旧报告去微调 Llama 3.1 8B,三个属性的写入率全面超过拿规范结构化报告微调的版本。
我把这篇读了三遍,最强烈的感受是:它其实不是一篇“AI 写得比人好”的文章,而是一篇“我们从来没有认真定义过一份 CMR 报告该写什么”的文章。下面按“它问对了什么问题—哪一步最聪明—哪张图是决定性的—哪里我不敢直接采信—怎么照着做一遍”来讲,最后给出可复现的配方和三个能直接立项的选题。
二、这不是“写错了”,是“没写”
要把这篇文章读明白,先得接受一个前提:LGE 的三个属性不是学术修辞,而是临床决策变量。模式(pattern)回答“是不是缺血”——心内膜下强化指向冠脉分布区的梗死,mid-myocardial 或心外膜强化指向非缺血性病因;分布(distribution)描述局灶、斑片、弥漫还是沿冠脉走行;程度(severity)按占心肌质量的比例切成 ≤5%、6–14%、≥15% 三档。程度这一项的证据最硬:在一个 344 例非缺血性心肌病一级预防 ICD 队列里,LGE ≥2% 的患者在 61 个月中位随访中的恰当 ICD 治疗率是 24%,而 <2% 只有 8%,且 LGE ≥2% 独立预测恰当放电。注意这里的参照系——现行指南里以 LGE 为阈值决定 ICD 的,其实只写进了肥厚型心肌病,所以报告里一句“extensive”的缺席,损失的是接收医生本来可以据以重新分层的那块信息。
那为什么这件事一直没人量清楚?因为“报告写全没写全”是个极难规模化的终点。既往做法要么人工逐份审阅,几百份就到顶;要么只把“有没有用结构化模板”当作粗变量,默认模板等于完整。两种做法都绕不开同一个困境:判断“该写而没写”,需要一个懂 LGE 的读者,而这个读者的成本直接决定了样本量能有多大。作者的取巧正在这里——他们把“读者”也做成了模型,于是终点可以从“写得对不对”退到“有没有写”,用二分类换规模。这个交换是有代价的,代价我在第八节算。
三、最聪明的一步:把“对错”换成“有没有”
我认为全文最聪明的一步,是设计里那个不显眼的三段对照。他们没有做常见的“AI vs 医生”二选一,而是把三种报告并排放进同一个坐标系:人写的非结构化报告、人写的结构化报告、模型生成的报告;再在这条线上加一段“机 vs 机”,用两个各只有 1 000 份训练样本的 QLoRA 适配器,分别去吃结构化与非结构化的语料。这样一摆,原本纠缠在一起的问题被拆成了三个:格式能不能治漏写(人—人对照)、模型能不能治漏写(人—机对照)、以及模型的收益究竟来自“规范”还是来自“多样”(机—机对照)。
第二个决定是评审机制。2 535 份生成报告不可能人工读完,他们用 MedGemma 作外部评审,对三个属性各打一个“有/无”。这一步让整篇文章在规模上成立——没有它,9 650 份报告只能抽读。但它同时也是全文最脆弱的一环,因为它把“有没有写”和“写得对不对”彻底切开,而这个切口会让后文一些结论被读得过满。
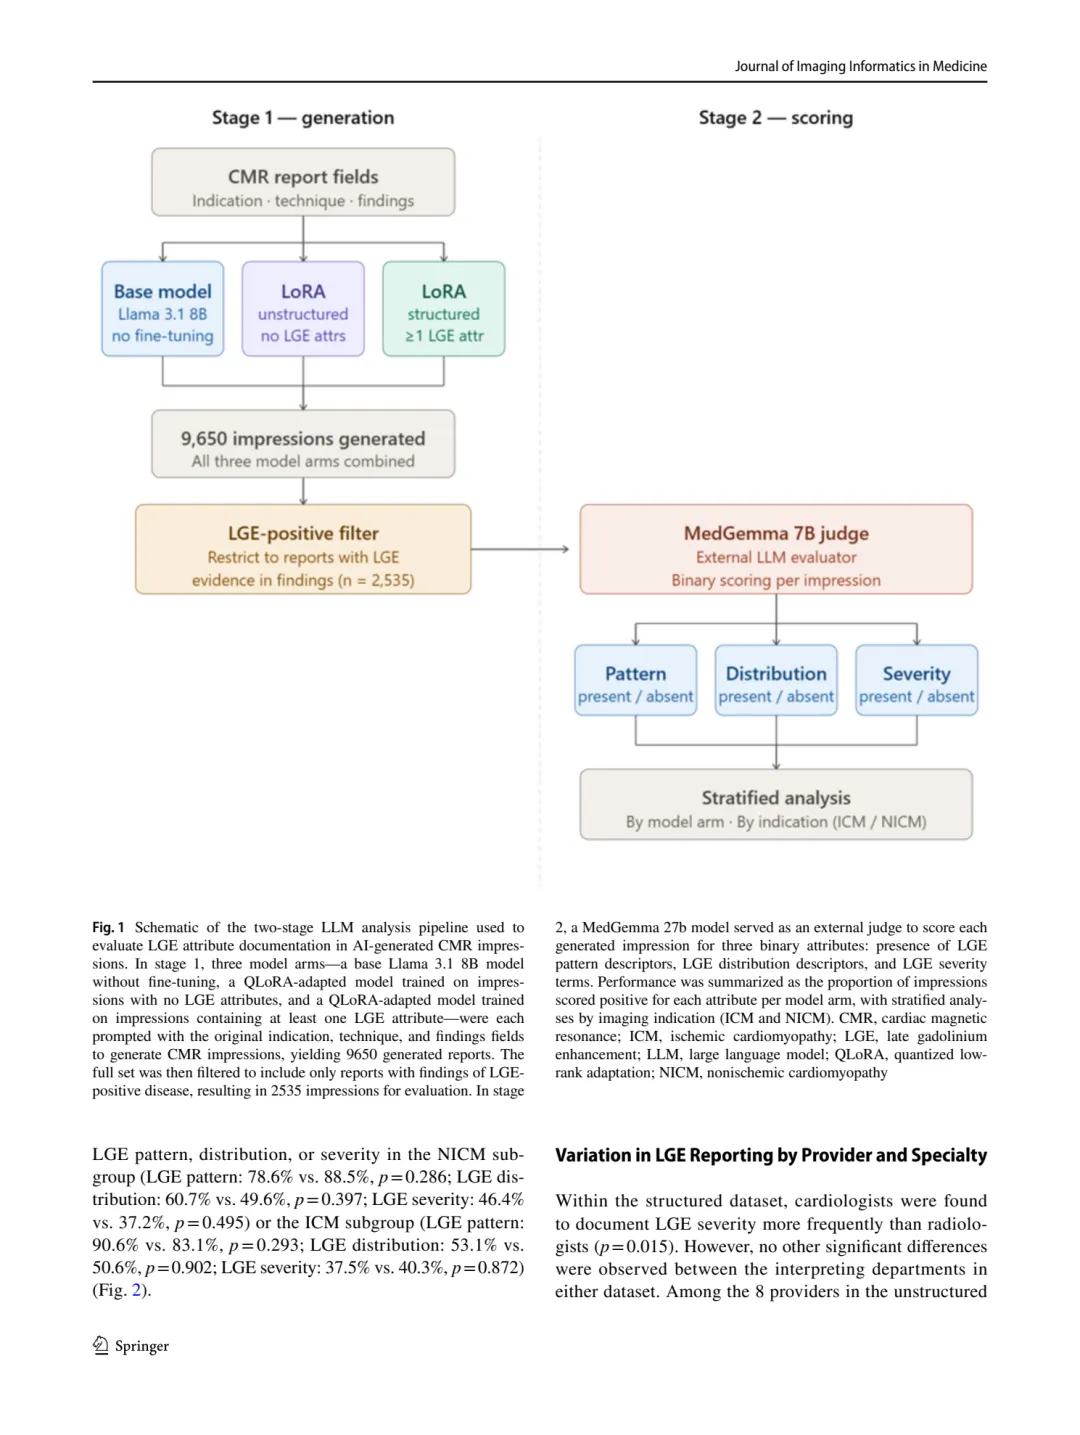
图1(原文Fig. 1)用于评估 AI 生成 CMR 印象中 LGE 属性记录情况的两阶段 LLM 分析流程示意图。第一阶段中,三个模型臂——未经微调的 Llama 3.1 8B 基础模型、在“不含 LGE 属性”的印象上训练的 QLoRA 适配模型、以及在“至少含 1 个 LGE 属性”的印象上训练的 QLoRA 适配模型——各自以原始的适应证、技术、所见字段作为提示,生成 CMR 印象,合计产出 9 650 份生成报告;随后对全集施加“LGE 阳性”筛选,仅保留所见字段中存在 LGE 阳性病变证据的报告,得到 2 535 份印象进入评价。第二阶段中,由 MedGemma 27b 模型充当外部评审,对每份生成印象就三个二分类属性打分:是否存在 LGE 模式描述词、是否存在 LGE 分布描述词、是否存在 LGE 程度用词。性能以各模型臂中被判为“具备该属性”的印象比例汇总,并按检查适应证(ICM 与 NICM)做分层分析。CMR,心脏磁共振;ICM,缺血性心肌病;LGE,延迟钆增强;LLM,大语言模型;QLoRA,量化低秩适配;NICM,非缺血性心肌病。
读图:这张图把两段式流水线画得很清楚:左边是生成(三个臂吃同样的适应证、技术、所见字段),右边是评分(MedGemma 对三个属性各判有/无),中间那道筛选把 9 650 压到 2 535。它证明了这套设计是可复制的,任何单中心都能照搭;但有两处要留意——图上写的是 MedGemma 7B 而正文写 27b,前后不一致会直接影响复现;更重要的是两个适配器的标注分别是“非结构化、不含 LGE 属性”与“结构化、至少含一个 LGE 属性”,格式和内容同时被改动了,这一点我在第七节展开。
四、三条时间线搭起来的队列
队列构造很朴素,但三条时间线的跨度值得停一下。非结构化那一批是 1990 年 4 月 18 日到 2023 年 4 月 19 日的 828 份报告,来自同一家大型学术医院;结构化那一批是 2024 年 1 月 1 日到 2025 年 1 月 1 日的 400 份,起点正好是全院铺开结构化报告之后。规则解析器把报告切成适应证、所见、印象三段,再按关键词把适应证分成两类:NICM 用 dilated、hypertrophic、nonischemic、restrictive、arrhythmogenic、infiltrative、amyloidosis、sarcoidosis、hemochromatosis;ICM 用 ischemia、ischemic、infarct、viability、scar、fibrosis、myocardial injury。1 228 份中 LGE 阳性 418 份,结构化 131 份、非结构化 287 份。
生成端的基础是 Llama 3.1 8B,先在 27 000 份结构化 CMR 报告上微调,再分三个臂各生成一批印象,合计 9 650 份;只保留所见字段中有 LGE 阳性证据的 2 535 份进入评分。表 1 把三个队列并列摆开,一眼能看到一个必须记住的不平衡:LLM 队列里 81.2% 是 ICM 适应证,而人写的两个队列分别只有 45.8% 和 37.6%。这个数字后面会反复出现——因为 ICM 恰好是模型表现最好的亚组。
患者特征 | 结构化数据集 (2024–2025) | 非结构化数据集 (1990–2023) | LLM 生成数据集 |
检查数量 | 400 | 828 | 9 650 |
LGE 阳性病例 | 131(32.8%) | 287(34.7%) | 2 535(26.3%) |
CMR 检查时平均年龄(岁) | 62.1 | 56.2 | 57.8 |
女性 | 35(26.7%) | 72(25.1%) | 854(33.7%) |
非缺血性心肌病(NICM) | 26(19.8%) | 82(28.6%) | 428(16.9%) |
缺血/存活心肌(ICM) | 60(45.8%) | 108(37.6%) | 2 060(81.2%) |
表1(原文Table 1)结构化数据集、非结构化数据集与 LLM 生成数据集中患者的基线特征。(CMR,心脏磁共振;LGE,延迟钆增强;LLM,大语言模型。说明:NICM 与 ICM 两行的百分比为占该队列 LGE 阳性病例的比例,故同一列之和不足 100%。)
五、决定性的一张图:模板只救回了“模式”
图 2 是全文的分水岭。它把三种格式、三个属性、三个分层压进三块柱状图,从左到右依次是全 LGE 阳性、NICM、ICM。先看 a 图:结构化报告把模式写入率从 61.0% 拉到 85.5%(p = 9.6×10⁻⁷),这是模板唯一真正兑现了的承诺;但分布只有 53.4% 对 49.5%(p = 0.519),程度 42.0% 对 41.1%(p = 0.952),这两条都只能读作“没有差别”。
这两个百分比需要参照系才有分量。53.4% 不是某位医生的疏忽,而是 2024–2025 整整一年、全院、在结构化模板之下测出来的整体水平;而 LGE 是这套检查里预后证据最扎实的一项。换句话说,模板把“格式”这一层治好了,却没碰到“什么值得写”这一层。
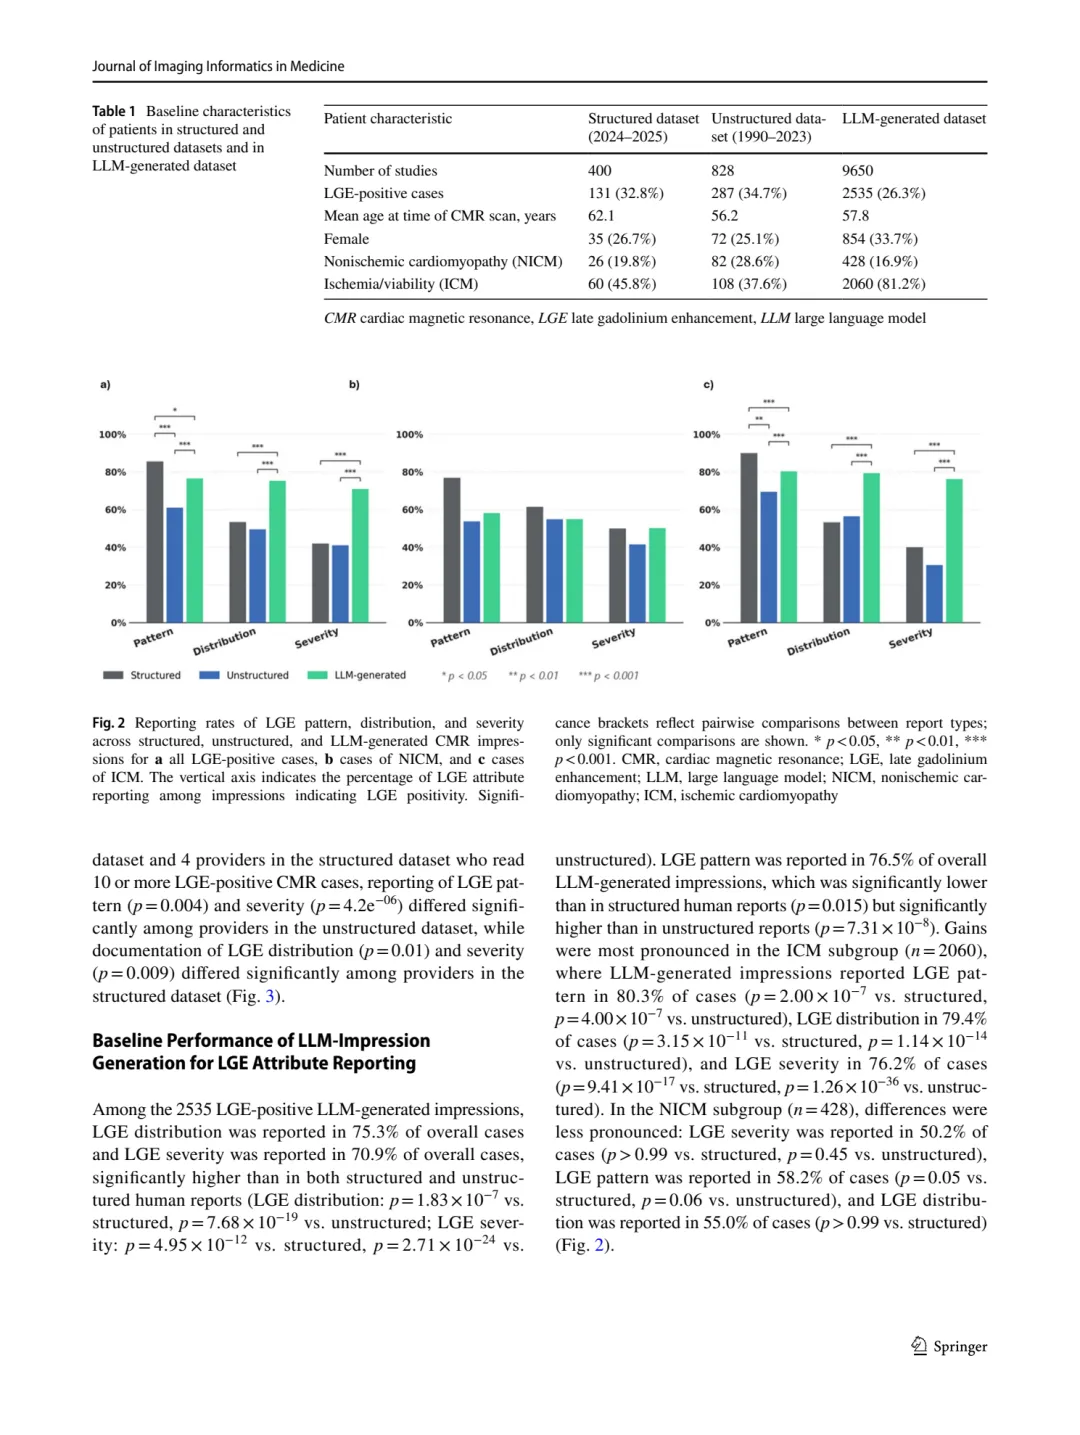
图2(原文Fig. 2)结构化、非结构化与 LLM 生成 CMR 印象中 LGE 模式、分布与程度的报告率:a 全部 LGE 阳性病例,b NICM 病例,c ICM 病例。纵轴表示在提示 LGE 阳性的印象中,各 LGE 属性被记录的比例。显著性括号反映报告类型之间的两两比较;仅显示显著的比较。* p < 0.05,** p < 0.01,*** p < 0.001。CMR,心脏磁共振;LGE,延迟钆增强;LLM,大语言模型;NICM,非缺血性心肌病;ICM,缺血性心肌病。
读图:最锋利的一组对比在 c 图:LLM 在 ICM 的分布 79.4%、程度 76.2%,对两种人写格式的 p 值小到 10⁻¹⁴ 至 10⁻³⁶ 量级;但同一张图的 a 图里,模型的模式写入率 76.5% 反而低于结构化的 85.5%(p = 0.015)。这个一高一低给出了很干净的判断——模型补的是“人懒得写”的部分,补不了“模板已经强制写”的部分;它不是更懂 LGE,只是更愿意把话说全。警惕之处在 b 图:NICM 三根柱子几乎一样高,模型的优势在这个亚组完全消失。
六、漏在哪儿:不在科室,在人
图 3 回答的是“漏写该归咎于谁”。a、b 两块把心内科与放射科并排:非结构化队列里三个属性全部不显著;结构化队列里只有程度一项,心内科显著高于放射科(p = 0.015)。真正的差异藏在 c 块——那里每一个点是一位医生。非结构化队列 8 位读片量 ≥10 例的医生,模式写入率从约 40% 到 85% 不等(p = 0.004),程度从约 20% 到 75% 不等(p = 4.2×10⁻⁶);结构化队列 4 位医生,分布(p = 0.01)与程度(p = 0.009)同样散得很开。
我认为这是全文对科室质控最有直接用处的一张图,因为它说明“规范化”的对象可能画错了。模板统一的是格式,不统一“什么值得写”;同一个模板下,两位医生对“要不要写程度”的分歧可以到三倍。如果要做质量改进,抓手在个人层面的反馈与共识,而不在再改一版模板。顺带一个瑕疵:这张图纵轴用的是 Location 而不是正文一直用的 pattern,术语没对齐,读图时得自己换算。
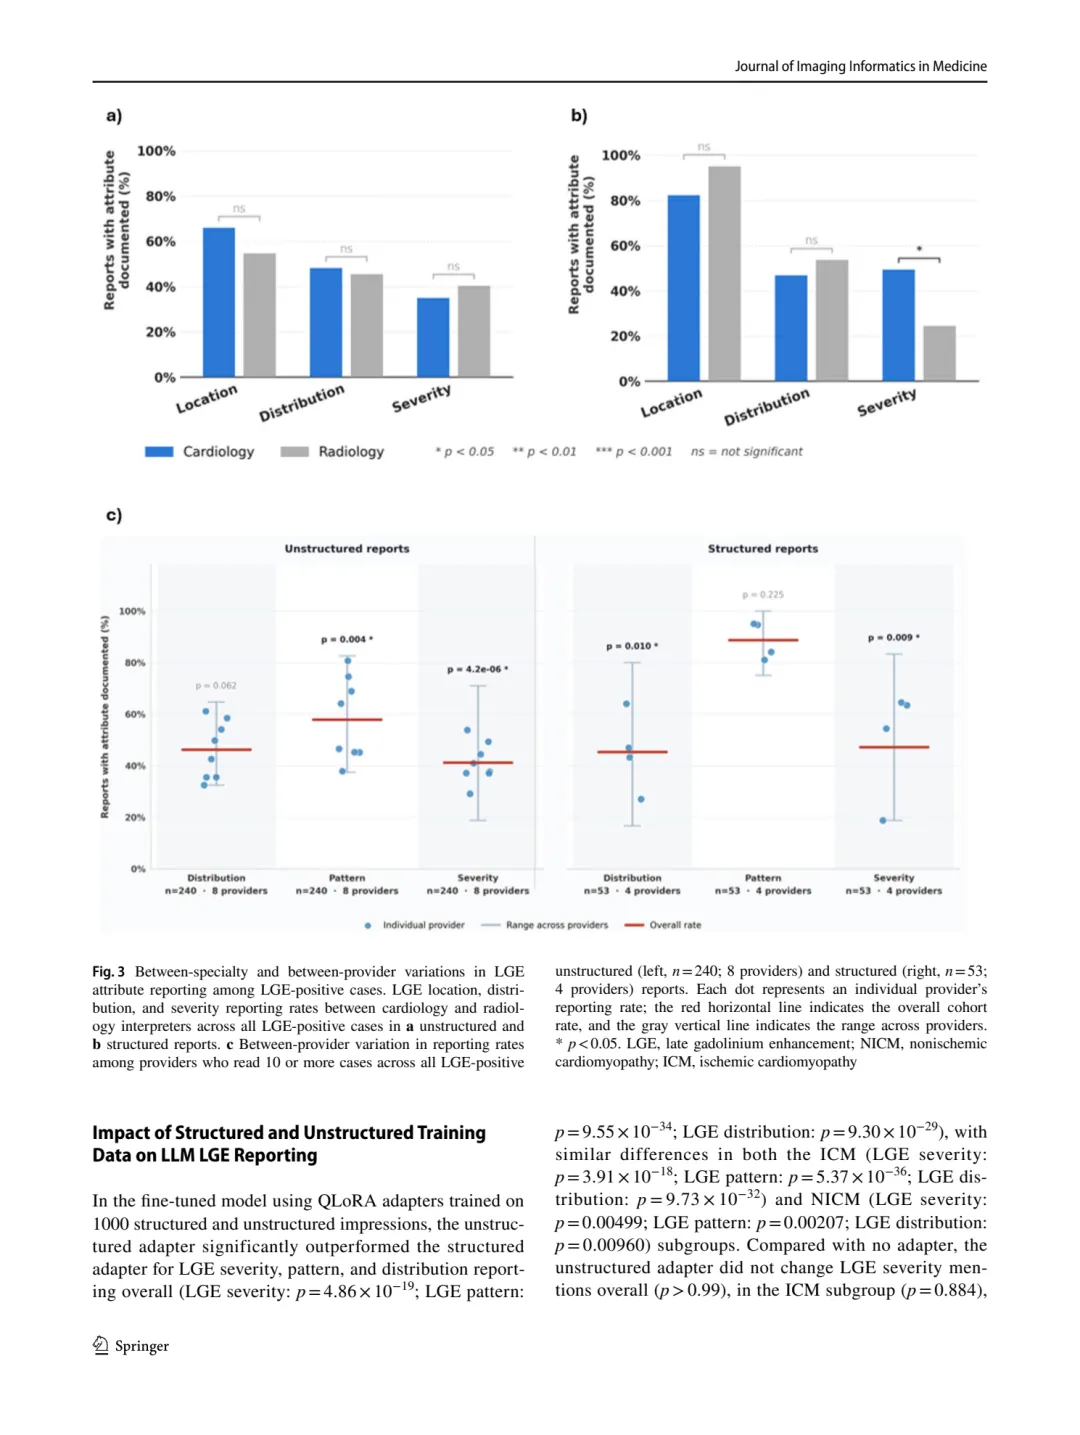
图3(原文Fig. 3)LGE 阳性病例中 LGE 属性记录情况的科室间与提供者间差异。a 非结构化报告与 b 结构化报告中,全部 LGE 阳性病例在心血管内科与放射科判读者之间的 LGE 位置、分布与程度报告率。c 在读片量 ≥10 例的提供者之间,全部 LGE 阳性病例的记录率差异:非结构化报告(左,n = 240;8 位提供者)与结构化报告(右,n = 53;4 位提供者)。每个点代表一位提供者的个人报告率;红色水平线表示总体队列率,灰色竖线表示提供者之间的范围。* p < 0.05。LGE,延迟钆增强;NICM,非缺血性心肌病;ICM,缺血性心肌病。
读图:a、b 两块几乎全是不显著的 ns,说明科室不是一个好的解释变量;c 块一点开,同一个科室里的离散度立刻显形——非结构化队列的程度一项从 20% 到 75%。这直接支撑了作者后面那句判断:漏写更像提供者个人的书写习惯,而不是亚专业的集体偏好。需要注意样本很薄:结构化队列只有 4 位医生、53 例,点少到任何一个人的休假都会改变结论。
七、反直觉的一招:喂“脏”数据,写出更全的报告
图 4 是全文最反直觉的一段,也是最值得记住的一段。三根柱子分别是“非结构化微调”“结构化微调”“不微调(基线)”。a 图里,非结构化微调在模式上约 87%、分布约 85%,都是三组最高;程度与基线基本持平。结构化微调则明确更差:程度全面低于基线(p = 4.86×10⁻¹⁹),模式也低于基线(p = 0.00166)。也就是说,给模型喂“更规范”的那 1 000 份,效果不如喂“更乱”的那 1 000 份。
作者的解释是“暴露于提供者层面的风格异质性”:训练时见到的写法越杂,模型越能在真实报告的多样表达里认出 LGE 描述,而不是被锁死在一种句法上。这个解释与数据显示的方向一致,但我认为它没有被干净地识别出来。按图 1 的臂标注,非结构化适配器吃的是“不含 LGE 属性”的印象,结构化适配器吃的是“至少含一个 LGE 属性”的印象——两个臂同时改变了格式与内容含量,2×2 里缺了两个格子,所以只能说“异质性解释与数据相容”,不能说被证明。
另一个同样合理的解释是:结构化模板的语言高度同质,模型很容易学成一个“套话生成器”,而套话里最常出现的恰恰是 mild 与 none,于是把程度的表达压低。这与“模板让书写变浅”的直觉吻合,也和作者在讨论里的另一句判断互为呼应。不管机制是哪一种,这条经验本身是可迁移的:做领域适配时,训练语料的“多样性”可能比“规范性”更重要。这跟大多数人的直觉相反,也是我后续实验第一个要验的假设。
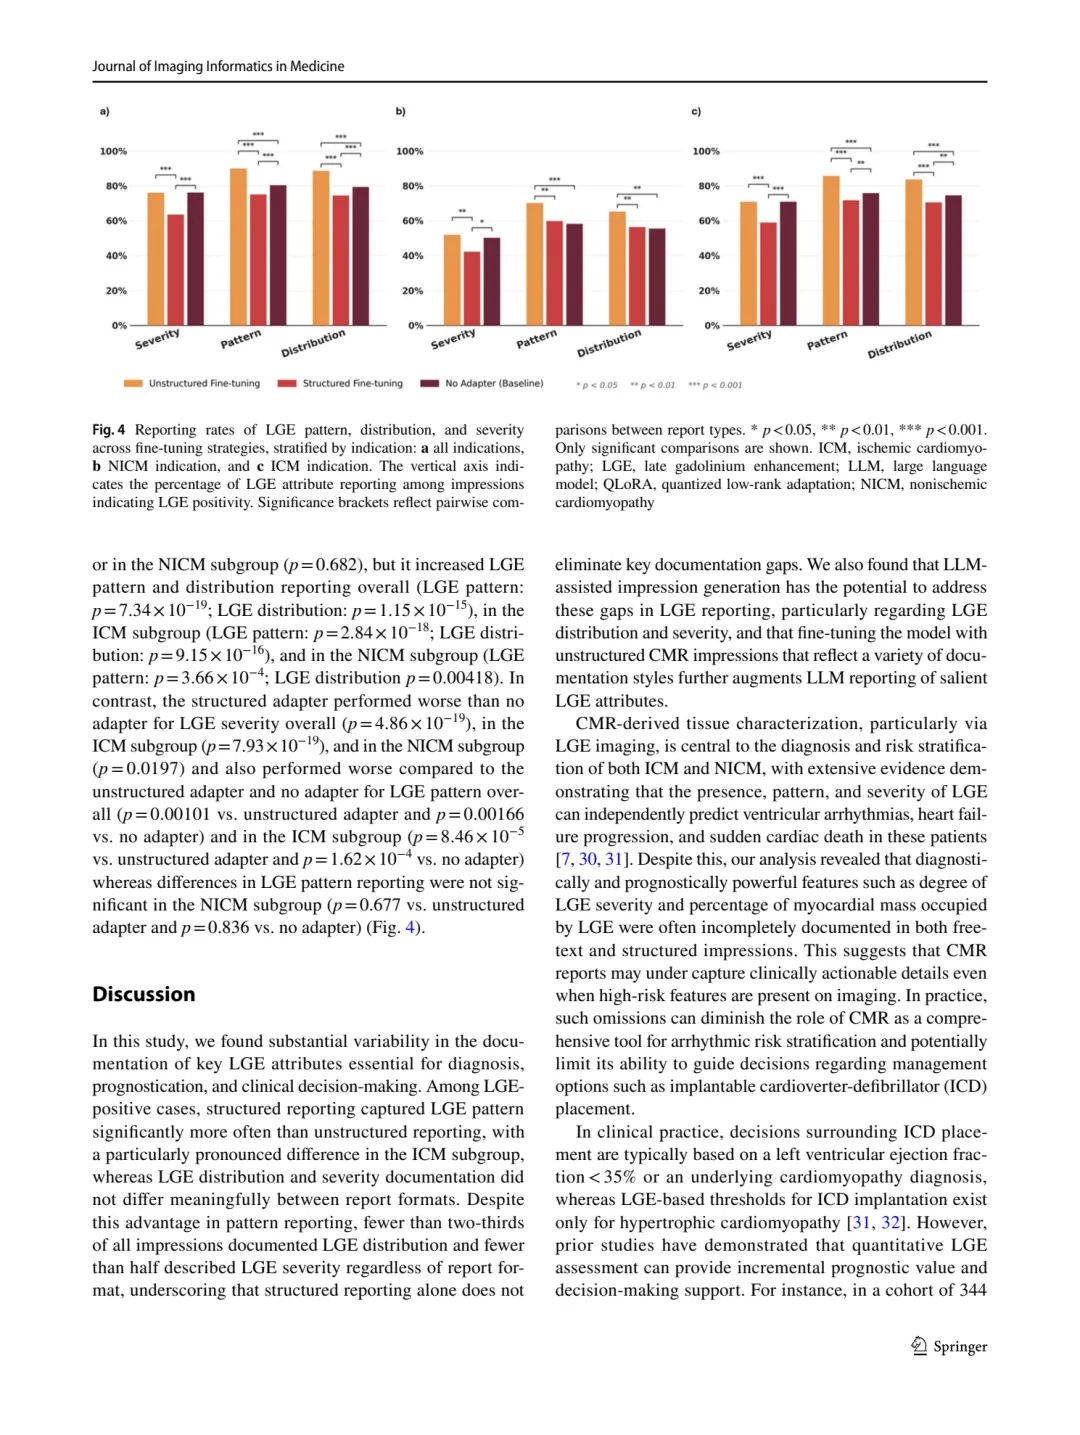
图4(原文Fig. 4)不同微调策略下 LGE 模式、分布与程度的报告率,按适应证分层:a 全部适应证,b NICM 适应证,c ICM 适应证。纵轴表示在提示 LGE 阳性的印象中,各 LGE 属性被记录的比例。显著性括号反映报告类型之间的两两比较。仅显示显著的比较。* p < 0.05,** p < 0.01,*** p < 0.001。ICM,缺血性心肌病;LGE,延迟钆增强;LLM,大语言模型;QLoRA,量化低秩适配;NICM,非缺血性心肌病。
读图:注意 a 图里程度那一条:非结构化微调与基线几乎等高,结构化微调却明显塌下去——这说明“喂规范数据”在这里不是无效,而是有害。b 图(NICM)里三组都挤在 50–65% 区间,差距最大也只有十来个点,提示在表型更复杂的亚组,微调策略能撬动的空间本来就很窄。读这张图时别忘了:每组只有 1 000 份训练样本,量级的差别可能被放大了。
九、复现配方
对象与切片。单中心回顾性研究,经机构审查委员会批准、豁免知情同意,全程去标识化。两段式时间分组:1990-04-18 至 2023-04-19 的非结构化报告 828 份;2024-01-01 至 2025-01-01 的结构化报告 400 份(起点是结构化报告全院铺开之时)。规则解析器把报告切成适应证、所见、印象三段,再用关键词把适应证二分。⚠️原文未报告解析器的命中规则细节与人工复核方式;如果是我,会抽 50 份人工核对,并把误分率写进结果。
标注与判定。用 MedTator 1.3.16 做文本标注,两名受训者独立标注印象段,由一名专科医师监督。属性字典四类:LGE 提及(阳性/可能/否定)、模式(心内膜下、壁内、透壁、心外膜)、分布(局灶、斑片、弥漫、冠脉分布)、程度(轻度 ≤5%、中度 6–14%、广泛/重度 ≥15% 心肌质量)。⚠️原文未报告标注者间一致性指标(Kappa)与分歧裁决流程;如果是我,会双人独立标 150 份算 Cohen's Kappa,低于 0.7 就回头改标注手册再开工。
生成与评价。基座是 Llama 3.1 8B,先在 27 000 份结构化 CMR 报告上微调;再做两个 QLoRA 适配器,各用 1 000 份印象训练(一个结构化、一个非结构化)。数据按 90:10 切分训练与验证,AdamW 优化器,学习率 3×10⁻⁴,余弦调度,批大小 16,最多 4 000 步,每 200 步验证一次,按验证集早停并选最优模型。三臂合计生成 9 650 份,筛出 LGE 阳性 2 535 份,用 MedGemma 27b 作评审逐份打三个二分类标签;统计用 Python(SciPy 3.13.9)的卡方检验,α ≤ 0.05。⚠️原文未报告提示词全文,也未报告评审模型自身的准确率标定;这是复现时最大的坑——如果是我,会先人工标 200 份做评审模型的敏感度与特异度,报出来之后再谈组间差异。
呈现方式。图 2 那种“三格式 × 三属性 × 三分层”的分组柱加显著性括号,值得直接抄;图 3c 用“每点一位医生 + 中位线 + 极差线”,是把“人”作为分析单元的最好画法,比报一个科室均值有说服力得多;图 4 把适配器作为第三组并列进来,方向一眼可辨。表 1 用三队列并列而不是拆成三张表,也是好习惯——它让“81.2% 是 ICM”这样的构成差异无处躲藏。
先把这篇文章的骨架抽象成一个公式:【一个“报告里本应写、但没人强制写”的关键影像属性】加上【一把可规模化、且先用人工标定过的大模型评审尺子】加上【格式 × 提供者 × 微调数据三个层次的对照】,等于一篇影像信息学或报告质量研究。它真正的洞察可以压缩成一句话:结构化只改壳,不改内容;能改内容的是“暴露于多样性”。这句话往任何一个“模板已经上了、质量还是不行”的场景里搬,都成立。
第一个选题,是我认为最有分量、也最容易做成一篇完整论文的一个:中国单中心 CMR 报告的 LGE 三属性漏写率与医生画像。人群取某三甲医院 2022–2025 年的 CMR,预计 3 000–5 000 例,其中 LGE 阳性约 1 200 例;暴露是报告格式(旧自由文本 vs 新模板)与报告医生(年资、亚专业);主要结局是三个属性的写入率,次要结局是“写了但与影像不符”的错误率——这一点原文完全没做,也正是我们最容易做出差异化的地方,只需随机抽 200 例做影像复核;方法直接借用原文的 MedTator 字典、卡方与提供者散点图;数据来自 PACS 报告文本加影像复核。为什么能发:原文只回答“有没有写”,我们补上“写得对不对”,同时给出中文语境下的第一份基线,国际上确实还没有。
第二个选题:中文报告上的“多样性 vs 规范性”对照微调。人群取同一批 5 000 份中文 CMR 报告,抽 1 000 份自由文本与 1 000 份模板化文本作训练语料;干预是两个 LoRA 适配器,但臂设计必须把“格式”与“是否含属性”解耦成 2×2 四臂(这正是原文没做干净的地方);结局不能只报写入率,要报与人工金标准的一致率(F1),测试集用 2 名医师标注的 300 份;数据来自院内报告加标注。为什么能发:它直接修掉原文最大的方法学漏洞,而中文语料与国产模型(Qwen 系)本身就是天然的差异化卖点。
第三个选题上手最快,适合先探路:不改模型,只改提示。人群取公开可获取的心脏影像报告集,或自建 200 份小样本;干预是在 few-shot 示例里分别混入“风格多样”的报告与“规范模板”报告;结局同样报写入率与幻觉率(模型写出了影像中不存在的属性的比例);数据成本最低,两个月内能出结果。作为 pilot 或 letter,它足以回答一个关键问题:“多样性”的好处是不是在提示层面就能拿到,还是必须动微调。
排序我的建议是:先做三探路,再做一立主篇,最后做二补机制。三的成本最低,两周内就能告诉你“多样性提示是否也有效”,而这个答案直接决定二值不值得投两个适配器的训练时间。门槛上要说实话:这类研究的真正成本不在算力,8B 模型单卡就够,1 000 份的适配器训练几个小时;成本在标注与复核——3 000 份报告的双人标注约需 2 人 × 3 周,而且必须有心血管影像医师做金标准仲裁,这是最容易卡住的一环。最难拿到的不是报告文本,而是“影像—报告配对的人工复核”,因为要重新调阅影像判断 LGE 程度;最容易失败的一步是评审模型校准,如果它在中文报告上的敏感度不到 0.8,所有百分比都不可信。降级方案也很清楚:不做全量评审,只对 500 份做“人工 + 模型”双读并报一致性,其余用规则加关键词抽取顶上——模式与分布的词典其实很有限,规则法能到不错的水平。
升级路线我有两条。第一条,作者没做正确性,我会加一层影像金标准复核:随机抽 300 例 LGE 阳性,由 2 名医师盲法重读影像,给出真实的模式、分布、程度,然后同时算“写入率”和“写入正确率”。这样“LLM 更全”才能升级成“LLM 更准”,而审稿人会买账,因为这正是作者在局限性里自己点出的第一条。第二条,把“多样性”假说做成 2×2 的解耦实验(格式 × 属性含量),再加一个风格多样性的量化指标——比如不同医生句向量的离散度——直接检验“异质性驱动”这个机制。代价是多训两个适配器,大约一天 GPU 时间;风险是四条臂结果差不多,但那本身也是一个有价值的阴性结果,因为它会把解释权交还给“训练样本量”。