ARTICLE · 1382854
一句话问数:连数据库、调接口、传 Excel,三种方式我都实测了一遍
不用写报表页面,不用为每个查询需求排期开发。数据在哪,就从哪儿问。
#引子:三个每天都有人问的问题
如果你在一家做设备租赁 / 售后服务的公司,下面这三句话大概率天天出现:
销售在群里问:"**机器人科技名下现在有多少台设备?都谁在负责?" 运营问:"上海这周气温起伏大不大?会影响现场作业安排吗?" 老板随手扔过来一个 Excel:"这份台账你帮我看看,哪台设备工时明显偏高?"
三个问题,三种数据位置:一个在业务数据库里,一个在别人的 HTTP 接口里,一个在他刚发给你的文件里。
传统做法是三种不同的工程:写 SQL + 出报表、写接口对接 + 定时同步、手工 Excel 透视。需求一多,IT 部门就成了"人肉查询接口"。
下面是我这两天真实跑出来的三条路径 —— 同一个 Agent、同一个输入框,只换数据源。所有数字都是真实结果,截图都是真实界面。
先说结论:单次查询 6~27 秒,一条命令都不用写。
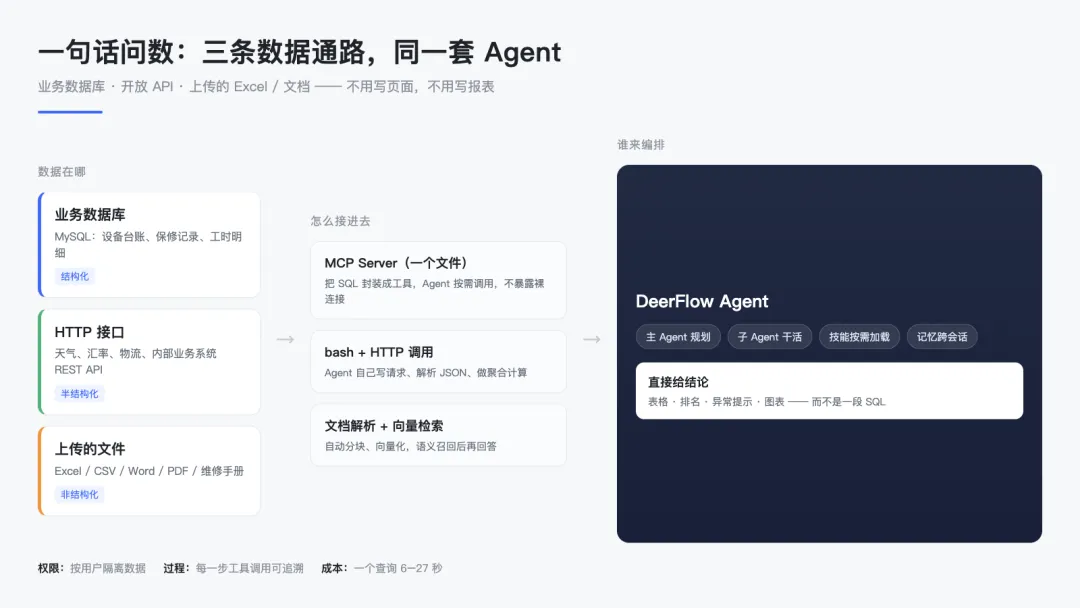
#一、先看整体:三条路,一套编排
三条路的关键差别不在"模型多聪明",而在数据怎么接进来:
#二、路径一:连数据库(结构化数据)
#为什么不直接让模型连数据库
让模型拿一个 root 账号自由写 SQL,是最容易出事的那种"快"。我的做法是中间加一层 MCP Server:把查询能力封成有限个、语义明确的工具,模型只能调这些工具,不能拼任意 SQL。
backend/mcp_servers/mysql_device_server.py 是个单文件,暴露 8 个工具:
@mcp.tool()defquery_device(sn: str) -> str:"""按设备SN精确查询设备完整信息"""...@mcp.tool()defsearch_devices(keyword: str = "", customer_name: str = "",brand:str="",engineer_name:str="")->str:"""多维度模糊搜索设备"""...# 另外还有:get_devices_by_engineer / get_devices_by_customer# list_warranty_status / query_device_location / get_my_devices / run_cross_db_query
注册只要一段 JSON(extensions_config.json):
"mysql-device":{"enabled":true,"type":"stdio","command":"uv","args":["run","--directory","/path/to/backend","python","mcp_servers/mysql_device_server.py"],"tool_call_timeout":30,"routing":{"mode":"prefer","priority":80,"keywords":["叉车","设备","保修","forklift"]}}
routing.keywords 这段很关键:工具不是全量塞给模型的,命中关键词才把这一组工具"抬"进上下文。既省 token,也减少模型乱调工具。
#实测
我问了一句:
用数据库工具帮我统计:**机器人科技有限公司名下的设备有多少台?按责任工程师分组各多少台?再列出累计工时最高的 3 台设备(编号+工时)。
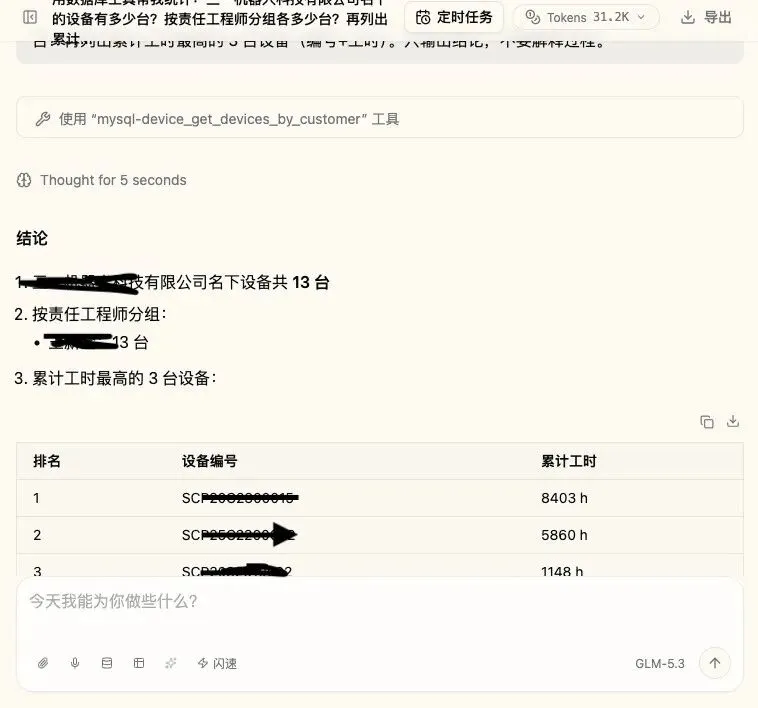
结果(真实数据,该客户名下):
耗时 6 秒,Token 31.2K,只调用了 1 个工具(界面里那行 使用 mysql-device_get_devices_by_customer 工具)我没有提前告诉它表结构,它自己读了工具描述决定用哪个
数据本身分散在 deer_device(设备)、deer_warranty(保修)、deer_hours(工时)、deer_auth(用户-客户映射)四个库里,服务端用 run_cross_db_query 做跨库关联,本次查询命中的是 deer_device。
我拿原始数据交叉核对过:该客户共 13 台设备、责任工程师都是王新全,工时前三名一致。这是"可核对"的关键 —— 后面我会专门讲为什么必须每次都核。
#数据库这条路的三条经验
只给只读账号。工具里写死 SELECT,物理上不给写权限。工具粒度要"业务化",不是 execute_sql(sql)。get_devices_by_customer这种名字模型一看就知道该在什么时候用。多租户在服务端过滤。我们还有个 get_my_devices(user_identifier),从user_customer_map里查这个人能看哪些客户 —— 权限不能靠提示词约束。
#三、路径二:调 API(半结构化数据)
不是所有数据都在你库里。天气、汇率、物流轨迹、SaaS 系统的接口 —— 这类数据的特点是:有接口,但没人为它写适配器。
实测时我没有写任何代码,只描述要什么:
调用公开天气接口(https://api.open-meteo.com[https://api.open-meteo.com/]),取上海过去 7 天的逐日最高/最低气温,算出日温差最大的是哪一天,用表格列出来。
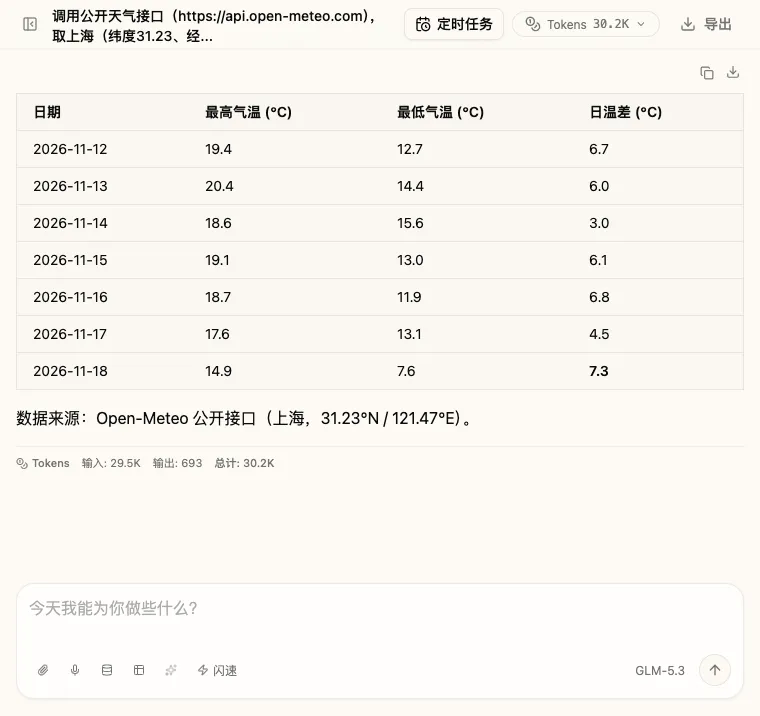
Agent 自己写了个 Python 请求(bash 工具里):
import json, urllib.requesturl = ('https://archive-api.open-meteo.com/v1/archive''?latitude=31.23&longitude=121.47''&start_date=2026-11-12&end_date=2026-11-18''&daily=temperature_2m_max,temperature_2m_min&timezone=Asia/Shanghai')data = json.load(urllib.request.urlopen(url))["daily"]# 然后自己算温差、排序、出表
结果:11-18 号温差最大,7.3°C(14.9 / 7.6)。耗时 8 秒,30.2K tokens。
注意我做了件"不信任"的事:我又用 curl 直接打了一次接口,对了一遍原始数组:
max [19.4, 20.4, 18.6, 19.1, 18.7, 17.6, 14.9]min [12.7, 14.4, 15.6, 13.0, 11.9, 13.1, 7.6]
逐行一致。这套流程里,人是审计员,不是操作员。
#API 这条路的边界
适合:一次性的外部取数、临时对接、内部已有 REST 接口但没有 SDK 不适合:高频调用(每次都现写请求,不如封装成 MCP 工具)、需要严格计费控制的场景 有鉴权的接口,把 token 放到环境变量里,别写进提示词
#四、路径三:上传文件
最容易被低估的一条路。业务同事不会给你数据库权限,但会发 Excel 给你。
实测:我把 设备台账.xlsx(6 台设备)拖进对话框,问:
统计每个客户的设备台数、全部设备的平均累计工时,并指出工时最高的那台设备。
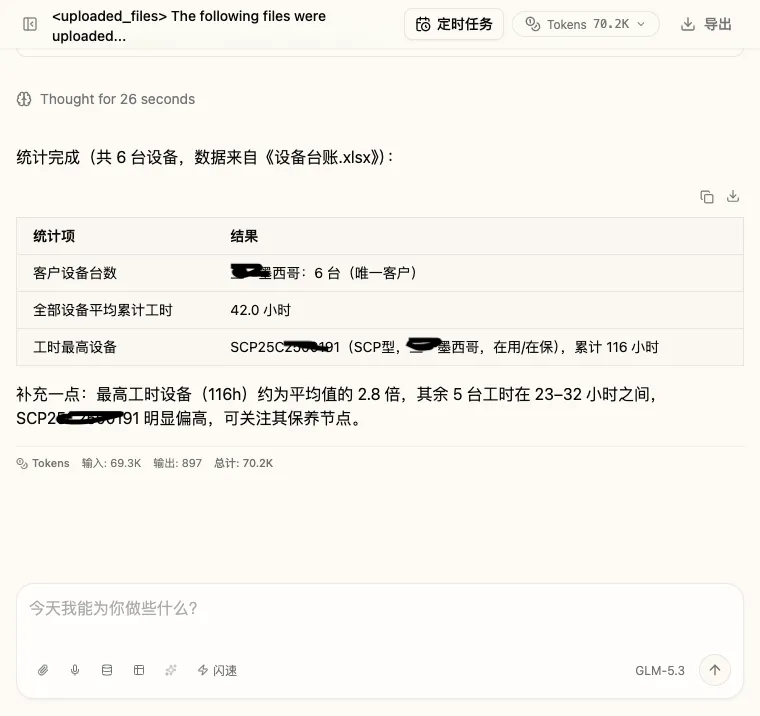
Agent 做的事很聪明 —— 它先读了 data-analysis 技能的说明,然后用 DuckDB 把 Excel 当表来查:
python /mnt/skills/public/data-analysis/scripts/analyze.py \--files "/mnt/user-data/uploads/设备台账.xlsx" \--action query \--sql "SELECT 客户名称, COUNT(*) AS 台数 FROM data GROUP BY 客户名称"
结果:墨西哥 6 台(唯一客户)、平均累计工时 42.0 小时、最高 SCP25C2500191(116 小时,约平均值的 2.8 倍),并主动提示"明显偏高,可关注保养节点"。
这条路的代价也很真实:27 秒,70.2K tokens,5 次工具调用。比数据库贵一倍多 —— 因为要先解析文件结构、再生成 SQL、再解释结果。所以:
一次性分析 → 传文件,别为了它就建库 每天都要查 → 进数据库,用路径一
文档类(Word / PDF / 维修手册)走的是另一条支路:上传后自动分块 + 向量化,检索时按语义召回再回答,适合"电池亏电怎么处理"这种非表格问题,不适合精确计数。
#五、三条路横向对比(可以直接抄)
| 6 秒 | 8 秒 | 27 秒 | |
#六、三个踩过的坑(比功能更值钱)
1)不要给模型"自由 SQL"
见过太多 demo 是 execute_sql(query),看起来灵活,实际是把自己变成了 SQL 注入的靶子,还经常查错表。工具化之后,模型只能选工具、填参数,出错空间从"任意 SQL"缩到"参数填错"。
2)每个结论都要能对回原始数据
我写这篇文章时,三组结果全部拿原始数据核过:数据库用 pymysql 直查、API 用 curl 重打、Excel 我肉眼看了表。这不是不信任模型,而是问数场景下,一个错数字比没有数字更危险。建议在团队里立个规矩:涉及金额、工时、台数的结论,必须附"数据来源 + 核对方式"。
3)成本不在模型,在"上下文"
同样一个问题:数据库 31K、API 30K、文件 70K。差在文件要先把整张表读进上下文。如果你每天要问 50 次,这个差距就是真金白银 —— 所以"高频走库、低频走文件"不是偏好,是算账。
#七、如果你也想落地,我的建议顺序
第 1 周:先打通数据库
挑一张被问得最多的表(我们这边是设备台账) 写 4~6 个业务语义的工具(按客户查、按工程师查、按 SN 查、按保修状态查) 用只读账号,工具内固定 SQL 模板 上线后观察一周:哪些问题模型答不上来,就补哪个工具
第 2 周:打开文件与接口
文件这条路几乎零成本,先让业务同事用起来,收集真实问法 外部接口先做"临时取数",稳定复用的再封装成工具
第 3 周:把结论送出去
定时任务 + 推送(比如每天早上 9:00 自动跑一次"出保设备清单"发到飞书) 这一步做完,才算真的从"能问"变成"不用问"
#写在最后
这三条路径背后其实只有一句话:让数据留在它该在的地方,让 AI 去找它。
不搬库、不做宽表、不为每个问题排期。数据库留在数据库,接口留给接口,Excel 就让它在聊天窗口里被解析。
技术栈(都是开源的):DeerFlow(LangGraph Agent 框架)+ MCP(工具协议)+ DuckDB(文件查询)+ ChromaDB(文档检索),模型这次用的是 GLM-5.3。
如果你也在做类似的事,欢迎在评论区说说你的数据都在哪儿 。